作者: admin

  • 呼和浩特總投資200億元新能源汽車項目正式開工

    日前,計畫總投資約200億元的內蒙古自治區呼和浩特市金山高新區新能源汽車製造專案舉行了集中開工儀式。

    該項目占地2605畝、計畫總投資約200億元,其中基礎設施、廠房投資35億元,設計建築面積102.7萬平方米,擬入駐規模以上工業企業20家以上。項目建成後,年產值預計可達500億元,提供就業崗位3萬個,將成為內蒙古新能源汽車及核心零部件產業聚集區。

    該專案採取PPP建設模式,分三期推進。目前集中開工的6個專案是首期落戶的項目,計畫於2017年1月實現部分產能投產,預計當年產值可達100億元左右,提供就業崗位6千餘個。

    呼和浩特市金山高新區新能源汽車製造專案是該市土左旗2015年引進的億元以上重點工業專案,致力於發展新能源電池、電機、電控等核心零部件生產以及整車製造等延伸產業鏈。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

    ※小三通物流營運型態?

    ※快速運回,大陸空運推薦?

  • 清華大學與日產聯手研發電動車與自動駕駛技術

    5月16日,“清華大學(汽車系)-日產智慧出行聯合研究中心”成立儀式在北京舉行,日產汽車攜手清華大學,針對中國市場的電動汽車和自動駕駛技術開展研發工作。

    合作框架包括:電動汽車以及電池相關技術、自動駕駛和未來中國道路系統三個方面,雙方將共用資源,調研中國道路情況以及各地的駕駛習慣,助力發展中國智慧出行交通方式。與此同時,日產汽車與清華大學還將培養優秀本地人才。

    據瞭解,日產汽車與清華大學有著多年的合作歷史,過去10年間,雙方在汽車核心技術開發,汽車發展戰略研究等領域一直保持密切合作,日產汽車將通過此次合作深入研究中國道路交通網絡,以最佳方式實現“日產智慧出行”。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※台灣寄大陸海運貨物規則及重量限制?

    ※大陸寄台灣海運費用試算一覽表

    ※台中搬家,彰化搬家,南投搬家前需注意的眉眉角角,別等搬了再說!

  • Faraday Future:量產車續航會超過特斯拉20%-30%

    知名科技網站The Verge的記者Andrew J . Hawkins近日造訪了拉斯維加斯,參加了超級高鐵Hyperloop的公開首秀。

    Faraday Future全球製造副總裁Dag Reckhorn,就Faraday Future未來的計畫,公眾對那輛造型誇張怪異、最大輸出功率1000馬力的Zero1概念車的反應,以及對中國投資方樂視造車的看法,等等大家十分好奇的事情聊了聊。

    關於Faraday Future要造的車

    未來Faraday Future要造的汽車,都會採用“可變平臺架構”(Variable Platform Architecture,簡稱VPA),這樣方便不同車型的大規模量產。所以概念車階段我們一般都會想得天馬行空一些,而等到量產時,只要增加不同的配置(傳統系統、電池等)就好,完全不需要根據不同的車型再重新設計底盤平臺。目前只是不斷地通過反覆運算的工程樣車,來一步步逼近量產車型的模樣。現在還無法給出量產車型發佈的具體時間,因為要將成熟的產品投放市場,總不會是那麼一帆風順。

    關於Faraday Future的工廠

    工廠已經奠基了,將很快開建。那一大片地都是我們的,從選址到設計,也是破費周折。Hyperloop在我們工廠旁邊,但只有一小塊地,而我們從六位不同的買家手裡拿到了七塊地皮,足以想像整個工廠的建設得多複雜。說實話,要建這麼一座大工廠,實在不是件簡單事,敲定設計方案就花了我不少時間,不過總算搞定了。目前進行的是整個工廠框架的工程搭建工作,就快要完工了。所以我們很快就要開始工廠主體部分的建設了。

    選擇內華達州的原因

    內華達州對Faraday Future建廠而言,是再好不過的選擇。實際上,也有很多其他州拋出了更好的優惠政策和條件,但我們希望工廠建在能夠吸引志趣相投的夥伴的地方,靠近15號高速公路,尤其要靠近西海岸。所以要找到360多公頃大的這麼一塊地,並不是件容易事。此外,這裡配套基礎設施建設完善意味著新品能夠迅速推向市場,而且內華達州每年都有近4100萬遊客資源,我們只要吸引其中的一小部分到工廠參觀並體驗我們的產品,這絕對是極佳的行銷工具,我們完全可以將Faraday Future的工廠變成一處景點。只要有人願意來,他總歸是想看點不一樣的東西。而且這裡有朝北的陽光直射進來,綠色環保的太陽能可以保證能源持續不斷的供給。

    稅收優惠

    Faraday Future將為內華達州提供4500份就業機會,為工廠項目投資10億美元…而只是工廠建設及運營的工作,就會消耗掉內華達州近50%的勞動力。至於優惠政策嘛,說實話FF不是沖著這個來的。因為我個人認為,一個專案如果需要這些外界各種各樣的支撐才能做下去的話,那它本身是有問題的。

    據瞭解,Faraday Future已經得到了內華達州政府2億1千950萬美元的稅收優惠。還有額外的1億2千萬美元將用於對該公司三處獨立的基礎設施進行功能性提升。

    關於中國投資方樂視

    樂視是Faraday Future的合作夥伴,而樂視的生態系統內包含了電影、app、音樂等等幾乎你想得到的任何業務,它都有。而對FF而言,這些領域的資源和技術支援是十分重要的。Faraday Future和樂視是兩家獨立運作的公司,只不過這位FF的創始人又恰恰是樂視的老總罷了。而當初成立Faraday Future的時候,賈總就表示只是以投資人的身份參與,不會干涉任何公司業務的運作。至於樂視前段時間推出的LeSEE超級汽車,我認為這是一款迎合了中國消費市場需求的車型…這裡還要重申一下,FF和樂視建立了緊密開放的合作關係,這目前已經不是什麼秘密了。而關於這個問題,目前我也只能說這麼多了。

    續航里程

    我們有自己的目標,不過現在還不到向公眾透露的時機。我只能說,未來Faraday Future量產車型的續航里程會比市場上同類競爭者多出20%~30%。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※大陸寄台灣空運注意事項

    ※大陸海運台灣交貨時間多久?

    ※避免吃悶虧無故遭抬價!台中搬家公司免費估價,有契約讓您安心有保障!

  • 駱駝集團8億元進軍新能源汽車動力電池領域

    駱駝集團8億元進軍新能源汽車動力電池領域

    近日,駱駝集團股份有限公司公開發行可轉換公司債券預案,本次公開發行可轉換公司債券募集資金總額不超過 90,000 萬元,扣除發行費用後,募集資金用於以下項目:

    駱駝集團此次5.5億用於建設年產7億Wh動力電池生產線可以看作是駱駝集團進軍電動汽車動力電池領域的信號。

    早在今年三月,駱駝集團動力電池專案就已經正式開工建設,總投資高達20億元人民幣,預計建成後年產能達到50億瓦時鋰離子電池,並將大量供應給新能源汽車主機廠。不僅於此,駱駝集團還先後於2015年佈局了充電設施建設、新能源汽車租賃業務等新能源配套產業鏈。可見,駱駝集團在新能源汽車領域已籌畫多時,此次轉換公司債券預案的發佈只是一個開端,下一步還將會有新能源動力電池方面的大動作。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※專營大陸空運台灣貨物推薦

    ※台灣空運大陸一條龍服務

    ※評比彰化搬家公司費用,南投搬家公司費用收費行情懶人包大公開

    ※彰化搬家費用,南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

  • abp(net core)+easyui+efcore實現倉儲管理系統——ABP WebAPI與EasyUI結合增刪改查之一(二十七)

    abp(net core)+easyui+efcore實現倉儲管理系統——ABP WebAPI與EasyUI結合增刪改查之一(二十七)


    一.前言

           通過前面的文章至的學習,我們已經有實現了傳統的ASP.NET Core MVC+EasyUI的增刪改查功能。本篇文章我們要實現了使用ABP提供的WebAPI方式+EasyUI來實現增刪改查的功能。本文中我們將不在使用DataGrid表格控件,而是使用樹形表格(TreeGrid)控件。

    二、樹形表格(TreeGrid)介紹

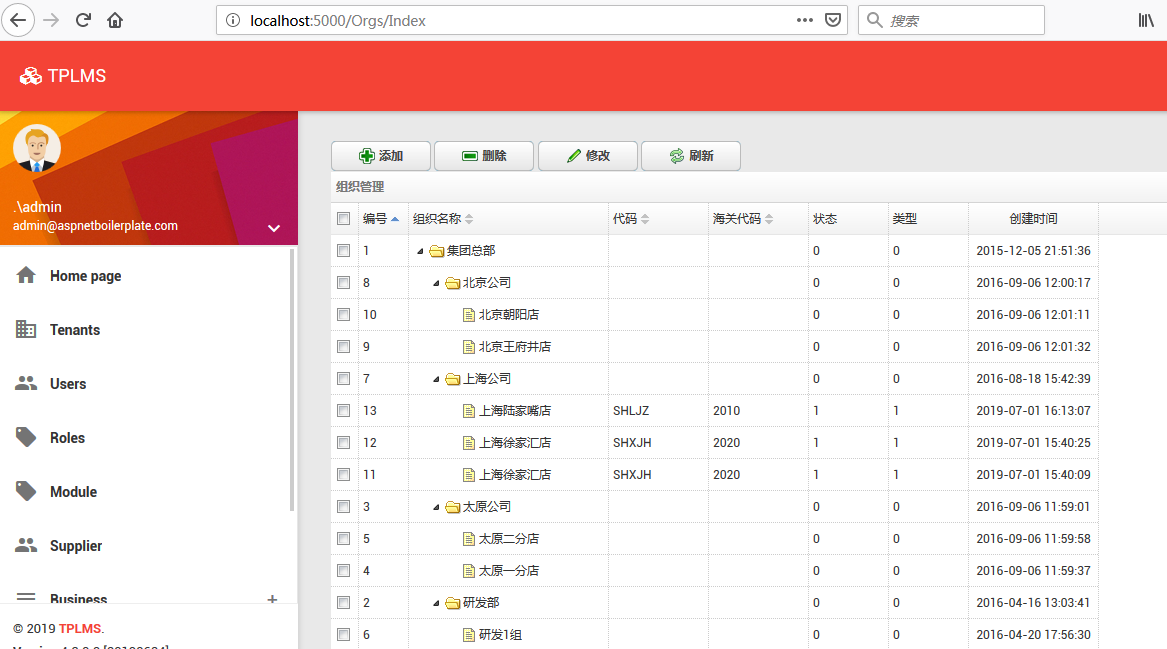
           我先上圖,讓我們來看一下功能完成之後的組織管理信息列表頁面。如下圖。

           這個組織管理列表頁面使用TreeGrid來實現的。我們接下來介紹一下TreeGrid。

         首先、在定義TreeGrid時有兩個屬性必須要有一個是idField,這個要唯一;另一個是treeField的定義,這是樹節點的值,必須要有。 

         其次、easyui加載treegrid的json數據格式有三種,我就介紹我常用的這種。其他兩種方式,請查看easyui的相關文檔。

      {"total":7,"rows":[
    
               {"id":1,"name":"All Tasks","begin":"3/4/2010","end":"3/20/2010","progress":60,"iconCls":"icon-ok"},      
    {"id":2,"name":"Designing","begin":"3/4/2010","end":"3/10/2010","progress":100,"_parentId":1,"state":"closed"},
    {"id":21,"name":"Database","persons":2,"begin":"3/4/2010","end":"3/6/2010","progress":100,"_parentId":2},
    {"id":22,"name":"UML","persons":1,"begin":"3/7/2010","end":"3/8/2010","progress":100,"_parentId":2}, {"id":23,"name":"Export Document","persons":1,"begin":"3/9/2010","end":"3/10/2010","progress":100,"_parentId":2},
    {"id":3,"name":"Coding","persons":2,"begin":"3/11/2010","end":"3/18/2010","progress":80},
    {"id":4,"name":"Testing","persons":1,"begin":"3/19/2010","end":"3/20/2010","progress":20} ],"footer":[ {"name":"Total Persons:","persons":7,"iconCls":"icon-sum"} ]}

         下面介紹一下上面數據中的幾個重要屬性:

         1)  _parentId :字段_parentId必不可少,且名稱唯一。記得前面有“_” ,他是用來記錄父級節點,沒有這個屬性,是沒法展示父級節點 其次就是這個父級節點必須存在,不然信息也是展示不出來,在後台遍歷組合的時候,如果父級節點不存在或為0時,此時 _parentId 應該不賦值,或設為“”。如果賦值 “0” 則在表格中不显示數據。

        2) state:是否展開

         3) checked:是否選中(用於複選框)

        4) iconCls:選項前面的圖標,如果自己不設定,父級節點默認為文件夾圖標,子級節點為文件圖標


        下面我們來開始實現組織管理頁面的相關功能。首先我們要創建一個組織信息實體。

    三、創建Org實體

           1. 在Visual Studio 2017的“解決方案資源管理器”中,右鍵單擊“ABP.TPLMS.Core”項目的“Entitys”文件夾,在彈出菜單中選擇“添加” >

     > “類”。 將類命名為 Org,然後選擇“添加”。

          2.創建Org類繼承自Entity<int>,通過實現審計模塊中的IHasCreationTime來實現保存創建時間。根據TreeGrid所需要的數據格式的要求。代碼如下:

    using Abp.Domain.Entities;
    using Abp.Domain.Entities.Auditing;
    using System;
    using System.Collections.Generic;
    using System.ComponentModel.DataAnnotations;
    using System.Text;
     
    
    namespace ABP.TPLMS.Entitys
    {
    
       public partial class Org : Entity<int>, IHasCreationTime
    {
          int m_parentId = 0;
            public Org()
            {
    
                this.Id = 0;
                this.Name = string.Empty;
                this.HotKey = string.Empty;
                this.ParentId = 0;
                this.ParentName = string.Empty;
    
                this.IconName = string.Empty;
    
                this.Status = 0;
    
                this.Type = 0;
    
                this.BizCode = string.Empty;
                this.CustomCode = string.Empty;
                this.CreationTime = DateTime.Now;
                this.UpdateTime = DateTime.Now;
                this.CreateId = 0;
    
                this.SortNo = 0;
    
            }
    
            [Required]
            [StringLength(255)]
            public string Name { get; set; }
    
            [StringLength(255)]
            public string HotKey { get; set; }
    
            public int ParentId { get { return m_parentId; } set { m_parentId = value; } }
    
            [Required]
            [StringLength(255)]
            public string ParentName { get; set; }
    
            public bool IsLeaf { get; set; }
    
            public bool IsAutoExpand { get; set; }
    
            [StringLength(255)]
            public string IconName { get; set; } 
    
            public int Status { get; set; }
    
            public int Type { get; set; }
    
            [StringLength(255)]
            public string BizCode { get; set; }
    
            [StringLength(100)]
            public string CustomCode { get; set; }
    
            public DateTime CreationTime { get; set; }
            public DateTime UpdateTime { get; set; }
            public int CreateId { get; set; }
    
            public int SortNo { get; set; }
    public int? _parentId {
                get {
                    if (m_parentId == 0)                
    
                    {
                        return null;
                    }
    
                    return m_parentId;
                }           
    
            }
        }
    }

          3.定義好實體之後,我們去“ABP.TPLMS.EntityFrameworkCore”項目中的“TPLMSDbContext”類中定義實體對應的DbSet,以應用Code First 數據遷移。添加以下代碼


    using Microsoft.EntityFrameworkCore;
    using Abp.Zero.EntityFrameworkCore;
    using ABP.TPLMS.Authorization.Roles;
    using ABP.TPLMS.Authorization.Users;
    using ABP.TPLMS.MultiTenancy;
    using ABP.TPLMS.Entitys;
     
    
    namespace ABP.TPLMS.EntityFrameworkCore
    {
    
        public class TPLMSDbContext : AbpZeroDbContext<Tenant, Role, User, TPLMSDbContext>
        {
    
            /* Define a DbSet for each entity of the application */
        
            public TPLMSDbContext(DbContextOptions<TPLMSDbContext> options)
                : base(options)
    
            {
            }
    
            public DbSet<Module> Modules { get; set; }
            public DbSet<Supplier> Suppliers { get; set; }
      public DbSet<Cargo> Cargos { get; set; }
              public DbSet<Org> Orgs { get; set; }
    
        }
    }


          4.從菜單中選擇“工具->NuGet包管理器器—>程序包管理器控制台”菜單。

         5. 在PMC中,默認項目選擇EntityframeworkCore對應的項目后。輸入以下命令:Add-Migration AddEntityOrg,創建遷移。如下圖。


           6. 在上面的命令執行完畢之後,創建成功后,會在Migrations文件夾下創建時間_AddEntityOrg格式的類文件,這些代碼是基於DbContext指定的模型。如下圖。


         7.在程序包管理器控制台,輸入Update-Database,回車執行遷移。執行成功后,如下圖。


         8. 在SQL Server Management Studio中查看數據庫,Orgs表創建成功。


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※試算大陸海運運費!

  • 極*Java速成教程 – (1)

    序言

    眾所周知,程序員需要快速學習新知識,所以就有了《21天精通C++》和《MySQL-從刪庫到跑路》這樣的書籍,Java作為更“高級”的語言也不應該落後,所以我就寫一個《極·Java速成教程》,讓想學的人能夠快速學習Java(手斜)。
    本文大概分三大部分:

    • 編程基礎知識
      • 面向對象思想
      • 數據類型
      • 運算符
      • 流程控制
    • Java語言基礎
    • Java高級特性

    本文請逐字理解文本內容,本文僅供理解和學習Java編程,不可作為概念性參考

    本文是閱讀《Java編程思想》后的讀後感
    本文着重於理解某種思想,所以些許描述顯得晦澀,意會即可

    面向對象思想

    何為面向對象

    Java是一個從設計之初就遵循面向對象思想的語言,因此而有着諸多面向對象的特性,那麼問題來了,面向對象指的是什麼?
    面向對象,不是指的臉超女朋友,而是說編程的時候,你所操作的一切事物都是“對象”,假如說Java程序員是個搬磚工,那Java操作的對象就是搬磚工手裡的磚,一塊磚就是一個對象,一堆轉就是一堆對象,諸多同樣的對象可以用一個概念來概括,這個概念就是“類”。
    先在我們可以思考磚是個什麼東西,也就是磚的“概念(類)”:磚,由土燒制而成,可以用來砌牆、鋪地和墊桌角,有一定的重量和體積,能被搬被砌。仔細分析這句定義,可以發現能分為4小句:

    • 磚是由土燒制而成。也就是說,一個類都是從另一個或多個類繼承發展而來,也就是“繼承(extend)和組合自另一個或多個類”,在Java中,所有類都繼承和擴展自Object類,在自己寫的程序中,一個類可以繼承和擴展自官方的類,別人寫的類和自己寫的類。
    • 磚可以用來砌牆、鋪地和墊桌角。也就是同一個類可以根據不同的需求去加工處理,修改為不同的“形狀”,添加不同的屬性,在不同的地方起到不同的作用。
    • 磚由一定的重量和體積。也就是說每個類都有其屬性,但是對於同一種屬性,他們的值未必相同,正如每個磚的重量和體積都可以不同。
    • 磚能被搬被砌。也就是說每個類都有其功能,屬性是一個類靜態的描述,而功能(或者說方法)則是一個類動態的描述。

    將許多個“磚”一樣的對象搭配組合,堆壘到一起,就可以構建起程序的這棟房屋,實現整體的功能。

    Java中類的幾個特點

    Java中的類有幾個特點

    1. 單根繼承,也就是說某一個類只能直接繼承自另一個類,就像磚只能由土燒制而成,即土→磚,然而除了土,磚的燒制過程中還需要加其他的配料比如外面要燒上去一層琉璃,那就得在磚本身的屬性以上添加一個琉璃的屬性,琉璃的屬性是額外的,獨立無關的,但是他們組合起來實現了更多的功能。也就是說除了直接繼承,還可以添加其他類到一個類中,這種方法叫通過接口(interface)進行繼承。
    2. 訪問控制。對於一個類來說,你只能看到一個類想讓你看到的部分。就像一個磚,你只能看到磚的表面,不能看到它的內里,除非敲開他,但是在Java中,這是不被允許的。一個類想讓你看到的部分和不想讓你看到的部分由不同的關鍵詞進行控制:
      • public 對於所有對象都公開的內容
      • private 只有自己可見的內容
      • protected 只有自己和自己的子孫可以看到的內容
      • default 只有自己的親戚(同一個包)可以看到的內容
        我們不用關心他們內部什麼樣子,我們只需要關心我們需要的,暴露在外面的東西,以及對象能正常工作就行。
    3. “像”就是“是”。對於一個類來說,如果長得像一個東西,那就可以看作是一個東西。就像兒子像父親,父親能幹的兒子也能幹一樣,一塊防火轉是一個磚,那他也有磚的所有屬性,也能被壘起來。而一個具有壘起來方法的對象看上去能壘起來,那他就能像磚一樣被壘起來。
    4. static屬性。對於一個類來說,有的屬性和方法可以是static也就是靜態的,這種屬性和方法不是描述一個類的對象的,而是描述一個類的。就比如可以對所有的磚執行統計數量操作,對於一個磚頭讓他統計同類的數量是不恰當的,但是對於一堆轉,讓這堆磚告訴你有多少塊是可行的。
    5. 對象生命周期管理。Java語言的使用者不用關心Java對象是怎麼誕生的,怎麼消亡的,只需要在需要時new一下,創建一個對象即可,使用完以後的垃圾丟到哪裡,那是Java高級特性需要研究的東西。
    6. Java中的類之上具有包(package)的結構,包是具有層次的,如java.lang.Math就表示java下的lang包下的Math類,這個層次結構可以有好多層,一層一層深入,所以可能這個名字會很長。在使用某一個包中的某一個類的某些內容時,需要使用import進行導入,如果需要導入某個包下的全部,可以使用*通配符。,如java.lang.*。

    Java編程需要關心的點

    只要想好這個類和它的對象應該怎麼設計,怎麼正常運行即可,其他語言的包袱,甩掉即可

    數據類型

    一切都是對象,而根基只需要幾個

    當Java使用者需要一個對象時,這個對象在內存中的位置時我們不用管也沒法管的。但這個對象是怎麼來的,卻是可以思考的。就像房子是磚壘成的,磚是由土燒成的,那土是什麼構成的呢,這麼追究下去,追究到最後就成了重子和輕子了,但是我們不必追求這麼細,就像Java中我們知道一切對象都有Object這個“祖宗”,但是我們不需要凡事都請動這個祖宗,它有幾個子女是我們常用的,也就是“基本類型”:

    類型 大小 包裝器 初始值
    boolean true/false Boolean false
    char 16 bit Character ‘\u0000’
    byte 8 bit Byte (byte)0
    short 16 bit Short (short)0
    int 32 bit Integer 0
    long 64 bit Long 0L
    float 32 bit Float 0.0f
    double 64 bit Double 0.0d
    void Void void

    這些基本類型的大小都與其位數n有關,最小值為-2n-1,最大值為2n-1-1,float和double遵循IEEE754標準。
    除了基本類型,還有字符串String,高精度整數BigInteger和高精度浮點數BigDecimal等常見類。

    還有一些方便的類型可以使用

    String

    字符串是一個常用的類型,可以用來儲存一個字符序列。字符串類型在內存中是一個不可變對象,也就是說當一個String s="ABC"字符串在內存中創建后,它就不可以被修改了,如果執行了s+="DEF"的操作,那這個s引用實際上是指向了一個新的”ABCDEF”對象,它與原來的”ABC”對象已經沒有關係了。
    字符串變量的比較是不可以直接用==判斷的。==是用來進行引用對比的運算符,而兩個內容一樣的字符串引用未必在內存中指向同一個對象。因此,String對象的比較要使用equals()方法進行。

    enum

    enum是枚舉對象,是一個有限的可以n選1的對象的集合,可以在switch語句內使用。形如:

    public enum Spiciness{
        NOT,MILD,MEDIUM,HOT,FLAMING
    }

    枚舉類型的實例都是常量,可以使用枚舉類型名.枚舉常量的方法選擇常量的值。它內部創建了toString()方法,所以可以很方便地打印枚舉常量的值,還提供了ordinal()方法,可以獲取某個枚舉常量在枚舉類型中的順序。以及靜態的 values()方法,可以按照枚舉常量的聲明順序獲取由這些常量值構成的數組。

    對象應當被管理

    一個對象,給他個稱號,就可以根據這個名字喊他做各種事,就像家裡人可以喊你小名讓你幹活一樣。但是當出了家裡,可能有好多人跟你重名,這會帶來困擾,因此是不被允許的,而在外面叫你的小名,這也會帶來尷尬,也就是說,這個名字超出了作用域,在Java中,一個稱號(或者說引用)的作用域是從這個命名的聲明到所在花括號的結尾。當然如果不關心這一點也沒問題,因為IDE會提醒你這裏出了問題。
    當一個對象有了它的稱呼以後,就可以安排他做好多的事情了,無論誰喊,只要是喊到,就可以用。在作用域範圍內的所有調用都可以通過這個名字實行,而你也可以再給這個對象起另一個名字,這多個名字都是指的同一個對象,當處理不當時,這會帶來一些問題,比如一個喊你張三的人給你圖了個花臉,別人喊你李四把你喊過來以後也會看到一個花臉。
    對於一堆相同類型的對象,可以用一個容器裝住他們,方便我們管理和使用,Java中提供了多種類型的容器,有最基本的數組,也就是一串連續的空間去裝一樣的對象,還有其他的諸如set和map之類的容器可以裝,這一點可以在後面進行詳細討論。

    運算符

    運算符按照字面語義理解就好

    運算符有其優先級,也有短路的特徵。優先級就是說先乘除后加減,短路就是邏輯運算時當直接可以產生結果時就不再繼續運算。
    運算符有以下幾個:
    +。加號,数字的累加,字符串的連接,將較小類型的数字提升為int類型。
    -。減號,数字相減。負號。
    *。乘號,数字相乘。
    /。除號,数字相除,給出結果的整數部分,直接截斷小數,不會四舍五入。
    %。求余,数字相除求餘數。
    ++自增,–自減,當出現在對象前面時先運算再輸出值,當出現在對象後面時先輸出值再運算。
    >,<,>=,<=。大於,小於,大於等於,小於等於。顧名思義。
    ==判斷相等,對於Java來說,這是容易使人困擾的一點,因為除了在判斷基本類型對象是否相等時以外,==僅僅為判斷別名所指向的對象是否為同一個,而不關心對象的屬性是否相等。如果要判斷String等官方封裝好的類型,就要用到equals()方法,但是對於自己定義的類來說,如果沒有重新定義equals()方法,就會和==一樣,對引用對象進行判斷,而不是對對象的屬性進行判斷。
    &&,||,!。邏輯運算符與或非,對boolean值進行判斷,兩邊都true時&&結果為真,兩邊有一個為true時||結果為真,!是對boolean對象的邏輯值進行顛倒。
    &,|,^,~。按位操作符,對数字類型進行按位的與,或,異或和非操作,與,或,異或是對兩個對象進行操作,非是對一個對象進行操作。
    <<,>>,>>>。移位操作符,就是將操作數按位進行移位,A※※B就是將A往箭頭方向移B位。如果是負數,>>在左側補1,>>>在左側補0。
    =。数字賦值,或者是給一個對象起別名,或者是將另一個別名添加到一個對象上。
    +=,-=,*=,/=,&=,|=,^=,>>=,>>>=,<<=。比較類似,a※=b就是a=a※b。當>>>=byte和short時,轉化成int進行處理然後截斷,可能產生不正確的結果。
    指數計數法:AeB代表了Ax10B,如1.39e-43f代表float的1.39×10-43。
    ?:。這是個三元運算符,如A?B:C就表示如果A的邏輯結果為真,就執行B,否則就執行C。
    直接常量,就是直接的數,如200D,0x200。其規則是如果後面跟D表示double,F表示float,L表示long,前面跟0表示8進制數,0x表示16進制數。

    操作符使用時容易出現的問題

    類型轉換

    (A)B可以將B強制轉化為A類型,如果是從較小的類型轉化為較大的類型,將不會帶來問題,但如果是從較大的類型轉化為較小的類型,則會帶來信息丟失的問題。自定義類的轉換同理。

    截尾和舍入

    對於浮點數來說,強制轉化為整形時,會捨棄小數部分,如果要獲取捨入的結果,需要使用java.lang.Math中的round()方法。

    流程控制

    Java是一種面向對象的語言,但其執行過程依舊時順序的,在順序執行的程序中,會進行一些選擇分支和循環操作。

    選擇

    Java中可以使用if-else和switch進行分支選擇。

    if-else

    形如

    if(A){
        B
    }else{
        C
    }

    就是如果判斷條件A為真,則執行B,否則執行C。

    switch

    形如

    switch(A){
        case 1: B;
        case 2: C;break;
        case 3: D;break;
        case 4: E;break;
    ···
    }

    即如果判斷條件A為1,則執行B然後執行C然後中斷該代碼塊,如果判斷條件為2則執行C然後中斷該代碼塊,如果判斷條件為3則執行D然後中斷該代碼塊,等等。

    循環

    循環有3種形式:while,do-while和for。

    while

    形如

    while(A){
        B
    }
    對判斷條件A進行判斷,當判斷條件為A時,多次執行B代碼。

    do-while

    形如

    do{
        B
    }while(A)

    先執行一次B代碼,然後對判斷條件A進行判斷,當判斷條件A為真時,循環至花括號頭部執行B代碼。

    for

    形如

    for(int i=0,j=0;i<100;i++,j++){
        B
    }

    首先對第一個;前面的部分執行,常見於循環控制對象進行初始化,多個對象可以使用,進行區分,然後對;間的循環控制條件進行判斷,如果條件為真則執行下方代碼塊,最後對;后的第三部分執行,比如對循環對象進行自增操作等。實例中就是先對i和j進行初始化為0,然後判斷i是否小於100,如果為真則執行B代碼,最後執行i自增和j自增,然後判斷i是否小於100,如果為真繼續循環,該代碼最後將執行B代碼段100次。
    在編程時,循環常在數組等可迭代對象上進行。可迭代就是可以從前到后順序走一遍。對此,Java提供了一些便利的語法方便開發。形如

    容器/數組 A;
    for(int i:A){
        B
    }

    就是說對於容器或者數組A,迭代遍歷一遍,i會在每次循環中引用到A中的每個對象,然後執行B代碼塊。假如容器/數組A中有100個對象,那B就會被執行100次。

    返回

    return

    結束該語句所在函數,返回返回值。
    返回值類型由函數定義決定,如果不匹配且無法兼容則會IDE報錯。

    Java的與眾不同

    Java的流程控制中沒有goto語句,但是通過break和continue語句,實現了從深層循環中跳出的功能。通過在循環前標記label:,然後使用break label和continue label,即可跳出循環到指定位置或者是跳出本次循環到指定位置。

    label1:
    while(true){
        label2:
        while(true){
            continue label1;//結束本次循環,跳轉到外循環繼續循環
            break label1://結束外層循環
        }
    }

    感慨

    Java的基本語法,與其他的語言有相似之處,也有不同之處,但編程本來就是一種實踐的技能,紙上得來終覺淺,絕知代碼要手擼,還是實打實的寫代碼才可以將知識轉化為能力。以及,文章真難寫。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※專營大陸快遞台灣服務

    ※台灣快遞大陸的貨運公司有哪些呢?

  • 前端每周學習分享–第12期

    1.VuePress

    大家看過不少Vue.js及其子項目的文檔,一定發現了它們風格完全一致,界面清爽,讀起來很舒服,它們都使用了vuepress。

    VuePress是尤大為了支持 Vue 及其子項目的文檔需求而寫的一個靜態網站生成工具,廣泛用於編寫技術文檔 ,可以部署在github上做個人博客。

    原理:

    在構建過程中,會創建應用程序的服務器渲染版本,通過訪問每個路由,來渲染相應的 HTML。

    其中, 每個 markdown 文件都使用 編譯為 HTML,然後作為 Vue 組件的模板進行處理。這允許你直接在 markdown 文件中使用 Vue,在需要嵌入動態內容時,這種使用方式非常有用。

    十分實用的特性:

    • md文件可內嵌vue代碼
    • 可自定義主題
    • 利用service worker做離線緩存
    • 多語言支持
    • 基於git的最近更新

    官方文檔:

    快速搭建:

    2.WebWorker

    web worker是運行在後台的jacvascript,利用類似線程的消息傳遞實現并行,獨立於其他腳本,不會影響頁面的性能。

    web worker能夠長時間運行,有理想的啟動性能以及理想的內存消耗。

    worker 創建后,它可以向它的創建者指定的事件監聽函數傳遞消息,這樣該worker生成的所有任務都會接收到這些消息。

    webworker有專用線程dedicated worker(單窗口專用),sharedWorker(可多窗口共享),以及後來的service worker(目前瀏覽器支持程度還不高)。

    2.1.dedicated worker

    使用方法:

    worker線程里監聽onmessage,

    頁面線程里創建worker對象:const myworker = new Worker("worker.js")

    發送消息:postMessage(msg)

    接受消息:onmessage = function(e){const msg = e.data}

    msg的數據格式自行定義。

    終止worker:myworker.terminate()

    例如下面的示例,worker會接收頁面上輸入的兩個数字,計算出乘積后返回結果。

    worker.js

    onmessage = function(e) {
      console.log('Worker: Message received from main script');
      let result = e.data[0] * e.data[1];
      if (isNaN(result)) {
        postMessage('Please write two numbers');
      } else {
        let workerResult = 'Result: ' + result;
        console.log('Worker: Posting message back to main script');
        postMessage(workerResult);
      }
    }

    index.html里

    const first = document.querySelector('#number1');
    const second = document.querySelector('#number2');
    const result = document.querySelector('.result');
    if (window.Worker) {
        const myWorker = new Worker("worker.js");
    
        first.onchange = function() {
          myWorker.postMessage([first.value, second.value]);
          console.log('Message posted to worker');
        }
    
        second.onchange = function() {
          myWorker.postMessage([first.value, second.value]);
          console.log('Message posted to worker');
        }
    
        myWorker.onmessage = function(e) {
            result.textContent = e.data;
            console.log('Message received from worker');
        }
    } else {
        console.log('Your browser doesn\'t support web workers.')
    }

    2.2.shared worker

    共享進程可以連接到多個不同的頁面,這些頁面必須屬於相同的域(相同的協議,主機以及端口)

    在火狐中,共享進程不能在私有與公共文檔間進行共享。

    SharedWorker.port返回一個MessagePort對象,用來進行通信和對共享進程進行控制。

    創建共享進程對象:const myWorker = new SharedWorker("worker.js");

    獲取端口:

    發送消息:myWorker.port.postMessage(msg)

    接收消息:myWorker.port.onmessage = function(e) {const msg = e.data}

    worker線程獲取端口:onconnect = function(e) {const port = e.ports[0]}

    啟動端口:port.start()

    2.3.service worker

    Service Worker 可以理解為一個介於客戶端和服務器之間的一個代理服務器 ,常用於做離線資源緩存

    出於對安全問題的考慮,Service Worker 只能被使用在 https 或者本地的 localhost 環境下。

    暫時沒有仔細學這塊,可以閱讀。

    參考文章:

    3.代碼相關

    3.1.元素內文本垂直居中

    已知元素高度的話,可以設置line-height:元素高度.

    如果元素高度未知,就不能使用line-height了。

    有人會想使用line-height:100%,會發現這是不行的,這個百分比是相對當前字體尺寸,而不是元素高度。

    我使用了flex布局實現

        display: flex;
        align-items:center;
        justify-content:center;

    還可以設置padding來使文本看起來垂直居中

    padding: 50px 20px;

    3.2.微信小程序自定義placeholder的隱藏時機

    在一個searchBar組件中,有一個自定的placeholder如下:

    <!-- <view
    ​        wx:if="{{!inputValue.length}}"
    ​        class="placeholder" >
    ​        {{placeholder}}
    ​     </view> -->

    原生的placeholder不是在觸發bindinput時隱藏,而是在輸入鍵盤按鈕點擊時。使用inputValue.length來判斷显示自定義的placeholder會在某些輸入法中導致拼音預覽和自定義placeholder重疊(因為拼音显示的時候value值還沒變)

    最後選擇棄用這個自定義placeholder,使用input組件的placeholder屬性,並使用placeholder-class來設置它的樣式。

    3.3.關於微信小程序原生組件的坑

    原生組件有camera、canvas、input (僅在focus時表現為原生組件) 、live-player、live-pusher、map、textarea、video、cover-view、cover-image。

    所以當你用canvas畫圖表、使用地圖、播放視頻甚至做文本輸入時,都是可能遇到相關坑點的。

    1. 關於原生組件、組件之間的層級關係、

    ​ 原生組件的層級始終高於普通組件,不論普通組件的z-index設置了多少。

    ​ 后插入的原生組件可以覆蓋之前的原生組件。

    ​ 原生組件之間的相對層級關係可以通過z-index來調整。

    ​ 原生組件會遮擋vconsole彈出的調試面板。

    ​ cover-view和cover-image可以覆蓋在部分原生組件上。

    1. cover-view的使用

    ​ cover-view在做地圖、畫布、視頻上的彈出層時是會用到的,但它有很多使用限制。

    ​ cover-view只能內嵌cover-view、cover-image、button,其他元素在真機上就會被cover-view給覆蓋住,如果想內嵌radio、picker等就只能自己用這3個可內嵌的元素來實現。

    ​ cover-view不支持iconfont,也不支持單邊border、background-image、shadow、overflow: visible等。

    1. input的使用

    ​ input在不聚焦時是佔位元素,會被原生組件遮擋,聚焦時才使用原生組件渲染。這就會出現input設置了更高的z-index,不聚焦時仍會被其他原生組件遮住。

    ​ 要解決這個問題,可以使用textarea來代替input。

    ​ 我的一個解決方案是,加一個標誌位來記錄input是否聚焦,當不聚焦時,显示一個承載value值的cover-view(它需要綁定一個觸發聚焦的點擊事件),聚焦時,就显示input組件。

    3.4.多個標籤頁之間的通信方案

    1. 使用websocket

    2. 使用localstorage或者cookie

    3. 使用sharedworker

    我遇到的問題是需要在新窗口打開當前網站的新窗口時,能繼承上一個窗口的vuex的狀態樹里的某些數據。這不需要和服務器打交道,最好就在本地。

    最後使用localstorage來做,在跳轉新窗口前更新localstorage,在新窗口根組件掛載時取出數據。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

    ※台灣海運大陸貨務運送流程

    ※兩岸物流進出口一站式服務

  • 2.NioEventLoop的創建

    2.NioEventLoop的創建

    NioEventLoop的創建

    NioEventLoop是netty及其重要的組成部件,它的首要職責就是為註冊在它上的channels服務,發現這些channels上發生的新連接、讀寫等I/O事件,然後將事件轉交 channel 流水線處理。使用netty時,我們首先要做的就是創建NioEventLoopGroup,這是一組NioEventLoop的集合,類似線程與線程池。通常,服務端會創建2個group,一個叫做bossGroup,一個叫做workerGroup。bossGroup負責監聽綁定的端口,接受請求並創建新連接,初始化后交由workerGroup處理後續IO事件。

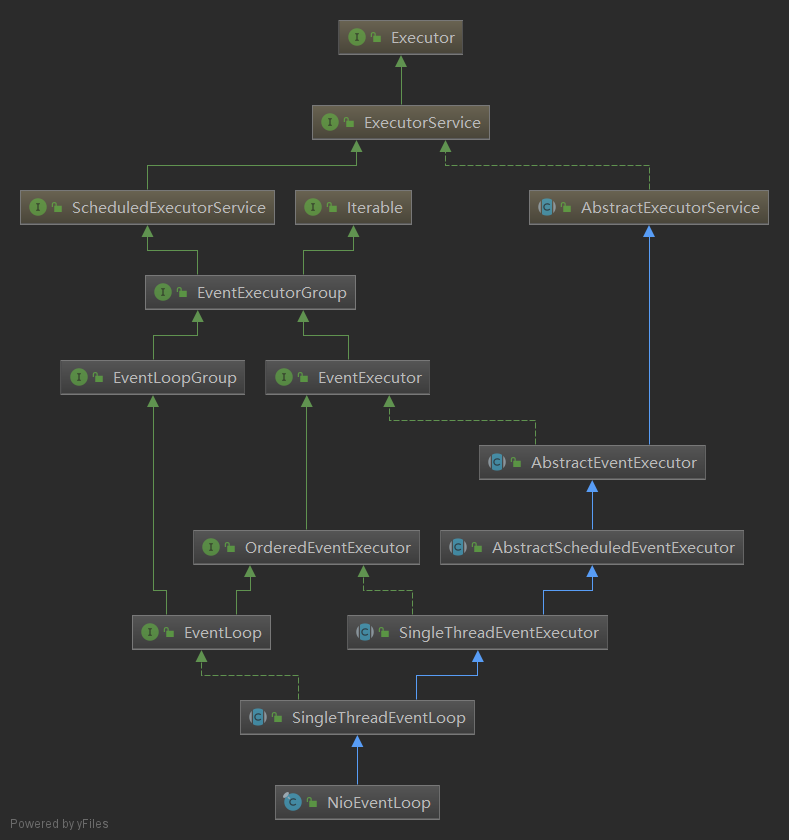
    NioEventLoop和NioEventLoopGroup的類圖

    首先看看NioEventLoop和NioEventLoopGroup的類關係圖

    類多但不亂,可以發現三個特點:

    1. 兩者都繼承了ExecutorService,從而與線程池建立了聯繫
    2. NioEventLoop繼承的都是SingleThread,NioEventLoop繼承的是MultiThread
    3. NioEventLoop還繼承了AbstractScheduledEventExecutor,不難猜出這是個和定時任務調度有關的線程池

    NioEventLoopGroup的創建

    EventLoopGroup bossGroup = new NioEventLoopGroup(1);
    EventLoopGroup workerGroup = new NioEventLoopGroup();

    我們先看看bossGroup和workerGroup的構造方法。

    public NioEventLoopGroup() {
        this(0);
    }
    public NioEventLoopGroup(int nThreads) {
        this(nThreads, (Executor) null);
    }
    除此之外,還有多達8種構造方法,這些構造方法可以指定5種參數:
    1、最大線程數量。如果指定為0,那麼Netty會將線程數量設置為CPU邏輯處理器數量的2倍
    2、線程工廠。要求線程工廠類必須實現java.util.concurrent.ThreadFactory接口。如果沒有指定線程工廠,那麼默認DefaultThreadFactory。
    3、SelectorProvider。如果沒有指定SelectorProvider,那麼默認的SelectorProvider為SelectorProvider.provider()。
    4、SelectStrategyFactory。如果沒有指定則默認為DefaultSelectStrategyFactory.INSTANCE
    5、RejectedExecutionHandler。拒絕策略處理類,如果這個EventLoopGroup已被關閉,那麼之後提交的Runnable任務會默認調用RejectedExecutionHandler的reject方法進行處理。如果沒有指定,則默認調用拒絕策略。

    最終,NioEventLoopGroup會重載到父類MultiThreadEventExecutorGroup的構造方法上,這裏省略了一些健壯性代碼。

    protected MultithreadEventExecutorGroup(int nThreads, Executor executor,EventExecutorChooserFactory chooserFactory, Object... args) {
        // 步驟1
        if (executor == null) {
            executor = new ThreadPerTaskExecutor(newDefaultThreadFactory());
        }
        
        // 步驟2
        children = new EventExecutor[nThreads];
        for (int i = 0; i < nThreads; i ++) {
            children[i] = newChild(executor, args);
        }    
    
        // 步驟3
        chooser = chooserFactory.newChooser(children);
    
        // 步驟4
        final FutureListener<Object> terminationListener = future -> {
            if (terminatedChildren.incrementAndGet() == children.length) {
                terminationFuture.setSuccess(null);
            }
        };
        for (EventExecutor e: children) {
            e.terminationFuture().addListener(terminationListener);
        }
    
        // 步驟5
        Set<EventExecutor> childrenSet = new LinkedHashSet<>(children.length);
        Collections.addAll(childrenSet, children);
        readonlyChildren = Collections.unmodifiableSet(childrenSet);
        }

    這裏可以分解為5個步驟,下面一步步講解

    步驟1

    第一個步驟是創建線程池executor。從workerGroup構造方法可知,默認傳進來的executor為null,所以首先創建executor。newDefaultThreadFactory的作用是設置線程的前綴名和線程優先級,默認情況下,前綴名是nioEventLoopGroup-x-y這樣的命名規則,而線程優先級則是5,處於中間位置。
    創建完newDefaultThreadFactory后,進入到ThreadPerTaskExecutor。它直接實現了juc包的線程池頂級接口,從構造方法可以看到它只是簡單的把factory賦值給自己的成員變量。而它實現的接口方法調用了threadFactory的newThread方法。從名字可以看出,它構造了一個thread,並立即啟動thread。

    public ThreadPerTaskExecutor(ThreadFactory threadFactory) {
        this.threadFactory = threadFactory;
    }
    @Override
    public void execute(Runnable command) {
        threadFactory.newThread(command).start();
    }    

    那麼我們回過頭來看下DefaultThreadFactory的newThread方法,發現他創建了一個FastThreadLocalThread。這是netty自定義的一個線程類,顧名思義,netty認為它的性能更快。關於它的解析留待以後。這裏步驟1創建線程池就完成了。總的來說他與我們通常使用的線程池不太一樣,不設置線程池的線程數和任務隊列,而是來一個任務啟動一個線程。(問題:那任務一多豈不是直接線程爆炸?)

    @Override
    public Thread newThread(Runnable r) {
        Thread t = newThread(FastThreadLocalRunnable.wrap(r), prefix + nextId.incrementAndGet());        
        return t;
    }
    protected Thread newThread(Runnable r, String name) {
        return new FastThreadLocalThread(threadGroup, r, name);
    }

    步驟2

    步驟2是創建workerGroup中的NioEventLoop。在示例代碼中,傳進來的線程數是0,顯然不可能真的只創建0個nioEventLoop線程。在調用父類MultithreadEventLoopGroup構造函數時,對線程數進行了判斷,若為0,則傳入默認線程數,該值默認為2倍CPU核心數

    protected MultithreadEventLoopGroup(int nThreads, Executor executor, Object... args) {
        super(nThreads == 0 ? DEFAULT_EVENT_LOOP_THREADS : nThreads, executor, args);
    }
    // 靜態代碼塊初始化DEFAULT_EVENT_LOOP_THREADS
    static {
        DEFAULT_EVENT_LOOP_THREADS = Math.max(1, SystemPropertyUtil.getInt("io.netty.eventLoopThreads",     NettyRuntime.availableProcessors() * 2));
    }    

    接下來是通過newChild方法為每一個EventExecutor創建一個對應的NioEventLoop。這個方法傳入了一些args到NioEventLoop中,前三個是在NioEventLoopGroup創建時傳過來的參數。默認值見上文

    1. SlectorProvider.provider, 用於創建 Java NIO Selector 對象;
    2. SelectStrategyFactory, 選擇策略工廠;
    3. RejectedExecutionHandlers, 拒絕執行處理器;
    4. EventLoopTaskQueueFactory,任務隊列工廠,默認為null;

    進入NioEventLoop的構造函數,如下:

    NioEventLoop構造函數
    NioEventLoop(NioEventLoopGroup parent, Executor executor, SelectorProvider selectorProvider,
                     SelectStrategy strategy, RejectedExecutionHandler rejectedExecutionHandler,
                     EventLoopTaskQueueFactory queueFactory) {
            super(parent, executor, false, newTaskQueue(queueFactory), newTaskQueue(queueFactory),
                    rejectedExecutionHandler);
            if (selectorProvider == null) {
                throw new NullPointerException("selectorProvider");
            }
            if (strategy == null) {
                throw new NullPointerException("selectStrategy");
            }
            provider = selectorProvider;
            final SelectorTuple selectorTuple = openSelector();
            selector = selectorTuple.selector;
            unwrappedSelector = selectorTuple.unwrappedSelector;
            selectStrategy = strategy;
        }
    // 父類構造函數    
    protected SingleThreadEventExecutor(EventExecutorGroup parent, Executor executor,
                                            boolean addTaskWakesUp, Queue<Runnable> taskQueue,
                                            RejectedExecutionHandler rejectedHandler) {
        super(parent);
        this.addTaskWakesUp = addTaskWakesUp;
        this.maxPendingTasks = DEFAULT_MAX_PENDING_EXECUTOR_TASKS;
        this.executor = ThreadExecutorMap.apply(executor, this);
        this.taskQueue = ObjectUtil.checkNotNull(taskQueue, taskQueue");
        rejectedExecutionHandler = ObjectUtil.checkNotNullrejectedHandler, "rejectedHandler");
    }    

    首先調用一個newTaskQueue方法創建一個任務隊列。這是一個mpsc即多生產者單消費者的無鎖隊列。之後調用父類的構造函數,在父類的構造函數中,將NioEventLoopGroup設置為自己的parent,並通過匿名內部類創建了這樣一個Executor————通過ThreadPerTaskExecutor執行傳進來的任務,並且在執行時將當前線程與NioEventLoop綁定。其他屬性也一一設置。
    在nioEventLoop構造函數中,我們發現創建了一個selector,不妨看一看netty對它的包裝。

    unwrappedSelector = provider.openSelector();
    if (DISABLE_KEY_SET_OPTIMIZATION) {
        return new SelectorTuple(unwrappedSelector);
    }

    首先看到netty定義了一個常量DISABLE_KEY_SET_OPTIMIZATION,如果這個常量設置為true,也即不對keyset進行優化,則直接返回未包裝的selector。那麼netty對selector進行了哪些優化?

    final SelectedSelectionKeySet selectedKeySet = new SelectedSelectionKeySet();
    
    final class SelectedSelectionKeySet extends AbstractSet<SelectionKey> {
    
        SelectionKey[] keys;
        int size;
    
        SelectedSelectionKeySet() {
            keys = new SelectionKey[1024];
        }
    } 

    往下,我們看到了一個叫做selectedSelectionKeySet的類,點進去可以看到,它繼承了AbstractSet,然而它的成員變量卻讓我們想到了ArrayList,再看看它定義的方法,除了不支持remove和contains外,活脫脫一個簡化版的ArrayList,甚至也支持擴容。
    沒錯,netty確實通過反射的方式,將selectionKey從Set替換為了ArrayList。仔細一想,卻又覺得此番做法有些道理。眾所周知,雖然HashSet和ArrayList隨機查找的時間複雜度都是o(1),但相比數組直接通過偏移量定位,HashSet由於需要Hash運算,時間消耗上又稍稍遜色了些。再加上使用場景上,都是獲取selectionKey集合然後遍歷,Set去重的特性完全用不上,也無怪乎追求性能的netty想要替換它了。

    步驟3

    創建完workerGroup的NioEventLoop后,如何挑選一個nioEventLoop進行工作是netty接下來想要做的事。一般來說輪詢是一個很容易想到的方案,為此需要創建一個類似負載均衡作用的線程選擇器。當然追求性能到喪心病狂的netty是不會輕易滿足的。我們看看netty在這樣常見的方案里又做了哪些操作。

    public EventExecutorChooser newChooser(EventExecutor[] executors) {
        if (isPowerOfTwo(executors.length)) {
            return new PowerOfTwoEventExecutorChooser(executors);
        } else {
            return new GenericEventExecutorChooser(executors);
        }
    }
    // PowerOfTwo
    public EventExecutor next() {
        return executors[idx.getAndIncrement() & executors.length - 1];
    }
    // Generic
    public EventExecutor next() {
        return executors[Math.abs(idx.getAndIncrement() % executors.length)];
    }

    可以看到,netty根據workerGroup內線程的數量採取了2種不同的線程選擇器,當線程數x是2的冪次方時,可以通過&(x-1)來達到對x取模的效果,其他情況則需要直接取模。這與hashmap強制設置容量為2的冪次方有異曲同工之妙。

    步驟4

    步驟4就是添加一些保證健壯性而添加的監聽器了,這些監聽器會在EventLoop被關閉后得到通知。

    步驟5

    創建一個只讀的NioEventLoop線程組

    到此NioEventLoopGroup及其包含的NioEventLoop組就創建完成了

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※小三通海運與一般國際貿易有何不同?

    ※小三通快遞通關作業有哪些?

  • 理解Spark SQL(一)—— CLI和ThriftServer

    理解Spark SQL(一)—— CLI和ThriftServer

    Spark SQL主要提供了兩個工具來訪問hive中的數據,即CLI和ThriftServer。前提是需要Spark支持Hive,即編譯Spark時需要帶上hive和hive-thriftserver選項,同時需要確保在$SPARK_HOME/conf目錄下有hive-site.xml配置文件(可以從hive中拷貝過來)。在該配置文件中主要是配置hive metastore的URI(Spark的CLI和ThriftServer都需要)以及ThriftServer相關配置項(如hive.server2.thrift.bind.host、hive.server2.thrift.port等)。注意如果該台機器上同時運行有Hive ThriftServer和Spark ThriftServer,則hive中的hive.server2.thrift.port配置的端口與spark中的hive.server2.thrift.port配置的端口要不一樣,避免同時啟動時發生端口衝突。

    啟動CLI和ThriftServer之前都需要先啟動hive metastore。執行如下命令啟動:

    [root@BruceCentOS ~]# nohup hive –service metastore &

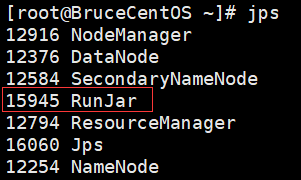
    成功啟動后,會出現一個RunJar的進程,同時會監聽端口9083(hive metastore的默認端口)。


     先來看CLI,通過spark-sql腳本來使用CLI。執行如下命令:

    [root@BruceCentOS4 spark]# $SPARK_HOME/bin/spark-sql –master yarn

    上述命令執行後會啟動一個yarn client模式的Spark程序,如下圖所示:

      同時它會連接到hive metastore,可以在隨後出現的spark-sql>提示符下運行hive sql語句,比如:

      其中每輸入並執行一個SQL語句相當於執行了一個Spark的Job,如圖所示:

      也就是說執行spark-sql腳本會啟動一個yarn clien模式的Spark Application,而後出現spark-sql>提示符,在提示符下的每個SQL語句都會在Spark中執行一個Job,但是對應的都是同一個Application。這個Application會一直運行,可以持續輸入SQL語句執行Job,直到輸入“quit;”,然後就會退出spark-sql,即Spark Application執行完畢。


    另外一種更好地使用Spark SQL的方法是通過ThriftServer,首先需要啟動Spark的ThriftServer,然後通過Spark下的beeline或者自行編寫程序通過JDBC方式使用Spark SQL。

    通過如下命令啟動Spark ThriftServer:

    [root@BruceCentOS4 spark]# $SPARK_HOME/sbin/start-thriftserver.sh –master yarn

    執行上面的命令后,會生成一個SparkSubmit進程,實際上是啟動一個yarn client模式的Spark Application,如下圖所示:

      而且它提供一個JDBC/ODBC接口,用戶可以通過JDBC/ODBC接口連接ThriftServer來訪問Spark SQL的數據。具體可以通過Spark提供的beeline或者在程序中使用JDBC連接ThriftServer。例如在啟動Spark ThriftServer后,可以通過如下命令使用beeline來訪問Spark SQL的數據。

    [root@BruceCentOS3 spark]# $SPARK_HOME/bin/beeline -n root -u jdbc:hive2://BruceCentOS4.Hadoop:10003

     上述beeline連接到了BruceCentOS4上的10003端口,也就是Spark ThriftServer。所有連接到ThriftServer的客戶端beeline或者JDBC程序共享同一個Spark Application,通過beeline或者JDBC程序執行SQL相當於向這個Application提交並執行一個Job。在提示符下輸入“!exit”命令可以退出beeline。

    最後,如果要停止ThriftServer(即停止Spark Application),需要執行如下命令:

    [root@BruceCentOS4 spark]# $SPARK_HOME/sbin/stop-thriftserver.sh


     綜上所述,在Spark SQL的CLI和ThriftServer中,比較推薦使用後者,因為後者更加輕量,只需要啟動一個ThriftServer(對應一個Spark Application)就可以給多個beeline客戶端或者JDBC程序客戶端使用SQL,而前者啟動一個CLI就啟動了一個Spark Application,它只能給一個用戶使用。


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

    ※小三通物流營運型態?

    ※快速運回,大陸空運推薦?

  • Github PageHelper 原理解析

    任何服務對數據庫的日常操作,都離不開增刪改查。如果一次查詢的紀錄很多,那我們必須採用分頁的方式。對於一個Springboot項目,訪問和查詢MySQL數據庫,持久化框架可以使用MyBatis,分頁工具可以使用github的 PageHelper。我們來看一下PageHelper的使用方法:

     1 // 組裝查詢條件
     2 ArticleVO articleVO = new ArticleVO();
     3 articleVO.setAuthor("劉慈欣");
     4 
     5 // 初始化返回類
     6 // ResponsePages類是這樣一種返回類,其中包括返回代碼code和返回消息msg
     7 // 還包括返回的數據和分頁信息
     8 // 其中,分頁信息就是 com.github.pagehelper.Page<?> 類型
     9 ResponsePages<List<ArticleVO>> responsePages = new ResponsePages<>();
    10 
    11 // 這裏為了簡單,寫死分頁參數。正確的做法是從查詢條件中獲取
    12 // 假設需要獲取第1頁的數據,每頁20條記錄
    13 // com.github.pagehelper.Page<?> 類的基本字段如下
    14 // pageNum: 當前頁
    15 // pageSize: 每頁條數
    16 // total: 總記錄數
    17 // pages: 總頁數
    18 com.github.pagehelper.Page<?> page = PageHelper.startPage(1, 20);
    19 
    20 // 根據條件獲取文章列表
    21 List<ArticleVO> articleList = articleMapper.getArticleListByCondition(articleVO);
    22 
    23 // 設置返回數據
    24 responsePages.setData(articleList);
    25 
    26 // 設置分頁信息
    27 responsePages.setPage(page);


    如代碼所示,page 是組裝好的分頁參數,即每頁显示20條記錄,並且显示第1頁。然後我們執行mapper的獲取文章列表的方法,返回了結果。此時我們查看 responsePages 的內容,可以看到 articleList 中有20條記錄,page中包括當前頁,每頁條數,總記錄數,總頁數等信息。   使用方法就是這麼簡單,但是僅僅知道如何使用還不夠,還需要對原理有所了解。下面就來看看,PageHelper 實現分頁的原理。   我們先來看看 startPage 方法。進入此方法,發現一堆方法重載,最後進入真正的 startPage 方法,有5個參數,如下所示:

     1 /**
     2  * 開始分頁
     3  *
     4  * @param pageNum      頁碼
     5  * @param pageSize     每頁显示數量
     6  * @param count        是否進行count查詢
     7  * @param reasonable   分頁合理化,null時用默認配置
     8  * @param pageSizeZero true 且 pageSize=0 時返回全部結果,false時分頁, null時用默認配置
     9  */
    10 public static <E> Page<E> startPage(int pageNum, int pageSize, boolean count, Boolean reasonable, Boolean pageSizeZero) {
    11     Page<E> page = new Page<E>(pageNum, pageSize, count);
    12     page.setReasonable(reasonable);
    13     page.setPageSizeZero(pageSizeZero);
    14     // 當已經執行過orderBy的時候
    15     Page<E> oldPage = SqlUtil.getLocalPage();
    16     if (oldPage != null && oldPage.isOrderByOnly()) {
    17         page.setOrderBy(oldPage.getOrderBy());
    18     }
    19     SqlUtil.setLocalPage(page);
    20     return page;
    21 }


    getLocalPage 和 setLocalPage 方法做了什麼操作?我們進入基類 BaseSqlUtil 看一下:

     1 package com.github.pagehelper.util;
     2 ...
     3 
     4 public class BaseSqlUtil {
     5     // 省略其他代碼
     6 
     7     private static final ThreadLocal<Page> LOCAL_PAGE = new ThreadLocal<Page>();
     8     
     9     /**
    10      * 從 ThreadLocal<Page> 中獲取 page
    11      */ 
    12     public static <T> Page<T> getLocalPage() {
    13         return LOCAL_PAGE.get();
    14     }
    15     
    16     /**
    17      * 將 page 設置到 ThreadLocal<Page>
    18      */
    19     public static void setLocalPage(Page page) {
    20         LOCAL_PAGE.set(page);
    21     }
    22 
    23     // 省略其他代碼
    24 }


    原來是將 page 放入了 ThreadLocal<Page> 中。ThreadLocal 是每個線程獨有的變量,與其他線程不影響,是放置 page 的好地方。 setLocalPage 之後,一定有地方 getLocalPage,我們跟蹤進入代碼來看。   有了MyBatis動態代理的知識后,我們知道最終執行SQL的地方是 MapperMethod 的 execute 方法,作為回顧,我們來看一下:

     1 package org.apache.ibatis.binding;
     2 ...
     3 
     4 public class MapperMethod {
     5 
     6     public Object execute(SqlSession sqlSession, Object[] args) {
     7         Object result;
     8         if (SqlCommandType.INSERT == command.getType()) {
     9             // 省略
    10         } else if (SqlCommandType.UPDATE == command.getType()) {
    11             // 省略
    12         } else if (SqlCommandType.DELETE == command.getType()) {
    13             // 省略
    14         } else if (SqlCommandType.SELECT == command.getType()) {
    15             if (method.returnsVoid() && method.hasResultHandler()) {
    16                 executeWithResultHandler(sqlSession, args);
    17                 result = null;
    18             } else if (method.returnsMany()) {
    19                 /**
    20                  * 獲取多條記錄
    21                  */
    22                 result = executeForMany(sqlSession, args);
    23             } else if ...
    24                 // 省略
    25         } else if (SqlCommandType.FLUSH == command.getType()) {
    26             // 省略
    27         } else {
    28             throw new BindingException("Unknown execution method for: " + command.getName());
    29         }
    30         ...
    31         
    32         return result;
    33     }
    34 }


    由於執行的是select操作,並且需要查詢多條紀錄,所以我們進入 executeForMany 這個方法中,然後進入 selectList 方法,然後是 executor.query 方法。再然後突然進入到了 mybatis 的 Plugin 類的 invoke 方法,這是為什麼?   這裏就必須提到 mybatis 提供的 Interceptor 接口。
    Intercept 機制讓我們可以將自己製作的分頁插件 intercept 到查詢語句執行的地方,這是MyBatis對外提供的標準接口。藉助於Java的動態代理,標準的攔截器可以攔截在指定的數據庫訪問流程中,執行攔截器自定義的邏輯,比如在執行SQL之前攔截,拼裝一個分頁的SQL並執行。   讓我們回到MyBatis初始化的時候,我們發現 MyBatis 為我們組裝了 sqlSessionFactory,所有的 sqlSession 都是生成自這個 Factory。在這篇文章中,我們將重點放在 interceptorChain 上。程序啟動時,MyBatis 或者是 mybatis-spring 會掃描代碼中所有實現了 interceptor 接口的插件,並將它們以【攔截器集合】的方式,存儲在 interceptorChain 中。如下所示:

    # sqlSessionFactory 中的重要信息
    
    sqlSessionFactory
        configuration
            environment        
            mapperRegistry
                config         
                knownMappers   
            mappedStatements   
            resultMaps         
            sqlFragments       
            interceptorChain   # MyBatis攔截器調用鏈
                interceptors   # 攔截器集合,記錄了所有實現了Interceptor接口,並且使用了invocation變量的類


    如果MyBatis檢測到有攔截器,它就會在攔截器指定的執行點,首先執行 Plugin 的 invoke 方法,喚醒攔截器,然後執行攔截器定義的邏輯。因此,當 query 方法即將執行的時候,其實執行的是攔截器的邏輯。   MyBatis官網的說明: MyBatis 允許你在已映射語句執行過程中的某一點進行攔截調用。默認情況下,MyBatis 允許使用插件來攔截的方法調用包括:

    • Executor (update, query, flushStatements, commit, rollback, getTransaction, close, isClosed)
    • ParameterHandler (getParameterObject, setParameters)
    • ResultSetHandler (handleResultSets, handleOutputParameters)
    • StatementHandler (prepare, parameterize, batch, update, query)

      如果想了解更多攔截器的知識,可以看文末的參考資料。   我們回到主線,繼續看Plugin類的invoke方法:

     1 package org.apache.ibatis.plugin;
     2 ...
     3 
     4 public class Plugin implements InvocationHandler {
     5     ...
     6 
     7     public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
     8         try {
     9            Set<Method> methods = signatureMap.get(method.getDeclaringClass());
    10            if (methods != null && methods.contains(method)) {
    11                // 執行攔截器的邏輯
    12                return interceptor.intercept(new Invocation(target, method, args));
    13            }
    14            return method.invoke(target, args);
    15        } catch (Exception e) {
    16            throw ExceptionUtil.unwrapThrowable(e);
    17        }
    18    }
    19    ...
    20 }


    我們去看 intercept 方法的實現,這裏我們進入【PageHelper】類來看:

     1 package com.github.pagehelper;
     2 ...
     3 
     4 /**
     5  * Mybatis - 通用分頁攔截器
     6  */
     7 @SuppressWarnings("rawtypes")
     8 @Intercepts(@Signature(type = Executor.class, method = "query", args = {MappedStatement.class, Object.class, RowBounds.class, ResultHandler.class}))
     9 public class PageHelper extends BasePageHelper implements Interceptor {
    10     private final SqlUtil sqlUtil = new SqlUtil();
    11 
    12     @Override
    13     public Object intercept(Invocation invocation) throws Throwable {
    14         // 執行 sqlUtil 的攔截邏輯
    15         return sqlUtil.intercept(invocation);
    16     }
    17 
    18     @Override
    19     public Object plugin(Object target) {
    20         return Plugin.wrap(target, this);
    21     }
    22 
    23     @Override
    24     public void setProperties(Properties properties) {
    25         sqlUtil.setProperties(properties);
    26     }
    27 }


    可以看到最終調用了 SqlUtil 的intercept 方法,裏面的 doIntercept 方法是 PageHelper 原理中最重要的方法。跟進來看:

      1 package com.github.pagehelper.util;
      2 ...
      3 
      4 public class SqlUtil extends BaseSqlUtil implements Constant {
      5     ...
      6     
      7     /**
      8      * 真正的攔截器方法
      9      *
     10      * @param invocation
     11      * @return
     12      * @throws Throwable
     13      */
     14     public Object intercept(Invocation invocation) throws Throwable {
     15         try {
     16             return doIntercept(invocation);  // 執行攔截
     17         } finally {
     18             clearLocalPage();  // 清空 ThreadLocal<Page>
     19         }
     20     }
     21     
     22     /**
     23      * 真正的攔截器方法
     24      *
     25      * @param invocation
     26      * @return
     27      * @throws Throwable
     28      */
     29     public Object doIntercept(Invocation invocation) throws Throwable {
     30         // 省略其他代碼
     31         
     32         // 調用方法判斷是否需要進行分頁
     33         if (!runtimeDialect.skip(ms, parameterObject, rowBounds)) {
     34             ResultHandler resultHandler = (ResultHandler) args[3];
     35             // 當前的目標對象
     36             Executor executor = (Executor) invocation.getTarget();
     37             
     38             /**
     39              * getBoundSql 方法執行后,boundSql 中保存的是沒有 limit 的sql語句
     40              */
     41             BoundSql boundSql = ms.getBoundSql(parameterObject);
     42             
     43             // 反射獲取動態參數
     44             Map<String, Object> additionalParameters = (Map<String, Object>) additionalParametersField.get(boundSql);
     45             // 判斷是否需要進行 count 查詢,默認需要
     46             if (runtimeDialect.beforeCount(ms, parameterObject, rowBounds)) {
     47                 // 省略代碼
     48                 
     49                 // 執行 count 查詢
     50                 Object countResultList = executor.query(countMs, parameterObject, RowBounds.DEFAULT, resultHandler, countKey, countBoundSql);
     51                 Long count = (Long) ((List) countResultList).get(0);
     52                 
     53                 // 處理查詢總數,從 ThreadLocal<Page> 中取出 page 並設置 total
     54                 runtimeDialect.afterCount(count, parameterObject, rowBounds);
     55                 if (count == 0L) {
     56                     // 當查詢總數為 0 時,直接返回空的結果
     57                     return runtimeDialect.afterPage(new ArrayList(), parameterObject, rowBounds);
     58                 }
     59             }
     60             // 判斷是否需要進行分頁查詢
     61             if (runtimeDialect.beforePage(ms, parameterObject, rowBounds)) {
     62                 /**
     63                  * 生成分頁的緩存 key
     64                  * pageKey變量是分頁參數存放的地方
     65                  */
     66                 CacheKey pageKey = executor.createCacheKey(ms, parameterObject, rowBounds, boundSql);
     67                 /**
     68                  * 處理參數對象,會從 ThreadLocal<Page> 中將分頁參數取出來,放入 pageKey 中
     69                  * 主要邏輯就是這樣,代碼就不再單獨貼出來了,有興趣的同學可以跟進驗證
     70                  */
     71                 parameterObject = runtimeDialect.processParameterObject(ms, parameterObject, boundSql, pageKey);
     72                 /**
     73                  * 調用方言獲取分頁 sql
     74                  * 該方法執行后,pageSql中保存的sql語句,被加上了 limit 語句
     75                  */
     76                 String pageSql = runtimeDialect.getPageSql(ms, boundSql, parameterObject, rowBounds, pageKey);
     77                 BoundSql pageBoundSql = new BoundSql(ms.getConfiguration(), pageSql, boundSql.getParameterMappings(), parameterObject);
     78                 //設置動態參數
     79                 for (String key : additionalParameters.keySet()) {
     80                     pageBoundSql.setAdditionalParameter(key, additionalParameters.get(key));
     81                 }
     82                 /**
     83                  * 執行分頁查詢
     84                  */
     85                 resultList = executor.query(ms, parameterObject, RowBounds.DEFAULT, resultHandler, pageKey, pageBoundSql);
     86             } else {
     87                 resultList = new ArrayList();
     88             }
     89         } else {
     90             args[2] = RowBounds.DEFAULT;
     91             // 不需要分頁查詢,執行原方法,不走代理
     92             resultList = (List) invocation.proceed();
     93         }
     94         /**
     95          * 主要邏輯:
     96          * 從 ThreadLocal<Page> 中取出 page
     97          * 將 resultList 塞進 page,並返回
     98          */
     99         return runtimeDialect.afterPage(resultList, parameterObject, rowBounds);
    100     }
    101     ...
    102 }


    Count 查詢語句 countBoundSql 被執行了,分頁查詢語句 pageBoundSql 也被執行了。然後從 ThreadLocal<Page> 中將page 取出來,設置記錄總數,每頁條數等信息,同時也將查詢到的記錄塞進page,最後返回。再之後就是mybatis的常規後續操作了。


    知識拓展

    我們來看看 PageHelper 支持哪些數據庫的分頁操作:

    1. Oracle
    2. Mysql
    3. MariaDB
    4. SQLite
    5. Hsqldb
    6. PostgreSQL
    7. DB2
    8. SqlServer(2005,2008)
    9. Informix
    10. H2
    11. SqlServer2012
    12. Derby
    13. Phoenix

      原來 PageHelper 支持這麼多數據庫,那麼持久化工具mybatis為什麼不一口氣把分頁也做了呢? 其實mybatis也有自帶的分頁方法:RowBounds。
    RowBounds簡單地來說包括 offset 和 limit。實現原理是將所有符合條件的記錄獲取出來,然後丟棄 offset 之前的數據,只獲取 limit 條數據。這種做法效率低下,個人猜想mybatis只想把數據庫連接和SQL執行這方面做精做強,至於如分頁之類的細節,本身提供Intercept接口,讓第三方實現該接口來完成分頁。PageHelper 就是這樣的第三方分頁插件。甚至你可以實現該接口,製作你自己的業務邏輯,攔截到任何MyBatis允許你攔截的地方。  

    總結

    PageHelper 的分頁原理,最核心的部分是實現了 MyBatis 的 Interceptor 接口,從而將分頁參數攔截在執行sql之前,拼裝出分頁sql到數據庫中執行。 初始化的時候,因為 PageHelper 的 SqlUtil 中實例化了 intercept 方法,因此MyBatis 將它視作一個攔截器,記錄在 interceptorChain 中。 執行的時候,PageHelper首先將 page 需求記錄在 ThreadLocal<Page> 中,然後在攔截的時候,從 ThreadLocal<Page> 中取出 page,拼裝出分頁sql,然後執行。 同時將結果分頁信息(包括當前頁,每頁條數,總頁數,總記錄數等)設置回page,讓業務代碼可以獲取。  

    參考資料

    • PageHelper淺析:
    • MyBatis攔截器:
    • ThreadLocal理解:


    創作時間:2019-11-20 21:21


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※台灣寄大陸海運貨物規則及重量限制?

    ※大陸寄台灣海運費用試算一覽表

    ※台中搬家,彰化搬家,南投搬家前需注意的眉眉角角,別等搬了再說!