作者: admin

  • 前後端分離,我怎麼就選擇了 Spring Boot + Vue 技術棧?

    前後端分離,我怎麼就選擇了 Spring Boot + Vue 技術棧?

    前两天又有小夥伴私信松哥,問題還是職業規劃,Java 技術棧路線這種,實際上對於這一類問題我經常不太敢回答,每個人的情況都不太一樣,而小夥伴也很少詳細介紹自己的情況,大都是一兩句話就把問題拋出來了,啥情況都不了解,就要指出一個方向,這實在是太難了。

    因此今天我想從我學習 Spring Boot + Vue 這套技術棧的角度,來和大家聊一聊沒有人指導,我是如何一步一步建立起自己的技術體系的。

    線上大家看我經常寫文章,線下我其實比較宅,跟人交流比較少,我也很少問別人職業規劃或者技術規劃這些問題,因為這種學什麼的問題,我喜歡自己把握,我不太喜歡被別人牽着走。

    Rome was not built in a day,剛開始接觸 Spring Boot + Vue 時,我甚至都沒有一個明確的想法,只是覺得該學點什麼,不能讓時間浪費,沒有告訴我 Spring Boot 要火了,也沒有人告訴我 Vue 要超過 React 了,都是我自己一直在摸索摸索,一步一步,直到構建起這套技術大廈。

    Spring Boot

    先說說 Spring Boot 吧,三年前差不多也是這個時候,是我第一次接觸 Spring Boot ,那個時候我的正式身份還是一名 Android 工程師,那段時間在研究 Android7 的源碼,還寫了一些博客:

    但是那個時候 Android 的行情在慢慢下滑,而我剛畢業 1 年多,未來還有更加豐富的技術人生,我不願意這麼早就把技術棧定死,而且還定在一個行情日漸下滑的技術棧上。所以我打算學一點新的東西。

    Python、Go、前端 和 Java 都是備選的方向,但是最終還是選擇繼續做 Java,有三個原因:

    • 做 Java 當時可以在公司內部轉崗,做 Python 或者 Go 的話,可能就得換工作了,技術棧切換,一切從頭開始,當時心裏還是沒底,於是就選擇繼續做 Java
    • 剛好大學的時候也有 JavaEE 的底子,重新撿起來 JavaEE 相關的技術點倒也不是啥難事
    • 第三點也是最重要的一點,我一直希望能夠獨立接點私活,這樣有一天賺錢能夠不受工作地點的限制,基於這樣的初衷,我一直希望走全棧的路線,用 Python 和 Go 雖然也可以做企業級應用,但是在目前的技術環境下,這並不算是主流方案,主流方案依然是 Java ,雖然它被被多人吐槽

    基於以上三點,我決定還是走 Java 的方向吧。

    2016 年那會,CSDN 幾乎每個月送我一本技術圖書,10 月份的圖書我就和夢鴿美女要了一本 Spring Boot 相關的書,書到了之後,一直在忙各種事情沒時間看,到了當年 12 月份的時候,公司安排我去深圳出差,出差的話,每天下班后時間就比較充裕了,於是我就帶上了書,每天下班回到酒店,就開始搞 Spring Boot。

    一開始我就發現這玩意相比我大學時候搞得 XML 配置的 SSM 太好用了,還是 SSM 那套東西,但是有了自動化配置,不用再去寫讓人頭大的 XML 配置了,可以基於 Spring Boot 快速搞一個 SSM 應用出來。不過剛開始學的時候我還不知道 Spring Boot 在 Java 領域如此火爆,當我寫了幾篇博客之後,我發現每篇博客的閱讀量都暴漲,遠遠高於其他博客的閱讀,我隱隱約約感覺到這次稀里糊塗的技術棧切換,算是沒走錯路。

    不過老實說,Spring Boot 技術棧其實不算難,都是 SSM 那一套東西,只是多了自動化配置(當然,Spring Boot 也有不少自己的東西,不過整體上基於 SSM 這點應該沒啥爭議),我剛開始搞 Spring Boot 的時候,有時候會有一些東西看的雲里霧裡,後來發現問題出在 Spring + SpringMVC 上,好幾年不寫 JavaEE,這些東西有一點點生疏了,後來又花了一些時間把 SSM 這些東西系統過了一遍,然後再去看 Spring Boot 就順暢多了。

    所以有一些小夥伴問松哥能不能跳過 SSM 直接學習 Spring Boot,這個我不建議,大家在 Spring Boot 中見到的很多神奇的自動化配置大部分都是基於 Spring 現有功能實現的,要是不懂實現原理,你會發現 Spring Boot 用得時候雖然好用,但是出了問題,你就束手無策了。

    就這樣,跳入了 Spring Boot 的坑裡了。Spring Boot 學完沒多久,工作上,馬上要從 Android 切換到 JavaEE 了,亟需一個項目練練手,當時我的上司給我介紹了一個西藏大學的項目,我使用 Spring Boot+EasyUI 的技術棧花了不到一個禮拜做完了,從此就算是叩開了 JavaEE 的大門,那會是 2017 年。

    當時前端選擇 EasyUI 也是沒辦法,甲方催得緊,而我來不及搞其他的前端框架,當時只有 EasyUI 熟悉一些,不用花時間學,直接就能用,於是就選擇了 EasyUI,但是 EasyUI 太丑了,所以在做完西藏大學的項目后,我就一直思量着再整一個專業的前端框架,這樣以後再有私活,我就可以獨立做出來一個好看的後端管理系統了。

    就這樣,在綜合對比了 Vue、React 以及 Angular 之後,決定跳入 Vue 的坑。

    Vue

    前端其實還算接觸的比較早,最早的 jQuery Mobile,PhoneGap 上大學的時候就玩過,我的第一本 NodeJS 的書是在 2013 年買的,那個時候 NodeJS 還算是一個比較新的事物。當我還是一名 Android 工程師的時候,我就玩過 React 和 ReactNative,RN 是當時比較流行的一個跨平台解決方案。但是在我比較這三個技術棧的時候,我發現 Vue 更加好用,生態也更加豐富,而且大有超過 React 的架勢(當時 Vue 在 GitHub 上的 star 數還沒超過 React),於是我就選擇了 Vue。其實當時我心裏想,大不了學完 Vue 再學 React,反正我才剛畢業兩年多,沒必要這麼早就鎖定技術棧停止學習。

    Vue 的學習確實不費啥事,花了兩三天時間刷了一遍官網,然後就開始做項目,但是要去深入學習,又是一個漫長的過程了。

    Vue 有很多漂亮的 UI 庫,像 ElementUI 等都算是做的比較好的,這些東西只要會用其中一個,其他的就可以手到擒來。

    到 2018 年初,Spring Boot+Vue 技術棧基本上已經熟悉了,兩個開源項目 V 部落()和微人事()也受到小夥伴們的歡迎,常規的企業級應用可以一個人獨立完成了,5 月份的時候,經朋友介紹,接了哈爾濱工程大學一位老師的項目,毫無疑問我就使用了最擅長的 Spring Boot+Vue 技術棧來做了,前後端都是自己做,沒人扯皮,美滋滋。

    再後來,就是寫書(),業餘繼續搞點項目用 Spring Boot + Vue 來做,這些以前都和大家聊過我就不再多說了,業餘接點項目來做這塊倒是有一些經驗,以後和小夥伴們細聊。

    就這樣,沒有任何人的指引,我慢慢構建了 Spring Boot + Vue 這套技術體系,這個過程中,最大的學習經驗就是要寫博客,做筆記,寫博客不僅僅是記錄,也是總結提煉,在寫的過程中,融入自己的思考,加深對技術的理解。 掌握了這套技術棧之後,我覺得我離全棧又更近了一步,離賺錢不受工作地點的限制這個目標也更近一步了。

    結語

    有前輩大佬的指引,你可能走得快,自己摸索,走的踏實。其實從我第一天自學 Java 開始,基本上都是一直在摸索。大學時候一個 BUG 折騰兩三天才解決,但是一旦自己想明白解決了,以後類似的錯誤不會再犯,這是我的感受。

    好了,一點點學習經驗,和小夥伴們分享,要是覺得有啟發,歡迎轉發哦。

    掃碼關注松哥,公眾號後台回復 2TB,獲取松哥獨家 超2TB 學習資源

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※專營大陸空運台灣貨物推薦

    ※台灣空運大陸一條龍服務

    ※評比彰化搬家公司費用,南投搬家公司費用收費行情懶人包大公開

    ※彰化搬家費用,南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

  • 020.掌握Pod-Pod基礎使用

    020.掌握Pod-Pod基礎使用

    一 Pod定義詳解

    1.1 完整Pod定義文件

      1 apiVersion: v1			#必選,版本號,例如v1,版本號必須可以用 kubectl api-versions 查詢到
      2 kind: Pod				#必選,Pod
      3 metadata:				#必選,元數據
      4   name: string			#必選,Pod名稱,需符合RFC 1035規範
      5   namespace: string			#必選,Pod所屬的命名空間,默認為"default"
      6   labels:				#自定義標籤
      7     - name: string			#自定義標籤名字
      8   annotations:			#自定義註釋列表
      9     - name: string
     10 spec:				#必選,Pod中容器的詳細定義
     11   containers:			#必選,Pod中容器列表
     12   - name: string			#必選,容器名稱,需符合RFC 1035規範
     13     image: string			#必選,容器的鏡像名稱
     14     imagePullPolicy: [ Always|Never|IfNotPresent ]	#獲取鏡像的策略,Alawys表示每次都嘗試下載鏡像,IfnotPresent表示優先使用本地鏡像,否則下載鏡像,Nerver表示僅使用本地鏡像
     15     command: [string]		#容器的啟動命令列表,如不指定,使用打包時使用的啟動命令
     16     args: [string]			#容器的啟動命令參數列表
     17     workingDir: string		#容器的工作目錄
     18     volumeMounts:			#掛載到容器內部的存儲卷配置
     19     - name: string			#引用pod定義的共享存儲卷的名稱,需用volumes[]部分定義的的卷名
     20       mountPath: string		#存儲卷在容器內mount的絕對路徑,應少於512字符
     21       readOnly: boolean		#是否為只讀模式,默認為讀寫模式
     22     ports:				#需要暴露的端口庫號列表
     23     - name: string			#端口的名稱
     24       containerPort: int		#容器需要監聽的端口號
     25       hostPort: int		        #容器所在主機需要監聽的端口號,默認與Container相同
     26       protocol: string		#端口協議,支持TCP和UDP,默認TCP
     27     env:				#容器運行前需設置的環境變量列表
     28     - name: string			#環境變量名稱
     29       value: string		        #環境變量的值
     30     resources:			#資源限制和請求的設置
     31       limits:			#資源限制的設置
     32         cpu: string		        #CPU的限制,單位為core數,將用於docker run --cpu-shares參數
     33         memory: string		#內存限制,單位可以為Mib/Gib,將用於docker run --memory參數
     34       requests:			#資源請求的設置
     35         cpu: string		        #CPU請求,容器啟動的初始可用數量
     36         memory: string		#內存請求,容器啟動的初始可用數量
     37     livenessProbe:			#對Pod內各容器健康檢查的設置,當探測無響應幾次后將自動重啟該容器,檢查方法有exec、httpGet和tcpSocket,對一個容器只需設置其中一種方法即可
     38       exec:			        #對Pod容器內檢查方式設置為exec方式
     39         command: [string]		#exec方式需要制定的命令或腳本
     40       httpGet:			#對Pod內個容器健康檢查方法設置為HttpGet,需要制定Path、port
     41         path: string
     42         port: number
     43         host: string
     44         scheme: string
     45         HttpHeaders:
     46         - name: string
     47           value: string
     48       tcpSocket:			#對Pod內個容器健康檢查方式設置為tcpSocket方式
     49          port: number
     50        initialDelaySeconds: 0	#容器啟動完成后首次探測的時間,單位為秒
     51        timeoutSeconds: 0		#對容器健康檢查探測等待響應的超時時間,單位秒,默認1秒
     52        periodSeconds: 0		#對容器監控檢查的定期探測時間設置,單位秒,默認10秒一次
     53        successThreshold: 0
     54        failureThreshold: 0
     55        securityContext:
     56          privileged: false
     57     restartPolicy: [Always | Never | OnFailure]	#Pod的重啟策略,Always表示一旦不管以何種方式終止運行,kubelet都將重啟,OnFailure表示只有Pod以非0退出碼退出才重啟,Nerver表示不再重啟該Pod
     58     nodeSelector: obeject		#設置NodeSelector表示將該Pod調度到包含這個label的node上,以key:value的格式指定
     59     imagePullSecrets:		#Pull鏡像時使用的secret名稱,以key:secretkey格式指定
     60     - name: string
     61     hostNetwork: false		#是否使用主機網絡模式,默認為false,如果設置為true,表示使用宿主機網絡
     62     volumes:			#在該pod上定義共享存儲卷列表
     63     - name: string			#共享存儲卷名稱 (volumes類型有很多種)
     64       emptyDir: {}			#類型為emtyDir的存儲卷,與Pod同生命周期的一個臨時目錄。為空值
     65       hostPath: string		#類型為hostPath的存儲卷,表示掛載Pod所在宿主機的目錄
     66         path: string		#Pod所在宿主機的目錄,將被用於同期中mount的目錄
     67       secret:			#類型為secret的存儲卷,掛載集群與定義的secre對象到容器內部
     68         scretname: string
     69         items:
     70         - key: string
     71           path: string
     72       configMap:			#類型為configMap的存儲卷,掛載預定義的configMap對象到容器內部
     73         name: string
     74         items:
     75         - key: string
     76           path: string

    二 Pod的基本用法

    2.1 創建Pod


    Pod可以由1個或多個容器組合而成,通常對於緊耦合的兩個應用,應該組合成一個整體對外提供服務,則應該將這兩個打包為一個pod。

    屬於一個Pod的多個容器應用之間相互訪問只需要通過localhost即可通信,這一組容器被綁定在一個環境中。

      1 [root@k8smaster01 study]# vi frontend-localredis-pod.yaml
      2 apiVersion: v1
      3 kind: Pod
      4 metadata:
      5   name: redis-php
      6   label:
      7     name: redis-php
      8 spec:
      9   containers:
     10   - name: frontend
     11     image: kubeguide/guestbook-php-frontend:localredis
     12     ports:
     13     - containersPort: 80
     14   - name: redis-php
     15     image: kubeguide/redis-master
     16     ports:
     17     - containersPort: 6379
     18 
     19 [root@k8smaster01 study]# kubectl create -f frontend-localredis-pod.yaml
     20 


    2.2 查看Pod

      1 [root@k8smaster01 study]# kubectl get pods	                #READY為2/2,表示此Pod中運行了yaml定義的兩個容器
      2 NAME        READY   STATUS    RESTARTS   AGE
      3 redis-php   2/2     Running   0          7m45s
      4 [root@k8smaster01 study]# kubectl describe pod redis-php	#查看詳細信息
      5 


    三 靜態Pod

    3.1 靜態Pod概述


    靜態pod是由kubelet進行管理的僅存在於特定Node的Pod上,他們不能通過API Server進行管理,無法與ReplicationController、Deployment或者DaemonSet進行關聯,並且kubelet無法對他們進行健康檢查。靜態Pod總是由kubelet進行創建,並且總是在kubelet所在的Node上運行。

    創建靜態Pod有兩種方式:配置文件或者HTTP方式。

    3.2 配置文件方式創建

      1 [root@k8snode01 ~]# mkdir -p /etc/kubelet.d
      2 [root@k8snode01 ~]# vi /etc/kubelet.d/static-web.yaml
      3 apiVersion: v1
      4 kind: Pod
      5 metadata:
      6   name: static-web
      7   label:
      8     name: static-web
      9 spec:
     10   containers:
     11   - name: static-web
     12     image: nginx
     13     ports:
     14     - name: web
     15       containersPort: 80
     16 
     17 [root@k8snode01 ~]# vi /etc/systemd/system/kubelet.service
     18 ……
     19   --config=/etc/kubelet.d/ \·				#加入此參數
     20 ……
     21 [root@k8snode01 ~]# systemctl daemon-reload
     22 [root@k8snode01 ~]# systemctl restart kubelet.service	#重啟kubelet
     23 [root@k8snode01 ~]# docker ps				#查看創建的pod


    提示:由於靜態pod不能通過API Server進行管理,因此在Master節點執行刪除操作後會變為Pending狀態,且無法刪除。刪除該pod只能在其運行的node上,將定義POD的yaml刪除。

    3.3 HTTP方式


    通過設置kubelet的啟動參數–mainfest-url,會定期從該URL下載Pod的定義文件,並以.yaml或.json文件的格式進行解析,從而創建Pod。

    四 Pod容器共享Volume

    4.1 共享Volume


    在同一個Pod中的多個容器能夠共享Pod級別的存儲就Volume。Volume可以被定義為各種類型,多個容器各自進行掛載操作,將一個Volume掛載為容器內部需要的目錄。


    示例1:

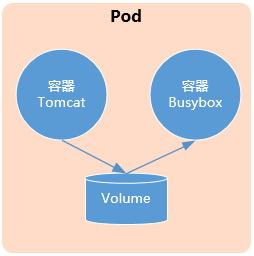
    Pod級別設置Volume “app-logs”,同時Pod包含兩個容器,Tomcat向該Volume寫日誌,busybox讀取日誌文件。

      1 [root@k8smaster01 study]# vi pod-volume-applogs.yaml
      2 apiVersion: v1
      3 kind: Pod
      4 metadata:
      5   name: volume-pod
      6 spec:
      7   containers:
      8   - name: tomcat
      9     image: tomcat
     10     ports:
     11     - containerPort: 8080
     12     volumeMounts:
     13     - name: app-logs
     14       mountPath: /usr/local/tomcat/logs
     15   - name: logreader
     16     image: busybox
     17     command: ["sh","-c","tail -f /logs/catalina*.log"]
     18     volumeMounts:
     19     - name: app-logs
     20       mountPath: /logs
     21   volumes:
     22   - name: app-logs
     23     emptyDir: {}

    解釋:

    Volume名:app-logs;

    emptyDir:為Pod分配到Node的時候創建。無需指定宿主機的目錄文件,為Kubernetes自動分配的目錄。

      1 [root@k8smaster01 study]# kubectl create -f pod-volume-applogs.yaml	#創建
      2 [root@k8smaster01 study]# kubectl get pods				#查看
      3 [root@k8smaster01 study]# kubectl logs volume-pod -c busybox	#讀取log


      1 [root@k8smaster01 study]# kubectl exec -it volume-pod -c tomcat -- ls /usr/local/tomcat/logs
      2 catalina.2019-06-29.log      localhost_access_log.2019-06-29.txt
      3 host-manager.2019-06-29.log  manager.2019-06-29.log
      4 localhost.2019-06-29.log
      5 [root@k8smaster01 study]# kubectl exec -it volume-pod -c tomcat -- tail /usr/local/tomcat/logs/catalina.2019-06-29.log


    提示:通過tomcat容器可查看日誌,對比busybox通過共享Volume查看的日誌是否一致。

    五 Pod配置管理

    5.1 Pod配置概述


    應用部署的一個最佳實踐是將應用所需的配置信息與程序進行分離,使程序更加靈活。將相應的應用打包為鏡像,可以通過環境變量或者外掛volume的方式在創建容器的時候進行配置注入,從而實現更好的復用。

    Kubernetes提供一種統一的應用配置管理方案:ConfigMap。

    5.2 ConfigMap概述


    ConfigMap供容器使用的主要場景:

    • 生成容器內部的環境變量;
    • 設置容器的啟動命令的參數(需設置為環境變量);
    • 以volume的形式掛載為容器內部的文件或者目錄。


    ConfigMap以一個或多個key:value的形式定義。value可以是string也可以是一個文件內容,可以通過yaml配置文件或者通過kubectl create configmap 的方式創建configMap。

    5.3 創建ConfigMap資源對象——yaml方式

      1 [root@k8smaster01 study]# vi cm-appvars.yaml
      2 apiVersion: v1
      3 kind: ConfigMap
      4 metadata:
      5   name: cm-appvars
      6 data:
      7   apploglevel: info
      8   appdatadir: /var/data
      9 
     10 [root@k8smaster01 study]# kubectl create -f cm-appvars.yaml
     11 configmap/cm-appvars created
     12 [root@k8smaster01 study]# kubectl get configmaps
     13 NAME         DATA   AGE
     14 cm-appvars   2      8s
     15 [root@k8smaster01 study]# kubectl describe configmaps cm-appvars


      1 [root@k8smaster01 study]# kubectl get configmaps cm-appvars -o yaml


    5.4 創建ConfigMap資源對象——命令行方式


    語法1

      1 # kubectl create configmap NAME --from-file=[key=]source --from-file=[key=]source


    解釋:通過–from-file參數從文件中創建,可以指定key名稱,也可以制定多個key。

    語法2

      1 # kubectl create configmap NAME --from-file=config-files-dir


    解釋:通過–from-file參數從目錄中創建,該目錄下的每個配置文件名都被設置為key,文件的內容被設置為value。

    語法3

      1 # kubectl create configmap NAME --from-literal=key1=value1 --from-literal=key2=value2


    解釋:通過–from-literal參數從文本中創建,直接將指定的key#=value#創建為ConfigMap的內容。

    5.5 Pod使用ConfigMap


    容器應用使用ConfigMap有兩種方式:

    • 通過環境變量獲取ConfigMap中的內容;
    • 通過Volume掛載的方式將ConfigMap中的內容掛載為容器內容的文件或目錄。

      1 [root@k8smaster01 study]# vi cm-test-pod.yaml
      2 apiVersion: v1
      3 kind: Pod
      4 metadata:
      5   name: cm-test-pod
      6 spec:
      7   containers:
      8   - name: cm-test
      9     image: busybox
     10     command: ["/bin/sh","-c","env|grep APP"]	#容器里執行查看環境變量的命令
     11     env:
     12     - name: APPLOGLEVEL				#定義容器環境變量名稱
     13       valueFrom:
     14         configMapKeyRef:			#環境變量的值來自ConfigMap
     15           name: cm-appvars			#指定來自cm-appvars的ConfigMap
     16           key: apploglevel			#key為apploglevel
     17     - name: APPDATADIR
     18       valueFrom:
     19         configMapKeyRef:
     20           name: cm-appvars
     21           key: appdatadir
     22 
     23 [root@k8smaster01 study]# kubectl create -f cm-test-pod.yaml
     24 [root@k8smaster01 study]# kubectl get pods
     25 NAME          READY   STATUS      RESTARTS   AGE
     26 cm-test-pod   0/1     Completed   2          24s


    【掛載形式-待補充】

    5.6 ConfigMap限制


    • Configmap必須在pod創建之間創建;
    • ConfigMap受到namespace的限制,只有同一個命名空間下才能引用;
    • ConfigMap暫時無法配置配額;
    • 靜態的pod無法使用ConfigMap;
    • 在使用volumeMount掛載的時候,configMap基於items創建的文件會整體的將掛載數據卷的容器的目錄下的文件全部覆蓋。

    六 Pod獲取自身信息

    6.1 Downward API


    pod擁有唯一的名字、IP地址,並且處於某個Namespace中。pod的容器內獲取pod的信息科通過Downward API實現。具體有以下兩種方式:

    • 環境變量:用於單個變量,可以將pod信息和container信息注入容器內部;
    • volume掛載:將數組類信息生成為文件,掛載至容器內部。


    舉例1:通過Downward API將Pod的IP、名稱和所在的Namespace注入容器的環境變量。

      1 [root@k8smaster01 study]# vi dapi-test-pod.yaml
      2 apiVersion: v1
      3 kind: Pod
      4 metadata:
      5   name: dapi-test-pod
      6 spec:
      7   containers:
      8     - name: test-container
      9       image: busybox
     10       command: [ "/bin/sh", "-c", "env" ]
     11       env:
     12         - name: MY_POD_NAME
     13           valueFrom:
     14             fieldRef:
     15               fieldPath: metadata.name
     16         - name: MY_POD_NAMESPACE
     17           valueFrom:
     18             fieldRef:
     19               fieldPath: metadata.namespace
     20         - name: MY_POD_IP
     21           valueFrom:
     22             fieldRef:
     23               fieldPath: status.podIP
     24   restartPolicy: Never


    提示:Downward API提供如下變量:

    metadata.name:Pod的名稱,當Pod通過RC生成時,其名稱是RC隨機產生的唯一名稱;

    status.podIP:Pod的IP地址,POd的IP屬於狀態數據,而非元數據;

    metadata.namespace:Pod所在的namespace。

      1 [root@k8smaster01 study]# kubectl create -f dapi-test-pod.yaml
      2 [root@k8smaster01 study]# kubectl logs dapi-test-pod | grep MY_POD
      3 MY_POD_NAMESPACE=default
      4 MY_POD_IP=172.30.240.4
      5 MY_POD_NAME=dapi-test-pod
      6 


    舉例2:通過Downward API將Container的自願請求和限制信息注入容器的環境變量。

      1 [root@k8smaster01 study]# vi dapi-test-pod-container-vars.yaml
      2 apiVersion: v1
      3 kind: Pod
      4 metadata:
      5   name: dapi-test-pod-container-vars
      6 spec:
      7   containers:
      8     - name: test-container
      9       image: busybox
     10       imagePullPolicy: Never
     11       command: [ "/bin/sh", "-c" ]
     12       args:
     13       - while true; do
     14           echo -en '\n';
     15           printenv MY_CPU_REQUEST MY_CPU_LIMIT;
     16           printenv MY_MEM_REQUEST MY_MEM_LIMIT;
     17           sleep 3600;
     18         done;
     19       resources:
     20         requests:
     21           memory: "32Mi"
     22           cpu: "125m"
     23         limits:
     24           memory: "64Mi"
     25           cpu: "250m"
     26       env:
     27         - name: MY_CPU_REQUEST
     28           valueFrom:
     29             resourceFieldRef:
     30               containerName: test-container
     31               resource: requests.cpu
     32         - name: MY_CPU_LIMIT
     33           valueFrom:
     34             resourceFieldRef:
     35               containerName: test-container
     36               resource: limits.cpu
     37         - name: MY_MEM_REQUEST
     38           valueFrom:
     39             resourceFieldRef:
     40               containerName: test-container
     41               resource: requests.memory
     42         - name: MY_MEM_LIMIT
     43           valueFrom:
     44             resourceFieldRef:
     45               containerName: test-container
     46               resource: limits.memory
     47   restartPolicy: Never


    提示:Downward API提供如下變量:

    requests.cpu:容器的CPU請求值;

    limits.cpu:容器的CPU限制值;

    requests.memory:容器的內存請求值;

    limits.memory:容器的內存限制值。

      1 [root@k8smaster01 study]# kubectl create -f dapi-test-pod-container-vars.yaml
      2 [root@k8smaster01 study]# kubectl logs dapi-test-pod-container-vars
      3 1
      4 1
      5 33554432
      6 67108864


    舉例3:通過Downward API將Pod的Label、Annotation列表通過Volume掛載為容器內的一個文件。

      1 [root@k8smaster01 study]# vi dapi-test-pod-volume.yaml
      2 apiVersion: v1
      3 kind: Pod
      4 metadata:
      5   name: dapi-test-pod-volume
      6   labels:
      7     zone: us-est-coast
      8     cluster: test-cluster1
      9     rack: rack-22
     10   annotations:
     11     build: two
     12     builder: john-doe
     13 spec:
     14   containers:
     15     - name: test-container
     16       image: busybox
     17       imagePullPolicy: Never
     18       command: [ "/bin/sh", "-c" ]
     19       args:
     20       - while true; do
     21           if [[ -e /etc/labels ]]; then
     22             echo -en '\n\n'; cat /etc/labels; fi;
     23           if [[ -e /etc/annotations ]]; then
     24             echo -en '\n\n'; cat /etc/annotations; fi;
     25           sleep 3600;
     26         done;
     27       volumeMounts:
     28         - name: podinfo
     29           mountPath: /etc
     30           readOnly: false
     31   volumes:
     32     - name: podinfo
     33       downwardAPI:
     34         items:
     35           - path: "labels"
     36             fieldRef:
     37               fieldPath: metadata.labels
     38           - path: "annotations"
     39             fieldRef:
     40               fieldPath: metadata.annotations


    注意:Volume中的ddownwardAPI的items語法,將會以path的名稱生成文件。如上所示,會在容器內生產/etc/labels和/etc/annotations兩個文件,分別包含metadata.labels和metadata.annotations的全部Label。

      1 [root@k8smaster01 study]# kubectl create -f dapi-test-pod-volume.yaml
      2 [root@k8smaster01 study]# kubectl logs dapi-test-pod-volume
      3 


    提示:DownwardAPI意義:

    在某些集群中,集群中的每個節點需要將自身的標識(ID)及進程綁定的IP地址等信息事先寫入配置文件中,進程啟動時讀取此類信息,然後發布到某個類似註冊服務中心。此時可通過DowanwardAPI,將一個預啟動腳本或Init Container,通過環境變量或文件方式獲取Pod自身的信息,然後寫入主程序配置文件中,最後啟動主程序。本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※試算大陸海運運費!
  • SpringBoot基本配置詳解

    SpringBoot基本配置詳解

    SpringBoot項目有一些基本的配置,比如啟動圖案(banner),比如默認配置文件application.properties,以及相關的默認配置項。

    示例項目代碼在:

    一、啟動圖案banner

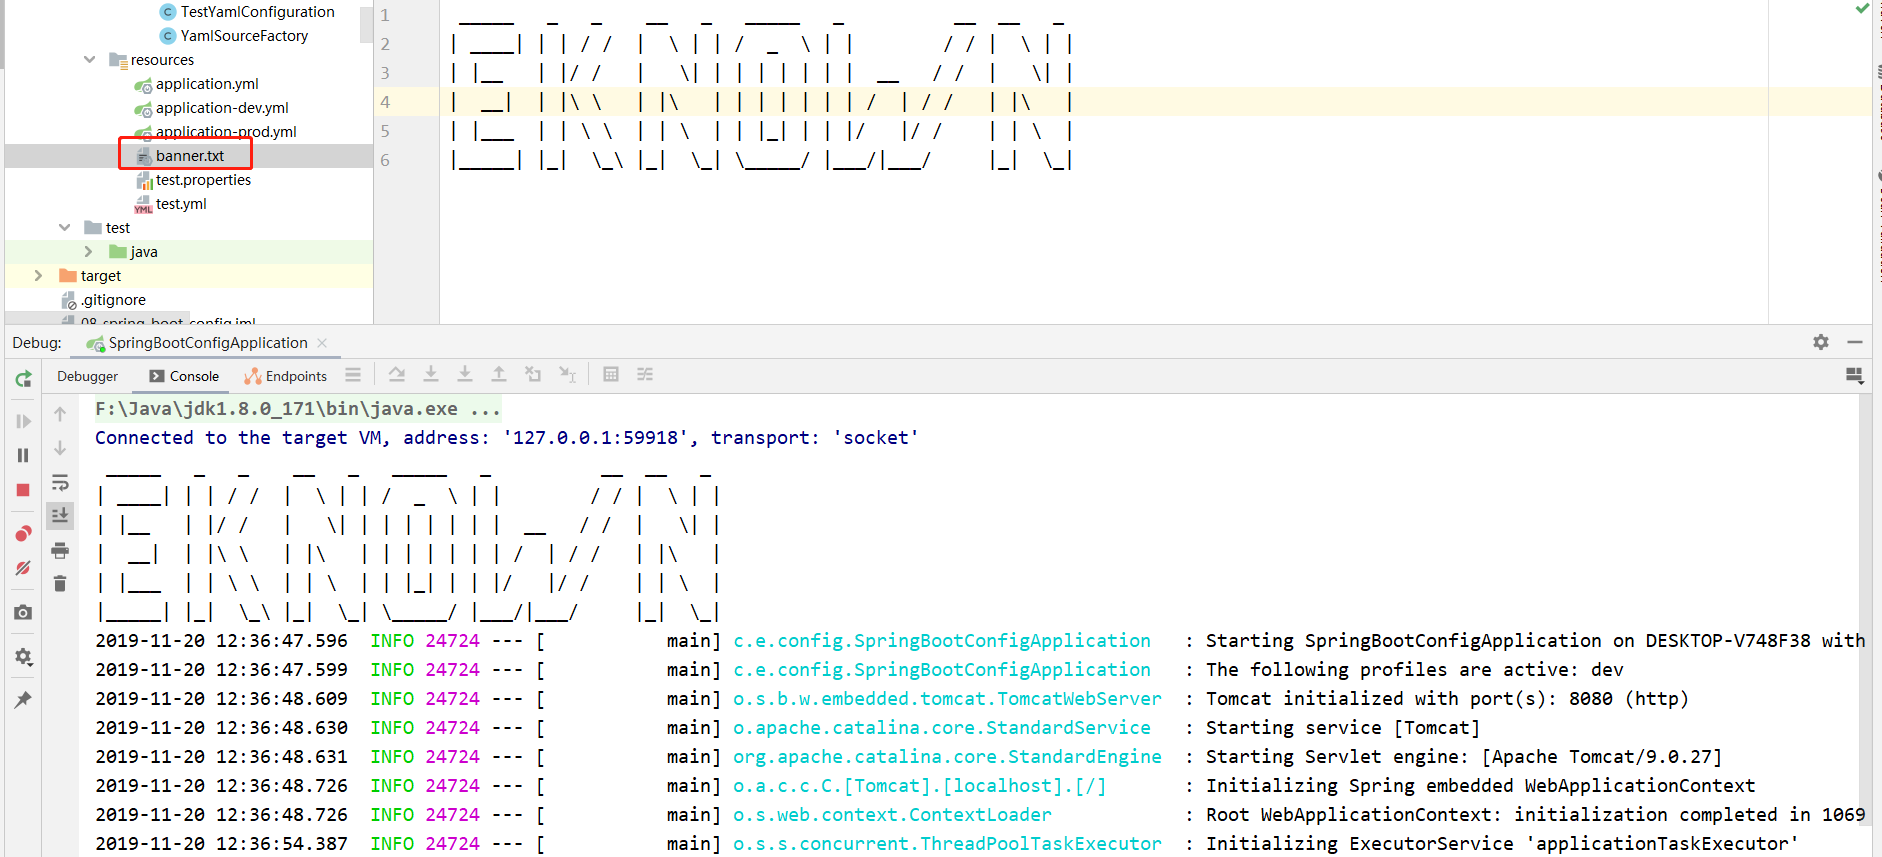
    編寫banner.txt放入resources文件夾下,然後啟動項目即可修改默認圖案。

    關於banner的生成,可以去一些專門的網站。

    比如:https://www.bootschool.net/ascii

    二、配置文件application

    2.1 application.properties/yml

    resources下通常會默認生成一個application.properties文件,這個文件包含了SpringBoot項目的全局配置文件。裏面的配置項通常是這樣的:

    server.port=8080

    在這個文件里我們可以添加框架支持的配置項,比如項目端口號、JDBC連接的數據源、日誌級別等等。

    現在比較流行的是將properties文件改為yml文件。yml文件的格式yaml是這樣的:

    server:
        port: 8080

    yml和properties的作用是一樣的。而yml的好處是顯而易見的——更易寫易讀。

    屬性之間互相調用使用${name}:

    eknown:
        email: eknown@163.com
        uri: http://www.eknown.cn
        title: 'hello, link to ${eknown.uri} or email to ${eknown.email}'

    鏈接:

    2.2 多環境配置文件

    通常開發一個應用會有多個環境,常見如dev/prod,也會有test,甚至其他一些自定義的環境,SpringBoot支持配置文件的靈活切換。

    定義新配置文件需要遵循以下格式:application-{profile}.properties 或者application-{profile}.yml

    比如現在有dev和prod兩個環境,我需要在application.yml文件之外新建兩個文件:

    1. application-dev.yml

      server:
         port: 8080
    2. application-prod.yml

      server:
        port: 8081

    然後在application.yml中通過application.profiles.active={profile}指明啟用那個配置:

    application:
        profiles:
          active: dev

    除了在application.yml中指定配置文件外,還可以通過啟動命令指定:java -jar xxx.jar --spring.profiles.active=dev

    2.2 自定義配置項並獲取它

    主要介紹兩種方式,獲取單個配置項和獲取多個配置項。

    舉例:

    eknown:
        email: eknown@163.com
        uri: http://www.eknown.cn

    2.2.1 使用@Value註解獲取單個配置項

    @Value("${eknown.email}")
    private String email;
    
    @Value("${eknown.uri}")
    private String url;

    注意:使用@Value註解的時候,所在類必須被Spring容器管理,也就是被@Component、@Controller、@Service等註解定義的類。

    2.2.2 獲取多個配置項

    第一種,定義一個bean類,通過@Value獲取多個配置項:

    @Component
    public class MyConfigBean {
      
    }

    然後我們通過get方法來獲取這些值:

    @RestController
    public class BasicAction {
      
      @Autowired
      private MyConfigBean myConfigBean;
    
    }

    第二種,使用註解@ConfigurationProperties:

    @Component
    @ConfigurationProperties(perfix="eknown")
    public class MyConfigBean {
    
      private String email;
      private String uri;
    }

    這裏只需要通過prefix指定前綴即可,後面的值自動匹配。

    這裏我們還使用了@Component註解來讓spring容器管理這個MyConfigBean。

    此外,我們可以不需要引入@Component,轉而在Application啟動類上加上@EnableConfigurationProperties({MyConfigBean.class})來啟動這個配置。

    注意:我們這裡是從主配置文件,也就是SpringBoot默認的application-profile文件中獲取配置數據的。

    而從自定義的配置文件,比如test.yml這種形式中獲取配置項時,情況是有點不大一樣的。

    三、自定義配置文件

    上面介紹的配置文件都是springboot默認的application開頭的文件。如果要自定義一個配置文件呢,比如test.yml或test.properties,怎麼獲取其中的配置項呢?

    使用@PageResource註解即可。

    首先我們來看一下讀取自定義的properties文件里的內容:

    test.properties

    hello.time=2019.11.19
    hello.name=eknown

    定義Configuration類:

    @Configuration
    @PropertySource("classpath:test.properties")
    //@PropertySource("classpath:test.yml") // 注意,yml文件不能直接這樣寫,會讀不出數據
    @ConfigurationProperties(prefix = "hello")
    public class TestConfiguration {
        private String name;
        private String time;
    
        // hide get and set methods
    }
    

    測試一下:

    @RestController
    @RequestMapping(value = "test")
    public class TestAction {
    
        @Autowired
        private TestConfiguration testConfiguration;
    
        @GetMapping(value = "config")
        public String test() {
            return testConfiguration.getName() + "<br/>" + testConfiguration.getTime();
        }
    }

    如果將properties文件換成yml文件呢?

    我們嘗試一下,發現:

    讀不出數據?

    分析一下@PropertySource註解,發現其使用的PropertySourceFactory是DefaultPropertySourceFactory.

    這個類的源碼如下:

    public class DefaultPropertySourceFactory implements PropertySourceFactory {
        public DefaultPropertySourceFactory() {
        }
    
        public PropertySource<?> createPropertySource(@Nullable String name, EncodedResource resource) throws IOException {
            return name != null ? new ResourcePropertySource(name, resource) : new ResourcePropertySource(resource);
        }
    }

    這個類只能處理properties文件,無法處理yml文件。所以我們需要自定義一個YmlSourceFactory。

    public class YamlSourceFactory extends DefaultPropertySourceFactory {
    
        @Override
        public PropertySource<?> createPropertySource(String name, EncodedResource resource) throws IOException {
            return new YamlPropertySourceLoader().load(resource.getResource().getFilename()
                    , resource.getResource()).get(0);
        }
    }

    然後定義test.yml文件的config類:

    @Configuration
    @PropertySource(value = "classpath:test.yml", encoding = "utf-8", factory = YamlSourceFactory.class)
    @ConfigurationProperties(prefix = "yml.hello")
    public class TestYamlConfiguration {
        private String name;
        private String time;
    
        // hide get and set methods
    }
    

    注:為了區分test.properties和test.yml,這裏的test.yml中的屬性以yml.hello開頭。

    編寫一下測試:

        @Autowired
        private TestYamlConfiguration ymlConfiguration;
    
        @GetMapping(value = "yml")
        public String testYml() {
            return "yml config: <br/>" + ymlConfiguration.getName() + "<br/>" + ymlConfiguration.getTime();
        }

    訪問:

    四、補充@ConfigurationProperties

    網上一些資料中,為配合使用@ConfigurationProperties,還使用了@EnableConfigurationProperties註解。

    經過測試發現:

    1. 從SpringBoot默認配置文件讀取配置信息,使用@ConfigurationProperties + @Component/@Configuration,或者@ConfigurationProperties + 在啟動類添加@EnableConfigurationProperties({class})。這兩種方式都能解決問題

    2. 從非默認配置文件讀取配置信息,需要利用@PropertySource註解。同樣兩種方式:

      2.1 @PropertySource + @ConfigurationProperties + @Component/@Configuration

      2.2 @PropertySource + @ConfigurationProperties + @Component/@Configuration + @EnableConfigurationProperties,第二種方式存在一個問題,即還是必須要使用@Component註解,如果不使用,則會導致讀取配置信息為null,但程序不會報錯;而如果採用了,則會導致bean類的set方法被執行兩次(也就是生成了兩個同樣類型的bean類)。這種方式不建議!

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※專營大陸快遞台灣服務

    ※台灣快遞大陸的貨運公司有哪些呢?

  • Appium+python自動化(四十一)-Appium自動化測試框架綜合實踐 – 即將落下帷幕(超詳解)

    Appium+python自動化(四十一)-Appium自動化測試框架綜合實踐 – 即將落下帷幕(超詳解)

    1.簡介

      今天我們緊接着上一篇繼續分享Appium自動化測試框架綜合實踐 – 代碼實現。到今天為止,大功即將告成;框架所需要的代碼實現都基本完成。

    2.data數據封裝

    2.1使用背景

    在實際項目過程中,我們的數據可能是存儲在一個數據文件中,如txt,excel、csv文件類型。我們可以封裝一些方法來讀取文件中的數據來實現數據驅動。

    2.2案例

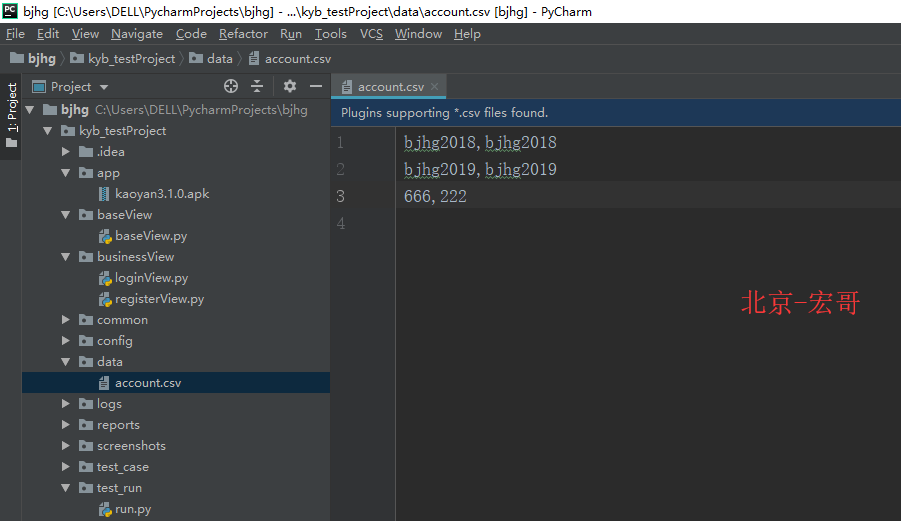
    將測試賬號存儲在account.csv文件,內容如下:

    account.csv

    hg2018

    hg2018

    hg2019

    zxw2019

    666

    222

    參考代碼

    2.3enumerate()簡介

    enumerate()是python的內置函數

    • enumerate在字典上是枚舉、列舉的意思
    • 對於一個可迭代的(iterable)/可遍歷的對象(如列表、字符串),enumerate將其組成一個索引序列,利用它可以同時獲得索引和值
    • enumerate多用於在for循環中得到計數。

    2.4enumerate()使用

    如果對一個列表,既要遍歷索引又要遍曆元素時,首先可以這樣寫:

    參考代碼
    list = ["這", "是", "一個", "測試","數據"]
    
    for i in range(len(list)):
    
        print(i,list[i])

    上述方法有些累贅,利用enumerate()會更加直接和優美:

    參考代碼
    list1 = ["這", "是", "一個", "測試","數據"]
    
    for index, item in enumerate(list1):
    
            print(index,item)

    3.數據讀取方法封裝

      數據讀取方法也屬於公共方法,這裏我們首先實現一下,然後將其封裝到裡邊即可。

    3.1數據讀取方法實現的參考代碼

    import csv
    
    
         def get_csv_data(csv_file,line):
    
            with open(csv_file, 'r', encoding='utf-8-sig') as file:
    
                reader=csv.reader(file)
    
                for index, row in enumerate(reader,1):
    
                    if index == line:
    
                        return row


        csv_file='../data/account.csv'
    
        data=get_csv_data(csv_file,3)
    
        print(data)

    3.2封裝

    將其封裝在公共方法中,在其他地方用到的時候,直接導入調用即可。

    4.utf-8與utf-8-sig兩種編碼格式的區別

    UTF-8以字節為編碼單元,它的字節順序在所有系統中都是一樣的,沒有字節序的問題,也因此它實際上並不需要BOM(“ByteOrder Mark”)。但是UTF-8 with BOM即utf-8-sig需要提供BOM。

    5.config文件配置

    各種配置文件都放在這個目錄下。

    5.1日誌文件配置 

    主要是一些日誌信息的配置。

    log.config

     參考代碼
    [loggers]
    keys=root,infoLogger
    
    [logger_root]
    level=DEBUG
    handlers=consoleHandler,fileHandler
    
    [logger_infoLogger]
    handlers=consoleHandler,fileHandler
    qualname=infoLogger
    propagate=0
    
    [handlers]
    keys=consoleHandler,fileHandler
    
    [handler_consoleHandler]
    class=StreamHandler
    level=INFO
    formatter=form02
    args=(sys.stdout,)
    
    [handler_fileHandler]
    class=FileHandler
    level=INFO
    formatter=form01
    args=('../logs/runlog.log', 'a')
    
    [formatters]
    keys=form01,form02
    
    [formatter_form01]
    format=%(asctime)s %(filename)s[line:%(lineno)d] %(levelname)s %(message)s
    
    [formatter_form02]
    format=%(asctime)s %(filename)s[line:%(lineno)d] %(levelname)s %(message)s

    6.測試用例封裝

    這裏宏哥舉例給小夥伴們演示:封裝註冊和登錄兩個測試用例。

    6.1測試用例執行開始結束操作封裝

    測試用例執行開始和結束的封裝,其他模塊用到直接導入,調用即可。

    myunit.py

    參考代碼
    # coding=utf-8
    # 1.先設置編碼,utf-8可支持中英文,如上,一般放在第一行
    
    # 2.註釋:包括記錄創建時間,創建人,項目名稱。
    '''
    Created on 2019-11-20
    @author: 北京-宏哥   QQ交流群:707699217
    Project:Appium自動化測試框架綜合實踐 - 代碼實現
    '''
    # 3.導入模塊
    import unittest
    from kyb_testProject.common.desired_caps import appium_desired
    import logging
    from time import sleep
    
    class StartEnd(unittest.TestCase):
        def setUp(self):
            logging.info('=====setUp====')
            self.driver=appium_desired()
    
        def tearDown(self):
            logging.info('====tearDown====')
            sleep(5)
            self.driver.close_app()

    6.2註冊用例

    開始註冊用例代碼邏輯的實現。

    test_register.py

    參考代碼
    # coding=utf-8
    # 1.先設置編碼,utf-8可支持中英文,如上,一般放在第一行
    
    # 2.註釋:包括記錄創建時間,創建人,項目名稱。
    '''
    Created on 2019-11-20
    @author: 北京-宏哥   QQ交流群:707699217
    Project:Appium自動化測試框架綜合實踐 - 代碼實現
    '''
    # 3.導入模塊
    from kyb_testProject.common.myunit import StartEnd
    from kyb_testProject.businessView.registerView import RegisterView
    import logging,random,unittest
    
    class RegisterTest(StartEnd):
        def test_user_register(self):
            logging.info('======test_user_register======')
            r=RegisterView(self.driver)
    
            username = 'bjhg2019' + 'fly' + str(random.randint(1000, 9000))
            password = 'bjhg2020' + str(random.randint(1000, 9000))
            email = 'bjhg' + str(random.randint(1000, 9000)) + '@163.com'
    
            self.assertTrue(r.register_action(username,password,email))
    
    if __name__ == '__main__':
        unittest.main()

    6.3登錄用例

    開始登錄用例代碼邏輯的實現。

    test_login.py

    參考代碼
    # coding=utf-8
    # 1.先設置編碼,utf-8可支持中英文,如上,一般放在第一行
    
    # 2.註釋:包括記錄創建時間,創建人,項目名稱。
    '''
    Created on 2019-11-13
    @author: 北京-宏哥   QQ交流群:707699217
    Project:Appium自動化測試框架綜合實踐 - 代碼實現
    '''
    # 3.導入模塊
    from kyb_testProject.common.myunit import StartEnd
    from kyb_testProject.businessView.loginView import LoginView
    import unittest
    import logging
    
    class TestLogin(StartEnd):
        csv_file='../data/account.csv'
    
        @unittest.skip('test_login_zxw2018')
        def test_login_zxw2018(self):
            logging.info('======test_login_zxw2018=====')
            l=LoginView(self.driver)
            data=l.get_csv_data(self.csv_file,2)
    
            l.login_action(data[0],data[1])
            self.assertTrue(l.check_loginStatus())
    
        # @unittest.skip('skip test_login_zxw2017')
        def test_login_zxw2017(self):
            logging.info('======test_login_zxw2017=====')
            l=LoginView(self.driver)
            data = l.get_csv_data(self.csv_file, 1)
    
            l.login_action(data[0], data[1])
            self.assertTrue(l.check_loginStatus())
    
        @unittest.skip('test_login_error')
        def test_login_error(self):
            logging.info('======test_login_error=====')
            l = LoginView(self.driver)
            data = l.get_csv_data(self.csv_file, 3)
    
            l.login_action(data[0], data[1])
            self.assertTrue(l.check_loginStatus(),msg='login fail!')
    
    if __name__ == '__main__':
        unittest.main()

    7.小結

    到此,Appium自動化測試框架就差下一篇就全部完成了,聰明的你都懂了嗎???嘿嘿!慢慢地來吧。

    下節預告

    下一篇,講解執行測試用例,生成測試報告,以及自動化平台,請關注宏哥,敬請期待!!!

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

    ※台灣海運大陸貨務運送流程

    ※兩岸物流進出口一站式服務

  • 一文帶你深入了解 Redis 的持久化方式及其原理

    一文帶你深入了解 Redis 的持久化方式及其原理

    Redis 提供了兩種持久化方式,一種是基於快照形式的 RDB,另一種是基於日誌形式的 AOF,每種方式都有自己的優缺點,本文將介紹 Redis 這兩種持久化方式,希望閱讀本文後你對 Redis 的這兩種方式有更加全面、清晰的認識。

    RDB 快照方式持久化

    先從 RDB 快照方式聊起,RDB 是 Redis 默認開啟的持久化方式,並不需要我們單獨開啟,先來看看跟 RDB 相關的配置信息:

    ################################ SNAPSHOTTING  ################################
    #
    # Save the DB on disk:
    #
    #   save <seconds> <changes>
    #
    #   Will save the DB if both the given number of seconds and the given
    #   number of write operations against the DB occurred.
    #
    #   In the example below the behaviour will be to save:
    #   after 900 sec (15 min) if at least 1 key changed
    #   after 300 sec (5 min) if at least 10 keys changed
    #   after 60 sec if at least 10000 keys changed
    #   save ""
    # 自動生成快照的觸發機制 中間的是時間,單位秒,後面的是變更數據 60 秒變更 10000 條數據則自動生成快照
    save 900 1
    save 300 10
    save 60 10000
    
    # 生成快照失敗時,主線程是否停止寫入
    stop-writes-on-bgsave-error yes
    
    # 是否採用壓縮算法存儲
    rdbcompression yes
    
    # 數據恢復時是否檢測 RDB文件有效性
    rdbchecksum yes
    
    # The filename where to dump the DB
    # RDB 快照生成的文件名稱
    dbfilename dump.rdb
    
    # 快照生成的路徑 AOF 也是存放在這個路徑下面
    dir .

    關於 RDB 相關配置信息不多,需要我們調整的就更少了,我們只需要根據自己的業務量修改生成快照的機制和文件存放路徑即可。

    RDB 有兩種持久化方式:手動觸發 和 自動觸發,手動觸發使用以下兩個命令:

    • save:會阻塞當前 Redis 服務器響應其他命令,直到 RDB 快照生成完成為止,對於內存 比較大的實例會造成長時間阻塞,所以線上環境不建議使用

    • bgsave:Redis 主進程會 fork 一個子進程,RDB 快照生成有子進程來負責,完成之後,子進程自動結束,bgsave 只會在 fork 子進程的時候短暫的阻塞,這個過程是非常短的,所以推薦使用該命令來手動觸發

    除了執行命令手動觸發之外,Redis 內部還存在自動觸發 RDB 的持久化機制,在以下幾種情況下 Redis 會自動觸發 RDB 持久化:

    • 在配置中配置了 save 相關配置信息,如我們上面配置文件中的 save 60 10000 ,也可以把它歸類為“save m n”格式的配置,表示 m 秒內數據集存在 n 次修改時,會自動觸發 bgsave。

    • 在主從情況下,如果從節點執行全量複製操作,主節點自動執行 bgsave 生成 RDB 文件併發送給從節點

    • 執行 debug reload 命令重新加載 Redis 時,也會自動觸發 save 操作

    • 默認情況下執行 shutdown 命令時,如果沒有開啟 AOF 持久化功能則自動執行 bgsave

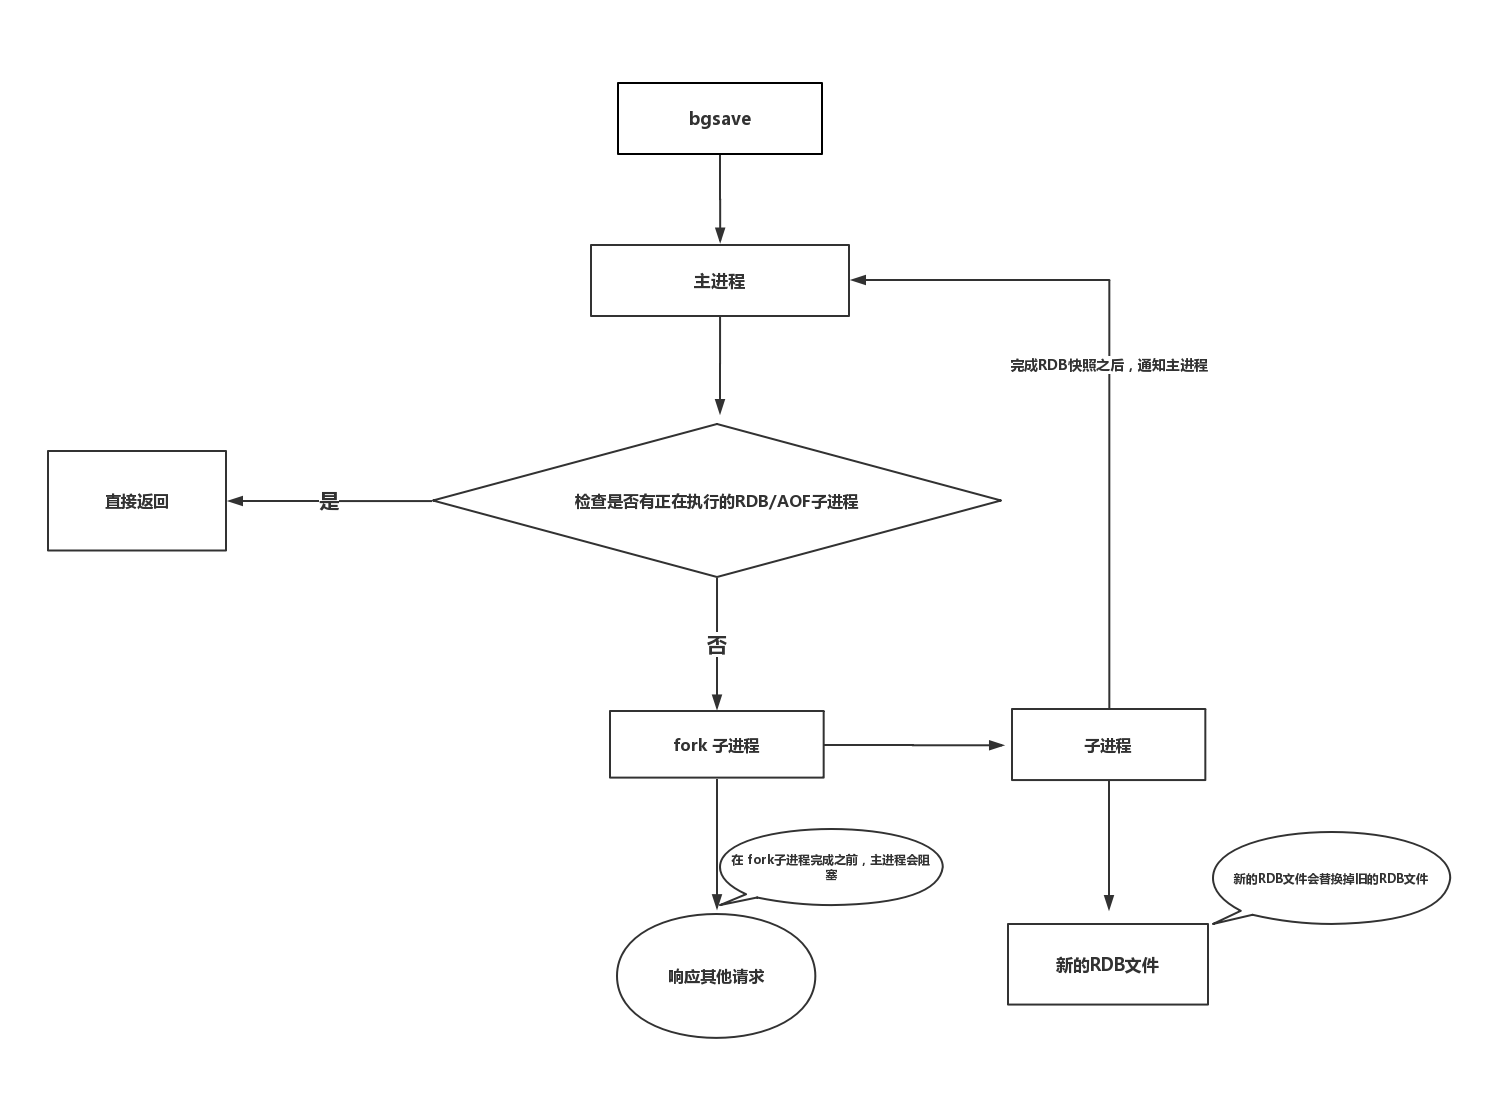
    上面就是 RDB 持久化的方式,可以看出 save 命令使用的比較少,大多數情況下使用的都是 bgsave 命令,所以這個 bgsave 命令還是有一些東西,那接下來我們就一起看看 bgsave 背後的原理,先從流程圖開始入手:

    bgsave 命令大概有以下幾個步驟:

    • 1、執行 bgsave 命令,Redis 主進程判斷當前是否存在正在執行的 RDB/AOF 子進程,如果存在, bgsave 命令直接返回不在往下執行。
    • 2、父進程執行 fork 操作創建子進程,fork 操作過程中父進程會阻塞,fork 完成後父進程將不在阻塞可以接受其他命令。
    • 3、子進程創建新的 RDB 文件,基於父進程當前內存數據生成臨時快照文件,完成後用新的 RDB 文件替換原有的 RDB 文件,並且給父進程發送 RDB 快照生成完畢通知

    上面就是 bgsave 命令背後的一些內容,RDB 的內容就差不多了,我們一起來總結 RDB 持久化的優缺點,RDB 方式的優點:

    • RDB 快照是某一時刻 Redis 節點內存數據,非常適合做備份,上傳到遠程服務器或者文件系統中,用於容災備份
    • 數據恢復時 RDB 要遠遠快於 AOF

    有優點同樣存在缺點,RDB 的缺點有:

    • RDB 持久化方式數據沒辦法做到實時持久化/秒級持久化。我們已經知道了 bgsave 命令每次運行都要執行 fork 操作創建子進程,屬於重量級操作,頻繁執行成本過高。
    • RDB 文件使用特定二進制格式保存,Redis 版本演進過程中有多個格式 的 RDB 版本,存在老版本 Redis 服務無法兼容新版 RDB 格式的問題

    如果我們對數據要求比較高,每一秒的數據都不能丟,RDB 持久化方式肯定是不能夠滿足要求的,那 Redis 有沒有辦法滿足呢,答案是有的,那就是接下來的 AOF 持久化方式

    AOF 持久化方式

    Redis 默認並沒有開啟 AOF 持久化方式,需要我們自行開啟,在 redis.conf 配置文件中將 appendonly no 調整為 appendonly yes,這樣就開啟了 AOF 持久化,與 RDB 不同的是 AOF 是以記錄操作命令的形式來持久化數據的,我們可以查看以下 AOF 的持久化文件 appendonly.aof

    *2
    $6
    SELECT
    $1
    0
    *3
    $3
    set
    $6
    mykey1
    $6
    你好
    *3
    $3
    set
    $4
    key2
    $5
    hello
    *1
    $8

    大概就是長這樣的,具體的你可以查看你 Redis 服務器上的 appendonly.aof 配置文件,這也意味着我們可以在 appendonly.aof 文件中國修改值,等 Redis 重啟時將會加載修改之後的值。看似一些簡單的操作命令,其實從命令到 appendonly.aof 這個過程中非常有學問的,下面時 AOF 持久化流程圖:

    在 AOF 持久化過程中有兩個非常重要的操作:一個是將操作命令追加到 AOF_BUF 緩存區,另一個是 AOF_buf 緩存區數據同步到 AOF 文件,接下來我們詳細聊一聊這兩個操作:

    1、為什麼要將命令寫入到 aof_buf 緩存區而不是直接寫入到 aof 文件?

    我們知道 Redis 是單線程響應,如果每次寫入 AOF 命令都直接追加到磁盤上的 AOF 文件中,這樣頻繁的 IO 開銷,Redis 的性能就完成取決於你的機器硬件了,為了提升 Redis 的響應效率就添加了一層 aof_buf 緩存層, 利用的是操作系統的 cache 技術,這樣就提升了 Redis 的性能,雖然這樣性能是解決了,但是同時也引入了一個問題,aof_buf 緩存區數據如何同步到 AOF 文件呢?由誰同步呢?這就是我們接下來要聊的一個操作:fsync 操作

    2、aof_buf 緩存區數據如何同步到 aof 文件中?

    aof_buf 緩存區數據寫入到 aof 文件是有 linux 系統去完成的,由於 Linux 系統調度機制周期比較長,如果系統故障宕機了,意味着一個周期內的數據將全部丟失,這不是我們想要的,所以 Linux 提供了一個 fsync 命令,fsync 是針對單個文件操作(比如這裏的 AOF 文件),做強制硬盤同步,fsync 將阻塞直到寫入硬盤完成后返回,保證了數據持久化,正是由於有這個命令,所以 redis 提供了配置項讓我們自行決定何時進行磁盤同步,redis 在 redis.conf 中提供了appendfsync 配置項,有如下三個選項:

    # appendfsync always
    appendfsync everysec
    # appendfsync no
    • always:每次有寫入命令都進行緩存區與磁盤數據同步,這樣保證不會有數據丟失,但是這樣會導致 redis 的吞吐量大大下降,下降到每秒只能支持幾百的 TPS ,這違背了 redis 的設計,所以不推薦使用這種方式
    • everysec:這是 redis 默認的同步機制,雖然每秒同步一次數據,看上去時間也很快的,但是它對 redis 的吞吐量沒有任何影響,每秒同步一次的話意味着最壞的情況下我們只會丟失 1 秒的數據, 推薦使用這種同步機制,兼顧性能和數據安全
    • no:不做任何處理,緩存區與 aof 文件同步交給系統去調度,操作系統同步調度的周期不固定,最長會有 30 秒的間隔,這樣出故障了就會丟失比較多的數據。

    這就是三種磁盤同步策略,但是你有沒有注意到一個問題,AOF 文件都是追加的,隨着服務器的運行 AOF 文件會越來越大,體積過大的 AOF 文件對 redis 服務器甚至是主機都會有影響,而且在 Redis 重啟時加載過大的 AOF 文件需要過多的時間,這些都是不友好的,那 Redis 是如何解決這個問題的呢?Redis 引入了重寫機制來解決 AOF 文件過大的問題。

    3、Redis 是如何進行 AOF 文件重寫的?

    Redis AOF 文件重寫是把 Redis 進程內的數據轉化為寫命令同步到新 AOF 文件的過程,重寫之後的 AOF 文件會比舊的 AOF 文件占更小的體積,這是由以下幾個原因導致的:

    • 進程內已經超時的數據不再寫入文件
    • 舊的 AOF 文件含有無效命令,如 del key1、hdel key2、srem keys、set a111、set a222等。重寫使用進程內數據直接生成,這樣新的AOF文件只保 留最終數據的寫入命令
    • 多條寫命令可以合併為一個,如:lpush list a、lpush list b、lpush list c可以轉化為:lpush list a b c。為了防止單條命令過大造成客戶端緩衝區溢 出,對於 list、set、hash、zset 等類型操作,以 64 個元素為界拆分為多條。

    重寫之後的 AOF 文件體積更小了,不但能夠節約磁盤空間,更重要的是在 Redis 數據恢復時,更小體積的 AOF 文件加載時間更短。AOF 文件重寫跟 RDB 持久化一樣分為手動觸發和自動觸發,手動觸發直接調用 bgrewriteaof 命令就好了,我們後面會詳細聊一聊這個命令,自動觸發就需要我們在 redis.conf 中修改以下幾個配置

    auto-aof-rewrite-percentage 100
    auto-aof-rewrite-min-size 64mb
    • auto-aof-rewrite-percentage:代表當前 AOF文件空間 (aof_current_size)和上一次重寫后 AOF 文件空間(aof_base_size)的比值,默認是 100%,也就是一樣大的時候
    • auto-aof-rewrite-min-size:表示運行 AOF 重寫時 AOF 文件最小體積,默認為 64MB,也就是說 AOF 文件最小為 64MB 才有可能觸發重寫

    滿足了這兩個條件,Redis 就會自動觸發 AOF 文件重寫,AOF 文件重寫的細節跟 RDB 持久化生成快照有點類似,下面是 AOF 文件重寫流程圖:

    AOF 文件重寫也是交給子進程來完成,跟 RDB 生成快照很像,AOF 文件重寫在重寫期間建立了一個 aof_rewrite_buf 緩存區來保存重寫期間主進程響應的命令,等新的 AOF 文件重寫完成后,將這部分文件同步到新的 AOF 文件中,最後用新的 AOF 文件替換掉舊的 AOF 文件。需要注意的是在重寫期間,舊的 AOF 文件依然會進行磁盤同步,這樣做的目的是防止重寫失敗導致數據丟失,

    Redis 持久化數據恢復

    我們知道 Redis 是基於內存的,所有的數據都存放在內存中,由於機器宕機或者其他因素重啟了就會導致我們的數據全部丟失,這也就是要做持久化的原因,當服務器重啟時,Redis 會從持久化文件中加載數據,這樣我們的數據就恢復到了重啟前的數據,在數據恢復這一塊Redis 是如何實現的?我們先來看看數據恢復的流程圖:

    Redis 的數據恢複流程比較簡單,優先恢復的是 AOF 文件,如果 AOF 文件不存在時則嘗試加載 RDB 文件,為什麼 RDB 的恢復速度比 AOF 文件快,但是還是會優先加載 AOF 文件呢?我個人認為是 AOF 文件數據更全面並且 AOF 兼容性比 RDB 強,需要注意的是當存在 RDB/AOF 時,如果數據加載不成功,Redis 服務啟動會失敗。

    最後

    目前互聯網上很多大佬都有 Redis 系列教程,如有雷同,請多多包涵了。原創不易,碼字不易,還希望大家多多支持。若文中有所錯誤之處,還望提出,謝謝。

    歡迎掃碼關注微信公眾號:「平頭哥的技術博文」,和平頭哥一起學習,一起進步。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※小三通海運與一般國際貿易有何不同?

    ※小三通快遞通關作業有哪些?

  • Netty學習篇⑤–編、解碼源碼分析

    Netty學習篇⑤–編、解碼源碼分析

    前言

    學習Netty也有一段時間了,Netty作為一個高性能的異步框架,很多RPC框架也運用到了Netty中的知識,在rpc框架中豐富的數據協議及編解碼可以讓使用者更加青睞;
    Netty支持豐富的編解碼框架,其本身內部提供的編解碼也可以應對各種業務場景;
    今天主要就是學習下Netty中提供的編、解碼類,之前只是簡單的使用了下Netty提供的解碼類,今天更加深入的研究下Netty中編、解碼的源碼及部分使用。

    編、解碼的概念

    • 編碼(Encoder)

      編碼就是將我們發送的數據編碼成字節數組方便在網絡中進行傳輸,類似Java中的序列化,將對象序列化成字節傳輸
    • 解碼(Decoder)

      解碼和編碼相反,將傳輸過來的字節數組轉化為各種對象來進行展示等,類似Java中的反序列化
      如:
      // 將字節數組轉化為字符串
      new String(byte bytes[], Charset charset)

    編、解碼超類

    ByteToMessageDecoder: 解碼超類,將字節轉換成消息

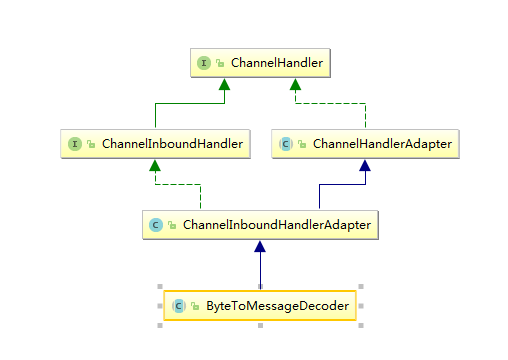
    解碼解碼一般用於將獲取到的消息解碼成系統可識別且自己需要的數據結構;因此ByteToMessageDecoder需要繼承ChannelInboundHandlerAdapter入站適配器來獲取到入站的數據,在handler使用之前通過channelRead獲取入站數據進行一波解碼;
    ByteToMessageDecoder類圖

    源碼分析

    通過channelRead獲取入站數據,將數據緩存至cumulation數據緩衝區,最後在傳給decode進行解碼,在read完成之後清空緩存的數據

    1. 獲取入站數據

    /**
    *  通過重寫channelRead方法來獲取入站數據
    */
    @Override
    public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
        // 檢測是否是byteBuf對象格式數據
        if (msg instanceof ByteBuf) {
            // 實例化字節解碼成功輸出集合 即List<Object> out
            CodecOutputList out = CodecOutputList.newInstance();
            try {
                // 獲取到的請求的數據
                ByteBuf data = (ByteBuf) msg;
                // 如果緩衝數據區為空則代表是首次觸發read方法
                first = cumulation == null;
                if (first) {
                    // 如果是第一次read則當前msg數據為緩衝數據
                    cumulation = data;
                } else {
                    // 如果不是則觸發累加,將緩衝區的舊數據和新獲取到的數據通過        expandCumulation 方法累加在一起存入緩衝區cumulation
                    // cumulator 累加類,將緩衝池中數據和新數據進行組合在一起
                    // private Cumulator cumulator = MERGE_CUMULATOR;
                    cumulation = cumulator.cumulate(ctx.alloc(), cumulation, data);
                }
                // 將緩衝區數據cumulation進行解碼
                callDecode(ctx, cumulation, out);
            } catch (DecoderException e) {
                throw e;
            } catch (Throwable t) {
                throw new DecoderException(t);
            } finally {
                // 在解碼完畢后釋放引用和清空全局字節緩衝區
                if (cumulation != null && !cumulation.isReadable()) {
                    numReads = 0;
                    cumulation.release();
                    cumulation = null;
                    // discardAfterReads為netty中設置的讀取多少次后開始丟棄字節 默認值16
                    // 可通過setDiscardAfterReads(int n)來設置值不設置默認16次
                } else if (++ numReads >= discardAfterReads) {
                    // We did enough reads already try to discard some bytes so we not risk to see a OOME.
                    // 在我們讀取了足夠的數據可以嘗試丟棄一些字節已保證不出現內存溢出的異常
                    // 
                    // See https://github.com/netty/netty/issues/4275
                    // 讀取次數重置為0
                    numReads = 0;
                    // 重置讀寫指針或丟棄部分已讀取的字節
                    discardSomeReadBytes();
                }
                // out為解碼成功的傳遞給下一個handler
                int size = out.size();
                decodeWasNull = !out.insertSinceRecycled();
                // 結束當前read傳遞到下個ChannelHandler
                fireChannelRead(ctx, out, size);
                // 回收響應集合 將insertSinceRecycled設置為false;
                // insertSinceRecycled用於channelReadComplete判斷使用
                out.recycle();
            }
        } else {
            // 不是的話直接fire傳遞給下一個handler
            ctx.fireChannelRead(msg);
        }
    }
    
    2. 初始化字節緩衝區計算器: Cumulator主要用於全局字節緩衝區和新讀取的字節緩衝區組合在一起擴容
    public static final Cumulator MERGE_CUMULATOR = new Cumulator() {
        
        /**
        * alloc ChannelHandlerContext分配的字節緩衝區
        * cumulation 當前ByteToMessageDecoder類全局的字節緩衝區
        * in 入站的字節緩衝區
        **/
        @Override
        public ByteBuf cumulate(ByteBufAllocator alloc, ByteBuf cumulation, ByteBuf in) {
            final ByteBuf buffer;
            // 如果全局ByteBuf寫入的字節+當前入站的字節數據大於全局緩衝區最大的容量或者全局緩衝區的引用數大於1個或全局緩衝區只讀
            if (cumulation.writerIndex() > cumulation.maxCapacity() - in.readableBytes()
                || cumulation.refCnt() > 1 || cumulation.isReadOnly()) {
                // Expand cumulation (by replace it) when either there is not more room in the buffer
                // or if the refCnt is greater then 1 which may happen when the user use slice().retain() or
                // duplicate().retain() or if its read-only.
                //
                // See:
                // - https://github.com/netty/netty/issues/2327
                // - https://github.com/netty/netty/issues/1764
                // 進行擴展全局字節緩衝區(容量大小 = 新數據追加到舊數據末尾組成新的全局字節緩衝區)
                buffer = expandCumulation(alloc, cumulation, in.readableBytes());
            } else {
                buffer = cumulation;
            }
            // 將新數據寫入緩衝區
            buffer.writeBytes(in);
            // 釋放當前的字節緩衝區的引用
            in.release();
            
            return buffer;
        }
    };
    
    
    /**
    * alloc 字節緩衝區操作類
    * cumulation 全局累加字節緩衝區
    * readable 讀取到的字節數長度
    */
    // 字節緩衝區擴容方法
    static ByteBuf expandCumulation(ByteBufAllocator alloc, ByteBuf cumulation, int readable) {
        // 舊數據
        ByteBuf oldCumulation = cumulation;
        // 通過ByteBufAllocator將緩衝區擴大到oldCumulation + readable大小
        cumulation = alloc.buffer(oldCumulation.readableBytes() + readable);
        // 將舊數據重新寫入到新的字節緩衝區
        cumulation.writeBytes(oldCumulation);
        // 舊字節緩衝區引用-1
        oldCumulation.release();
        return cumulation;
    }
    3. ByteBuf釋放當前字節緩衝區的引用: 通過調用ReferenceCounted接口中的release方法來釋放
    @Override
    public boolean release() {
        return release0(1);
    }
    
    @Override
    public boolean release(int decrement) {
        return release0(checkPositive(decrement, "decrement"));
    }
    
    /**
    * decrement 減量
    */
    private boolean release0(int decrement) {
        for (;;) {
            int refCnt = this.refCnt;
            // 當前引用小於減量
            if (refCnt < decrement) {
                throw new IllegalReferenceCountException(refCnt, -decrement);
            }
            // 這裏就利用里線程併發中的知識CAS,線程安全的設置refCnt的值
            if (refCntUpdater.compareAndSet(this, refCnt, refCnt - decrement)) {
                // 如果減量和引用量相等
                if (refCnt == decrement) {
                    // 全部釋放
                    deallocate();
                    return true;
                }
                return false;
            }
        }
    }

    4. 將全局字節緩衝區進行解碼

    /**
    * ctx ChannelHandler的上下文,用於傳輸數據與下一個handler來交互
    * in 入站數據
    * out 解析之後的出站集合 (此出站不是返回給客戶端的而是傳遞給下個handler的)
    */
    protected void callDecode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) {
        try {
            // 如果入站數據還有沒解析的
            while (in.isReadable()) {
                // 解析成功的出站集合長度
                int outSize = out.size();
                // 如果大於0則說明解析成功的數據還沒被消費完,直接fire掉給通道中的後續handler繼續                消費
                if (outSize > 0) {
                    fireChannelRead(ctx, out, outSize);
                    out.clear();
    
                    // Check if this handler was removed before continuing with decoding.
                    // 在這個handler刪除之前檢查是否還在繼續解碼
                    // If it was removed, it is not safe to continue to operate on the buffer.
                    // 如果移除了,它繼續操作緩衝區是不安全的
                    //
                    // See:
                    // - https://github.com/netty/netty/issues/4635
                    if (ctx.isRemoved()) {
                        break;
                    }
                    outSize = 0;
                }
                // 入站數據字節長度
                int oldInputLength = in.readableBytes();
                // 開始解碼數據
                decodeRemovalReentryProtection(ctx, in, out);
    
                // Check if this handler was removed before continuing the loop.
                // 
                // If it was removed, it is not safe to continue to operate on the buffer.
                //
                // See https://github.com/netty/netty/issues/1664
                if (ctx.isRemoved()) {
                    break;
                }
    
                // 解析完畢跳出循環
                if (outSize == out.size()) {
                    if (oldInputLength == in.readableBytes()) {
                        break;
                    } else {
                        continue;
                    }
                }
    
                if (oldInputLength == in.readableBytes()) {
                    throw new DecoderException(
                        StringUtil.simpleClassName(getClass()) +
                        ".decode() did not read anything but decoded a message.");
                }
    
                if (isSingleDecode()) {
                    break;
                }
            }
        } catch (DecoderException e) {
            throw e;
        } catch (Throwable cause) {
            throw new DecoderException(cause);
        }
    }
    
    final void decodeRemovalReentryProtection(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) throws Exception {
            // 設置解碼狀態為正在解碼  STATE_INIT = 0; STATE_CALLING_CHILD_DECODE = 1;             STATE_HANDLER_REMOVED_PENDING = 2; 分別為初始化; 解碼; 解碼完畢移除
            decodeState = STATE_CALLING_CHILD_DECODE;
            try {
                // 具體的解碼邏輯(netty提供的解碼器或自定義解碼器中重寫的decode方法)
                decode(ctx, in, out);
            } finally {
                // 此時decodeState為正在解碼中 值為1,返回false
                boolean removePending = decodeState == STATE_HANDLER_REMOVED_PENDING;
                // 在設置為初始化等待解碼
                decodeState = STATE_INIT;
                // 解碼完成移除當前ChannelHandler標記為不處理
                // 可以看看handlerRemoved源碼。如果緩衝區還有數據直接傳遞給下一個handler
                if (removePending) {
                    handlerRemoved(ctx);
                }
            }
        }
    5. 執行channelReadComplete
    @Override
    public void channelReadComplete(ChannelHandlerContext ctx) throws Exception {
        // 讀取次數重置
        numReads = 0;
        // 重置讀寫index
        discardSomeReadBytes();
        // 在channelRead meth中定義賦值 decodeWasNull = !out.insertSinceRecycled();
        // out指的是解碼集合List<Object> out; 咱們可以點進
        if (decodeWasNull) {
            decodeWasNull = false;
            if (!ctx.channel().config().isAutoRead()) {
                ctx.read();
            }
        }
        // fire掉readComplete傳遞到下一個handler的readComplete
        ctx.fireChannelReadComplete();
    }
    
    /**
    *  然後我們可以搜索下insertSinceRecucled在什麼地方被賦值了
    * Returns {@code true} if any elements where added or set. This will be reset once {@link #recycle()} was called.
    */
    boolean insertSinceRecycled() {
        return insertSinceRecycled;
    }
    
    
    // 搜索下insert的調用我們可以看到是CodecOutputList類即為channelRead中的out集合,眾所周知在    decode完之後,解碼數據就會被調用add方法,此時insertSinceRecycled被設置為true
    private void insert(int index, Object element) {
        array[index] = element;
        insertSinceRecycled = true;
    }
    
    
    /**
    * 清空回收數組內部的所有元素和存儲空間
    * Recycle the array which will clear it and null out all entries in the internal storage.
    */
    // 搜索recycle的調用我么可以知道在channelRead的finally邏輯中 調用了out.recycle();此時        insertSinceRecycled被設置為false
    void recycle() {
        for (int i = 0 ; i < size; i ++) {
            array[i] = null;
        }
        clear();
        insertSinceRecycled = false;
        handle.recycle(this);
    }
    

    至此ByteToMessageDecoder解碼類應該差不多比較清晰了!!!

    MessageToByteEncoder: 編碼超類,將消息轉成字節進行編碼發出

    何謂編碼,就是將發送數據轉化為客戶端和服務端約束好的數據結構和格式進行傳輸,我們可以在編碼過程中將消息體body的長度和一些頭部信息有序的設置到ByteBuf字節緩衝區中;方便解碼方靈活的運用來判斷(是否完整的包等)和處理業務;解碼是繼承入站數據,反之編碼應該繼承出站的數據;接下來我們看看編碼類是怎麼進行編碼的;
    MessageToByteEncoder類圖如下

    源碼分析

    既然是繼承出站類,我們直接看看write方法是怎麼樣的

    /**
    * 通過write方法獲取到出站的數據即要發送出去的數據
    * ctx channelHandler上下文
    * msg 發送的數據 Object可以通過繼承類指定的泛型來指定
    * promise channelPromise異步監聽,類似ChannelFuture,只不過promise可以設置監聽的結果,future只能通過獲取監聽的成功失敗結果;可以去了解下promise和future的區別
    */
    @Override
    public void write(ChannelHandlerContext ctx, Object msg, ChannelPromise promise) throws Exception {
        ByteBuf buf = null;
        try {
            // 檢測發送數據的類型 通過TypeParameterMatcher類型匹配器
            if (acceptOutboundMessage(msg)) {
                @SuppressWarnings("unchecked")
                I cast = (I) msg;
                // 分配字節緩衝區 preferDirect默認為true
                buf = allocateBuffer(ctx, cast, preferDirect);
                try {
                    // 進行編碼
                    encode(ctx, cast, buf);
                } finally {
                    // 完成編碼后釋放對象的引用
                    ReferenceCountUtil.release(cast);
                }
                // 如果緩衝區有數據則通過ctx發送出去,promise可以監聽數據傳輸並設置是否完成
                if (buf.isReadable()) {
                    ctx.write(buf, promise);
                } else {
                    // 如果沒有數據則釋放字節緩衝區的引用併發送一個empty的空包
                    buf.release();
                    ctx.write(Unpooled.EMPTY_BUFFER, promise);
                }
                buf = null;
            } else {
                // 非TypeParameterMatcher類型匹配器匹配的類型直接發送出去
                ctx.write(msg, promise);
            }
        } catch (EncoderException e) {
            throw e;
        } catch (Throwable e) {
            throw new EncoderException(e);
        } finally {
            if (buf != null) {
                buf.release();
            }
        }
    }
    
    // 初始化設置preferDirect為true
    protected MessageToByteEncoder() {
        this(true);
    }
    protected MessageToByteEncoder(boolean preferDirect) {
        matcher = TypeParameterMatcher.find(this, MessageToByteEncoder.class, "I");
        this.preferDirect = preferDirect;
    }

    編碼: 重寫encode方法,根據實際業務來進行數據編碼

    // 此處就是我們需要重寫的編碼方法了,我們和根據約束好的或者自己定義好想要的數據格式發送給對方
    
    // 下面是我自己寫的demo的編碼方法;頭部設置好body的長度,服務端可以根據長度來判斷是否是完整的包,僅僅自學寫的簡單的demo非正常線上運營項目的邏輯
    public class MyClientEncode extends MessageToByteEncoder<String> {
    
        @Override
        protected void encode(ChannelHandlerContext ctx, String msg, ByteBuf out) throws Exception {
            if (null != msg) {
                byte[] request = msg.getBytes(Charset.forName("UTF-8"));
                out.writeInt(request.length);
                out.writeBytes(request);
            }
        }
    }

    編碼類相對要簡單很多,因為只需要將發送的數據序列化,按照一定的格式進行發送數據!!!

    項目實戰

    項目主要簡單的實現下自定義編解碼器的運用及LengthFieldBasedFrameDecoder的使用

    • 項目結構如下
      │  hetangyuese-netty-06.iml
      │  pom.xml
      │
      ├─src
      │  ├─main
      │  │  ├─java
      │  │  │  └─com
      │  │  │      └─hetangyuese
      │  │  │          └─netty
      │  │  │              ├─client
      │  │  │              │      MyClient06.java
      │  │  │              │      MyClientChannelInitializer.java
      │  │  │              │      MyClientDecoder.java
      │  │  │              │      MyClientEncode.java
      │  │  │              │      MyClientHandler.java
      │  │  │              │      MyMessage.java
      │  │  │              │
      │  │  │              └─server
      │  │  │                      MyChannelInitializer.java
      │  │  │                      MyServer06.java
      │  │  │                      MyServerDecoder.java
      │  │  │                      MyServerDecoderLength.java
      │  │  │                      MyServerEncoder.java
      │  │  │                      MyServerHandler.java
      │  │  │
      │  │  └─resources
      │  └─test
      │      └─java
      
    • 服務端

      Serverhandler: 只是簡單的將解碼的內容輸出

      public class MyServerHandler extends ChannelInboundHandlerAdapter {
      
          @Override
          public void channelActive(ChannelHandlerContext ctx) throws Exception {
              System.out.println("客戶端連接成功 time: " + new Date().toLocaleString());
          }
      
          @Override
          public void channelInactive(ChannelHandlerContext ctx) throws Exception {
              System.out.println("客戶端斷開連接 time: " + new Date().toLocaleString());
          }
      
          @Override
          public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
              String body = (String) msg;
              System.out.println("content:" + body);
          }
      
          @Override
          public void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) throws Exception {
              // 出現異常關閉通道
              cause.printStackTrace();
              ctx.close();
          }
      }

      解碼器

      public class MyServerDecoder extends ByteToMessageDecoder {
      
          // 此處我頭部只塞了長度字段佔4個字節,別問為啥我知道,這是要客戶端和服務端約束好的
          private static int min_head_length = 4;
      
          @Override
          protected void decode(ChannelHandlerContext ctx, ByteBuf in, List<Object> out) throws Exception {
              // 解碼的字節長度
              int size = in.readableBytes();
              if(size < min_head_length) {
                  System.out.println("解析的數據長度小於頭部長度字段的長度");
                  return ;
              }
              // 讀取的時候指針已經移位到長度字段的尾端
              int length = in.readInt();
              if (size < length) {
                  System.out.println("解析的數據長度與長度不符合");
                  return ;
              }
      
              // 上面已經讀取到了長度字段,後面的長度就是body
              ByteBuf decoderArr = in.readBytes(length);
              byte[] request = new byte[decoderArr.readableBytes()];
              // 將數據寫入空數組
              decoderArr.readBytes(request);
              String body = new String(request, Charset.forName("UTF-8"));
              out.add(body);
          }
      }

      將解碼器加入到channelHandler中:記得加到業務handler的前面否則無效

      public class MyChannelInitializer extends ChannelInitializer<SocketChannel> {
      
          @Override
          protected void initChannel(SocketChannel ch) throws Exception {
              ch.pipeline()
      //                .addLast(new MyServerDecoderLength(10240, 0, 4, 0, 0))
      //                .addLast(new LengthFieldBasedFrameDecoder(10240, 0, 4, 0, 0))
                      .addLast(new MyServerDecoder())
                      .addLast(new MyServerHandler())
              ;
          }
      }
    • 客戶端

      ClientHandler

      public class MyClientHandler extends ChannelInboundHandlerAdapter {
      
          @Override
          public void channelActive(ChannelHandlerContext ctx) throws Exception {
              System.out.println("與服務端連接成功");
              for (int i = 0; i<10; i++) {
                  ctx.writeAndFlush("hhhhh" + i);
              }
          }
      
          @Override
          public void channelInactive(ChannelHandlerContext ctx) throws Exception {
              System.out.println("與服務端斷開連接");
          }
      
          @Override
          public void channelRead(ChannelHandlerContext ctx, Object msg) throws Exception {
              System.out.println("收到服務端消息:" +msg+ " time: " + new Date().toLocaleString());
          }
      
          @Override
          public void exceptionCaught(ChannelHandlerContext ctx, Throwable cause) throws Exception {
              cause.printStackTrace();
              ctx.close();
          }
      }

      編碼器

      public class MyClientEncode extends MessageToByteEncoder<String> {
      
          @Override
          protected void encode(ChannelHandlerContext ctx, String msg, ByteBuf out) throws Exception {
              if (null != msg) {
                  byte[] request = msg.getBytes(Charset.forName("UTF-8"));
                  out.writeInt(request.length);
                  out.writeBytes(request);
              }
          }
      }

      將編碼器加到ClientHandler的前面

      public class MyClientChannelInitializer extends ChannelInitializer<SocketChannel> {
      
          @Override
          protected void initChannel(SocketChannel ch) throws Exception {
              ch.pipeline()
                      .addLast(new MyClientDecoder())
                      .addLast(new MyClientEncode())
                      .addLast(new MyClientHandler())
              ;
      
          }
      }
    • 服務端運行結果
      MyServer06 is start ...................
      客戶端連接成功 time: 2019-11-19 16:35:47
      content:hhhhh0
      content:hhhhh1
      content:hhhhh2
      content:hhhhh3
      content:hhhhh4
      content:hhhhh5
      content:hhhhh6
      content:hhhhh7
      content:hhhhh8
      content:hhhhh9
    • 如果不用自定義的解碼器怎麼獲取到body內容呢

      將自定義編碼器換成LengthFieldBasedFrameDecoder(10240, 0, 4, 0, 0)

      public class MyChannelInitializer extends ChannelInitializer<SocketChannel> {
      
          @Override
          protected void initChannel(SocketChannel ch) throws Exception {
              ch.pipeline()
      //                .addLast(new MyServerDecoderLength(10240, 0, 4, 0, 0))
                      .addLast(new LengthFieldBasedFrameDecoder(10240, 0, 4, 0, 0))
      //                .addLast(new MyServerDecoder())
                      .addLast(new MyServerHandler())
              ;
          }
      }
      
      // 怕忘記的各個參數的含義在這在說明一次,自己不斷的修改每個值觀察結果就可以更加深刻的理解
      /**
      * maxFrameLength:消息體的最大長度,好像默認最大值為1024*1024
      * lengthFieldOffset 長度字段所在字節數組的下標 (我這是第一個write的所以下標是0)
      * lengthFieldLength 長度字段的字節長度(int類型佔4個字節)
      * lengthAdjustment 長度字段補償的數值 (lengthAdjustment =  數據包長度 - lengthFieldOffset - lengthFieldLength - 長度域的值),解析需要減去對應的數值
      * initialBytesToStrip 是否去掉長度字段(0不去除,對應長度域字節長度)
      */
      public LengthFieldBasedFrameDecoder(
                  int maxFrameLength,
                  int lengthFieldOffset, int lengthFieldLength,
                  int lengthAdjustment, int initialBytesToStrip)
      結果: 前都帶上了長度
      MyServer06 is start ...................
      客戶端連接成功 time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh0, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh1, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh2, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh3, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh4, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh5, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh6, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh7, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh8, time: 2019-11-19 17:53:42
      收到客戶端發來的消息:   hhhhh9, time: 2019-11-19 17:53:42

      如果我們在客戶端的長度域中做手腳 LengthFieldBasedFrameDecoder(10240, 0, 4, 0, 0)

      舊: out.writeInt(request.length);
      新: out.writeInt(request.length + 1);
      // 看結果就不正常,0後面多了一個0;但是不知道為啥只解碼了一次??? 求解答
      MyServer06 is start ...................
      客戶端連接成功 time: 2019-11-19 17:56:55
      收到客戶端發來的消息:   hhhhh0 , time: 2019-11-19 17:56:55
      
      // 正確修改為 LengthFieldBasedFrameDecoder(10240, 0, 4, -1, 0)
      // 結果:
      MyServer06 is start ...................
      客戶端連接成功 time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh0, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh1, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh2, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh3, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh4, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh5, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh6, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh7, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh8, time: 2019-11-19 18:02:18
      收到客戶端發來的消息:   hhhhh9, time: 2019-11-19 18:02:18

      捨棄長度域 :LengthFieldBasedFrameDecoder(10240, 0, 4, 0, 4)

      // 結果
      MyServer06 is start ...................
      客戶端連接成功 time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh0, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh1, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh2, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh3, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh4, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh5, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh6, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh7, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh8, time: 2019-11-19 18:03:44
      收到客戶端發來的消息:hhhhh9, time: 2019-11-19 18:03:44
      分析源碼示例中的 lengthAdjustment = 消息字節長度 – lengthFieldOffset-lengthFieldLength-長度域中的值
    • 源碼中的示例
       * <pre>
       * lengthFieldOffset   =  0
       * lengthFieldLength   =  2
       * <b>lengthAdjustment</b>    = <b>-2</b> (= the length of the Length field)
       * initialBytesToStrip =  0
       *
       * BEFORE DECODE (14 bytes)         AFTER DECODE (14 bytes)
       * +--------+----------------+      +--------+----------------+
       * | Length | Actual Content |----->| Length | Actual Content |
       * | 0x000E | "HELLO, WORLD" |      | 0x000E | "HELLO, WORLD" |
       * +--------+----------------+      +--------+----------------+
       * </pre>
      長度域中0x000E為16進制,轉換成10進制是14,說明消息體長度為14;根據公式:14-0-2-14 = -2
      * <pre>
       * lengthFieldOffset   = 0
       * lengthFieldLength   = 3
       * <b>lengthAdjustment</b>    = <b>2</b> (= the length of Header 1)
       * initialBytesToStrip = 0
       *
       * BEFORE DECODE (17 bytes)                      AFTER DECODE (17 bytes)
       * +----------+----------+----------------+      +----------+----------+----------------+
       * |  Length  | Header 1 | Actual Content |----->|  Length  | Header 1 | Actual Content |
       * | 0x00000C |  0xCAFE  | "HELLO, WORLD" |      | 0x00000C |  0xCAFE  | "HELLO, WORLD" |
       * +----------+----------+----------------+      +----------+----------+----------------+
       * </pre>
      從上的例子可以知道;lengthAdjustment(2) = 17- 12(00000C)-lengthFieldOffset(0) - lengthFieldLength(3);

      …….等等

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※試算大陸海運運費!
  • Hadoop壓縮的圖文教程

    Hadoop壓縮的圖文教程

    近期由於Hadoop集群機器硬盤資源緊張,有需求讓把 Hadoop 集群上的歷史數據進行下壓縮,開始從網上查找的都是關於各種壓縮機制的對比,很少有關於怎麼壓縮的教程(我沒找到。。),再此特記錄下本次壓縮的過程,方便以後查閱,利己利人。


    本文涉及的所有 jar包、腳本、native lib 見文末的相關下載 ~


    我的壓縮版本: 

    Jdk 1.7及以上

    Hadoop-2.2.0 版本


    壓縮前環境準備:

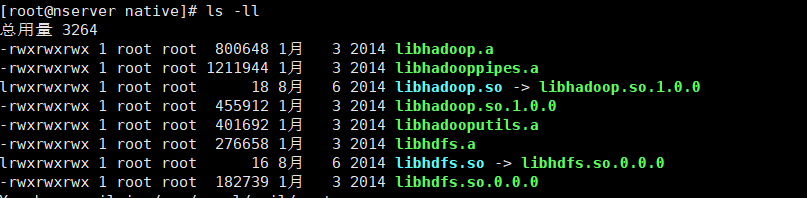
    關於壓縮算法對比,網上資料很多,這裏我用的是 Bzip2 的壓縮方式,比較中庸,由於是Hadoop自帶的壓縮機制,也不需要額外下載別的東西,只需要在 Hadoop根目錄下 lib/native 文件下有如下文件即可:


    壓縮之前要檢查 Hadoop 集群支持的壓縮算法: hadoop checknative

    每台機器都要檢查一下,都显示如圖 true 則說明 集群支持 bzip2 壓縮,

    如果显示false 則需要將上圖的文件下載拷貝到 Hadoop根目錄下 lib/native


    壓縮程序介紹:


    壓縮程序用到的類 getFileList(獲取文件路徑) 、 FileHdfsCompress(壓縮類)、FileHdfsDeCompress(解壓縮類) ,只用到這三個類即可完成壓縮/解壓縮操作。


    getFileList 作用:遞歸打印 傳入文件目錄下文件的根路徑,包括子目錄下的文件。開始想直接輸出到文件中,後來打包放到集群上運行時,發現文件沒有內容,可能是由於分佈式運行的關係,所以就把路徑打印出來,人工在放到文件中。


    核心代碼:
    public static void listAllFiles(String path, List<String> strings) throws IOException {
            FileSystem hdfs = getHdfs(path);
            Path[] filesAndDirs = getFilesAndDirs(path);
    
            for(Path p : filesAndDirs){
                if(hdfs.getFileStatus(p).isFile()){
                    if(!p.getName().contains("SUCCESS")){
                        System.out.println(p);
                    }
                }else{
                    listAllFiles(p.toString(),strings);
                }
            }
           // FileUtils.writeLines(new File(FILE_LIST_OUTPUT_PATH), strings,true);
    
        }

    public static FileSystem getHdfs(String path) throws IOException {
            Configuration conf = new Configuration();
            return FileSystem.get(URI.create(path),conf);
        }
    
    
    public static Path[] getFilesAndDirs(String path) throws IOException { FileStatus[] fs = getHdfs(path).listStatus(new Path(path)); return FileUtil.stat2Paths(fs); }


     FileHdfsCompress:壓縮程序非常簡單,對應程序里的 FileHdfsCompress 類,(解壓縮是 FileHdfsDeCompress),採用的是Hadoop 原生API  ,將Hadoop集群上原文件讀入作為輸入流,將壓縮路徑的輸入流作為輸出,再使用相關的壓縮算法即,代碼如下:


    核心代碼:
    
     //指定壓縮方式
                Class<?> codecClass = Class.forName(COMPRESS_CLASS_NAME);
    
                Configuration conf = new Configuration();
                CompressionCodec codec = (CompressionCodec)ReflectionUtils.newInstance(codecClass, conf);
                // FileSystem fs = FileSystem.get(conf);
                FileSystem fs = FileSystem.get(URI.create(inputPath),conf);
    
                //原文件路徑 txt 用原本的輸入流讀入
                FSDataInputStream in = fs.open(new Path(inputPath));
    
                //創建 HDFS 上的輸出流,壓縮路徑
                //通過文件系統獲取輸出流
                OutputStream out = fs.create(new Path(FILE_OUTPUT_PATH));
                //對輸出流的數據壓縮
                CompressionOutputStream compressOut = codec.createOutputStream(out);
                //讀入原文件 壓縮到HDFS上 輸入--普通流  輸出-壓縮流
                IOUtils.copyBytes(in, compressOut, 4096,true);


    以下是代碼優化的過程,不涉及壓縮程序使用,不感興趣同學可以跳過 ~ :


    在實際編碼中,我其實是走了彎路的,一開始並沒有想到用 Hadoop API 就能實現壓縮解壓縮功能,代碼到此其實是經歷了優化迭代的過程。


    最開始時壓縮的思路就是 將文件讀進來,再壓縮出去,一開始使用了 MapReduce 的方式,在編碼過程中,由於對生成壓縮文件的路徑還有要求,又在 Hadoop 輸出時自定義了輸出類來使的輸出文件的名字符合要求,不是 part-r-0000.txt ,而是時間戳.txt 的格式,至此符合原線上路徑的要求。


    而在實際運行過程中發現,MR 程序需要啟動 Yarn,並佔用Yarn 資源,由於壓縮時間較長,有可能會長時間佔用 集群資源不釋放,後來發現 MR 程序的初衷是用來做并行計算的,而壓縮僅僅是 map 任務讀取一條就寫一條,不涉及計算,就是內容的簡單搬運。所以這裏放棄了使用 MR 想着可不可以就用簡單的 Hadoop API 就完成壓縮功能,經過一番嘗試后,發現真的可行! 使用了 Hadoop API 釋放了集群資源,壓縮速度也還可以,這樣就把這個壓縮程序當做一個後台進程跑就行了也不用考慮集群資源分配的問題。


    實測壓縮步驟:


    1 將項目打包,上傳到hadoop 集群任一節點即可,準備好相應的腳本,輸入數據文件,日誌文件,如下圖:


    2 使用獲取文件路徑腳本,打印路徑: 


    getFileLish.sh 腳本內容如下,就是簡單調用,傳入參數為 hadoop集群上 HDFS 上目錄路徑:

    #!/bin/sh
    
    echo "begin get fileList"
    
    echo "第一個參數$1"
    
    if [ ! -n "$1" ]; then
    echo "check param!"
    fi
    
    #original file
    hadoop jar hadoop-compress-1.0.jar com.people.util.getFileList  $1


    3 將 打印的路徑 粘貼到 compress.txt 中,第 2 步中會把目錄的文件路徑包括子目錄路徑都打印出來,將其粘貼進  compress.txt 中即可,注意 文件名可隨意定。


    4 使用壓縮腳本即可,sh compress.sh /data/new_compress/compress.txt  ,加粗的部分是腳本的參數意思是 第3步中文件的路徑,注意:這裏只能是絕對路徑,不然可能報找不到文件的異常。


     compress.sh 腳本內容如下,就是簡單調用,傳入參數為 第3步中文件的絕對路徑:


    #!/bin/sh
    echo "begin compress"
    
    echo "第一個參數$1"
    
    if [ ! -n "$1" ]; then
    echo "check param!"
    fi
    
    
    hadoop jar hadoop-compress-1.0.jar com.people.compress.FileHdfsCompress  $1 >> /data/new_compress/compress.log 2>&1 &


    5 查看壓縮日誌,發現後台程序已經開始壓縮了!,tail  -f  compress.log


    6 如果感覺壓縮速度不夠,可以多台機器執行腳本,也可以一台機器執行多個任務,因為這個腳本任務是一個後台進程,不會佔用集群 Yarn 資源。


     相關下載:


    程序源碼下載: git@github.com:fanpengyi/hadoop-compress.git


    Hadoop 壓縮相關需要的 腳本、jar包、lib 下載: 關注公眾號 “大數據江湖”,後台回復 “hadoop壓縮”,即可下載


    長按即可關注


     — The End —


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※專營大陸快遞台灣服務

    ※台灣快遞大陸的貨運公司有哪些呢?

  • Thrift總結(四)Thrift實現雙向通信

    Thrift總結(四)Thrift實現雙向通信

    前面介紹過 Thrift 安裝和使用,介紹了Thrift服務的發布和客戶端調用,可以查看我之前的文章:

    但是,之前介紹的都是單向的客戶端發送消息,服務端接收消息。而客戶端卻得不到服務器的響應。

    那如果我們要實現雙向通信(即:客戶端發送請求,服務端處理返回,服務端發送消息,客戶端處理返回)的功能,該怎麼實現呢?


    其實在不涉及語言平台的制約,WebService或是webapi 就可以實現這種客戶端發起請求,服務端的處理的單向流程。

    然而,實際場景中,可能我們的某些業務需求,更需要服務端能夠響應請求並處理數據。下面我通過一個demo案例,介紹下Thrift 是如何實現雙向通信的。


    一、安裝Thrift

    這裏不再贅述,戳這裏查看我上篇文章的介紹:


    二、編寫Thrift IDL文件 

    編寫thrift腳本,命名為student.thrift  如下:

    service HelloWorldService{
        void SayHello(1:string msg);
    }

    生成service 的方法,之前的文章有介紹,這裏就不介紹了。


    三、編寫服務端代碼

    創建HelloThrift.Server 服務端工程,添加HelloWorldBidirectionServer類,HelloWorldBidirectionServer 實現了Iface接口用於接收客戶端消息,並有一個客戶端傳輸層對象集合用於記錄所有已連接的客戶端。

     public class HelloWorldBidirectionServer : HelloWorldBidirectionService.Iface
        {
            public void Run(int port)
            {
                try
                {
                    TServerTransport transport = new TServerSocket(port);
    
                    TTransportFactory transportFac = new TTransportFactory();
    
                    TProtocolFactory inputProtocolFactory = new TBinaryProtocol.Factory();
                    TThreadPoolServer server = new TThreadPoolServer(getProcessorFactory(), transport, transportFac, inputProtocolFactory);
    
                    server.Serve();
                }
                catch (Exception ex)
                {
                    Console.WriteLine(ex.Message);
                }
            }
    
            public static List<TTransport> TransportCollection = new List<TTransport>();
    
            public void SayHello(string msg)
            {
                Console.WriteLine(string.Format("{0:yyyy/MM/dd hh:mm:ss} 服務端接收到消息: {1}", DateTime.Now, msg));
            }
    
            public void SayToClient(string msg)
            {
                try
                {
                    foreach (TTransport trans in TransportCollection)
                    {
                        TBinaryProtocol protocol = new TBinaryProtocol(trans);
                        HelloWorldBidirectionService.Client client = new HelloWorldBidirectionService.Client(protocol);
                        //Thread.Sleep(1000);
                        client.SayHello(msg);
                        //Console.WriteLine("發給了客戶端喲");
                    }
                }
                catch (Exception ex)
                {
                    Console.WriteLine(ex.Message);
                }
            }
    
            public TProcessorFactory getProcessorFactory()
            {
                return new HelloWorldBidirectionProcessor();
            }
        }
    
        public class HelloWorldBidirectionProcessor : TProcessorFactory
        {
            public TProcessor GetProcessor(TTransport trans, TServer server = null)
            {
                if (trans.IsOpen)
                {
                    HelloWorldBidirectionServer.TransportCollection.Add(trans);
                    Console.WriteLine("客戶端連上。");
                }
    
                HelloWorldBidirectionServer srv = new HelloWorldBidirectionServer();
                return new global::HelloWorldBidirectionService.Processor(srv);
            }
        }


    四、編寫客戶端代碼

    首先創建HelloThrift.Client客戶端項目,添加接收服務端消息的類HelloWorldBidirectionClient,裏面只有一個實現Iface接口的方法:

      public class HelloWorldBidirectionClient
        {
            static HelloWorldBidirectionService.Client client = null;
            public void ConnectAndListern(int port, string ip = "127.0.0.1")
            {
                //Tsocket: TCP/IP Socket接口
                TSocket tSocket = new TSocket(ip, port);
                //消息結構協議
                TProtocol protocol = new TBinaryProtocol(tSocket);
                try
                {
                    if (client == null)
                    {
                        client = new global::HelloWorldBidirectionService.Client(protocol);
                        tSocket.Open();//建立連接
                        StartListern(tSocket);//啟動監聽線程
                    }
                }
                catch (Exception ex)
                {
                    Console.WriteLine(ex.Message);
                }
            }
    
            public void Say(string msg)
            {
                if (client != null)
                    client.SayHello(msg);
            }
    
            void StartListern(TSocket tSocket)
            {
                Thread t = new Thread(new ParameterizedThreadStart(Run));
                t.Start(tSocket);
            }
    
            public void Run(object tSocket)
            {
                HelloWorldBidirectionService.Processor process = new HelloWorldBidirectionService.Processor(new HelloWorldBidirectionFace());
    
                try
                {
                    while (process.Process(new TBinaryProtocol((TSocket)tSocket), new TBinaryProtocol((TSocket)tSocket)))
                    {
                        Console.WriteLine("消息接收完成,等下一波,阻塞中......");
                    }
                }
                catch (Exception ex)
                {
                    Console.WriteLine("連接斷開..." + ex.Message);
                }
            }
    
        }
        class HelloWorldBidirectionFace : HelloWorldBidirectionService.Iface
        {
            public void SayHello(string msg)
            {
                Console.WriteLine(string.Format("{0:yyyy/MM/dd hh:mm:ss} 收到服務端響應消息 {1}", DateTime.Now, msg));
    
            }
        }

     實現客戶端,ConnectAndListern方法可以與服務端建立連接,並開啟客戶端端口監聽來自服務端的信息。Say方法可將消息發送至服務端。


    五、測試

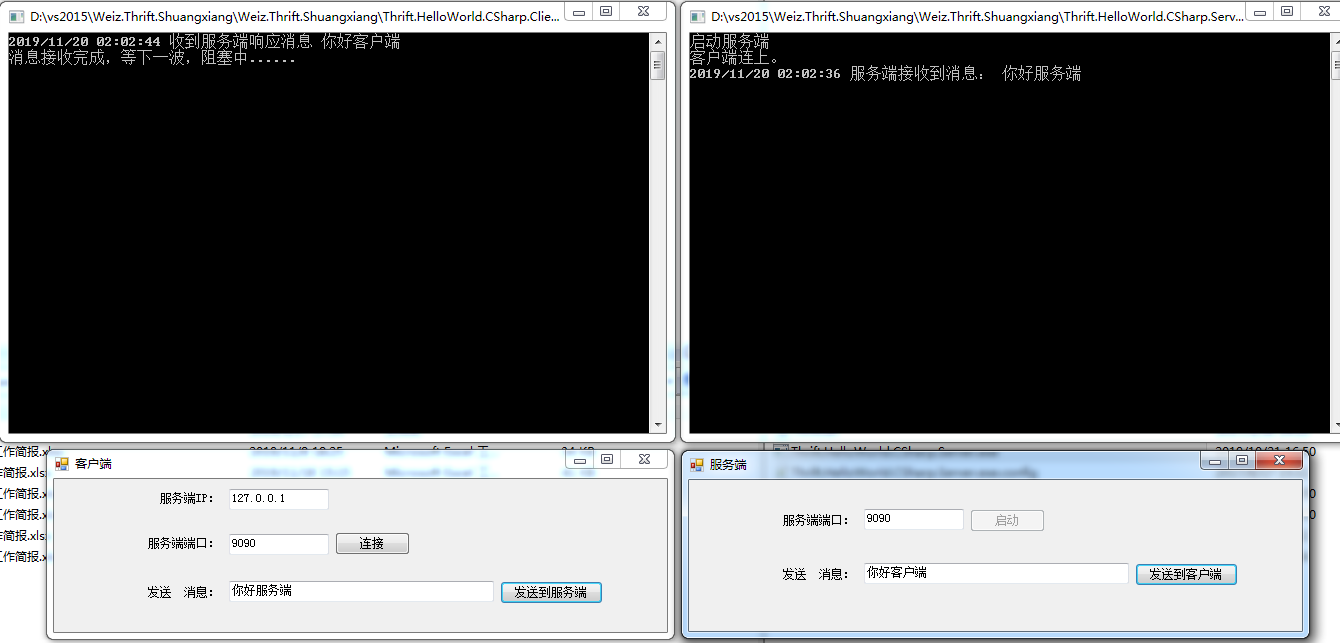
     測試效果如下:


    六、最後

      1. 關於使用Thrift 構建我們自己的rpc 的方法,這裏基本講完了。其他的方法本文就不再演示了,調用起來都是一樣。  

      2. 後續會簡單討論一下Thrift 框架的通信原理。

      3. 源代碼下載,


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※小三通海運與一般國際貿易有何不同?

    ※小三通快遞通關作業有哪些?

  • 美國蒙大拿州密蘇拉(Missoula)聯邦地區法官克里斯坦森(Dana Christensen)與環保人士及美國原住民站在同一陣線

    美國蒙大拿州密蘇拉(Missoula)聯邦地區法官克里斯坦森(Dana Christensen)與環保人士及美國原住民站在同一陣線,駁回美國魚類暨野生動物管理局(US Fish and Wildlife Service)將灰熊從瀕危物種名單除名的決定。

    環保人士主張,根據瀕臨滅絕物種保護法,對這些灰熊與蒙大拿州和下48州(Lower 48)的其他灰熊族群採取差別待遇,是生物學上靠不住且非法行為,法官也同意這類說法。

    環保人士說,儘管灰熊數量有所回升,倘若沒有受到聯邦持續保護,牠們的復育情況就會受到影響。此外,氣候變遷導致灰熊食物供給出現變化和人為死亡率高,也對灰熊生存構成威脅。

    本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※試算大陸海運運費!
  • 每年聯合國大會召開之際,多國元首和政府領袖同時舉行的「氣候週」今天(25日)開跑

    每年聯合國大會召開之際,多國元首和政府領袖同時舉行的「氣候週」今天(25日)開跑,他們敦促世界領袖緊急採取行動降低全球暖化。

    波蘭12月將主辦聯合國氣候變化綱要公約第24次締約方會議(COP24),聯合國氣候首長艾斯皮諾薩(Patricia Espinosa)呼籲各國團結,支持2015年巴黎協定所訂規定,將全球暖化升溫限制在攝氏兩度以下。

    艾斯皮諾薩表示,各國並未實現他們的承諾。並說:「各國目前依據巴黎協定做出的承諾,將使得全球溫度在2100年升高約三度。」

    本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※專營大陸快遞台灣服務

    ※台灣快遞大陸的貨運公司有哪些呢?