作者: admin

  • 回聲消除中的LMS和NLMS算法與MATLAB實現

    回聲消除中的LMS和NLMS算法與MATLAB實現

      自適應濾波是数字信號處理的核心技術之一,在科學和工業上有着廣泛的應用領域。自適應濾波技術應用廣泛,包括回波抵消、自適應均衡、自適應噪聲抵消和自適應波束形成。回聲對消是當今通信系統中普遍存在的現象。聲回波引起的信號干擾會分散用戶的注意力,降低通信質量。本文重點介紹了LMS和NLMS算法的使用,以減少這種不必要的回聲,從而提高通信質量

    關鍵詞:自適應濾波器,自適應算法,回聲消除

    1  引言

      當音頻信號在真實環境中產生混響時,就會產生聲學回聲,從而導致原始信號加上信號[1]的衰減、延時圖像。本文將重點研究通信系統中聲學回波的產生。

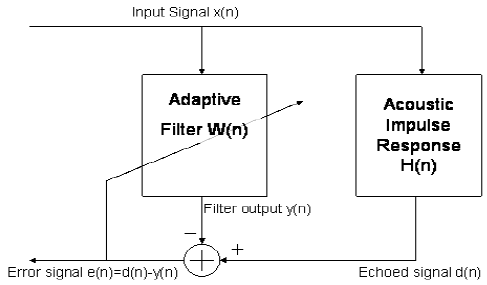
      自適應濾波器是一種動態濾波器,它不斷地改變其特性以獲得最優的輸出。自適應濾波算法通過改變參數使期望輸出d (n)與實際輸出y (n)之間的差值最小化。該函數稱為自適應算法的代價函數(loss)。圖1显示了自適應回聲抵消系統的框圖。其中,濾波器H(n)表示聲環境的脈衝響應,W(n)表示用來抵消回波信號的自適應濾波器。自適應濾波器的目標是使輸出的y(n)與期望的d(n)(在回聲環境中混響的信號)相等。在每次迭代中,誤差信號e(n)=d (n)-y (n)被反饋回濾波器,濾波器的特性也隨之改變。

    自適應回聲消除系統

      自適應濾波器的目標是計算期望信號與自適應濾波器輸出之間的差值e(n)。該誤差信號反饋到自適應濾波器,並通過算法改變其係數,以最小化該差值的函數,即代價函數。在聲回波消除的情況下,自適應濾波器的最優輸出與不需要的回波信號等值。當自適應濾波器輸出等於期望信號時,誤差信號為零。在這種情況下,回顯信號將被完全取消,遠用戶將不會聽到他們的任何原始語音返回給他們。

    2. 最小均方(LMS)算法

      最小均方(LMS)算法是由Widrow和Hoff在1959年通過對模式識別的研究首次提出的。由此成為自適應濾波中應用最廣泛的算法之一。LMS算法是一種基於隨機梯度的自適應濾波算法,它利用濾波器權重的梯度來收斂到最優的維納解[2-4]。由於其計算簡單而廣為人知並被廣泛使用。正是這種簡單性使它成為判斷所有其他自適應濾波算法的基準。

      隨着LMS算法的每次迭代,自適應濾波器的濾波抽頭(tap)權值按照如下公式進行更新。

    $$公式1:w(n+1)=w(n)2\mu e(n)x(n)$$

      這裏x(n)是延時輸入值的輸入向量,$x(n)=[x_1(n)x_2(n)…x_N(n)]^T=[x(n)x(n-1)…x(n-N+1)]^T$。向量$w(n)=[w_0(n)w_1(n)w_2(n)…w_{N-1}(n)]^T$代表自適應FIR濾波器抽頭(tap)權向量在時刻n的係數。參數μ被稱為步長參數和小正的常數。此步長參數控制更新因子的影響。μ必須選擇一個合適的值LMS算法的性能,如果該值太小自適應濾波器的收斂時間會太長;如果μ太大自適應濾波器變得不穩定,導致其輸出發散[5 – 8]。

    2.1 LMS算法的實現

    LMS算法的每次迭代都需要三個不同的步驟,順序如下:

    1. FIR濾波器的輸出y(n)用公式2計算。

    $$公式2:y(n)=\sum_{i=0}^{N-1}w(n)x(n-1)=w^T(n)x(n)$$

    2. 誤差估計的值按公式3計算。

    $$公式3:e(n)=d(n)-y(n)$$

    3.更新FIR向量的抽頭tap權值,為下一次迭代做準備,如公式4所示。

    $$公式4:w(n+1)=w(n)+2\mu e(n)x(n)$$

      LMS算法在自適應濾波中得到廣泛應用的主要原因是其計算簡單,比其他常用的自適應算法更易於實現。LMS算法每次迭代需要2N加法和2N + 1次乘法(N用於計算輸出y(N)),另一個用於通過向量乘法計算標量[9]。

    clear;
    clc;
    snr=20;     % 信噪比
    order=8;    % 自適應濾波器的階數為8
    Hn =[0.8783 -0.5806 0.6537 -0.3223 0.6577 -0.0582 0.2895 -0.2710 0.1278 ...     % ...表示換行的意思
        -0.1508 0.0238 -0.1814 0.2519 -0.0396 0.0423 -0.0152 0.1664 -0.0245 ...
        0.1463 -0.0770 0.1304 -0.0148 0.0054 -0.0381 0.0374 -0.0329 0.0313 ...
        -0.0253 0.0552 -0.0369 0.0479 -0.0073 0.0305 -0.0138 0.0152 -0.0012 ...
        0.0154 -0.0092 0.0177 -0.0161 0.0070 -0.0042 0.0051 -0.0131 0.0059 ...
        -0.0041 0.0077 -0.0034 0.0074 -0.0014 0.0025 -0.0056 0.0028 -0.0005 ...
        0.0033 -0.0000 0.0022 -0.0032 0.0012 -0.0020 0.0017 -0.0022 0.0004 -0.0011 0 0];
    Hn=Hn(1:order);
    mu=0.5;             % mu表示步長
    N=1000;             % 橫坐標1000個採樣點
    Loop=150;           % 150次循環
    EE_NLMS=zeros(N,1); % 不同步長的初始化誤差
    for nn=1:Loop       % epoch=150
        % 權重初始化w
        win_NLMS=zeros(1,order);         % NLMS四種步長測試,四個權重——1
        error_NLMS=zeros(1,N)';     % 初始化誤差
        % 均勻分佈的輸入值
        r=sign(rand(N,1)-0.5);          % shape=(1000,1)的(0,1)均勻分佈-0.5,sign(n)>0=1;<0=-1
        % 輸出:輸入卷積Hn得到 輸出
        output=conv(r,Hn);              % r卷積Hn,output長度=length(u)+length(v)-1
        output=awgn(output,snr,'measured');     % 將白高斯噪聲添加到信號中
    
        % N=1000,每個採樣點
        for i=order:N         % i=8:1000
          input=r(i:-1:i-order+1);  % 每次迭代取8個數據進行處理
          e_NLMS = output(i)-win_NLMS*input;
          win_NLMS=win_NLMS+e_NLMS*input'/(input'*input);   % NLMS更新權重
          error_NLMS(i)=error_NLMS(i)+e_NLMS^2;
        end
        
        EE_NLMS=EE_NLMS+error_NLMS;     % 把總誤差相加
    end
    % 對總誤差求平均值
    error_NLMS=EE_NLMS/Loop;
    
    figure;
    error_NLMS=10*log10(error_NLMS(order:N));
    plot(error_NLMS,'r');       % 紅色
    axis tight;                 % 使用緊湊的坐標軸
    legend('NLMS算法');           % 圖例
    title('NLMS算法誤差曲線');     % 圖標題
    xlabel('樣本');                     % x軸標籤
    ylabel('誤差/dB');                  % y軸標籤
    grid on;                            % 網格線

    3 歸一化最小均方(NLMS)算法

      LMS算法的主要缺點之一是每次迭代都有一個固定的步長參數。這需要在開始自適應濾波操作之前了解輸入信號的統計信息。實際上,這是很難實現的。即使我們假設自適應回聲抵消系統的唯一輸入信號是語音,但仍有許多因素如信號輸入功率和振幅會影響其性能[10-12]。

      歸一化最小均方算法(NLMS)是LMS算法的擴展,LMS算法通過計算最大步長值來繞過這個問題。步長值的計算公式如下

    $$Step\ size = \frac{1}{dot\ product(input\ vector,\ input\ vector)}$$

    這個步長與輸入向量x(n)的係數的瞬時值的總期望能量的倒數成正比。輸入樣本的期望能量之和也等於輸入向量與自身的點積,以及輸入向量自相關矩陣的跡R[13-15]。

    $$公式5:tr[R]=\sum_{i=0}^{N-1}E[x^2(n-i)]\\ \quad\quad =E[\sum_{i=0}^{N-1}x^2(n-i)]$$

    NLMS算法的遞歸公式如式6所示

    $$公式6:w(n+1)=w(n)+\frac{1}{x^T(n)x(n)}e(n)x(n)$$

    3.1 NLMS算法的實現

      NLMS算法已在Matlab中實現。由於步長參數是根據當前的輸入值來選擇的,因此NLMS算法在未知信號下具有更大的穩定性。該算法具有良好的收斂速度和相對簡單的計算能力,是實時自適應回波抵消系統[16]的理想算法。

      由於NLMS是標準LMS算法的擴展,因此NLMS算法的實際實現與LMS算法非常相似。NLMS算法的每次迭代都需要按照以下順序執行這些步驟。

    1. 計算了自適應濾波器的輸出

    $$公式7:y(n)=\sum_{i=0}^{N-1}w(n)x(n-i)=w^T(n)x(n)$$

    2. 誤差信號等於期望信號和濾波器輸出之間的差值。

    $$公式8:e(n)=d(n)-y(n)$$

    3.計算了輸入向量的步長值。

    $$公式9:\mu(n)=\frac{1}{x^T(n)x(n)}$$

    4. 濾波器抽頭權重更新,為下一次迭代做準備。

    $$公式10:w(n+1)=w(n)+\mu(n)e(n)x(n)$$

    NLMS算法的每次迭代都需要3N+1次乘法,僅比標準LMS算法多N次。考慮到所獲得的穩定性和回波衰減增益,這是一個可接受的增加。

    clear;
    clc;
    snr=20;     % 信噪比
    order=8;    % 自適應濾波器的階數為8
    % Hn是濾波器權重
    Hn =[0.8783 -0.5806 0.6537 -0.3223 0.6577 -0.0582 0.2895 -0.2710 0.1278 ...     % ...表示換行的意思
        -0.1508 0.0238 -0.1814 0.2519 -0.0396 0.0423 -0.0152 0.1664 -0.0245 ...
        0.1463 -0.0770 0.1304 -0.0148 0.0054 -0.0381 0.0374 -0.0329 0.0313 ...
        -0.0253 0.0552 -0.0369 0.0479 -0.0073 0.0305 -0.0138 0.0152 -0.0012 ...
        0.0154 -0.0092 0.0177 -0.0161 0.0070 -0.0042 0.0051 -0.0131 0.0059 ...
        -0.0041 0.0077 -0.0034 0.0074 -0.0014 0.0025 -0.0056 0.0028 -0.0005 ...
        0.0033 -0.0000 0.0022 -0.0032 0.0012 -0.0020 0.0017 -0.0022 0.0004 -0.0011 0 0];
    Hn=Hn(1:order);
    mu=0.5;             % mu表示步長
    N=1000;             % 橫坐標1000個採樣點
    Loop=150;           % 150次循環
    % 不同步長的初始化誤差
    EE_LMS = zeros(N,1);
    EE_NLMS=zeros(N,1);
    for nn=1:Loop       % epoch=150
        win_LMS = zeros(1,order);   % 權重初始化w
        error_LMS=zeros(1,N)';      % 初始化誤差
        % 均勻分佈的語音數據輸入
        r=sign(rand(N,1)-0.5);          % shape=(1000,1)的(0,1)均勻分佈-0.5,sign(n)>0=1;<0=-1
        % 輸出:輸入卷積Hn得到 輸出
        output=conv(r,Hn);              % r卷積Hn,output長度=length(u)+length(v)-1
        output=awgn(output,snr,'measured');     % 真實輸出=將白高斯噪聲添加到信號中
    
        % N=1000,每個採樣點
        for i=order:N         % i=8:1000
          input=r(i:-1:i-order+1);  % 每次迭代取8個數據進行處理
          e_LMS = output(i)-win_LMS*input;
          
          mu=0.02;      % 步長
          win_LMS = win_LMS+2*mu*e_LMS*input';
          error_LMS(i)=error_LMS(i)+e_LMS^2;
        end
        % 把總誤差相加
        EE_LMS = EE_LMS+error_LMS;
    
    end
    % 對總誤差求平均值
    error_LMS = EE_LMS/Loop;
    
    figure;
    error1_LMS=10*log10(error_LMS(order:N));
    plot(error1_LMS,'b.');  % 藍色
    axis tight;         % 使用緊湊的坐標軸
    legend('LMS算法');       % 圖例
    title('LMS算法誤差曲線');  % 圖標題
    xlabel('樣本');                     % x軸標籤
    ylabel('誤差/dB');                  % y軸標籤
    grid on;                            % 網格線

    4 LMS算法的結果

      利用Matlab對LMS算法進行了仿真。圖2显示的是通過麥克風從計算機系統收集到的輸入語音信號。圖3显示了從輸入信號派生出的所需回波信號。圖4显示了自適應濾波器的輸出,它將減少輸入信號的回波信號。圖5显示了由濾波器輸出信號計算出的均方誤差信號。圖6是由回波信號對誤差信號的分割得到的衰減。

      自適應濾波器為1025階FIR濾波器。步長設置為0.02。MSE表明,隨着算法的發展,代價函數的平均值逐漸減小。

    5 NLMS算法的結果

      用Matlab對NLMS算法進行了仿真。圖7显示了輸入信號。圖8显示了所需的信號。圖9显示了自適應濾波器輸出。圖10显示了均方誤差。圖11显示了衰減。

      自適應濾波器為1025階FIR濾波器。步長設置為0.1。


     NLMS算法在均方誤差和平均衰減方面優於LMS算法,其性能總結如表1所示。


    6 結論

      由於其簡單性,LMS算法是最流行的自適應算法。然而,LMS算法存在收斂速度慢和數據依賴的問題。

      NLMS算法是LMS算法的一個同樣簡單但更健壯的變體,它在簡單性和性能之間表現出比LMS算法更好的平衡。由於其良好的性能,NLMS在實時應用中得到了廣泛的應用。

    7. 參考

    文章翻譯自論文《2011_adaptive algorithms for acoustic echo cancellation in speech processing》

    [1]. Homana, I.; Topa, M.D.; Kirei, B.S.; “Echo cancelling using adaptive algorithms”, Design and Technology of Electronics Packages, (SIITME) 15th International Symposium., pp. 317-321, Sept.2009.

    [2]. Paleologu, C.; Benesty, J.; Grant, S.L.; Osterwise, C.; “Variable step-size NLMS algorithms for echo cancellation” 2009 Conference Record of the forty-third Asilomar Conference on Signals, Systems and Computers., pp. 633-637, Nov 2009.

    [3]. Soria, E.; Calpe, J.; Chambers, J.; Martinez, M.; Camps, G.; Guerrero, J.D.M.; “A novel approach to introducing adaptive filters based on the LMS algorithm and its variants”, IEEE Transactions, vol. 47, pp. 127-133, Feb 2008.

    [4]. Tandon, A.; Ahmad, M.O.; Swamy, M.N.S.; “An efficient, low-complexity, normalized LMS algorithm for echo cancellation”, IEEE workshop on Circuits and Systems, 2004. NEWCAS 2004, pp. 161-164, June 2004.

    [5]. Eneman, K.; Moonen, M.; “Iterated partitioned block frequency-domain adaptive filtering for acoustic echo cancellation,” IEEE Transactions on Speech and Audio Processing, vol. 11, pp. 143-158, March 2003.

    [6]. Krishna, E.H.; Raghuram, M.; Madhav, K.V; Reddy, K.A; “Acoustic echo cancellation using a computationally efficient transform domain LMS adaptive filter,” 2010 10th International Conference on Information sciences signal processing and their applications (ISSPA), pp. 409-412, May 2010.

    [7]. Lee, K.A.; Gan,W.S; “Improving convergence of the NLMS algorithm using constrained subband updates,” Signal Processing Letters IEEE, vol. 11, pp. 736-739, Sept. 2004.

    [8]. S.C. Douglas, “Adaptive Filters Employing Partial Updates,” IEEE Trans.Circuits SYS.II, vol. 44, pp. 209-216, Mar 1997.

    [9]. D.L. Duttweiler, “Proportionate Normalized Least Mean Square Adaptation in Echo Cancellers,” IEEE Trans. Speech Audio Processing, vol. 8, pp. 508-518, Sept. 2000.

    [10]. E. Soria, J. Calpe, J. Guerrero, M. Martínez, and J. Espí, “An easy demonstration of the optimum value of the adaptation constant in the LMS algorithm,” IEEE Trans. Educ., vol. 41, pp. 83, Feb. 1998.

    [11]. D. Morgan and S. Kratzer, “On a class of computationally efficient rapidly converging, generalized NLMS algorithms,” IEEE Signal Processing Lett., vol. 3, pp. 245–247, Aug. 1996.

    [12]. G. Egelmeers, P. Sommen, and J. de Boer, “Realization of an acoustic echo canceller on a single DSP,” in Proc. Eur. Signal Processing Conf. (EUSIPCO96), Trieste, Italy, pp. 33–36, Sept. 1996.

    [13]. J. Shynk, “Frequency-domain and multirate adaptive filtering,” IEEE Signal Processing Mag., vol. 9, pp. 15– 37, Jan. 1992.

    [14]. Ahmed I. Sulyman and Azzedine Zerguine, “Echo Cancellation Using a Variable Step-Size NLMS Algorithm”, Electrical and Computer Engineering Department Queen’s University.

    [15]. D. L. Duttweiler, “A twelve-channel digital echo canceller,” IEEE Trans. Commun., vol. 26, no. 5, pp. 647–653, May 1978.

    [16]. J. Benesty, H. Rey, L. Rey Vega, and S. Tressens, “A nonparametric VSS NLMS algorithm,” IEEE Signal Process. Lett., vol. 13, pp. 581–584, Oct. 2006.


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※大陸寄台灣空運注意事項

    ※大陸海運台灣交貨時間多久?

    ※避免吃悶虧無故遭抬價!台中搬家公司免費估價,有契約讓您安心有保障!
  • SpringBoot系列教程JPA之指定id保存

    SpringBoot系列教程JPA之指定id保存

    原文鏈接:

    前幾天有位小夥伴問了一個很有意思的問題,使用 JPA 保存數據時,即便我指定了主鍵 id,但是新插入的數據主鍵卻是 mysql 自增的 id;那麼是什麼原因導致的呢?又可以如何解決呢?

    本文將介紹一下如何使用 JPA 的 AUTO 保存策略來指定數據庫主鍵 id

    I. 環境準備

    實際開始之前,需要先走一些必要的操作,如安裝測試使用 mysql,創建 SpringBoot 項目工程,設置好配置信息等,關於搭建項目的詳情可以參考前一篇文章

    下面簡單的看一下後續的代碼中,需要的配置 (我們使用的是 mysql 數據庫)

    1. 表準備

    沿用前一篇的表,結構如下

    CREATE TABLE `money` (
      `id` int(11) unsigned NOT NULL AUTO_INCREMENT,
      `name` varchar(20) NOT NULL DEFAULT '' COMMENT '用戶名',
      `money` int(26) NOT NULL DEFAULT '0' COMMENT '錢',
      `is_deleted` tinyint(1) NOT NULL DEFAULT '0',
      `create_at` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '創建時間',
      `update_at` timestamp NOT NULL DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新時間',
      PRIMARY KEY (`id`),
      KEY `name` (`name`)
    ) ENGINE=InnoDB AUTO_INCREMENT=1 DEFAULT CHARSET=utf8mb4;

    2. 項目配置

    配置信息,與之前有一點點區別,我們新增了更詳細的日誌打印;本篇主要目標集中在添加記錄的使用姿勢,對於配置說明,後面單獨進行說明

    ## DataSource
    spring.datasource.url=jdbc:mysql://127.0.0.1:3306/story?useUnicode=true&characterEncoding=UTF-8&useSSL=false
    spring.datasource.driver-class-name=com.mysql.jdbc.Driver
    spring.datasource.username=root
    spring.datasource.password=
    ## jpa相關配置
    spring.jpa.database=MYSQL
    spring.jpa.hibernate.ddl-auto=none
    spring.jpa.show-sql=true
    spring.jackson.serialization.indent_output=true
    spring.jpa.hibernate.naming.physical-strategy=org.hibernate.boot.model.naming.PhysicalNamingStrategyStandardImpl

    II. Insert 教程

    首先簡單的看一下,我們一般使用默認的數據庫自增生成主鍵的使用方式,以便後面的自定義主鍵生成策略的對比

    對於 jpa 的插入數據的知識點不太清楚的同學,可以看一下之前的博文:

    1. 自增主鍵

    首先我們需要定義 PO,與數據庫中的表綁定起來

    @Data
    @DynamicUpdate
    @DynamicInsert
    @Entity
    @Table(name = "money")
    public class MoneyPO {
        @Id
        @GeneratedValue(strategy = GenerationType.IDENTITY)
        @Column(name = "id")
        private Integer id;
    
        @Column(name = "name")
        private String name;
    
        @Column(name = "money")
        private Long money;
    
        @Column(name = "is_deleted")
        private Byte isDeleted;
    
        @Column(name = "create_at")
        @CreatedDate
        private Timestamp createAt;
    
        @Column(name = "update_at")
        @CreatedDate
        private Timestamp updateAt;
    }

    注意上面的主鍵生成策略用的是 GenerationType.IDENTITY,配合 mysql 的使用就是利用數據庫的自增來生成主鍵 id

    /**
     * 新增數據
     * Created by @author yihui in 11:00 19/6/12.
     */
    public interface MoneyCreateRepositoryV2 extends JpaRepository<MoneyPO, Integer> {
    }

    接下來保存數據就很簡單了

    private void addWithId() {
        MoneyPO po1 = new MoneyPO();
        po1.setId(20);
        po1.setName("jpa 一灰灰 1x");
        po1.setMoney(2200L + ((long) (Math.random() * 100)));
        po1.setIsDeleted((byte) 0x00);
        MoneyPO r1 = moneyCreateRepositoryV2.save(po1);
        System.out.println("after insert res: " + r1);
    }

    強烈建議實際的體驗一下上面的代碼執行

    首次執行確保數據庫中不存在 id 為 20 的記錄,雖然我們的 PO 對象中,指定了 id 為 20,但是執行完畢之後,新增的數據 id 卻不是 20

    Hibernate: select moneypo0_.id as id1_0_0_, moneypo0_.create_at as create_a2_0_0_, moneypo0_.is_deleted as is_delet3_0_0_, moneypo0_.money as money4_0_0_, moneypo0_.name as name5_0_0_, moneypo0_.update_at as update_a6_0_0_ from money moneypo0_ where moneypo0_.id=?
    Hibernate: insert into money (is_deleted, money, name) values (?, ?, ?)
    after insert res: MoneyPO(id=104, name=jpa 一灰灰 1x, money=2208, isDeleted=0, createAt=null, updateAt=null)

    上面是執行的 sql 日誌,注意插入的 sql,是沒有指定 id 的,所以新增的記錄的 id 就會利用 mysql 的自增策略

    當我們的 db 中存在 id 為 20 的記錄時,再次執行,查看日誌發現實際執行的是更新數據

    Hibernate: select moneypo0_.id as id1_0_0_, moneypo0_.create_at as create_a2_0_0_, moneypo0_.is_deleted as is_delet3_0_0_, moneypo0_.money as money4_0_0_, moneypo0_.name as name5_0_0_, moneypo0_.update_at as update_a6_0_0_ from money moneypo0_ where moneypo0_.id=?
    Hibernate: update money set create_at=?, money=?, name=?, update_at=? where id=?
    after insert res: MoneyPO(id=20, name=jpa 一灰灰 1x, money=2234, isDeleted=0, createAt=null, updateAt=null)

    大膽猜測,save 的執行過程邏輯如

    • 首先根據 id 到數據庫中查詢對應的數據
    • 如果數據不存在,則新增(插入 sql 不指定 id)
    • 如果數據存在,則判斷是否有變更,以確定是否需要更新

    2. 指定 id

    那麼問題來了,如果我希望當我的 po 中指定了數據庫 id 時,db 中沒有這條記錄時,就插入 id 為指定值的記錄;如果存在記錄,則更新

    要實現上面這個功能,自定義主鍵 id,那麼我們就需要修改一下主鍵的生成策略了,官方提供了四種

    取值 說明
    GenerationType.TABLE 使用一個特定的數據庫表格來保存主鍵
    GenerationType.SEQUENCE 根據底層數據庫的序列來生成主鍵,條件是數據庫支持序列
    GenerationType.IDENTITY 主鍵由數據庫自動生成(主要是自動增長型)
    GenerationType.AUTO 主鍵由程序控制

    從上面四種生成策略說明中,很明顯我們要使用的就是 AUTO 策略了,我們新增一個 PO,並指定保存策略

    @Data
    @DynamicUpdate
    @DynamicInsert
    @Entity
    @Table(name = "money")
    public class AutoMoneyPO {
        @Id
        @GeneratedValue(strategy = GenerationType.AUTO, generator = "myid")
        @GenericGenerator(name = "myid", strategy = "com.git.hui.boot.jpa.generator.ManulInsertGenerator")
        @Column(name = "id")
        private Integer id;
    
        @Column(name = "name")
        private String name;
    
        @Column(name = "money")
        private Long money;
    
        @Column(name = "is_deleted")
        private Byte isDeleted;
    
        @Column(name = "create_at")
        @CreatedDate
        private Timestamp createAt;
    
        @Column(name = "update_at")
        @CreatedDate
        private Timestamp updateAt;
    }

    採用自定義的生成策略,需要注意,@GenericGenerator(name = "myid", strategy = "com.git.hui.boot.jpa.generator.ManulInsertGenerator")這個需要有,否則執行會拋異常

    這一行代碼的意思是,主鍵 id 是由ManulInsertGenerator來生成

    /**
     *  自定義的主鍵生成策略,如果填寫了主鍵id,如果數據庫中沒有這條記錄,則新增指定id的記錄;否則更新記錄
     *
     *  如果不填寫主鍵id,則利用數據庫本身的自增策略指定id
     *
     * Created by @author yihui in 20:51 19/11/13.
     */
    public class ManulInsertGenerator extends IdentityGenerator {
    
        @Override
        public Serializable generate(SharedSessionContractImplementor s, Object obj) throws HibernateException {
            Serializable id = s.getEntityPersister(null, obj).getClassMetadata().getIdentifier(obj, s);
    
            if (id != null && Integer.valueOf(id.toString()) > 0) {
                return id;
            } else {
                return super.generate(s, obj);
            }
        }
    }

    具體的主鍵生成方式也比較簡單了,首先是判斷 PO 中有沒有主鍵,如果有則直接使用 PO 中的主鍵值;如果沒有,就利用IdentityGenerator策略來生成主鍵(而這個主鍵生成策略,正好是GenerationType.IDENTITY利用數據庫自增生成主鍵的策略)

    接下來我們再次測試插入

    // 使用自定義的主鍵生成策略
    AutoMoneyPO moneyPO = new AutoMoneyPO();
    moneyPO.setId(20);
    moneyPO.setName("jpa 一灰灰 ex");
    moneyPO.setMoney(2200L + ((long) (Math.random() * 100)));
    moneyPO.setIsDeleted((byte) 0x00);
    AutoMoneyPO res = moneyCreateRepositoryWithId.save(moneyPO);
    System.out.println("after insert res: " + res);
    
    moneyPO.setMoney(3200L + ((long) (Math.random() * 100)));
    res = moneyCreateRepositoryWithId.save(moneyPO);
    System.out.println("after insert res: " + res);
    
    moneyPO = new AutoMoneyPO();
    moneyPO.setName("jpa 一灰灰 2ex");
    moneyPO.setMoney(2200L + ((long) (Math.random() * 100)));
    moneyPO.setIsDeleted((byte) 0x00);
    res = moneyCreateRepositoryWithId.save(moneyPO);
    System.out.println("after insert res: " + res);

    上面的代碼執行時,確保數據庫中沒有主鍵為 20 的數據,輸出 sql 日誌如下

    # 第一次插入
    Hibernate: select automoneyp0_.id as id1_0_0_, automoneyp0_.create_at as create_a2_0_0_, automoneyp0_.is_deleted as is_delet3_0_0_, automoneyp0_.money as money4_0_0_, automoneyp0_.name as name5_0_0_, automoneyp0_.update_at as update_a6_0_0_ from money automoneyp0_ where automoneyp0_.id=?
    Hibernate: insert into money (is_deleted, money, name, id) values (?, ?, ?, ?)
    after insert res: AutoMoneyPO(id=20, name=jpa 一灰灰 ex, money=2238, isDeleted=0, createAt=null, updateAt=null)
    
    # 第二次指定id插入
    Hibernate: select automoneyp0_.id as id1_0_0_, automoneyp0_.create_at as create_a2_0_0_, automoneyp0_.is_deleted as is_delet3_0_0_, automoneyp0_.money as money4_0_0_, automoneyp0_.name as name5_0_0_, automoneyp0_.update_at as update_a6_0_0_ from money automoneyp0_ where automoneyp0_.id=?
    Hibernate: update money set create_at=?, money=?, update_at=? where id=?
    after insert res: AutoMoneyPO(id=20, name=jpa 一灰灰 ex, money=3228, isDeleted=0, createAt=null, updateAt=null)
    
    # 第三次無id插入
    Hibernate: insert into money (is_deleted, money, name) values (?, ?, ?)
    after insert res: AutoMoneyPO(id=107, name=jpa 一灰灰 2ex, money=2228, isDeleted=0, createAt=null, updateAt=null)

    注意上面的日誌輸出

    • 第一次插入時拼裝的寫入 sql 是包含 id 的,也就達到了我們指定 id 新增數據的要求
    • 第二次插入時,因為 id=20 的記錄存在,所以執行的是更新操作
    • 第三次插入時,因為沒有 id,所以插入的 sql 中也沒有指定 id,使用 mysql 的自增來生成主鍵 id

    II. 其他

    0. 項目&博文

    • 工程:
    • module:

    1. 一灰灰 Blog

    盡信書則不如,以上內容,純屬一家之言,因個人能力有限,難免有疏漏和錯誤之處,如發現 bug 或者有更好的建議,歡迎批評指正,不吝感激

    下面一灰灰的個人博客,記錄所有學習和工作中的博文,歡迎大家前去逛逛

    • 一灰灰 Blog 個人博客
    • 一灰灰 Blog-Spring 專題博客

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※專營大陸空運台灣貨物推薦

    ※台灣空運大陸一條龍服務

    ※評比彰化搬家公司費用,南投搬家公司費用收費行情懶人包大公開

    ※彰化搬家費用,南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

  • 工信部第285批新車公示218款新能源入選

    根據《中華人民共和國行政許可法》和《國務院對確需保留的行政審批專案設定行政許可的決定》的規定,工信部日前將許可的汽車、摩托車、三輪汽車和低速貨車生產企業及產 品(第285批)予以了公告,共有218款新能源車型入選。進入該公告的新能源汽車可開展生產銷售,但是要獲得補貼,還需再獲得《新能源汽車推廣應用推薦車型目錄》准入。

    純電動轎車/乘用車方面,北汽、長城、禦捷馬、卡威、吉利等12款車型入選。

    插電式乘用車方面,比亞迪、寶馬、之諾、上汽等7款車型入選。

    純電動客車方面,安凱、江淮、安源、北奔、北方、福田、比亞迪、白雲、五菱、陸地方舟、尼歐凱、友誼、青年、海格、開沃、依維柯、飛燕、大通、象牌、野馬、華新、金龍、金旅、宇通、黃河、中通、中植汽車、穗通等28個品牌75款車型入選。

    插電式混動客車方面, 安凱、海格、易聖達、金龍、金旅、宇通6個品牌21款車型入選。

    新能源專用車方面,福田、北京、大運、黃海、東風、華神、揚子江、東風、福建、環球、藍速、田野、中悅 、卡威、陸地方舟、青年曼、康迪、五菱、暢達、躍進、金龍、凱馬、時風、太行成功、東風、金杯、邢牛、海德、解放、神州、宇通、長帆汽車、迪馬、炫虎等33個品牌103款車型入選。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步”網站設計“幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※試算大陸海運運費!

  • 中國汽車工業三十強榜單發佈:冠軍上汽集團營收超萬億元

    中國汽車工業三十強榜單發佈:冠軍上汽集團營收超萬億元

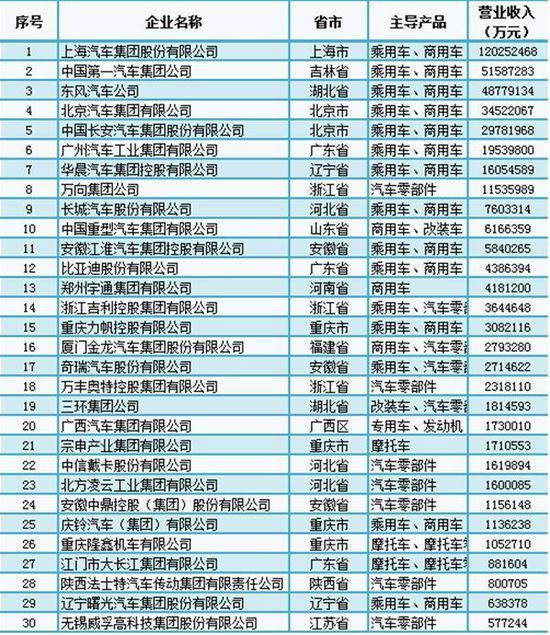
    2016年5月26日,中國機械工業聯合會、中國汽車工業協會發佈最新中國汽車工業三十強榜單。上汽集團以2015年1.2萬億元的總營業收入繼續蟬聯冠軍,一汽和東風依然排第2、3位。

    榜單中,蓋世汽車盤點出有乘用車公司16家,商用車公司4家,零部件公司7家,摩托車公司3家。本次榜單基於“年度匯總口徑快報”統計2015年營業收入,和上市公司合併財務報表中的營業收入存在計算上的差別,後者抵消了關聯交易部分。這也是為何上汽2015年年報中營收為670,448,223,139.34元,而本榜單中為1.2萬億元的緣故。

    對比2015年排名(以2014年營業收入統計),19家企業排名沒有變化,比亞迪和威孚高科新上榜,陝西汽車和金城集團落榜。前十名中,僅長城(今年第9)和重汽(今年第10)互換了名次,其他8家企業都保持了去年的座次。提升最快的是中鼎,從第27提高到第24,上升3位。下降幅度最大的是法士特,從第24滑落至第28。

    冠軍上汽集團去年營收總額超過第2名一汽和第3名東風總和。

    以下是具體排名

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※專營大陸快遞台灣服務

    ※台灣快遞大陸的貨運公司有哪些呢?

  • 菲亞特董事長公開闢謠 廣汽入主消息不實

    據《歐洲汽車新聞》報導,菲亞特克萊斯勒公司(FCA)董事長約翰•埃爾坎(John Elkann)明確指出,未與中國廣汽集團簽訂股權出售協定。

    2015年FCA與廣汽延續廣汽菲亞特的合作關係,成立了廣汽菲克合資公司,投產Jeep自由光和自由俠。近日,《義大利日報》發佈了一篇爆料新聞,除在生產方面的合作外,廣汽集團還有意入主FCA,展開資本層面的聯姻。

    埃爾坎同時也是菲亞特控股集團EXOR的董事長,25日召開了Exor股東大會。針對《義大利日報》的爆料,埃爾坎當日公開闢謠,公司與廣汽集團未簽訂股權出售協定。

    埃爾坎也被詢問標緻雪鐵龍集團(PSA集團)是否可成為FCA的良好合作夥伴,該董事長則指出其公司正在尋求的推動轉型的合作夥伴,PSA並不在公司的考慮範圍內。

    據法國《回聲報》的報導,法國政府正在考慮出售其持有的PSA 14%的部分或全部股權。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

    ※台灣海運大陸貨務運送流程

    ※兩岸物流進出口一站式服務

  • 寶馬投資Scoop拼車應用公司進軍汽車共享市場

    據《路透社》報導,寶馬集團透露,其旗下風險投資部門iVentures已經為加利福尼亞拼車應用公司Scoop提供了一筆投資金額,具體數目未知。

    Scoop公司目前位於三藩市港灣區,通過智慧手機支援為乘客提供拼車服務,其開發出的應用軟體可將相鄰社區及工作區域的人們連接起來,共同拼車。寶馬此舉為汽車製造商為初創公司投資的最新一次行動,使消費者在未擁有私人車輛或經常駕駛的情況下也能夠出行。

    此外,寶馬還分別為車隊管理軟體公司RideCell、泊車點定位服務Zirx、簡化公共交通系統服務Moovit、從智慧手機上集成資料教授司機如何安全駕駛的Zendrive公司進行了投資。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包”嚨底家”

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※小三通海運與一般國際貿易有何不同?

    ※小三通快遞通關作業有哪些?

  • 財政部將公開新能源汽車推廣騙補核查和處理結果

    5月28日,財政部發佈聲明稱,關於新能源汽車推廣騙補核查,現場核查已經完成,目前處於會審階段。核查及處理情況,將按資訊公開有關規定及時公開。

    中國新能源汽車產業的發展受到政策的強力推動。從2010年開始,我國便實施新能源汽車補貼政策,由於監督機制不完善,騙補隨之愈演愈烈。2016年1月份,工信部、財政部、科技部、發改委聯合啟動對新能源汽車相關情況的專項核查工作,新能源汽車生產企業、運營企業、租賃企業、企事業單位等新能源汽車使用者全部列入核查物件。國務院也把遏制新能源汽車騙補行為作為重點工作之一。

    此前,央視曝光了10家涉及騙補的企業,分別是蘇州吉姆西客車製造有限公司、陝西通家汽車股份有限公司、重慶力帆乘用車有限公司、江蘇陸地方舟新能源電動汽車有限公司、奇瑞萬達貴州客車股份有限公司、國宏汽車有限公司、江蘇奧新新能源汽車有限公司、蕪湖寶騏汽車製造有限公司、重慶力帆汽車有限公司,以及金華青年汽車製造有限公司。這些企業的共同特點是,2015年12月單月產量(主要依據是機動車出廠合格證)均超過全年產量的50%。

    對於騙補行為,工信部部長苗圩曾公開表示,“局部地區確實存在少部分企業騙補的現象,對於騙補企業,沒補貼的錢不會下發,已補貼的錢一定要扣回。依法進行處置,直至取消這些企業的資質”。

    對於騙補的企業到底有哪些?將受到怎樣的處罰?這些問題一直受到業界的關注和猜測。此次,財政部公開發佈新能源汽車推廣核查有關情況的聲明,表示“現場核查已經完成,目前處於會審階段”。聲明特別強調“財政部和部內有關司局至今未接受過媒體採訪,核查及處理情況,將按資訊公開有關規定及時公開”。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※試算大陸海運運費!

  • 大眾汽車計畫投資100億歐元新建一座電池工廠

    據外媒報導,大眾汽車計畫投資100億歐元新建一座電池工廠,意欲轉型為一家領先的電動汽車製造商,從而使其可以自己掌控電動汽車的命運,而不是單純依賴于亞洲的電池廠商。

    在大眾汽車6月22日召開年度股東大會以前,該公司的一個非執行理事會將對首席執行官馬蒂亞斯•穆勒(Matthias Müller)及其下屬一個團隊提出的計畫進行考慮。根據《商報》的報導,這項計畫的規模將需要足夠大到可以支援一個目標,即在未來十年時間裡將純電動汽車(PEV)的銷售量提高至100萬輛。

    從投資額來看,大眾汽車計畫建設的這座工廠類似於特斯拉汽車的“超級工廠”(Gigafactry),而該公司所需電池的規模也意味著這將是一座龐大的工廠,但大眾汽車尚未透露更多細節。

    據報導,大眾汽車的董事會很可能將會批准這項計畫,而身為該公司大股東之一的德國下薩克森州(Lower Saxony)也將支持該計畫。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※專營大陸快遞台灣服務

    ※台灣快遞大陸的貨運公司有哪些呢?

  • 大眾計畫為高端車型開發第二個電動汽車平臺

    據外媒報導稱,大眾正在考慮開發第二個電動汽車平臺,用於更大、更高端的車型。

    大眾的第一個電動汽車平臺名叫MEB,曾在CES上展示 過,BUDD-e概念車就是用該平臺開發的。該平臺專門針對小型汽車、輕型商務用車,充電一次行駛距離大約155英里至310英里(250-500公 裡)。目前大眾正在調查MEB平臺的彈性,看它是否可以用在高端車型上,比如Phaeton(輝騰),未來大眾可能會為高端車型專門開發一個新平臺。

    按照大眾的計畫,2019年之前MEB平臺準備就緒,因為該平臺主要針對的是電動汽車,擴展性更強。也就是說汽車製造商調整軸距、軌距、座位位置更加容易一些,它們可以將平臺用在更多的車型上。落地式電池尤其引人注目,因為工程師可以根據車型改變電池的大小。

    大眾集團電子研發主管沃克馬•坦尼伯格(Volkmar Tanneberger)稱,‘巧克力電池’(chocolate battery)製造更容易,可以進行大規模工業化生產。MEB能夠用在所有車型上,包括超小型Polo和中型汽車帕薩特(Passat),未來MEB有可能會成為大眾所有產品線的基石。如果MEB架構無法用在更大型的汽車上,比如輝騰,開發第二個電動汽車平臺就會變得有意義。保時捷Mission E和奧迪e-tron Quattro將會擁有自己的平臺,因為早在MEB架構公佈之前,它們已經設計成型。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

    ※台灣海運大陸貨務運送流程

    ※兩岸物流進出口一站式服務

  • 特斯拉超級電池工廠Gigafactory 7月正式開業 目前仍在建

    據外媒體報導,特斯拉稱其位於內華達州里諾市郊的超級電池工廠Gigafactory將於7月29日晚上舉行開業典禮,目前該工廠仍處於建設之中。

    特斯拉在發給客戶的一封電子郵件中披露,為特斯拉成功推薦的客戶超過5位元的人將會受邀參加此次開業典禮。特斯拉已經通過電子郵件向這些符合資格的客戶通知了開業典禮時間。

    事實上,在未來2個月內Gigafactory工廠不可能完全竣工,特斯拉僅僅是決定在已建成區域舉行小型典禮。在今年3月份,特斯拉、SolarCity在該廠區接待了內華達州議員,探討了太陽能業務在該州的發展。

    據悉,Gigafactory工廠建設造價逾50億美元,到今年5月初僅建成14%。此外,松下向特斯拉的超級電池工廠供應電池生產設備,並提供部分資金。

    儘管電池廠還在建設之中,但是工廠已經投產。工廠目前生產的太陽能電池被用於公共設施、企業以及各個地產業主。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※小三通海運與一般國際貿易有何不同?

    ※小三通快遞通關作業有哪些?