環境資訊中心綜合外電;姜唯 編譯;林大利 審校
本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※教你寫出一流的銷售文案?
※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益
※回頭車貨運收費標準
※別再煩惱如何寫文案,掌握八大原則!
※超省錢租車方案
※產品缺大量曝光嗎?你需要的是一流包裝設計!
摘錄自2018年8月30日世界日報報導
加州州議會29日準備將一項畫時代的法案送交州長簽署,這項法案規定,加州在2045年前將電力供應全面變為清潔能源,不再使用煤和石油發電,100%改用太陽能、風力和其他再生能源。
由州參議會議長德利昂提出的SB100號法案,先獲州參議會通過,29日再獲州眾議會以43票對32票通過;州眾議會進行了修改,所以須再送回州參議會通過,就可以送交州長簽署。州議會今年的會期,將於本周結束,所以SB100估計可於周末前送交州長。
加州的公用事業公司包括太平洋瓦電和聖地牙哥瓦電,都反對SB100。美西各州石油協會和其他組織也反對。
布朗州長對SB100保持沉默,沒有說是否簽署,雖然他是加州反暖運動的先鋒。明年可能接替布朗做州長的紐森,曾說要以100%清潔能源作為加州的目標,但是他也沒有對SB100表態。
本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※超省錢租車方案
※別再煩惱如何寫文案,掌握八大原則!
※回頭車貨運收費標準
※教你寫出一流的銷售文案?
※FB行銷專家,教你從零開始的技巧
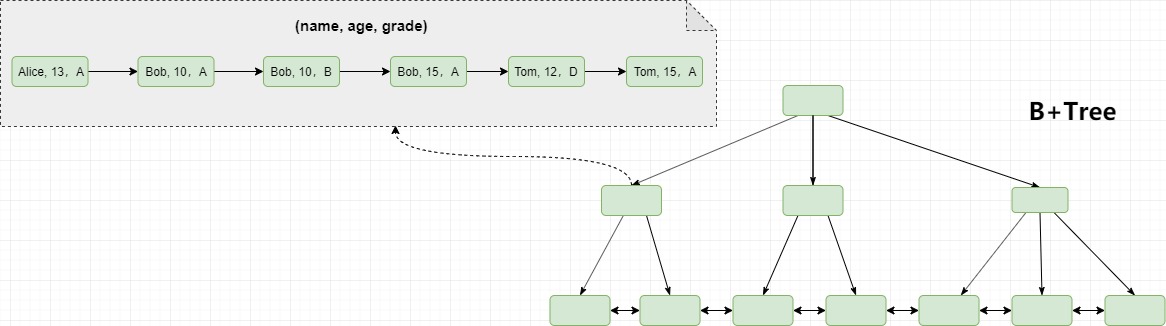
MySQL使用了B+Tree作為底層數據結構,能夠實現快速高效的數據查詢功能。工作中可怕的是沒有建立索引,比這更可怕的是建好了索引又沒有使用到。
本文將圍繞着如何優雅的使用索引,圖文並茂地和大家一起探討索引的正確打開姿勢,不談底層原理,只求工作實戰。
page之間是雙鏈表形式,而每個page內部的數據則是單鏈表形式存在。當進行數據查詢時,會限定位到具體的page,然後在page中通過二分查找具體的記錄。
並且索引的順序不同,數據的存儲順序則也不同。所以在開發過程中,一定要注意索引字段的先後順序。
最左匹配原則
當一個索引中包含多個字段時,可以稱之為組合索引。MySQL中有個很重要的規則,即最左匹配原則用來定義組合索引的命中規則,它是指在檢索數據時從聯合索引的最左邊開始匹配。假設對用戶表建立一個聯合索引(a,b,c),那麼條件a,(a,b),(a,b,c)都會用到索引。
在匹配過程中會優先根據最左前面的字段a進行匹配,然後再判斷是否用到了索引字段b,直到無法找到對應的索引字段,或者對應的索引被”破壞“(下文中會介紹)。
以下是本文中操作實踐用到的初始化語句,有條件的同學可以再本地執行,建議使用MySQL5.6+版本,畢竟實操才是學習的最佳途徑。
SET NAMES utf8mb4;
-- ----------------------------
-- Table structure for test_table
-- ----------------------------
DROP TABLE IF EXISTS `test_table`;
CREATE TABLE `test_table` (
  `id` bigint(20) unsigned NOT NULL AUTO_INCREMENT,
  `a` varchar(255) COLLATE utf8mb4_bin NOT NULL,
  `b` varchar(255) COLLATE utf8mb4_bin NOT NULL,
  `c` varchar(255) COLLATE utf8mb4_bin NOT NULL,
  `d` varchar(255) COLLATE utf8mb4_bin NOT NULL,
  PRIMARY KEY (`id`),
  KEY `idx_a_b_c` (`a`,`b`,`c`)
) ENGINE=InnoDB AUTO_INCREMENT=5 DEFAULT CHARSET=utf8mb4 COLLATE=utf8mb4_bin;

-- ----------------------------
-- Records of test_table
-- ----------------------------
BEGIN;
INSERT INTO `test_table` VALUES
(1, 'zhangsan', '12222222222', '23', 'aafasd'),
(2, 'lisi', '13333333333', '21', 'cxvcxv'),
(3, 'wanger', '14444444444', '24', 'dfdf'),
(4, 'liqiang', '18888888888', '18', 'ccsdf');
COMMIT;
盡量使用自增長主鍵
使用自增長主鍵的原因筆者認為有兩個。首先能有效減少頁分裂,MySQL中數據是以頁為單位存儲的且每個頁的大小是固定的(默認16kb),如果一個數據頁的數據滿了,則需要分成兩個頁來存儲,這個過程就叫做頁分裂。
如果使用了自增主鍵的話,新插入的數據都會盡量的往一個數據頁中寫,寫滿了之後再申請一個新的數據頁寫即可(大多數情況下不需要分裂,除非父節點的容量也滿了)。
自增主鍵
非自增主鍵
其次,對於緩存友好。系統分配給MySQL的內存有限,對於數據量比較多的數據庫來說,通常只有一小部分數據在內存中,而大多數數據都在磁盤中。如果使用無序的主鍵,則會造成隨機的磁盤IO,影響系統性能。
選擇性高的列優先
關注索引的選擇性。索引的選擇性,也可稱為數據的熵。在創建索引的時候通常要求將選擇性高的列放在最前面,對於選擇性不高的列甚至可以不創建索引。如果選擇性不高,極端性情況下可能會掃描全部或者大多數索引,然後再回表,這個過程可能不如直接走主鍵索引性能高。
索引列的選擇往往需要根據具體的業務場景來選擇,但是需要注意的是索引的區分度越高則價值就越高,意味着對於檢索的性價比就高。索引的區分度等於count(distinct 具體的列) / count(*),表示字段不重複的比例。
唯一鍵的區分度是1,而對於一些狀態值,性別等字段區分度往往比較低,在數據量比較大的情況下,甚至有無限接近0。假設一張表中用data_status來表示數據的狀態,1-有效,2-刪除,則數據的區分度為 1/500000。如果100萬條數據中只有1條被刪除,並且在查詢數據時查找data_status = 0 的數據時,需要進行全表掃描。由於索引也是需要佔用內存的,所以在內存較為有限的環境下,區分度不高的索引幾乎沒有意義。
聯合索引優先於多列獨立索引
聯合索引優先於多列獨立索引, 假設有三個字段a,b,c, 索引(a)(a,b),(a,b,c)可以使用(a,b,c)代替。MySQL中的索引並不是越多越好,各個公司的規定中往往會限制單表中的索引的個數。原因在於,索引本身也會佔用一定的空間,並且維護一個索引時有一定的代碼的,所以在滿足需求的情況下一定要盡可能創建更少的索引。
執行語句:
explain select * from test_table where a = "zhangsan";
explain select * from test_table where a = "zhangsan" and b = "188466668888";
explain select * from test_table where a = "zhangsan" and b = "188466668888" and c = "23";
執行結果分析:
實際上建立(a, b, c)聯合索引時,其作用相當於(a), (a, b), (a, b, c) 三個索引。所以以上三種查詢方式均會命中索引。
覆蓋索引避免回表
覆蓋索引如果執行的語句是 select ID from T where k between 3 and 5,這時只需要查 ID 的值,而 ID 的值已經在 k 索引樹上了,因此可以直接提供查詢結果,不需要回表。也就是說,在這個查詢裏面,索引 k 已經“覆蓋了”我們的查詢需求,我們稱為覆蓋索引。由於覆蓋索引可以減少樹的搜索次數,顯著提升查詢性能,所以使用覆蓋索引是一個常用的性能優化手段。
覆蓋索引的查詢優化
覆蓋索引同時還會影響索引的選擇,對於(a,b,c)索引來說,理論上來說不滿足最左匹配原則,但是實際上也會走索引。原因在於,優化器認為(a,b,c)索引的性能會高於全表掃描,實際情況也是這樣的,感興趣的小夥伴不妨分析一下上文中介紹的數據結構。
explain select a,b,c from test_table where b = "188466668888" and c = "23";
執行結果:
滿足查詢和排序
索引要滿足查詢和排序。大部分同學在創建索引時,通常第一反應是查詢條件來選擇索引列,需要注意的是查詢和排序同樣重要,我們建立的索引要同時滿足查詢和排序的需求.
包含要排序的列
select c, d from test_table where a = 1 and b = 2 order by c;
雖然查詢條件只使用了a,b兩個字段,但是由於排序用到了c字段,我們能可以建立(a,b,c)聯合索引來進行優化。
保證索引字段順序
如上文中的介紹,索引的字段順序決定了索引數據的組織順序。要想更高性能的檢索數據,一定要盡可能的藉助底層數據結構的特點來進行。如,索引(a, b)的默認組織形式就是先根據a排序,在a相同的情況下再根據b排序。
考慮索引的大小
內存中的空間十分寶貴,而索引往往又需要在內存中。為了在有限的內存中存儲更多的索引,在設計索引時往往要考慮索引的大小。比如我們常用的郵箱,xxxx@xx.com, 假設都是abc公司的,則郵箱後綴完全一致為@abc.com, 索引的區分度完全取決於@前面的字符串。
針對上述情況,MySQL 是支持前綴索引的,也就是說,你可以定義字符串的一部分作為索引。默認地,如果你創建索引的語句不指定前綴長度,那麼索引就會包含整個字符串。
如果使用的 email 整個字符串的索引結構執行順序是這樣的:從 index1 索引樹找到滿足索引值是’liqiang156@11.com’的這條記錄,取得 id (主鍵)的值ID2;到主鍵上查到主鍵值是ID2的行,將這行記錄加入結果集;
取 email 索引樹上剛剛查到的位置的下一條記錄,發現已經不滿足 email=’liqiang156@qq.com’的條件了,循環結束。這個過程中,只需要回主鍵索引取一次數據,所以系統認為只掃描了一行。但是它的問題就是索引的後半部分都是重複的,浪費內存。
這時我們可以考慮使用前綴索引,如果使用的是 index2 (email(7) 索引結構),執行順序是這樣的:從 index2 索引樹找到滿足索引值是’liqiang’的記錄,找到的第一個是 ID1,到主鍵上查到主鍵值是 ID1 的行,判斷出 email 的值是’liqiang156@xxx.com’,加入結果集。
取 index2 上剛剛查到的位置的下一條記錄,發現仍然是’liqiang’,取出 ID2,再到 ID 索引上取整行然後判斷,這次值仍然不對,則丟棄繼續往下取。
重複上一步,直到在 index2 上取到的值不是’liqiang’或者索引搜索完畢之後,循環結束。在這個過程中,要回主鍵索引取 4 次數據,也就是掃描了 4 行。通過這個對比,你很容易就可以發現,使用前綴索引后,可能會導致查詢語句讀數據的次數變多。
不過方法總比困難多,我們在建立索引時可以先通過語句查看一下索引的區分度,或者提前預估餘下前綴長度,對於上述問題我們可以將前綴長度調整為9即可達到效果。索引,在使用前綴索引時,一定要充分考慮數據的特徵,選擇合適的
對於一些比較長的字段的等值查詢,我們也可以採用其他方式來縮短索引的長度。比如url一般都是比較長,我們可以冗餘一列存儲其Hash值。
select field_list from t where id_card_crc=crc32('input_id_card_string') and id_card='input_id_card_string'
對於我們國家的身份證號,一共 18 位,其中前 6 位是地址碼,所以同一個縣的人的身份證號前 6 位一般會是相同的。為了提高區分度,我們可以將身份證號碼倒序存儲。
select field_list from t where id_card = reverse('input_id_card_string');
建立合適的索引是前提,想要取得理想的查詢性能,還應保證能夠用到索引。避免索引失效即是優化。
不在索引上進行任何操作
索引上進行計算,函數,類型轉換等操作都會導致索引從當前位置(聯合索引多個字段,不影響前面字段的匹配)失效,可能會進行全表掃描。
explain select * from test_table where upper(a) = "ZHANGSAN"
對於需要計算的字段,則一定要將計算方法放在“=”後面,否則會破壞索引的匹配,目前來說MySQL優化器不能對此進行優化。
explain select * from test_table where a = lower("ZHANGSAN")
隱式類型轉換
需要注意的是,在查詢時一定要注意字段類型問題,比如a字段時字符串類型的,而匹配參數用的是int類型,此時就會發生隱式類型轉換,相當於相當於在索引上使用函數。
explain select * from test_table where a = 1;
a是字符串類型,然後使用int類型的1進行匹配,此時就發生了隱式類型轉換,破壞索引的使用。
只查詢需要的列
在日常開發中很多同學習慣使用 select * … 來構建查詢語句,這種做法也是極不推薦的。主要原因有兩個,首先查詢無用的列在數據傳輸和解析綁定過程中會增加網絡IO,以及CPU的開銷,儘管往往這些消耗可以被忽略,但是我們也要避免埋坑。
explain select a,b,c from test_table where a="zhangsan" and b = "188466668888" and c = "23";
其次就是會使得覆蓋索引”失效”, 這裏的失效並非真正的不走索引。覆蓋索引的本質就是在索引中包含所要查詢的字段,而 select * 將使覆蓋索引失去意義,仍然需要進行回表操作,畢竟索引通常不會包含所有的字段,這一點很重要。
explain select * from test_table where a="zhangsan" and b = "188466668888" and c = "23";
不等式條件
查詢語句中只要包含不等式,負向查詢一般都不會走索引,如 !=, <>, not in, not like等。
explain select * from test_table where a !="1222" and b="12222222222" and c = 23;
explain select * from test_table where a <>"1222" and b="12222222222" and c = 23;
explain select * from test_table where a not in ("xxxx");
模糊匹配查詢
最左前綴在進行模糊匹配時,一般禁止使用%前導的查詢,如like “%zhangsan”。
explain select * from test_table where a like "zhangsan";
explain select * from test_table where a like "%zhangsan";
explain select * from test_table where a like "zhangsan%";
最左匹配原則
索引是有順序的,查詢條件中缺失索引列之後的其他條件都不會走索引。比如(a, b, c)索引,只使用b, c索引,就不會走索引。
explain select * from test_table where b = "188466668888" and c = "23";
如果索引從中間斷開,索引會部分失效。這裏的斷開指的是缺失該字段的查詢條件,或者說滿足上述索引失效情況的任意一個。不過這裏的仍然會使用到索引,只不過只能使用到索引的前半部分。
explain select * from test_table where a="zhangsan" and b != 1 and c = "23"
值得注意的是,如果使用了不等式查詢條件,會導致索引完全失效。而上一個例子中即使用了不等式條件,也使用了隱式類型轉換卻能用到索引。
同理,根據最左前綴匹配原則,以下如果使用b,c作為查詢條件則不會使用(a, b, c)索引。
執行語句:
explain select * from test_table where b = "188466668888" and c = "23";
執行結果:
索引下推
在說索引下推之前,我們先執行一下SQL。
執行語句:
explain select * from test_table where a = "zhangsan" and c = "23";
上述的最左前綴匹配原則相信大家都能很容易的理解,那麼使用(a, c)條件查詢能夠利用(a, b, c)嗎?答案是肯定的,正如上圖所示。即使沒有索引下推也會會根據最左匹配原則,使用到索引中的a字段。有了索引下推之後會增加查詢的效率。
在面試中通常會問到這樣一個問題,已知有索引(a,b,c)則根據條件(a,c)查詢時會不會走索引呢?答案是肯定的,但是是有版本限制的。
而 MySQL 5.6 引入的索引下推優化(index condition pushdown), 可以在索引遍歷過程中,對索引中包含的字段先做判斷,直接過濾掉不滿足條件的記錄,減少回表次數,是對查詢的一種優化,感興趣的同學可以看一下官方說明https://dev.mysql.com/doc/refman/8.0/en/index-condition-pushdown-optimization.html。
上述是沒有索引下推,每次查詢完之後都會回表,取到對應的字段進行匹配。
利用索引下推,每次盡可能在輔助索引中將不符合條件數據過濾掉。比如,索引中已經包含了name和age,索引不妨暫且忽略破壞索引匹配的條件直接匹配。
查詢優化-自適應索引順序
查詢時,mysql的優化器會優化sql的執行,即使查詢條件的順序沒有按照定義順序來使用,也是可以使用索引的。但是需要注意的是優化本身也會消耗一定的性能,所以還是推薦按照索引的定義來書寫sql。
explain select  * from test_table where b="12222222222" and a="zhangsan" and c = 23;
explain select  * from test_table where a="zhangsan" and b="12222222222" and c = 23;
索引並不是什麼高深的技術,從底層來看,不過是一個數據結構罷了。要想使用好索引,一定要先將B+Tree理解透徹,在此基礎上對於日常使用和面試則是信手拈來。
脫離業務的設計都是耍流氓,技術的意義在於服務業務。所以,索引的設計需要充分考慮業務的需求與設計原則之間做一些取捨,滿足需求是基礎。
在工作中,各個公司的版本可能大不相同,會存在一些奇奇怪怪,不確定的問題。所以為了驗證索引的有效性,強烈推薦把主要的查詢sql都通過explain查看一下執行計劃,是否會用到索引。
參考資料:
[1] 《MySQL 45講》—極客時間
[2] 《InnoDB存儲引擎》
[3] 《高性能MySQL》
[4] https://dev.mysql.com/doc/refman/8.0/en/
本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線
※Google地圖已可更新顯示潭子電動車充電站設置地點!!
※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益
※別再煩惱如何寫文案,掌握八大原則!
※網頁設計最專業,超強功能平台可客製化
※聚甘新

 |
車王電11月30日召開法說會,董事長蔡裕慶表示,目前電動工具訂單受惠於美國通路商挹注,產能滿載、訂單能見度看到2018年4月;此外,投資入股的華德動,預期在未來2年,可成為公司獲利金雞母。 蔡裕慶指出,看好電動車將是未來趨勢,新能源、儲能、電動巴士及汰役電池等,將是車王電未來經營重點。此外,華德動為是唯一可接受交通部補助的電動巴士廠商,其透過與日本住友等廠商,將電動巴士技術及供應鏈輸出至全球,預期未來2年,可望成為公司獲利金雞母。 另外,在電動工具部份,車王電表示,整體訂單能見度可看到明年4月,同時,預期第四季電動工具出貨將年成長3、4成,今年佔營收比重將從去年17%攀升至25%,且明年電動工具出貨更將比今年成長40%以上。 (本文內容由授權使用。首圖來源:華德動)
本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線
※Google地圖已可更新顯示潭子電動車充電站設置地點!!
※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益
※別再煩惱如何寫文案,掌握八大原則!
※網頁設計最專業,超強功能平台可客製化
※聚甘新
 |
中油董事長戴謙在 5 日表示,中油必須轉型朝向綠能目標發展,所以規劃自明年起將編列 20 億元預算,來增設千座電動車充電站。 中油新任董事長戴謙其農牧專業曾被外界質疑是否為董座的合適人選,不過其認為作為南科管理局局長展現的績效可被檢驗。如今上任滿一個月,已決定要宣布中油未來的轉型計畫,將配合政府政策,限縮燃煤,推廣電動機車。目前 Gogoro 全台已有 475 座機車充電站,其中有 109 座是與中油合作。 據《經濟日報》報導,戴謙強調,國營企業當然要支持國家政策,況且如果將來電動機車數量增多了,那中油要加油站做什麼。所以他認為,中油要面對轉型問題,未來成為「中油綠能站」,不只提供化石燃料,也要經營綠能市場,符合社會趨勢。目前中油擬定的做法是要先響應經濟部工業局推廣電池交換站(充電站)計畫,從明年起三年內,要在全台加油站點同時布建一千座充(換)電站,給電動機車充電。 中油副總畢淑蒨也出面說明細節表示,此計畫將以 20 億元預算逐年進行建設,第一年 160 座,第二年 390 座,第三年 450 座等進度來完成,而充電站與交換電池站建設比例大約為 1:9。針對現階段實施地點,畢淑蒨表示,明年將啟動示範場域評估可行性,目前大都會區以及空汙較為嚴重地區會是優先選項,特別的是還包含離島澎湖,這是因為行政院希望能將其打造位智慧及綠能的觀光島。 戴謙表示,雖然如此,但民眾不用擔心未來不會真的沒油可加,中油加油站會先採「加油、加電」雙軌併行,等到真的全台灣全面改用電動汽機車後,再轉型成純加電站。他還強調,中油轉型其電力供應不能光靠台電,未來將藉由社區民眾的綠能設備把電力輸送至中油加油站點裝設的儲能裝置,讓中油轉型成為社區的充換電基載中心,扮演公民電廠、社區貯能的節點角色。 (合作媒體:。首圖來源:中油)
本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
※想知道最厲害的網頁設計公司“嚨底家”!
※別再煩惱如何寫文案,掌握八大原則!
※產品缺大量曝光嗎?你需要的是一流包裝設計!
※聚甘新
 |
路透社12月5日報導,全球五大礦商之一的嘉能可(Glencore plc)加大投入電動車電池所需金屬的生產,因看好電動車市場的成長。路透社委託S&P Global Market Intelligence所做的研究顯示,嘉能可過去五年的銅與鈷產量都已經倍增,鎳產量更是四倍增長。其中,該公司銅產量從2011年的70萬噸增加至2016年的140萬噸,鈷產量從2011年的12,880公噸增加至2016年的28,300公噸,鎳產量從2011年的28,500公噸增加至2016年的115,100公噸。 報告顯示,銅鈷鎳等電動車相關金屬佔嘉能可核心獲利的五成比重,相比競爭對手包括力拓(Rio Tinto)、必和必拓(BHP Billiton)以及英美資源(Anglo American)等高出一倍。另一方面,嘉能可的股價自2015年以來已經上漲400%,2017年至今的漲幅也超過20%,表現也同樣優於其他三家競爭對手。 2017年1~9月,嘉能可銅產量較去年同期的106萬噸減少11%至94.65萬噸,主要由於尚比亞銅礦遭遇供電問題的影響。嘉能可也將今年全年的銅產量目標下調2%至131萬噸,較該公司去年的銅產量將減少8%。今年第三季,該公司的銅產量年減15%至30.36萬噸。 2017年1~9月,嘉能可的鋅產量年增4.8%至82.74萬噸,但是第三季的產量年減9%至25.66萬噸,較前季也減少12%。該公司也將全年的鋅產量目標下調2%至113萬噸。1~9月,該公司鎳產量年減2%至80,700公噸,全年產量則預估較去年持平為115,000公噸。 必和必拓商務長巴爾惠森(Arnoud Balhuizen)稱銅是「未來的金屬」,因2017年電動車迎來革命性的一年,市場大大低估了銅的需求潛力。國際銅業協會(International Copper Association)報告表示,電動汽車的產業增長,可望令未來十年該產業的銅需求量大幅增長,預估將從2017年的18.5萬噸增長至2027年的174萬噸,主要因為電動汽車較傳統汽車使用更多銅的影響。 加拿大蒙特利爾銀行資本市場(BMO Capital Markets)12月4日報告表示,受惠電動車電池需求的增長,鈷的價格在未來兩年預期將會大幅攀升。報告預估,鈷的價格將從當前的每磅30美元,上漲至2019年的每磅40.50美元(每噸89,290美元),並且不排除有倍增的可能。鈷價2017年至今已經上漲一倍,年初的價格約為每磅14.75美元。電動車電池的正極材料包括鋰、鈷與鎳,負極材料包括石墨與銅箔。 (本文內容由授權使用。首圖來源:public domain CC0)
本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益
※別再煩惱如何寫文案,掌握八大原則!
※教你寫出一流的銷售文案?
※超省錢租車方案
※FB行銷專家,教你從零開始的技巧
※聚甘新

 |
目前各個國家逐漸以禁售汽柴油車為目標,此舉不僅讓眾多廠商著手研發電動車,電池市場也隨之受惠,能源顧問公司Wood Mackenzie近日報告指出,到了2020年,電動車電池的產能可達到268GW,而2028年之後,電動車產量越來越高,電池的需求量將逐漸超越產量。 該報告預估,2035年世界上會有超過1.25億輛電動車,電池的需求量將增長三倍,達135 TWh,等同於美國德州的耗電量。 在去年全球8,600萬輛的新車中,電動車比例不到1%,而隨著國家政策轉變,市場趨勢逐漸轉移。以各國政策為例,印度預計2030年全面將汽車汰換成電動車,英國與法國則是預設2040年禁止販售傳統汽車,中國、歐洲與美國也皆強力推動電動車發展。 面對不斷增漲的電動車市場,電池製造廠商也摩拳擦掌,研發各種適用於電動車的電池,包括鋰離子電池、固態電池與燃料電池,不斷推出高續航力、高性能的電池。隨著電動車與電池的技術日益提高與成本逐年下降,產業市場未來備受看好。
石油市場受影響 根據石油輸出國組織(OPEC)的預估,2020年石油市場中,全球用於運輸的油佔60%以上,其中柴油與航空煤油的佔比最大,達到37.3%,其次則是汽油,使用佔比為26.6%。如汽車或運輸產業的燃油逐漸被電池取代,將對原油業產生巨大的衝擊。 報告指出,在未來20年內,電動車將占汽車市場的20%,全球石油需求量將下滑7%,預估每日減少500萬桶石油。 再加上各國為了達成「巴黎協定」,也逐漸減少對石油與天然氣的使用量,日前世界銀行更宣布,為了與各國一同響應排碳目標,2019年之後將不再資助石油與天然氣的探勘與開採。 (首圖來源:)
本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※別再煩惱如何寫文案,掌握八大原則!
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
※超省錢租車方案
※教你寫出一流的銷售文案?
※網頁設計最專業,超強功能平台可客製化
※聚甘新
微服務是一種架構的理念,提出了微服務的設計原則,從理論為具體的技術落地提供了指導思想。
實施微服務需要具備以下條件:
Spring Boot 是一套快速配置腳手架,可以基於 Spring Boot 快速開發單個微服務。
Spring Cloud 是一個基於 Spring Boot 實現的服務治理工具包;Spring Boot 專註於快速、方便集成的單個微服務個體;Spring Cloud 關注全局的服務治理框架。
Spring Boot / Cloud 是微服務實踐的最佳落地方案。
當然,微服務的設計還對運維提出了更高的要求,如何進行自動構建,如何進行自動發布,對於應用程序的質量管理以及遇到峰值時如何通過橫向擴展、彈性伸縮對於整個技術團隊都提出了更高的要求。
開源 RPC 框架有哪些呢?
一類是跟某種特定語言平台綁定的,另一類是與語言無關即跨語言平台的。
跟語言平台綁定的開源 RPC 框架主要有下面幾種。
而跨語言平台的開源 RPC 框架主要有以下幾種。
REST是一種架構風格,指的是一組架構約束條件和原則。滿足這些約束條件和原則的應用程序或設計就是 RESTful。REST規範把所有內容都視為資源,網絡上一切皆資源。
REST並沒有創造新的技術,組件或服務,只是使用Web的現有特徵和能力。 可以完全通過HTTP協議實現,使用 HTTP 協議處理數據通信。REST架構對資源的操作包括獲取、創建、修改和刪除資源的操作正好對應HTTP協議提供的GET、POST、PUT和DELETE方法。
REST與RPC比較
| 比較項 規範 | REST | RPC |
| 通信協議 | HTTP | 一般使用TCP |
| 性能 | 低 | 高 |
| 靈活度 | 高 | 低 |
高與低是對實現兩種規範框架的相對比較,但也不是絕對的,需要根據實際情況而定。
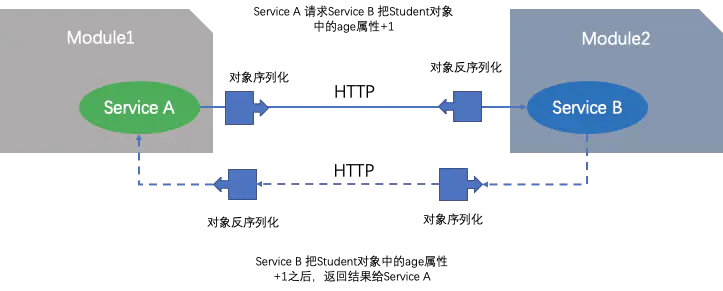
都是網絡交互的協議規範。通常用於多個微服務之間的通信協議。
REST和RPC都常用於微服務架構中。
RPC在微服務中的作用,RPC 框架作為架構微服務化的基礎組件,它能大大降低架構微服務化的成本,提高調用方與服務提供方的研發效率,屏蔽跨進程調用函數(服務)的各類複雜細節。讓調用方感覺就像調用本地函數一樣調用遠端函數、讓服務提供方感覺就像實現一個本地函數一樣來實現服務。
本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
※想知道最厲害的網頁設計公司“嚨底家”!
※別再煩惱如何寫文案,掌握八大原則!
※產品缺大量曝光嗎?你需要的是一流包裝設計!
※聚甘新
隨着大數據和AI業務的不斷融合,大數據分析和處理過程中,通過深度學習技術對非結構化數據(如圖片、音頻、文本)進行大數據處理的業務場景越來越多。本文會介紹Spark如何與深度學習框架進行協同工作,在大數據的處理過程利用深度學習框架對非結構化數據進行處理。
Spark是大規模數據處理的事實標準,包括機器學習的操作,希望把大數據處理和機器學習管道整合。
Spark使用函數式編程範式擴展了MapReduce模型以支持更多計算類型,可以涵蓋廣泛的工作流。Spark使用內存緩存來提升性能,因此進行交互式分析也足夠快速(如同使用Python解釋器,與集群進行交互一樣)。緩存同時提升了迭代算法的性能,這使得Spark非常適合機器學習。
由於Spark庫提供了Python、Scale、Java編寫的API,以及內建的機器學習、流數據、圖算法、類SQL查詢等模塊;Spark迅速成為當今最重要的分佈式計算框架之一。與YARN結合,Spark提供了增量,而不是替代已存在的Hadoop集群。在最近的Spark版本中,Spark加入了對於K8s的支持,為Spark與AI能力的融合提供了更好的支持。
TensorFlow
TensorFlow最初是由Google機器智能研究部門的Google Brain團隊開發,基於Google 2011年開發的深度學習基礎架構DistBelief構建起來的。由於Google在深度學習領域的巨大影響力和強大的推廣能力,TensorFlow一經推出就獲得了極大的關注,並迅速成為如今用戶最多的深度學習框架。
TensorFlow是一個非常基礎的系統,因此也可以應用於眾多領域。但由於過於複雜的系統設計,對讀者來說,學習TensorFlow底層運行機制更是一個極其痛苦的過程。TensorFlow的接口一直處於快速迭代之中,並且沒有很好地考慮向後兼容性,這導致現在許多開源代碼已經無法在新版的TensorFlow上運行,同時也間接導致了許多基於TensorFlow的第三方框架出現BUG。
Keras
Keras 於2015年3月首次發布,擁有“為人類而不是機器設計的API”,得到Google的支持。它是一個用於快速構建深度學習原型的高層神經網絡庫,由純Python編寫而成,以TensorFlow、CNTK、Theano和MXNet為底層引擎,提供簡單易用的API接口,能夠極大地減少一般應用下用戶的工作量。
嚴格意義上講,Keras並不能稱為一個深度學習框架,它更像一個深度學習接口,它構建於第三方框架之上。Keras的缺點很明顯:過度封裝導致喪失靈活性。Keras最初作為Theano的高級API而誕生,後來增加了TensorFlow和CNTK作為後端。學習Keras十分容易,但是很快就會遇到瓶頸,因為它缺少靈活性。另外,在使用Keras的大多數時間里,用戶主要是在調用接口,很難真正學習到深度學習的內容。
PyTorch
PyTorch於2016年10月發布,是一款專註於直接處理數組表達式的低級API。 前身是Torch(一個基於Lua語言的深度學習庫)。Facebook人工智能研究院對PyTorch提供了強力支持。PyTorch支持動態計算圖,為更具數學傾向的用戶提供了更低層次的方法和更多的靈活性,目前許多新發表的論文都採用PyTorch作為論文實現的工具,成為學術研究的首選解決方案。
Caffe/Caffe2.0
Caffe的全稱是Convolutional Architecture for Fast Feature Embedding,它是一個清晰、高效的深度學習框架,於2013年底由加州大學伯克利分校開發,核心語言是C++。它支持命令行、Python和MATLAB接口。Caffe的一個重要特色是可以在不編寫代碼的情況下訓練和部署模型。如果您是C++熟練使用者,並對CUDA計算游刃有餘,你可以考慮選擇Caffe。
在Spark程序中使用一個預訓練過的模型,將其并行應用於大型數據集的數據處理。比如,給定一個可以識別圖片的分類模型,其通過一個標準數據集(如ImageNet)訓練過。可以在一個Spark程序中調用一個框架(如TensorFlow或Keras)進行分佈式預測。通過在大數據處理過程中調用預訓練模型可以直接對非結構化數據進行直接處理。
我們重點介紹在Spark程序中使用Keras+TensorFlow來進行模型推理。
使用深度學習處理圖片的第一步,就是載入圖片。Spark 2.3中新增的ImageSchema包含了載入數百萬張圖像到Spark DataFrame的實用函數,並且以分佈式方式自動解碼,容許可擴展地操作。
使用Spark’s ImageSchema:
from pyspark.ml.image import ImageSchema
image_df = ImageSchema.readImages("/data/myimages")
image_df.show()
也可以利用Keras的圖片處理庫:
from keras.preprocessing import image
img = image.load_img("/data/myimages/daisy.jpg", target_size=(299, 299))
可以通過圖片路徑來構造Spark DataFrame:
def get_image_paths_df(sqlContext, dirpath, colName):
    files = [os.path.abspath(os.path.join(dirpath, f)) for f in os.listdir(dirpath) if f.endswith('.jpg')]
    return sqlContext.createDataFrame(files, StringType()).toDF(colName)
使用Keras接口加載預訓練模型:
from keras.applications import InceptionV3
model = InceptionV3(weights="imagenet")
model.save('/tmp/model-full.h5')
model = load_model('/tmp/model-full.h5')
定義圖片識別推理方法:
def iv3_predict(fpath):
            model = load_model('/tmp/model-full.h5')
            img = image.load_img(fpath, target_size=(299, 299))
            x = image.img_to_array(img)
            x = np.expand_dims(x, axis=0)
            x = preprocess_input(x)

            preds = model.predict(x)
            preds_decode_list = decode_predictions(preds, top=3)
            tmp = preds_decode_list[0]
            res_list = []
            for x in tmp:
                res = [x[0], x[1], float(x[2])]
                res_list.append(res)
            return res_list
定義推理輸入結果Schema:
def get_labels_type():
    ele_type = StructType()
    ele_type.add("class", data_type=StringType())
    ele_type.add("description", data_type=StringType())
    ele_type.add("probability", data_type=FloatType())
    return ArrayType(ele_type)
將推理方法定義成Spark UDF:
spark.udf.register("iv3_predict", iv3_predict, returnType=get_labels_type())
載入圖片定義為數據表:
df = get_image_paths_df(self.sql)
df.createOrReplaceTempView("_test_image_paths_df")
使用SQL語句對接圖片進行處理:
df_images = spark.sql("select fpath, iv3_predict(fpath) as predicted_labels from _test_image_paths_df")
df_images.printSchema()
df_images.show(truncate=False)
在大數據Spark引擎中使用深度學習框架加載預處理模型,來進行非結構數據處理有非常多的應用場景。但是由於深度學習框架目前比較多,模型與框架本身是深度耦合,在大數據環境中安裝和部署深度學習框架軟件及其依賴軟件會非常複雜,同時不利於大數據集群的管理和維護,增加人力成本。
華為雲DLI服務,採用大數據Serverless架構,用戶不需要感知實際物理集群,同時DLI服務已經在大數據集群中內置了AI計算框架和底層依賴庫(Keras/tensorflow/scikit-learn/pandas/numpy等)。DLI最新版本中已經支持k8s+Docker生態,並開放用戶自定義Docker鏡像能力,提供給用戶來擴展自己的AI框架、模型、算法包。在Serverless基礎上,為用戶提供更加開放的自定義擴展能力。
DLI支持多模引擎,企業僅需使用SQL或程序就可輕鬆完成異構數據源的批處理、流處理等,挖掘和探索數據信息,揭示其中的規律並發現數據潛在價值,華為雲618年中鉅惠,大數據+AI專場,歷史低價,助力企業“智能化”,業務“數據化”。
點擊關注,第一時間了解華為雲新鮮技術~
本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益
※別再煩惱如何寫文案,掌握八大原則!
※教你寫出一流的銷售文案?
※超省錢租車方案
※FB行銷專家,教你從零開始的技巧
※聚甘新
題記:昨晚在一個技術社區直播分享了“利用Azure Functions和k8s構建Serverless計算平台”這一話題。整個分享分為4個部分:Serverless概念的介紹、Azure Functions的簡單介紹、k8s和KEDA的介紹和最後的演示。
Serverless其實包含了兩種概念:BaaS(Backend as a Service)和FaaS(Function as a Service)。這次的分享主要針對的是FaaS概念。
FaaS的最大特徵就是:無需管理自己的服務器或擁有自己的持續運行的服務應用的情況下運行後端代碼。 上面加粗的地方其實也揭示了FaaS和PaaS的本質區別:你為了運行後端代碼,需不需要擁有一套持續運行的服務端完整應用(不管是WebSite還是Web API)。
另外,FaaS還擁有如下特徵:
當然判斷什麼東西不是FaaS也有一些標準:
使用FaaS有其優缺點,這裏就報喜不報憂,只列一下優點:
以官方文檔的介紹:Azure Functions 允許你運行小段代碼(稱為“函數”)且不需要擔心應用程序基礎結構。 藉助 Azure Functions,雲基礎結構可以提供應用程序保持規模化運行所需的所有最新狀態的服務器。 函數由特定類型的事件“觸發”。 支持的觸發器包括對數據更改做出響應、對消息做出響應、按計劃運行,或者生成 HTTP 請求的結果。 雖然你始終可以直接針對大量服務編寫代碼,但使用綁定可以簡化與其他服務的集成。 使用綁定,你能夠以聲明方式訪問各種 Azure 服務和第三方服務。
Azure Functions包含如下功能:
大家看到了,Azure Functions雖然是來源於微軟Azure的技術,但是是使用MIT協議開源的,且已經貢獻給.NET Foundation。
所以,你可以使用Azure Functions來搭建(甚至定製)自己的Serverless計算平台。開源的不僅是Azure Functions框架本身,還包括了命令行工具(可以支持本地調試)和VSCode的擴展。當然,開發工具除了前面兩者,你還是可以使用宇宙第一的IDE:Visual Studio。
下面是相關開源的地址:
只有開源的框架還不行,還需要運行環境,正如大部分開源FaaS框架一樣,Azure Functions也把k8s作為運行環境。不過為了達到自動伸縮、不使用就不消耗資源的目標,還需要搭配其他中間件才能達到效果。
眾所周知,Kubernetes已經成為最主流的PaaS平台,各大公有雲提供商都提供了k8s的服務,比如微軟Azure上的AKS或者阿里雲的ACK。
為了更好的理解為什麼k8s可以作為Serverless完美的運行環境,是需要對如下概念有一些深入的理解的:
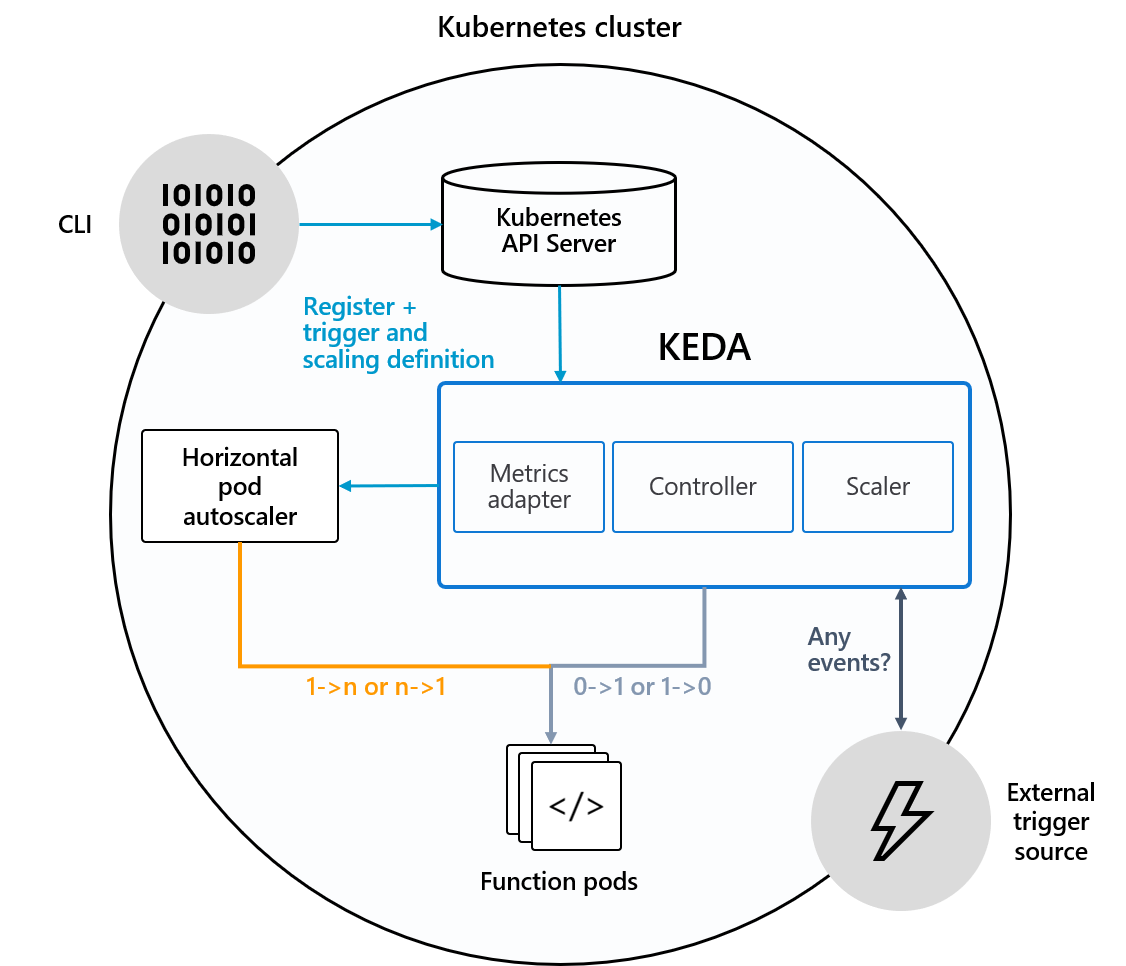
k8s雖然提供了HPA,但是它無法基於更靈活的事件源來進行伸縮,也無法把Pod的實例數縮到0,或者由0伸到1。這個時候,就需要另外一個開源項目KEDA出場了(貢獻者來自微軟、AWS等大公司,以及很多社區志願者)。
KEDA:Kubernetes Event-driven Autoscaling。項目地址在:https://github.com/kedacore/keda。其具有如下特點:
KEDA的架構如下圖所示:
從這個架構圖,我們看到KEDA包含了3個組件,Metric Adapter給k8s的HPA提供度量指標讓其進行1-n/n-1的伸縮,Controller控制Pod進行1-0/0-1的伸縮,Scaler偵聽配置的觸發器所觸發的事件。
且支持的伸縮器涵蓋了大部分主流雲組件或中間件:
既然Azure Functions是開源技術,為了驗證技術中立性,在演示過程中特意選擇了阿里雲的ACK作為運行環境(Kubernetes託管版),並使用RabbitMQ作為伸縮觸發器。
同時,我們採用C#/.NET Core來作為函數的開發語言。為什麼用這個選擇,是因為有第三方對AWS Lambda上的支持的語言進行了性能測試,得到的結論是.NET Core的C#和F#語言性能最高:
來源:https://read.acloud.guru/comparing-aws-lambda-performance-of-node-js-python-java-c-and-go-29c1163c2581
首先,需要到阿里雲上創建一個k8s集群,創建的選項截圖如下:
通過如下命令來部署KEDA到k8s:
helm repo add kedacore https://kedacore.github.io/charts
kubectl create namespace keda
helm install keda kedacore/keda --namespace keda
通過如下命令來部署RabbitMQ到k8s:
helm repo add bitnami https://charts.bitnami.com/bitnami
helm install rabbitmq --set rabbitmq.password=PASSWORD,service.type=LoadBalancer bitnami/rabbitmq
這裏需要注意(當然也可能是我打開方式不對),阿里雲的ACK不能自動創建pv,所以rabbitmq部署後會有問題,所以需要到阿里雲的ACK的控制面板裏面手動創建pv,並重建rabbitmq所需的同名pvc。
訪問:https://github.com/Azure/azure-functions-core-tools,安裝命令行工具。
在命令行中輸入:
func init --docker
來初始化一個帶有Dockerfile的Azure Functions項目,worker runtime選擇dotnet。
在命令行中輸入:
func function create
來創建一個函數,template選擇QueueTrigger,輸入你想要的函數名稱。
使用你喜歡的編輯器(比如VSCode)打開項目文件夾,修改csproj文件中的PackageReference為如下內容:
<ItemGroup>
  <PackageReference Include="Microsoft.NET.Sdk.Functions" Version="3.0.3" />
  <PackageReference Include="Microsoft.Azure.WebJobs.Extensions.RabbitMQ" Version="0.2.2029-beta" />
</ItemGroup>
修改函數代碼為如下內容:
[FunctionName("MyMqFunction")]
public static void Run(
    [RabbitMQTrigger("queue", ConnectionStringSetting = "RabbitMqConnection")] string inputMessage,
    [RabbitMQ(QueueName = "downstream", ConnectionStringSetting = "RabbitMqConnection")] out string outputMessage,
        ILogger log)
{
    Thread.Sleep(5000);
    outputMessage = inputMessage;
    log.LogInformation($"RabittMQ output binding function sent message: {outputMessage}");
}
這個函數從一個名為”queue“的隊列中讀取inputMessage,延遲5秒后,把消息存儲到名為”downstream”的隊列中。
打開local.settings.json文件,在Values節點下添加RabbitMqConnection:
"Values": {
  "AzureWebJobsStorage": "UseDevelopmentStorage=true",
  "FUNCTIONS_WORKER_RUNTIME": "dotnet",
  "RabbitMqConnection":"amqp://user:PASSWORD@rabbitmq.default.svc.cluster.local:5672"
},
這裏RabbitMQ的地址使用了k8s內部的默認Service地址,為了方便本地調試,你可以獲取到RabbitMQ在k8s的公網IP后,給這個域名添加host配置。
在命令行中輸入:
func start
就可以進行本地調試了。調試無誤,就可以進行發布到k8s的工作了。
以上示例代碼可以在這裏找到:https://github.com/heavenwing/AzFuncOnK8S
考慮到我用的阿里雲拉取Docker Hub比較慢,所以我是編譯出Docker Image后,push到了阿里雲的鏡像倉庫當中。 另外,我這裏還遇到一個問題,就是能在AKS中正常運行的Docker Image在ACK中無法正常運行,出現”Access to the path ‘/proc/1/map_files’ is denied”的錯誤,我的臨時解決辦法是修改Dockerfile文件,添加WORKDIR命令。
在把Docker Image推送到鏡像倉庫后,可以在命令行中輸入:
func kubernetes deploy --name azfunconk8s --image-name registry.cn-chengdu.aliyuncs.com/zygcloud/azfunconk8s:latest --dry-run > deploy-funcs.yaml
得到部署的yaml文件后,我們需要對ScaledObject進行一點修改,為rabbitmq的trigger配置添加queueLength,根據需要配置maxReplicaCount屬性,如下所示:
apiVersion: keda.k8s.io/v1alpha1
kind: ScaledObject
metadata:
  name: azfunconk8s
  namespace: default
  labels:
    deploymentName: azfunconk8s
spec:
  scaleTargetRef:
    deploymentName: azfunconk8s
  maxReplicaCount: 20
  triggers:
  - type: rabbitmq
    metadata:
      type: rabbitMQTrigger
      queueName: queue
      name: inputMessage
      host: RabbitMqConnection
      queueLength: "20"
現在就可以把函數部署到k8s了,在命令行中輸入:
kubectl apply -f .\deploy\deploy-funcs.yaml
這個時候應該可以看到k8s出現了名為azfunconk8s的Deployment,且需要實例和運行實例數都是為0:
另外寫一個小程序,往RabbitMQ的queue隊列裏面放一些測試消息,經過30秒(默認pollingInterval時間)那麼就會看到這個Deployment的所需實例數在提高,一直提高到你設置的maxReplicaCount。等隊列中的消息處理完成,又會看到所需實例數在降低,等沒有消息需要處理之後過上5分鐘(默認cooldownPeriod時間),所需實例數就會變為0。
能看到這裏的小夥伴都是愛學習的,應該紅包獎勵,不過當然是需要回答問題的。
問:KEDA解決的是非http的觸發器伸縮,那麼什麼東西可以解決http觸發器伸縮問題?
在我的公眾號中輸入答案,獲取支付寶紅包口令,數量有限先答對先得。
本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】
※別再煩惱如何寫文案,掌握八大原則!
※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!
※超省錢租車方案
※教你寫出一流的銷售文案?
※網頁設計最專業,超強功能平台可客製化
※聚甘新