部落格

  • Spring Boot2 系列教程(二十六)Spring Boot 整合 Redis

    Spring Boot2 系列教程(二十六)Spring Boot 整合 Redis

    在 Redis 出現之前,我們的緩存框架各種各樣,有了 Redis ,緩存方案基本上都統一了,關於 Redis,松哥之前有一個系列教程,尚不了解 Redis 的小夥伴可以參考這個教程:

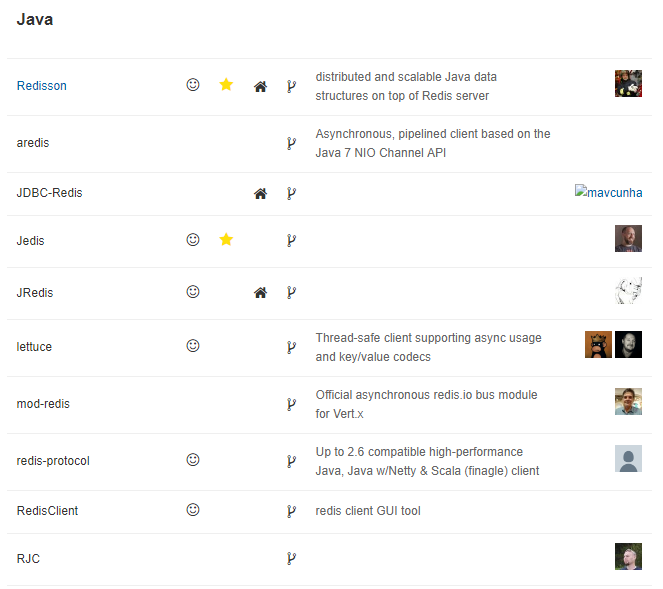
    使用 Java 操作 Redis 的方案很多,Jedis 是目前較為流行的一種方案,除了 Jedis ,還有很多其他解決方案,如下:

    除了這些方案之外,還有一個使用也相當多的方案,就是 Spring Data Redis。

    在傳統的 SSM 中,需要開發者自己來配置 Spring Data Redis ,這個配置比較繁瑣,主要配置 3 個東西:連接池、連接器信息以及 key 和 value 的序列化方案。

    在 Spring Boot 中,默認集成的 Redis 就是 Spring Data Redis,默認底層的連接池使用了 lettuce ,開發者可以自行修改為自己的熟悉的,例如 Jedis。

    Spring Data Redis 針對 Redis 提供了非常方便的操作模板 RedisTemplate 。這是 Spring Data 擅長的事情,那麼接下來我們就來看看 Spring Boot 中 Spring Data Redis 的具體用法。

    方案一:Spring Data Redis

    創建工程

    創建工程,引入 Redis 依賴:

    創建成功后,還需要手動引入 commos-pool2 的依賴,因此最終完整的 pom.xml 依賴如下:

    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-data-redis</artifactId>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.apache.commons</groupId>
            <artifactId>commons-pool2</artifactId>
        </dependency>
    </dependencies>

    這裏主要就是引入了 Spring Data Redis + 連接池。

    配置 Redis 信息

    接下來配置 Redis 的信息,信息包含兩方面,一方面是 Redis 的基本信息,另一方面則是連接池信息:

    spring.redis.database=0
    spring.redis.password=123
    spring.redis.port=6379
    spring.redis.host=192.168.66.128
    spring.redis.lettuce.pool.min-idle=5
    spring.redis.lettuce.pool.max-idle=10
    spring.redis.lettuce.pool.max-active=8
    spring.redis.lettuce.pool.max-wait=1ms
    spring.redis.lettuce.shutdown-timeout=100ms

    自動配置

    當開發者在項目中引入了 Spring Data Redis ,並且配置了 Redis 的基本信息,此時,自動化配置就會生效。

    我們從 Spring Boot 中 Redis 的自動化配置類中就可以看出端倪:

    @Configuration
    @ConditionalOnClass(RedisOperations.class)
    @EnableConfigurationProperties(RedisProperties.class)
    @Import({ LettuceConnectionConfiguration.class, JedisConnectionConfiguration.class })
    public class RedisAutoConfiguration {
        @Bean
        @ConditionalOnMissingBean(name = "redisTemplate")
        public RedisTemplate<Object, Object> redisTemplate(
                        RedisConnectionFactory redisConnectionFactory) throws UnknownHostException {
                RedisTemplate<Object, Object> template = new RedisTemplate<>();
                template.setConnectionFactory(redisConnectionFactory);
                return template;
        }
        @Bean
        @ConditionalOnMissingBean
        public StringRedisTemplate stringRedisTemplate(
                        RedisConnectionFactory redisConnectionFactory) throws UnknownHostException {
                StringRedisTemplate template = new StringRedisTemplate();
                template.setConnectionFactory(redisConnectionFactory);
                return template;
        }
    }

    這個自動化配置類很好理解:

    1. 首先標記這個是一個配置類,同時該配置在 RedisOperations 存在的情況下才會生效(即項目中引入了 Spring Data Redis)
    2. 然後導入在 application.properties 中配置的屬性
    3. 然後再導入連接池信息(如果存在的話)
    4. 最後,提供了兩個 Bean ,RedisTemplate 和 StringRedisTemplate ,其中 StringRedisTemplate 是 RedisTemplate 的子類,兩個的方法基本一致,不同之處主要體現在操作的數據類型不同,RedisTemplate 中的兩個泛型都是 Object ,意味者存儲的 key 和 value 都可以是一個對象,而 StringRedisTemplate 的 兩個泛型都是 String ,意味者 StringRedisTemplate 的 key 和 value 都只能是字符串。如果開發者沒有提供相關的 Bean ,這兩個配置就會生效,否則不會生效。

    使用

    接下來,可以直接在 Service 中注入 StringRedisTemplate 或者 RedisTemplate 來使用:

    @Service
    public class HelloService {
        @Autowired
        RedisTemplate redisTemplate;
        public void hello() {
            ValueOperations ops = redisTemplate.opsForValue();
            ops.set("k1", "v1");
            Object k1 = ops.get("k1");
            System.out.println(k1);
        }
    }

    Redis 中的數據操作,大體上來說,可以分為兩種:

    1. 針對 key 的操作,相關的方法就在 RedisTemplate 中
    2. 針對具體數據類型的操作,相關的方法需要首先獲取對應的數據類型,獲取相應數據類型的操作方法是 opsForXXX

    調用該方法就可以將數據存儲到 Redis 中去了,如下:

    k1 前面的字符是由於使用了 RedisTemplate 導致的,RedisTemplate 對 key 進行序列化之後的結果。

    RedisTemplate 中,key 默認的序列化方案是 JdkSerializationRedisSerializer 。

    而在 StringRedisTemplate 中,key 默認的序列化方案是 StringRedisSerializer ,因此,如果使用 StringRedisTemplate ,默認情況下 key 前面不會有前綴。

    不過開發者也可以自行修改 RedisTemplate 中的序列化方案,如下:

    @Service
    public class HelloService {
        @Autowired
        RedisTemplate redisTemplate;
        public void hello() {
            redisTemplate.setKeySerializer(new StringRedisSerializer());
            ValueOperations ops = redisTemplate.opsForValue();
            ops.set("k1", "v1");
            Object k1 = ops.get("k1");
            System.out.println(k1);
        }
    }

    當然也可以直接使用 StringRedisTemplate:

    @Service
    public class HelloService {
        @Autowired
        StringRedisTemplate stringRedisTemplate;
        public void hello2() {
            ValueOperations ops = stringRedisTemplate.opsForValue();
            ops.set("k2", "v2");
            Object k1 = ops.get("k2");
            System.out.println(k1);
        }
    }

    另外需要注意 ,Spring Boot 的自動化配置,只能配置單機的 Redis ,如果是 Redis 集群,則所有的東西都需要自己手動配置,關於如何操作 Redis 集群,松哥以後再來和大家分享。

    方案二:Spring Cache

    通過 Spring Cache 的形式來操作 Redis,Spring Cache 統一了緩存江湖的門面,這種方案,松哥之前有過一篇專門的文章介紹,小夥伴可以移步這裏:。

    方案三:回歸原始時代

    第三種方案,就是直接使用 Jedis 或者 其他的客戶端工具來操作 Redis ,這種方案在 Spring Boot 中也是支持的,雖然操作麻煩,但是支持,這種操作松哥之前也有介紹的文章,因此這裏就不再贅述了,可以參考 。

    總結

    Spring Boot 中,Redis 的操作,這裏松哥給大家總結了三種方案,實際上前兩個使用廣泛一些,直接使用 Jedis 還是比較少,基本上 Spring Boot 中沒見過有人直接這麼搞。

    好了,本文就說到這裏,有問題歡迎留言討論。

    相關案例已經上傳到 GitHub,歡迎小夥伴們們下載:

    掃碼關注松哥,公眾號後台回復 2TB,獲取松哥獨家 超2TB 免費 Java 學習乾貨

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益
  • javascript閉包詳解

    閉包(closure)是Javascript語言的一個難點,也是它的特色,很多高級應用都要依靠閉包實現。

    下面就是我的學習筆記,對於Javascript初學者應該是很有用的。

    一、變量的作用域

    要理解閉包,首先必須理解Javascript特殊的變量作用域。

    變量的作用域無非就是兩種:全局變量和局部變量。

    Javascript語言的特殊之處,就在於函數內部可以直接讀取全局變量。


    var n=999;
    
      function f1(){
        alert(n);
      }
    
      f1(); // 999


    另一方面,在函數外部自然無法讀取函數內的局部變量。


     function f1(){
        var n=999;
      }
    
      alert(n); // error


    這裡有一個地方需要注意,函數內部聲明變量的時候,一定要使用var命令。如果不用的話,你實際上聲明了一個全局變量!


     function f1(){
        n=999;
      }
    
      f1();
    
      alert(n); // 999


    二、如何從外部讀取局部變量?

    出於種種原因,我們有時候需要得到函數內的局部變量。但是,前面已經說過了,正常情況下,這是辦不到的,只有通過變通方法才能實現。

    那就是在函數的內部,再定義一個函數。


    function f1(){
    
        var n=999;
    
        function f2(){
          alert(n); // 999
        }
    
      }


    在上面的代碼中,函數f2就被包括在函數f1內部,這時f1內部的所有局部變量,對f2都是可見的。但是反過來就不行,f2內部的局部變量,對f1就是不可見的。這就是Javascript語言特有的”鏈式作用域”結構(chain scope),子對象會一級一級地向上尋找所有父對象的變量。所以,父對象的所有變量,對子對象都是可見的,反之則不成立。

    既然f2可以讀取f1中的局部變量,那麼只要把f2作為返回值,我們不就可以在f1外部讀取它的內部變量了嗎!


     function f1(){
    
        var n=999;
    
        function f2(){
          alert(n);
        }
    
        return f2;
    
      }
    
      var result=f1();
    
      result(); // 999


    三、閉包的概念

    上一節代碼中的f2函數,就是閉包。

    各種專業文獻上的”閉包”(closure)定義非常抽象,很難看懂。我的理解是,閉包就是能夠讀取其他函數內部變量的函數。

    由於在Javascript語言中,只有函數內部的子函數才能讀取局部變量,因此可以把閉包簡單理解成”定義在一個函數內部的函數”。

    所以,在本質上,閉包就是將函數內部和函數外部連接起來的一座橋樑。

    四、閉包的用途

    閉包可以用在許多地方。它的最大用處有兩個,一個是前面提到的可以讀取函數內部的變量,另一個就是讓這些變量的值始終保持在內存中。

    怎麼來理解這句話呢?請看下面的代碼。

      function f1(){

        var n=999;

        nAdd=function(){n+=1}

        function f2(){
          alert(n);
        }

        return f2;

      }

      var result=f1();

      result(); // 999

      nAdd();

      result(); // 1000

    在這段代碼中,result實際上就是閉包f2函數。它一共運行了兩次,第一次的值是999,第二次的值是1000。這證明了,函數f1中的局部變量n一直保存在內存中,並沒有在f1調用后被自動清除。

    為什麼會這樣呢?原因就在於f1是f2的父函數,而f2被賦給了一個全局變量,這導致f2始終在內存中,而f2的存在依賴於f1,因此f1也始終在內存中,不會在調用結束后,被垃圾回收機制(garbage collection)回收。

    這段代碼中另一個值得注意的地方,就是”nAdd=function(){n+=1}”這一行,首先在nAdd前面沒有使用var關鍵字,因此nAdd是一個全局變量,而不是局部變量。其次,nAdd的值是一個匿名函數(anonymous function),而這個匿名函數本身也是一個閉包,所以nAdd相當於是一個setter,可以在函數外部對函數內部的局部變量進行操作。

    五、使用閉包的注意點

    1)由於閉包會使得函數中的變量都被保存在內存中,內存消耗很大,所以不能濫用閉包,否則會造成網頁的性能問題,在IE中可能導致內存泄露。解決方法是,在退出函數之前,將不使用的局部變量全部刪除。

    2)閉包會在父函數外部,改變父函數內部變量的值。所以,如果你把父函數當作對象(object)使用,把閉包當作它的公用方法(Public Method),把內部變量當作它的私有屬性(private value),這時一定要小心,不要隨便改變父函數內部變量的值。

    六、思考題

    如果你能理解下面兩段代碼的運行結果,應該就算理解閉包的運行機制了。

    代碼片段一。

      var name = “The Window”;

      var object = {
        name : “My Object”,

        getNameFunc : function(){
          return function(){
            return this.name;
          };

        }

      };

      alert(object.getNameFunc()());

    代碼片段二。

      var name = “The Window”;

      var object = {
        name : “My Object”,

        getNameFunc : function(){
          var that = this;
          return function(){
            return that.name;
          };

        }

      };

      alert(object.getNameFunc()());


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • PowerMock學習(四)之Mock static的使用

    PowerMock學習(四)之Mock static的使用

    我們編寫代碼的時候,總會寫一些工具類,為了方便調用喜歡使用static關鍵字來修飾對應方法。

    那麼現在舉例說明,還是準備兩個接口,第一個是查詢學生總數,第二個是新增學生兩個接口,具體示例代碼如下:

    package com.rongrong.powermock.mockstatic;
    
    import com.rongrong.powermock.service.Student;
    
    /**
     * @author rongrong
     * @version 1.0
     * @date 2019/11/23 8:08
     */
    public class StudentStaticService {
    
        /**
         * 獲取學生總數
         * @return
         */
        public int getStudentTotal(){
            return StudentUtils.getStudent();
        }
    
        /**
         * 創建一個學生
         * @param student
         */
        public void createStudent(Student student){
            StudentUtils.createStudent(student);
        }
    }

    接着我們再來看看這個靜態工具類StudentUtils,具體代碼示例如下:

    package com.rongrong.powermock.mockstatic;
    
    import com.rongrong.powermock.service.Student;
    
    /**
     * @author rongrong
     * @version 1.0
     * @date 2019/11/23 7:38
     */
    public class StudentUtils {
        /**
         * 獲取學生總數
         * @return
         */
        public static int getStudent(){
            throw new UnsupportedOperationException();
        }
    
        /**
         * 創建一個學生
         * @param student
         */
        public static void createStudent(Student student){
            throw new UnsupportedOperationException();
        }
    }

    接下來我們用傳統方式,來做單元測試,示例代碼如下:

        @Test
        public void testGetStudnetTotal(){
            StudentStaticService staticService = new StudentStaticService();
            int studentTotal = staticService.getStudentTotal();
            assertEquals(studentTotal,10);
        }
    
        @Test
        public void testCreateStudent(){
            StudentStaticService staticService = new StudentStaticService();
            staticService.createStudent(new Student());
            assertTrue(true);
        }

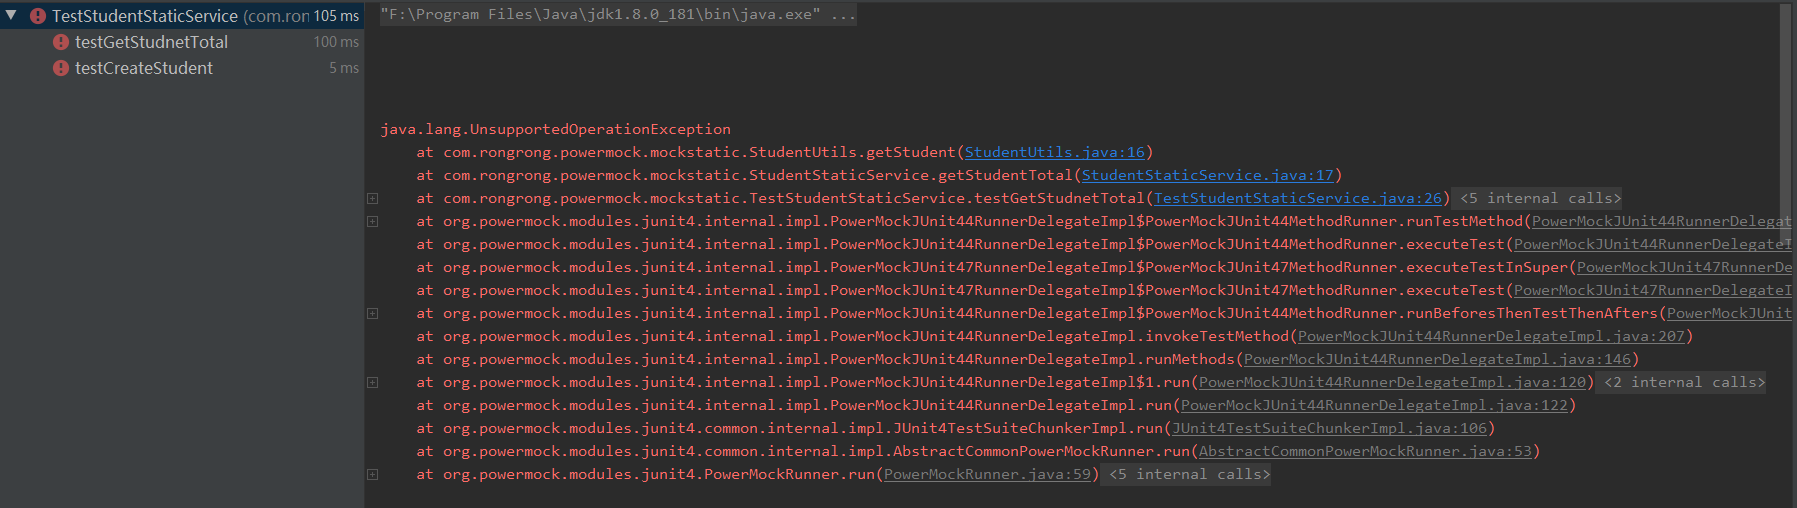
    接着運行下測試用例,結果肯定報錯了,為什麼報錯,這裏就不再細說了,參考之前文章,報錯,如下圖所示:


    接下來我們使用powermock來進行測試,具體示例代碼如下:

     @Test
        public void testGetStudentWithMock(){
            //先mock工具類對象
            PowerMockito.mockStatic(StudentUtils.class);
            //模擬靜態類調用
            PowerMockito.when(StudentUtils.getStudent()).thenReturn(10);
            //構建service
            StudentStaticService service = new StudentStaticService();
            int studentTotal = service.getStudentTotal();
            assertEquals(10,studentTotal);
        }
    
        @Test
        public void testCreateStudentWithMock(){
            //先模擬靜態工具類
            PowerMockito.mockStatic(StudentUtils.class);
            //模擬調用
            PowerMockito.doNothing().when(StudentUtils.class);
            //構建service
            StudentStaticService service = new StudentStaticService();
            Student student = new Student();
            service.createStudent(student);
            //這裏用powermock來驗證,而不是mock,更體現了powermock的強大
            PowerMockito.verifyStatic();
        }

    再次運行,測試通過,如下圖所示:


    運行之前先讓powermock為我們準備了StudentUtils工具類,而且採用mockstatic的方法,最後我們用powermock.verifyStatic()驗證,而不是mock,更體現了powermock的強大。


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

  • 阿里雲ECS服務器部署HADOOP集群(一):Hadoop完全分佈式集群環境搭建,阿里雲ECS服務器部署HADOOP集群(二):HBase完全分佈式集群搭建(使用外置ZooKeeper),阿里雲ECS服務器部署HADOOP集群(三):ZooKeeper 完全分佈式集群搭建,阿里雲ECS服務器部署HADOOP集群(四):Hive本地模式的安裝,阿里雲ECS服務器部署HADOOP集群(六):Flume 安裝,阿里雲ECS服務器部署HADOOP集群(七):Sqoop 安裝

    阿里雲ECS服務器部署HADOOP集群(一):Hadoop完全分佈式集群環境搭建,阿里雲ECS服務器部署HADOOP集群(二):HBase完全分佈式集群搭建(使用外置ZooKeeper),阿里雲ECS服務器部署HADOOP集群(三):ZooKeeper 完全分佈式集群搭建,阿里雲ECS服務器部署HADOOP集群(四):Hive本地模式的安裝,阿里雲ECS服務器部署HADOOP集群(六):Flume 安裝,阿里雲ECS服務器部署HADOOP集群(七):Sqoop 安裝

    準備:

    兩台配置CentOS 7.3的阿里雲ECS服務器;

    hadoop-2.7.3.tar.gz安裝包;

    jdk-8u77-linux-x64.tar.gz安裝包;

    hostname及IP的配置:

    更改主機名:

    由於系統為CentOS 7,可以直接使用‘hostnamectl set-hostname 主機名’來修改,修改完畢后重新shell登錄或者重啟服務器即可。

    1 hostnamectl set-hostname master
    2 exit
    3 ssh root@master
    1 hostnamectl set-hostname slave1
    2 exit 3 ssh root@slave1

    設置本地域名:

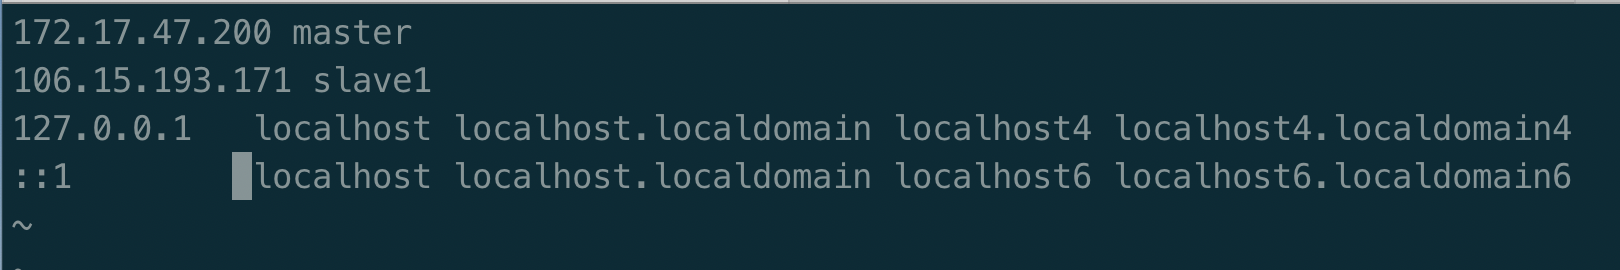
    設置本地域名這一步非常關鍵,ip的本地域名信息配置不好,即有可能造成Hadoop啟動出現問題,又有可能造成在使用Hadoop的MapReduce進行計算時報錯。在ECS上搭建Hadoop集群環境需參考以下兩篇文章:

    總結一下那就是,在“/etc/hosts”文件中進行域名配置時要遵從2個原則:

    •  新加域名在前面: 將新添加的Master、Slave服務器ip域名(例如“test7972”),放置在ECS服務器原有本地域名(例如“iZuf67wb***************”)的前面。但是注意ECS服務器原有本地      域名(例如“iZuf67wb***************”)不能被刪除,因為操作系統別的地方還會使用到。
    •  IP本機內網,其它外網: 在本機上的操作,都要設置成內網ip;其它機器上的操作,要設置成外網ip。

    master

    slave1

    此處摘自 

    配置好后需要在各個節點上執行如下命令,測試是否相互 ping 得通,如果 ping 不通,後面就無法順利配置成功:

    1 ping master -c 3
    2 ping slave1 -c 3

    例如我在 master 節點上 ping slave1 ,ping 通的話會显示 time,显示的結果如下圖所示:

    各節點角色分配

    master: NameNode  ResourceManager

    slave1: DataNode NodeManager

    免密碼登錄配置

    分別在 master 和 slave1 上做如下操作

    1 ssh-keygen -t rsa
    2 ssh-copy-id master 3 ssh-copy-id slave1

    驗證

    ssh master date;ssh slave1 date

    配置JDK

    解壓JDK安裝包到/usr/local/下

    tar -zxvf jdk-8u77-linux-x64.tar.gz -C /usr/local/

    將解壓目錄改為 jdk1.8

    mv jdk1.8.0_77/ jdk1.8/

    設置JAVA_HOME到系統環境變量

    vim /etc/profile

    在最後加入以下兩行代碼

    export JAVA_HOME=/usr/local/jdk1.8
    export PATH=$PATH:$JAVA_HOME/bin

    重新加載環境

    source /etc/profile

    這樣 master 的jdk就配置好了,可以用命令 java -version 測試下。

    java -version

    下面只需將 master 上配置好的文件分發到 slave1 上即可。

    將/usr/local/jdk1.8分發到 slave1 的/usr/local/下(建議壓縮后再分發)

    scp -r /usr/local/jdk1.8/ slave1:/usr/local/

    將/etc/profile分發到 slave1 的/etc/下

    scp /etc/profile slave1:/etc/

      然後重新加載 slave1 環境便完成了 slave1 的jdk配置

    source /etc/profile

    hadoop集群配置

    1 cd ~
    2 tar -zxvf hadoop-2.7.3.tar.gz -C /usr/local # 解壓到/usr/local中
    3 cd /usr/local/
    4 mv ./hadoop-2.7.3/ ./hadoop            # 將文件夾名改為hadoop

    輸入如下命令來檢查 Hadoop 是否可用,成功則會显示 Hadoop 版本信息:

    1 cd /usr/local/hadoop
    2 ./bin/hadoop version

    添加 HADOOP_HOME 到系統環境變量

    vim /etc/profile

    在後面添加如下兩行

    1 export HADOOP_HOME=/usr/local/hadoop
    2 export PATH=$PATH:$HADOOP_HOME/bin:$HADOOP_HOME/sbin

    重新加載環境,並輸出變量 HADOOP_HOME 驗證

    進入/user/local/hadoop/etc/hadoop/可以看到如下配置文件

    集群/分佈式模式需要修改 /usr/local/hadoop/etc/hadoop 中的6個配置文件,更多設置項可點擊查看官方說明,這裏僅設置了我完成課堂作業所必須的設置項:hadoop-env.sh, slaves,  ,  ,  ,   。

    1.首先來配置 hadoop-env.sh ,只需要設置一下JAVA_HOME即可

    注:之前在配置jdk中配置的是基於系統的JAVA_HOME變量,這裏需要配置基於Hadoop集群的JAVA_HOME變量。

    hadoop-env.sh 是Hadoop的環境變量配置腳本。

    所以應做以下修改 vim hadoop-env.sh

    export JAVA_HOME=/usr/local/jdk1.8

    2.配置 slave , 指定 slave 節點

    sudo vi slaves

    刪去原有的 localhost , 添加將作為 slave 節點的 slave1

    3.配置 core-site.xml 

     1 <configuration>
     2 
     3     <property>
     4         <name>fs.defaultFS</name>
     5         <value>hdfs://master:9000</value>
     6         <description>The name of the default file system.</description>
     7     </property> 
     8 # 設置訪問hdfs的默認名,9000是默認端口
     9 
    10     <property>
    11         <name>hadoop.tmp.dir</name>
    12         <value>/usr/local/hadoop/tmp</value>
    13         <description>Abase for other temporary directories.</description>
    14     </property>
    15 # 在hdfs格式化的時候會自動創建相應的目錄 'tmp/' 16 17 <property> 18 <name>fs.trash.interval</name> 19 <value>4320</value> 20 <description>Number of minutes after which the checkpoint gets deleted.</description> 21 </property> 22 # 設置回收站里的文件保留時間(單位:秒) 23 24 </configuration>

    4.配置 hdfs-site.xml 

     1 <configuration>
     2 
     3     <property>
     4         <name>dfs.namenode.name.dir</name>
     5         <value>/usr/local/hadoop/tmp/dfs/name</value>
     6     </property>
     7 
     8     <property>
     9         <name>dfs.datanode.data.dir</name>
    10         <value>/usr/local/hadoop/tmp/dfs/data</value>
    11     </property>
    12 
    13     <property>
    14         <name>dfs.replication</name>
    15         <value>1</value>
    16     </property>
    17 # 副本,因為有一個 slave 節點這裏設置為1(一般偽分佈模式設1個,三個或三個以上節點設3個)
    18 
    19     <property>
    20         <name>dfs.permissions.enabled</name>
    21         <value>false</value>
    22         <description>If "true", enable permission checking in HDFS. If "false", permission checking is turned off, but all other behavior is unchanged. Switching from one parameter value to the other does not change the mode, owner or group of files or directories.</description>
    23     </property>
    24 
    25 </configuration>    

    5.配置 mapred-site.xml (這個文件沒有直接提供,而是提供了模版文件,需將模版文件轉換為配置文件) 

    1 sudo mv mapred-site.xml.template mapred-site.xml
    2 sudo vi mapred-site.xml
     1 <configuration>
     2 
     3     <property>
     4         <name>mapreduce.framework.name</name>
     5         <value>yarn</value>
     6         <description>The runtime framework for executing MapReduce jobs.Can be one of local, classic or yarn.</description>
     7     </property>
     8     <property>
     9         <name>mapreduce.jobtracker.http.address</name>
    10         <value>master:50030</value>
    11     </property>
    12     <property>
    13         <name>mapreduce.jobhisotry.address</name>
    14         <value>master:10020</value>
    15     </property>
    16     <property>
    17         <name>mapreduce.jobhistory.webapp.address</name>
    18         <value>master:19888</value>
    19     </property>
    20     <property>
    21         <name>mapreduce.jobhistory.done-dir</name>
    22         <value>/jobhistory/done</value>
    23     </property>
    24     <property>
    25         <name>mapreduce.jobhistory.intermediate-done-dir</name>
    26         <value>/jobhisotry/done_intermediate</value>
    27     </property>
    28     <property>
    29         <name>mapreduce.job.ubertask.enable</name>
    30         <value>true</value>
    31         <description>Whether to enable the small-jobs "ubertask" optimization,which runs "sufficiently small" jobs sequentially within a single JVM."Small" is defined by the following maxmaps, maxreduces, and maxbytes settings. Note that configurations for application masters also affect the "Small" definition - yarn.app.mapreduce.am.resource.mb must be larger than both mapreduce.map.memory.mb and mapreduce.reduce.memory.mb, and yarn.app.mapreduce.am.resource.cpu-vcores must be larger than both mapreduce.map.cpu.vcores and mapreduce.reduce.cpu.vcores to enable ubertask. Users may override this value.</description>
    32     </property>
    33 
    34 </configuration>

    6.配置 yarn-site.xml

     1 <configuration>
     2 
     3     <property>
     4         <name>yarn.resourcemanager.hostname</name>
     5         <value>master</value>
     6     </property>
     7     <property>
     8         <name>yarn.nodemanager.aux-services</name>
     9         <value>mapreduce_shuffle</value>
    10         <description>A comma separated list of services where service name should only contain a-zA-Z0-9_ and can not start with numbers</description>
    11     </property>
    12     <property>
    13         <name>yarn.resourcemanager.address</name>
    14         <value>master:18040</value>
    15     </property>
    16     <property>
    17         <name>yarn.resourcemanager.scheduler.address</name>
    18         <value>master:18030</value>
    19     </property>
    20     <property>
    21         <name>yarn.resourcemanager.resource-tracker.address</name>
    22         <value>master:18025</value>
    23     </property>
    24     <property>
    25         <name>yarn.resourcemanager.admin.address</name>
    26         <value>master:18141</value>
    27     </property>
    28     <property>
    29         <name>yarn.resourcemanager.webapp.address</name>
    30         <value>master:18088</value>
    31     </property>
    32     <property>
    33         <name>yarn.log-aggregation-enable</name>
    34         <value>true</value>
    35     </property>
    36     <property>
    37         <name>yarn.log-aggregation.retain-seconds</name>
    38         <value>86400</value>
    39     </property>
    40     <property>
    41         <name>yarn.log-aggregation.retain-check-interval-seconds</name>
    42         <value>86400</value>
    43     </property>
    44     <property>
    45         <name>yarn.nodemanager.remote-app-log-dir</name>
    46         <value>/tmp/logs</value>
    47     </property>
    48     <property>
    49         <name>yarn.nodemanager.remote-app-log-dir-suffix</name>
    50         <value>logs</value>
    51     </property>
    52 
    53 </configuration>

     到這裏 master 就已經配置好了,下面將該服務器的配置分發到 slave1 上去(建議壓縮后再分發),在此使用壓縮後分發的方法

    在 master 節點上執行

    1 cd /usr/local
    2 tar -zcvf ~/hadoop.master.tar.gz ./hadoop 3 cd ~ 4 scp ./hadoop.master.tar.gz slave1:/root/ 5 scp /etc/profile slave1:/etc/

    在 slave1 節點上執行

    tar -zxvf ~/hadoop.master.tar.gz -C /usr/local

    在 slave1 上重新加載環境並檢查驗證

    source /etc/profile
    echo $HADOOP_HOME

    HDFS NameNode 格式化(只要在 master 上執行即可)

    $HADOOP_HOME/bin/hdfs namenode -format

    看到下面的輸出,表明hdfs格式化成功

    INFO common.Storage: Storage directory /usr/local/hadoop/tmp/dfs/name has been successfully formatted.

    啟動前檢查防火牆狀態

    systemctl status firewalld

    我這裡是已經關閉的,若未關閉,可以參考下圖(來自)

    阿里雲服務器還需要在服務器安全組裡配置防火牆,需將配置文件里的相關端口全部添加,否則會出現 web 頁面打不開,以及 DataNode 啟動但 Live datenode 為 0 等問題

    啟動 Hadoop 集群

    $HADOOP_HOME/sbin/start-all.sh


    • 第一次啟動 hadoop 時會出現 ssh 提示,提示是否要連入 0.0.0.0 節點,輸入 yes 即可
    • 若出現 hadoop 啟動時 datanode 沒有啟動,可以參考來解決

    啟動 job history server

    在 master 上執行

    $HADOOP_HOME/sbin/mr-jobhistory-daemon.sh start historyserver

    成功后在兩個節點上驗證

    在 master 上 執行 

    jps

    可以看到 ResourceManager、SecondaryNameNode、NameNode、JobHistoryServer 四個進程全部啟動

    在 slave1 上執行

    jps

    可以看到 NodeManager、DataNode 兩個進程全部啟動

    缺少任一進程都表示出錯。另外還需要在 Master 節點上通過命令 hdfs dfsadmin -report 查看 DataNode 是否正常啟動,如果 Live datanodes 不為 0 ,則說明集群啟動成功。例如我這邊一共有 1 個 Datanodes:

    全部配置完成之後查看 web 頁面

    hdfs: http://master:50070/

    hdfs Datanode 節點信息

    hdfs 的情況

    hdfs 的文件情況

     yarn:http://master:18088/


    阿里雲ECS服務器部署HADOOP集群系列:


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

  • 一看就懂的快速排序

    一看就懂的快速排序

    概念

    快速排序屬於交換排序,主要步驟是使用基準元素進行比較,把小於基準元素的移動到一邊,大於基準元素的移動到另一邊。從而把數組分成兩部分,然後再從這兩部分中選取出基準元素,重複上面的步驟。過程如下:

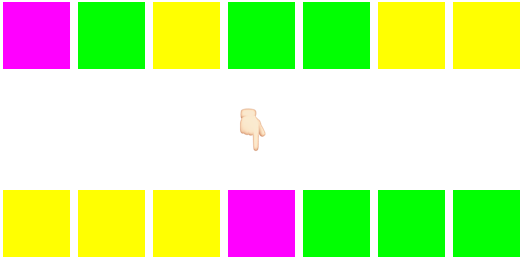
    紫色:基準元素
    綠色:大於基準元素
    黃色:小於基準元素

    這種思路叫做分治法。

    基準元素

    基準元素的選取可隨機選取。下面使用中我會使用第一位的元素作為基準元素。

    排序過程

    排序拆分過程如下圖:

    紫色為基準元素,(每一輪都重新選取)
    綠色為其他元素

    第一輪

    第二輪

    第三輪

    如上圖所示:
    若元素個數為n,因為排序過程中需要和全部元素都比較一遍,所以時間複雜度為O(n),
    而平均情況下排序輪次需要logn輪,因此快速排序的平均時間複雜度為O(nlogn)。

    排序的實現方法

    實現方法有雙邊循環法和單邊循環法

    雙邊循環法

    首選選取基準元素(pivot)4,並設置指針left和right,指向數組最左和最右兩個元素,如下:

    第一次循環,先從right指針指向的數據(rightData)開始和基準元素比較
    若 rightData >= pivot,則right指針向左移動,若 rightData < pivot,則right指針不移動,切換到left指針
    left指針指向數據(leftData)與基準元素比較,若 leftData < pivot,則left指針向右移動,若 leftData > pivot,交換left和right指向的元素。

    第一輪指針移動完后,得到如下結構:

    然後 left和right指向的元素進行交換:

    第一輪循環結束,重新切換到right指針,重複上述步驟。
    第二輪循環后,得:

    第三輪循環后,得:

    第四輪循環后,得:

    判斷到left和right指針指向同一個元素,指針停止移動,使pivot和指針元素進行交換,得:

    宣告該輪循環結束,並根據Pivot元素切分為兩部分,這兩部分的數組再根據上述步驟進行操作。

    實現代碼

    public class DoubleSort {
        public static void quickSort(int[] arr, int startIndex, int endIndex) {
    
            //遞歸結束條件
            if (startIndex >= endIndex) {
                return;
            }
    
            // 基準元素位置
            int pivotIndex = partition(arr, startIndex, endIndex);
    
            // 根據基準元素,分成兩部分進行遞歸排序
            quickSort(arr, startIndex, pivotIndex - 1);
            quickSort(arr, pivotIndex + 1, endIndex);
        }
    
        public static int partition(int[] arr, int startIndex, int endIndex) {
            // 取第一個元素為基準元素,也可以隨機抽取
            int pivot = arr[startIndex];
            int left = startIndex;
            int right = endIndex;
    
            while (left != right) {
                // 控制right指針比較並左移
                while (left < right && arr[right] >= pivot) {
                    right--;
                }
    
                // 控制left指針比較並右移
                while (left < right && arr[left] <= pivot) {
                    left++;
                }
    
                // 交換left和right指針所指向的元素
                if (left < right) {
                    int temp = arr[right];
                    arr[right] = arr[left];
                    arr[left] = temp;
                }
            }
    
            arr[startIndex] = arr[left];
            arr[left] = pivot;
            return left;
        }
    
        public static void main(String[] args) {
            int[] arr = new int[]{4, 7, 6, 5, 3, 2, 8, 1};
            quickSort(arr, 0, arr.length - 1);
            System.out.println(Arrays.toString(arr));
        }
    }

    單邊循環法

    雙邊循環法從數組的兩邊比較並交換元素,而單邊循環法則從數組的一邊遍歷,一直往後比較和交換,實現起來更加的簡單。
    過程如下:

    首先也是選取基準元素pivot(可以隨機選擇)
    設置一個mark指針指向數組的起始位置,代表小於基準元素的區域邊界(不理解的就把它理解成是等會用來交換元素的就好了)

    原始數組如下:

    從基準元素下一位開始遍曆數組
    如果該元素大於基準元素,繼續往下遍歷
    如果該元素小於基準元素,mark指針往右移,因為小於基準元素的區域邊界增大了1(即小於基準元素的多了1位),所以mark就 +1,並且該元素和mark指向元素進行交換。

    遍歷到元素3時,因為3 < 4,所以mark右移

    然後交換元素

    然後就繼續遍歷,根據上面的步驟進行判斷,後面的過程就不寫了。

    實現代碼

    public class SingleSort {
        public static void quickSort(int[] arr, int startIndex, int endIndex) {
    
            //遞歸結束條件
            if (startIndex >= endIndex) {
                return;
            }
    
            // 基準元素位置
            int pivotIndex = partition(arr, startIndex, endIndex);
    
            // 根據基準元素,分成兩部分進行遞歸排序
            quickSort(arr, startIndex, pivotIndex - 1);
            quickSort(arr, pivotIndex + 1, endIndex);
        }
    
        /**
         * 分治(單邊循環法)
         * @param arr
         * @param startIndex
         * @param endIndex
         * @return
         */
        public static int partition(int[] arr, int startIndex, int endIndex) {
            // 取第一個元素為基準元素,也可以隨機抽取
            int pivot = arr[startIndex];
            int mark = startIndex;
    
            for(int i = startIndex + 1; i< arr.length; i++) {
                if (pivot < arr[i]) {
                    continue;
                }
    
                mark ++;
                int temp = arr[mark];
                arr[mark] = arr[i];
                arr[i] = temp;
            }
            arr[startIndex] = arr[mark];
            arr[mark] = pivot;
            return mark;
        }
    
        public static void main(String[] args) {
            int[] arr = new int[]{4, 7, 6, 5, 3, 2, 8, 1};
            quickSort(arr, 0, arr.length - 1);
            System.out.println(Arrays.toString(arr));
        }
    }

    總結

    本人也是初次接觸算法,慢慢的去理解算法的思路和實現過程后,真是為自己以往寫的算法感到羞愧。該文章也是為了加深自己對快排算法的印象,若文章有不足之處,懇請各位在下方留言補充。感謝各位的閱讀。Thanks(・ω・)ノ。

    參考資料: 第四章。

    個人博客網址: https://colablog.cn/

    如果我的文章幫助到您,可以關注我的微信公眾號,第一時間分享文章給您

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

  • PL真有意思(一):引言

    前言

    斷斷續續學編譯原理到之前發過寫一個編譯器和正則表達式引擎系列文章也有一段時間了,然後最近看完PLP這本書,這本書應該算是入門書,但是對我這種半吊子收穫很大。所以為了彌補最近學操作系統和接外包摸的魚,就想寫寫看完這本書的收穫。(為拙劣的標題道歉

    程序設計語言的譜系

    現在的新語言都是一撮一撮的出來,但是基本都可以用他們的計算模型來分成兩類,一類是更關心計算機做什麼的說明式,一類是更關心計算機怎麼做的命令式

    一般認為像函數式邏輯式語言都算是說明式,而馮諾依曼式和面向對象的都被認為是命令式

    函數式

    函數式是基於函數的遞歸定義的計算模型,一般從本質上來看,函數式把程序認為是一種從輸入到輸出的函數,使用更簡單的函數通過逐步細化的過程來定義

    邏輯式

    邏輯式里經典的應該就是Prolog了,邏輯式一般將計算看作是一種找出滿足某些特定關係的值的嘗試過程

    馮諾依曼式

    馮諾依曼式最重要的就是通過副作用也就是修改寄存器里的值來對後續計算產生影響,像C和Fortran都屬於馮諾依曼式

    幾個例子

    如果C語言來實現求最大公約數,可以發現C語言偏向通過迭代和反覆修改變量的值來實現

    int gcd(int a, intb) {
        while (a != b) {
          if (a > b) {
            a = a - b;
          } else {
            b = b - a;
          }
        }
    }

    從lisp來看,則更加關注輸入和輸出的數學關係,要算出最大公約數,需要對函數的不斷的擴充和精簡

    (define gcd
      (lambda (a b)
        (cond ((= a b) a)
              ((> a b) (gcd (- a b) b))
              (else (gcd (- b a) a)))))

    對於像C或者Java入門的人,看到Prolog可能頭都大了,因為Prolog和命令式的思考邏輯完全不同,邏輯式更傾向給出一組公理和檢測規則,期望系統能給出相應合理的值,我也僅限於能看懂這些小程序

    gcd(A,B,G) :- A = B, G = A.
    gcd(A,B,G) :- A > B, C is A - B, gcd(C,B,G)
    gcd(A,B,G) :- B > A, C is B-A
    gcd(C,A,G)

    編譯和解釋

    下面再看兩個概念,編譯和解釋。

    編譯一般是指從一個語言到另一個語言的翻譯,無論是高級語言到彙編還是高級語言到高級語言都算是編譯。而解釋就是直接執行代碼,但是現代的解釋器,一般還有虛擬機一層,即翻譯到虛擬機指令再由虛擬機進行執行

    自舉

    很多語言的編譯器都是由自己編譯而成的,所以問題就是,最開始的編譯器是怎麼編譯的?

    假設現在要為Java編寫一個編譯器,我們可以先用C語言編寫一個Java小子集的編譯器,然後再手動將C語言翻譯到這個Java子集,就可以由這個子集編譯運行自己,然後就可以不斷擴充這個編譯器

    編譯概覽

    其實這個在之前那個寫編譯器的系列是說得最詳細的,這個系列是想要寫寫筆記對實踐和語言設計結合的說。

    • 詞法分析

    有關詞法分析其實就是將字符流化成單詞流,記錄每個單詞的信息,然後通常還會有其它更多的信息讓編譯器更好的生成錯誤信息

    • 語法分析

    語法分析通常會用到一個概念:上下文無關文法,就是用來定義語法形式的,比如while語句就可以這樣表示

    while-statment := WHILE ( expr ) statment

    一般語法分析過程最後的輸出都是樹狀結構

    • 語義分析和中間代碼生成

    語法分析只保證源代碼語法格式的正確,但是卻不能保證其它的正確性,比如對於靜態類型的語言,可能就會在編譯時直接檢測出類型錯誤

    而在語義分析過程一般還需要藉助一個叫做符號表的數據結構,這個符號表將每個標識符都映射到關於它的已知信息

    中間代碼的生成通常是會將樹形結構翻譯成更接近彙編的中間線性格式,但是中間格式不是必須的,比如之前那個系列里還寫了C的解釋器,雖然很殘缺,它是沒有中間代碼的,連虛擬機都沒有,是直接進行遍歷語法樹進行執行解釋的

    • 代碼優化

    有些代碼改進是機器無關的,即可以在中間格式上就進行優化,但是有的代碼優化是平台相關的,所以就需要在最後對目標語言優化

    • 目標代碼生成

    代碼生成階段就是根據之前生成的線性結構和符號表信息對目標代碼的生成

    小結

    這一篇主要說了幾個範式的語言和編譯過程的概括,對摸魚進行懺悔

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

  • Vue項目使用CSS變量實現主題化

    主題化管理經常能在網站上看到,一般的思路都是將主題相關的CSS樣式獨立出來,在用戶選擇主題的時候加載相應的CSS樣式文件。現在大部分瀏覽器都能很好的兼容,主題化樣式更容易管理了。最近,使用CSS變量在Vue項目中做了一個主題化實踐,下面來看看整個過程。

    可行性測試

    為了檢驗方法的可行性,在public文件夾下新建一個themes文件夾,並在themes文件夾新建一個default.css文件:

    :root {
      --color: red;
    }

    在public文件夾的index.html文件中引入外部樣式theme.css,如下:

    <!DOCTYPE html>
    <html lang="en">
      <head>
        <meta charset="utf-8">
        <meta http-equiv="X-UA-Compatible" content="IE=edge">
        <meta name="viewport" content="width=device-width,initial-scale=1.0">
        <link rel="icon" href="<%= BASE_URL %>favicon.ico">
        <title>vue-skin-peeler-demo</title>
        <!-- 引入themes文件夾下的default.css -->
        <link rel="stylesheet" type="text/css" href="src/themes/default.css" rel="external nofollow">
      </head>
      <body>
        <noscript>
          <strong>We're sorry but vue-skin-peeler-demo doesn't work properly without JavaScript enabled. Please enable it to continue.</strong>
        </noscript>
        <div id="app"></div>
        <!-- built files will be auto injected -->
      </body>
    </html>

    然後,在Home.vue中使用CSS變量:

    <template>
      <div class="home">
        <div :class="$style.demo">變紅色</div>
      </div>
    </template>
    
    <script>
    export default {
      name: 'home'
    }
    </script>
    
    <style module lang="scss">
      .demo {
        color: var(--color);
      }
    </style>

    然後,運行項目並在瀏覽器中打開頁面,頁面显示效果正常。

    注意:@vue/cli使用link標籤引入css樣式可能報錯“We’re sorry but vue-skin-peeler-demo doesn’t work properly without JavaScript enabled. Please enable it to continue.”。這是因為@vue/cli將src目錄下的文件都通過webpack打包所引起,所以,靜態文件資源要放在public(如果是@vue/cli 2.x版本放在static)文件夾下。

    實現主題切換

    這裏主題切換的思路是替換link標籤的href屬性,因此,需要寫一個替換函數,在src目錄下新建themes.js文件,代碼如下:

    // themes.js
    const createLink = (() => {
      let $link = null
      return () => {
        if ($link) {
          return $link
        }
        $link = document.createElement('link')
        $link.rel = 'stylesheet'
        $link.type = 'text/css'
        document.querySelector('head').appendChild($link)
        return $link
      }
    })()
    
    /**
     * 主題切換函數
     * @param {string} theme - 主題名稱, 默認default
     * @return {string} 主題名稱
     */
    const toggleTheme = (theme = 'default') => {
      const $link = createLink()
      $link.href = `./themes/${theme}.css`
      return theme
    }
    
    export default toggleTheme

    然後,在themes文件下創建default.css和dark.css兩個主題文件。創建CSS變量,實現主題化。CSS變量實現主題切換請參考另一篇文章

    兼容性

    IE瀏覽器以及一些舊版瀏覽器不支持CSS變量,因此,需要使用,是一個,可在舊版和現代瀏覽器中為CSS自定義屬性(也稱為“ CSS變量”)提供客戶端支持。由於要開啟watch監聽,所以還有安裝。

    安裝:

    npm install css-vars-ponyfill mutationobserver-shim --save

    然後,在themes.js文件中引入並使用:

    // themes.js
    import 'mutationobserver-shim'
    import cssVars from 'css-vars-ponyfill'
    
    cssVars({
      watch: true
    })
    
    const createLink = (() => {
      let $link = null
      return () => {
        if ($link) {
          return $link
        }
        $link = document.createElement('link')
        $link.rel = 'stylesheet'
        $link.type = 'text/css'
        document.querySelector('head').appendChild($link)
        return $link
      }
    })()
    
    /**
     * 主題切換函數
     * @param {string} theme - 主題名稱, 默認default
     * @return {string} 主題名稱
     */
    const toggleTheme = (theme = 'default') => {
      const $link = createLink()
      $link.href = `./themes/${theme}.css`
      return theme
    }
    
    export default toggleTheme

    開啟watch后,在IE 11瀏覽器點擊切換主題開關不起作用。因此,每次切換主題時都重新執行cssVars(),還是無法切換主題,原因是開啟watch后重新執行cssVars()是無效的。最後,只能先關閉watch再重新開啟。成功切換主題的themes.js代碼如下:

    // themes.js
    import 'mutationobserver-shim'
    import cssVars from 'css-vars-ponyfill'
    
    const createLink = (() => {
      let $link = null
      return () => {
        if ($link) {
          return $link
        }
        $link = document.createElement('link')
        $link.rel = 'stylesheet'
        $link.type = 'text/css'
        document.querySelector('head').appendChild($link)
        return $link
      }
    })()
    
    /**
     * 主題切換函數
     * @param {string} theme - 主題名稱, 默認default
     * @return {string} 主題名稱
     */
    const toggleTheme = (theme = 'default') => {
      const $link = createLink()
      $link.href = `./themes/${theme}.css`
      cssVars({
        watch: false
      })
      setTimeout(function () {
        cssVars({
          watch: true
        })
      }, 0)
      return theme
    }
    
    export default toggleTheme

    查看所有代碼,請移步。

    記住主題

    實現記住主題這個功能,一是可以向服務器保存主題,一是使用本地存儲主題。為了方便,這裏主要使用本地存儲主題的方式,即使用localStorage存儲主題。具體實現請移步。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • 電動車環島不是夢,特斯拉7月將於台灣完成250座充電站

    電動車環島不是夢,特斯拉7月將於台灣完成250座充電站

    一台特斯拉隨隨便便就要兩、三百萬元台幣的價碼,讓不少喜愛電動車有效率、環保特性的人無法輕易擁有。特斯拉宣布他們跟台灣本地銀行提供的優惠方案,最低每月負擔36,000 元台幣,就可以將特斯拉車子開回家。另外特斯拉的超級充電站也將遍布全台,開著特斯拉環島將不是夢想。

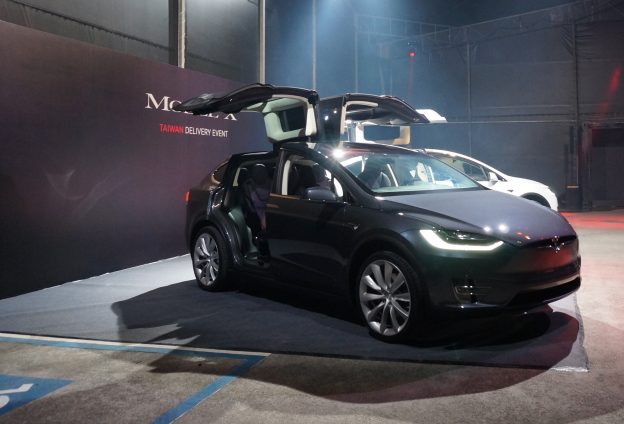
    在上週五(6/16)特斯拉Model X 交車派對上,特斯拉香港、澳門及台灣地區區域總監范菁怡表示,在台灣由星展銀行提供的優惠方案,每月最少花36,000 元,就可以開著特斯拉回家。或車主開了3 年之後,除了繼續繳每月的費用,也可以選擇回購專案,將車子賣回給特斯拉。特斯拉也有與車行合作模式,可採租賃模式駕駛特斯拉車。以上幾項不同的方案,供車主依自己的需求選擇最適合的方案。

    特斯拉表示,到了7 月,開特斯拉車環島也不會是問題。台灣中部、南部的台南、高雄都將在高速公路交流道一帶設置超級充電站,而東部也會有超級充電站。未來開著特斯拉享受環島行程不再是夢想。Tesla 於今年第二季末正式在台完成超過250 座目的地充電站,分布於全台80 個地點。

    ▲ 在派對上交車的車輛,5~7 人座都有。

    另外不少車主期待的自動輔助駕駛2.0 版與導航功能也將在台啟用,為全世界第一批啟用國家之一。不論是自動輔助轉向、跟車、防撞預警、自動換導、自動停車或是召換功能,都能在台灣使用。未來Model S 或Model X 開在台灣的道路上,透過OTA 機制更新,能夠累積台灣路況,提供最好的駕駛體驗。

    ▲ 特斯拉與車行合作,提供駕駛特斯拉車的不同方式。

    儘管在交車派對上車主是主角,但特斯拉宣布了不少優惠專案。對車主來說,可在一個月內免費申請安裝家用充電設備,另外還有機會到SpaceX 參觀!


    ▲ 特斯拉在台灣與星展銀行合作,推出特斯拉優惠方案。

    (合作媒體:。圖片出處:科技新報)

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益
  • Tesla超級充電站計畫開放給他牌電動車充電

    Tesla超級充電站計畫開放給他牌電動車充電


    由於各大廠牌的電動車充電標準不同,加上充電站設立不足,續航力一直是電動車普及化的最大障礙之一,但這個情況隨著特斯拉的投入,或許未來即將有望改變。

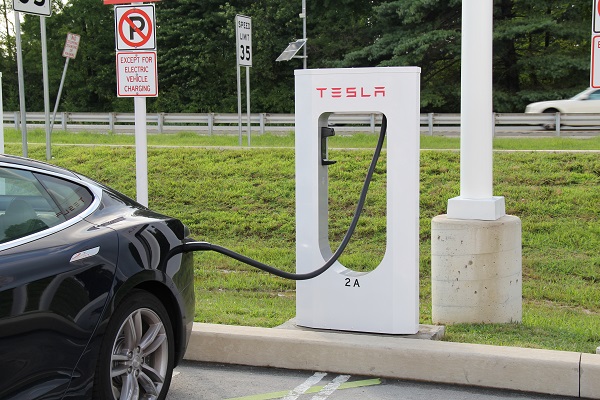
    Electrek 報導,特斯拉過去經常談到將超級充電站網路(Supercharger network)開放給其他車商的可能,但一直都沒有後續消息傳出。就在16 日能源博覽會中,技術長JB Straubel 再度提及這個想法,他表示,目前正與其他車商針對充電站的設置「積極交流」中。

    特斯拉最早提到這個概念是在2015 年9 月,當時執行長馬斯克(Elon Musk)表示,特斯拉會持續擁有並經營所有超級充電站,其他車商只需要為該廠牌電動車的充電費用付費即可。

    身為世界領先的電動車大廠,特斯拉的超級充電站無論充電率、覆蓋率都領先其他車廠許多,如果這樣的合作方式成真,相信對電動車普及會很有幫助,只怕充電站的塞車情況會更嚴重。

    特斯拉一直有在擴大超級充電站網路,根據官網介紹,目前全球已有超過861 個特斯拉超級充電站,但充電站塞車的情況仍舊持續上演,更別提目前多數電動車充電率都沒辦法達到特斯拉的一半;一旦開放其他廠牌車輛使用,車主恐怕得在充電站等上更久時間。

    為了改善這種情況,除了宣布進一步擴展網路以外,特斯拉推出一種新型用戶付費系統,可以提供其他車商的用戶使用。值得一提的是,特斯拉也加入了CCS 標準協會,這意味著未來超級充電站的充電接口兼容性或許會更廣泛。

    除此之外,一些車商正在打造更高充電率的電動車,很快特斯拉就不會是唯一能以100kW+ 充電率充電的車輛,包括保時捷、奧迪、賓士都宣布,未來2 年會推出新款電動車,估計這些車輛能接受直流快速充電。

    (合作媒體:。圖片出處:wikipedia)

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • 電動車發展快速,旭化成增產鋰電池材料「分隔模」

    電動車發展快速,旭化成增產鋰電池材料「分隔模」


    日刊工業新聞23日報導,因車廠加快電動車(EV)的研發腳步、帶動電池材料市場成長速度超乎預期,故旭化成(Asahi Kasei)計畫上修鋰離子電池關鍵材料「分隔膜(separator)」的增產計畫,目標在2020年結束前將分隔膜年產能最高擴增至15億平方公尺(m2)、將達現行的2.5倍,且將遠高於原先規劃的11億m2目標,期望藉由積極投資、鞏固全球龍頭位置。預估追加擴產所需的投資額約300億日圓。

    據報導,2016年全球分隔膜市場規模約15億m2、且預估2020年最高將擴大至35億m2的水準。就用途別來看,車用需求佔整體比重7成;就國別來看,因強化環保規範、提振EV需求急增的中國為全球最大市場、佔全球比重過半。

    旭化成於3月30日宣布,因電動車(EV)、油電混合車(HV)等車用鋰離子電池需求預估將呈現急速增長,故決議擴增鋰離子電池關鍵材料「分隔膜」產能,計畫投下約150億日圓,在守山製造所(滋賀縣守山市)增設年產能約2億平方公尺(m2)的分隔膜產線,並預計於2019年度上半年商轉。

    旭化成指出,待上述增產工程完工後,該公司整體分隔膜年產能將從現行的約6.6億m2提高3成至約8.6億m2。

    旭化成為全球分隔膜龍頭廠、全球市佔率達5成,目前於滋賀縣、宮崎縣以及美國和南韓生產分隔膜。

    根據日本市調機構富士經濟(Fuji Keizai)預估,2020年全球分隔膜市場規模將增至3,000億日圓、將達2015年的2倍水準,而EV、HV等車用用途是推動分隔膜需求急增的最大功臣,預估2020年車用分隔膜佔整體市場比重將達約45%。

    富士經濟6月22日公布調查報告指出,預估2030年時EV年銷售量將增至407萬台、超越HV(2030年銷售量預估為391萬台),且之後雙方的差距將持續擴大。富士經濟預估,在中國需求增加加持下,2035年EV全球銷售量將擴大至630萬台、將達2016年的13.4倍(較2016年增加12.4倍)。

    (本文內容由授權使用。圖片出處:)  

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選