部落格

  • 4W字的後端面試知識點總結(持續更新)

    4W字的後端面試知識點總結(持續更新)

    點贊再看,養成習慣,微信搜索【三太子敖丙】關注這個互聯網苟且偷生的工具人。

    本文 GitHub https://github.com/JavaFamily 已收錄,有一線大廠面試完整考點、資料以及我的系列文章。

    前言

    前段時間敖丙不是在複習嘛,很多小夥伴也想要我的複習路線,以及我自己筆記裏面的一些知識點,好了,丙丙花了一個月的時間,整整一個月啊,給大家整理出來了。

    一上來我就放個大招好吧,我的複習腦圖,可以說是全得不行,為了防止被盜圖,我加了水印哈。

    這期看下去你會發現很硬核,而且我會持續更新,啥也不說了,看在我熬夜一個月滿臉痘痘的份上,你可以點贊了哈哈。

    注:如果圖被壓縮了,可以去公眾號【三太子敖丙】回復【複習】獲取原圖

    Spring

    Spring框架的七大模塊

    Spring Core:框架的最基礎部分,提供 IoC 容器,對 bean 進行管理。

    Spring Context:繼承BeanFactory,提供上下文信息,擴展出JNDI、EJB、电子郵件、國際化等功能。

    Spring DAO:提供了JDBC的抽象層,還提供了聲明性事務管理方法。

    Spring ORM:提供了JPA、JDO、Hibernate、MyBatis 等ORM映射層.

    Spring AOP:集成了所有AOP功能

    Spring Web:提供了基礎的 Web 開發的上下文信息,現有的Web框架,如JSF、Tapestry、Structs等,提供了集成

    Spring Web MVC:提供了 Web 應用的 Model-View-Controller 全功能實現。

    Bean定義5種作用域

    singleton(單例) prototype(原型) request session global session

    spring ioc初始化流程?

    resource定位 即尋找用戶定義的bean資源,由 ResourceLoader通過統一的接口Resource接口來完成 beanDefinition載入 BeanDefinitionReader讀取、解析Resource定位的資源 成BeanDefinition 載入到ioc中(通過HashMap進行維護BD) BeanDefinition註冊 即向IOC容器註冊這些BeanDefinition, 通過BeanDefinitionRegistery實現

    BeanDefinition加載流程?

    定義BeanDefinitionReader解析xml的document BeanDefinitionDocumentReader解析document成beanDefinition

    DI依賴注入流程? (實例化,處理Bean之間的依賴關係)

    過程在Ioc初始化后,依賴注入的過程是用戶第一次向IoC容器索要Bean時觸發

    • 如果設置lazy-init=true,會在第一次getBean的時候才初始化bean, lazy-init=false,會容器啟動的時候直接初始化(singleton bean);

    • 調用BeanFactory.getBean()生成bean的;

    • 生成bean過程運用裝飾器模式產生的bean都是beanWrapper(bean的增強);

      依賴注入怎麼處理bean之間的依賴關係?

      其實就是通過在beanDefinition載入時,如果bean有依賴關係,通過佔位符來代替,在調用getbean時候,如果遇到佔位符,從ioc里獲取bean注入到本實例來

    Bean的生命周期?

    • 實例化Bean: Ioc容器通過獲取BeanDefinition對象中的信息進行實例化,實例化對象被包裝在BeanWrapper對象中
    • 設置對象屬性(DI):通過BeanWrapper提供的設置屬性的接口完成屬性依賴注入;
    • 注入Aware接口(BeanFactoryAware, 可以用這個方式來獲取其它 Bean,ApplicationContextAware):Spring會檢測該對象是否實現了xxxAware接口,並將相關的xxxAware實例注入給bean
    • BeanPostProcessor:自定義的處理(分前置處理和後置處理)
    • InitializingBean和init-method:執行我們自己定義的初始化方法
    • 使用
    • destroy:bean的銷毀

    IOC:控制反轉:將對象的創建權,由Spring管理. DI(依賴注入):在Spring創建對象的過程中,把對象依賴的屬性注入到類中。

    Spring的IOC注入方式

    構造器注入 setter方法注入 註解注入 接口注入

    怎麼檢測是否存在循環依賴?

    Bean在創建的時候可以給該Bean打標,如果遞歸調用回來發現正在創建中的話,即說明了循環依賴了。

    Spring如解決Bean循環依賴問題?

    Spring中循環依賴場景有:

    • 構造器的循環依賴
    • 屬性的循環依賴
    • singletonObjects:第一級緩存,裏面放置的是實例化好的單例對象; earlySingletonObjects:第二級緩存,裏面存放的是提前曝光的單例對象; singletonFactories:第三級緩存,裏面存放的是要被實例化的對象的對象工廠
    • 創建bean的時候Spring首先從一級緩存singletonObjects中獲取。如果獲取不到,並且對象正在創建中,就再從二級緩存earlySingletonObjects中獲取,如果還是獲取不到就從三級緩存singletonFactories中取(Bean調用構造函數進行實例化后,即使屬性還未填充,就可以通過三級緩存向外提前暴露依賴的引用值(提前曝光),根據對象引用能定位到堆中的對象,其原理是基於Java的引用傳遞),取到后從三級緩存移動到了二級緩存完全初始化之後將自己放入到一級緩存中供其他使用,
    • 因為加入singletonFactories三級緩存的前提是執行了構造器,所以構造器的循環依賴沒法解決。
    • 構造器循環依賴解決辦法:在構造函數中使用@Lazy註解延遲加載。在注入依賴時,先注入代理對象,當首次使用時再創建對象說明:一種互斥的關係而非層次遞進的關係,故稱為三個Map而非三級緩存的緣由 完成注入;

    Spring 中使用了哪些設計模式?

    • 工廠模式: spring中的BeanFactory就是簡單工廠模式的體現,根據傳入唯一的標識來獲得bean對象;
    • 單例模式: 提供了全局的訪問點BeanFactory;
    • 代理模式: AOP功能的原理就使用代理模式(1、JDK動態代理。2、CGLib字節碼生成技術代理。)
    • 裝飾器模式: 依賴注入就需要使用BeanWrapper;
    • 觀察者模式: spring中Observer模式常用的地方是listener的實現。如ApplicationListener。
    • 策略模式: Bean的實例化的時候決定採用何種方式初始化bean實例(反射或者CGLIB動態字節碼生成)

    AOP 核心概念

    1、切面(aspect):類是對物體特徵的抽象,切面就是對橫切關注點的抽象

    2、橫切關注點:對哪些方法進行攔截,攔截后怎麼處理,這些關注點稱之為橫切關注點。

    3、連接點(joinpoint):被攔截到的點,因為 Spring 只支持方法類型的連接點,所以在Spring 中連接點指的就是被攔截到的方法,實際上連接點還可以是字段或者構造器。

    4、切入點(pointcut):對連接點進行攔截的定義

    5、通知(advice):所謂通知指的就是指攔截到連接點之後要執行的代碼,通知分為前置、後置、異常、最終、環繞通知五類。

    6、目標對象:代理的目標對象

    7、織入(weave):將切面應用到目標對象並導致代理對象創建的過程

    8、引入(introduction):在不修改代碼的前提下,引入可以在運行期為類動態地添加方法或字段。

    解釋一下AOP

    傳統oop開發代碼邏輯自上而下的,這個過程中會產生一些橫切性問題,這些問題與我們主業務邏輯關係不大,會散落在代碼的各個地方,造成難以維護,aop思想就是把業務邏輯與橫切的問題進行分離,達到解耦的目的,提高代碼重用性和開發效率;

    AOP 主要應用場景有:

    • 記錄日誌
    • 監控性能
    • 權限控制
    • 事務管理

    AOP源碼分析

    • @EnableAspectJAutoProxy給容器(beanFactory)中註冊一個AnnotationAwareAspectJAutoProxyCreator對象;

    • AnnotationAwareAspectJAutoProxyCreator對目標對象進行代理對象的創建,對象內部,是封裝JDK和CGlib兩個技術,實現動態代理對象創建的(創建代理對象過程中,會先創建一個代理工廠,獲取到所有的增強器(通知方法),將這些增強器和目標類注入代理工廠,再用代理工廠創建對象);

    • 代理對象執行目標方法,得到目標方法的攔截器鏈,利用攔截器的鏈式機制,依次進入每一個攔截器進行執行

      AOP應用場景

      • 日誌記錄
      • 事務管理
      • 線程池關閉等

    AOP使用哪種動態代理?

    • 當bean的是實現中存在接口或者是Proxy的子類,—jdk動態代理;不存在接口,spring會採用CGLIB來生成代理對象;
    • JDK 動態代理主要涉及到 java.lang.reflect 包中的兩個類:Proxy 和 InvocationHandler。
    • Proxy 利用 InvocationHandler(定義橫切邏輯) 接口動態創建 目標類的代理對象。

    jdk動態代理

    • 通過bind方法建立代理與真實對象關係,通過Proxy.newProxyInstance(target)生成代理對象
    • 代理對象通過反射invoke方法實現調用真實對象的方法

    動態代理與靜態代理區別

    • 靜態代理,程序運行前代理類的.class文件就存在了;
    • 動態代理:在程序運行時利用反射動態創建代理對象<復用性,易用性,更加集中都調用invoke>

    CGLIB與JDK動態代理區別

    • Jdk必須提供接口才能使用;
    • C不需要,只要一個非抽象類就能實現動態代理

    SpringMVC

    springMVC流程:

    (1):用戶請求發送給DispatcherServlet,DispatcherServlet調用HandlerMapping處理器映射器;

    (2):HandlerMapping根據xml或註解找到對應的處理器,生成處理器對象返回給DispatcherServlet;

    (3):DispatcherServlet會調用相應的HandlerAdapter;

    (4):HandlerAdapter經過適配調用具體的處理器去處理請求,生成ModelAndView返回給DispatcherServlet

    (5):DispatcherServlet將ModelAndView傳給ViewReslover解析生成View返回給DispatcherServlet;

    (6):DispatcherServlet根據View進行渲染視圖;

    ->DispatcherServlet->HandlerMapping->Handler ->DispatcherServlet->HandlerAdapter處理handler->ModelAndView ->DispatcherServlet->ModelAndView->ViewReslover->View ->DispatcherServlet->返回給客戶

    Mybatis

    Mybatis原理

    • sqlsessionFactoryBuilder生成sqlsessionFactory(單例)
    • 工廠模式生成sqlsession執行sql以及控制事務
    • Mybatis通過動態代理使Mapper(sql映射器)接口能運行起來即為接口生成代理對象將sql查詢到結果映射成pojo

    sqlSessionFactory構建過程

    • 解析並讀取配置中的xml創建Configuration對象 (單例)
    • 使用Configruation類去創建sqlSessionFactory(builder模式)

    Mybatis一級緩存與二級緩存

    默認情況下一級緩存是開啟的,而且是不能關閉的。

    • 一級緩存是指 SqlSession 級別的緩存 原理:使用的數據結構是一個 map,如果兩次中間出現 commit 操作 (修改、添加、刪除),本 sqlsession 中的一級緩存區域全部清空
    • 二級緩存是指可以跨 SqlSession 的緩存。是 mapper 級別的緩存; 原理: 是通過 CacheExecutor 實現的。CacheExecutor其實是 Executor 的代理對象

    Zookeeper+eureka+springcloud

    SpringBoot啟動流程

    • new springApplication對象,利用spi機制加載applicationContextInitializer, applicationLister接口實例(META-INF/spring.factories);

    • 調run方法準備Environment,加載應用上下文(applicationContext),發布事件 很多通過lister實現

    • 創建spring容器, refreshContext() ,實現starter自動化配置,spring.factories文件加載, bean實例化

      SpringBoot自動配置的原理

      • @EnableAutoConfiguration找到META-INF/spring.factories(需要創建的bean在裏面)配置文件
      • 讀取每個starter中的spring.factories文件

    Spring Boot 的核心註解

    核心註解是@SpringBootApplication 由以下三種組成

    • @SpringBootConfiguration:組合了 @Configuration 註解,實現配置文件的功能。
    • @EnableAutoConfiguration:打開自動配置的功能。
    • @ComponentScan:Spring組件掃描。

    SpringBoot常用starter都有哪些

    spring-boot-starter-web – Web 和 RESTful 應用程序; spring-boot-starter-test – 單元測試和集成測試; spring-boot-starter-jdbc – 傳統的 JDBC; spring-boot-starter-security – 使用 SpringSecurity 進行身份驗證和授權; spring-boot-starter-data-jpa – 帶有 Hibernate 的 Spring Data JPA; spring-boot-starter-data-rest – 使用 Spring Data REST 公布簡單的 REST 服務

    Spring Boot 的核心配置文件

    (1):Application.yml 一般用來定義單個應用級別的,如果搭配 spring-cloud-config 使用

    (2).Bootstrap.yml(先加載) 系統級別的一些參數配置,這些參數一般是不變的

    Zuul與Gateway區別

    (1):zuul則是netflix公司的項目集成在spring-cloud中使用而已, Gateway是spring-cloud的 一個子項目;

    (2):zuul不提供異步支持流控等均由hystrix支持, gateway提供了異步支持,提供了抽象負載均衡,提供了抽象流控; 理論上gateway則更適合於提高系統吞吐量(但不一定能有更好的性能),最終性能還需要通過嚴密的壓測來決定

    (3):兩者底層實現都是servlet,但是gateway多嵌套了一層webflux框架

    (4): zuul可用至其他微服務框架中,內部沒有實現限流、負載均衡;gateway只能用在springcloud中;

    Zuul原理分析

    (1):請求給zuulservlet處理(HttpServlet子類) zuulservlet中有一個zuulRunner對象,該對象中初始化了RequestContext(存儲請求的數據),RequestContext被所有的zuulfilter共享;

    (2): zuulRunner中有 FilterProcessor(zuulfilter的管理器),其從filterloader 中獲取zuulfilter;

    (3):有了這些filter之後, zuulservelet執行的Pre-> route-> post 類型的過濾器,如果在執行這些過濾器有錯誤的時候則會執行error類型的過濾器,執行完后把結果返回給客戶端.

    Gateway原理分析

    (1):請求到達DispatcherHandler, DispatchHandler在IOC容器初始化時會在容器中實例化HandlerMapping接口

    (2):用handlerMapping根據請求URL匹配到對應的Route,然後有對應的filter做對應的請求轉發最終response返回去

    Zookeeper 工作原理(待查)

    Zookeeper 的核心是原子廣播,這個機制保證了各個 server 之間的同步。實現這個機制的協議叫做 Zab 協議。Zab 協議有兩種模式,它們分別是恢復模式和廣播模式。

    zoo與eur區別

    • zookeeper保證cp(一致性)
    • eureka保證ap(可用性)
    • zoo在選舉期間註冊服務癱瘓,期間不可用
    • eur各個節點平等關係,只要有一台就可保證服務可用,而查詢到的數據可能不是最新的,可以很好應對網絡故障導致部分節點失聯情況
    • zoo有leader和follower角色,eur各個節點平等
    • zoo採用半數存活原則(避免腦裂),eur採用自我保護機制來解決分區問題
    • eur本質是個工程,zoo只是一個進程 ZooKeeper基於CP,不保證高可用,如果zookeeper正在選主,或者Zookeeper集群中半數以上機器不可用,那麼將無法獲得數據。 Eureka基於AP,能保證高可用,即使所有機器都掛了,也能拿到本地緩存的數據。作為註冊中心,其實配置是不經常變動的,只有發版(發布新的版本)和機器出故障時會變。對於不經常變動的配置來說,CP是不合適的,而AP在遇到問題時可以用犧牲一致性來保證可用性,既返回舊數據,緩存數據。 所以理論上Eureka是更適合做註冊中心。而現實環境中大部分項目可能會使用ZooKeeper,那是因為集群不夠大,並且基本不會遇到用做註冊中心的機器一半以上都掛了的情況。所以實際上也沒什麼大問題。

    Hystrix原理(待查)

    通過維護一個自己的線程池,當線程池達到閾值的時候,就啟動服務降級,返回fallback默認值

    為什麼需要hystrix熔斷

    防止雪崩,及時釋放資源,防止系統發生更多的額級聯故障,需要對故障和延遲進行隔離,防止單個依賴關係的失敗影響整個應用程序;

    微服務優缺點

    • 每個服務高內聚,松耦合,面向接口編程;
    • 服務間通信成本,數據一致性,多服務運維難度增加,http傳輸效率不如rpc

    eureka自我保護機制

    • eur不移除長時間沒收到心跳而應該過期的服務
    • 仍然接受新服務註冊和查詢請求,但是不會同步到其它節點(高可用)
    • 當網絡穩定后,當前實例新註冊信息會同步到其它節點(最終一致性)

    MQ對比

    ActiveMQ:Apache出品,最早使用的消息隊列產品,時間比較長了,最近版本更新比較緩慢。 RabbitMQ:erlang語言開發,支持很多的協議,非常重量級,更適合於企業級的開發。性能較好,但是不利於做二次開發和維護。 RocketMQ:阿里開源的消息中間件,純Java開發,具有高吞吐量、高可用性、適合大規模分佈式系統應用的特點,分佈式事務。 ZeroMQ:號稱最快的消息隊列系統,尤其針對大吞吐量的需求場景,採用 C 語言實現。 消息隊列的選型需要根據具體應用需求而定,ZeroMQ 小而美,RabbitMQ 大而穩,Kakfa 和 RocketMQ 快而強勁

    JAVA基礎

    AVL樹與紅黑樹(R-B樹)的區別與聯繫

    • AVL是嚴格的平衡樹,因此在增加或者刪除節點的時候,根據不同情況,旋轉的次數比紅黑樹要多;
    • 紅黑樹是用非嚴格的平衡來換取增刪節點時候旋轉次數的降低開銷;
    • 所以簡單說,查詢多選擇AVL樹,查詢更新次數差不多選紅黑樹
    • AVL樹順序插入和刪除時有20%左右的性能優勢,紅黑樹隨機操作15%左右優勢,現實應用當然一般都是隨機情況,所以紅黑樹得到了更廣泛的應用 索引為B+樹 Hashmap為紅黑樹

    為啥redis zset使用跳躍鏈表而不用紅黑樹實現

    • skiplist的複雜度和紅黑樹一樣,而且實現起來更簡單。
    • 在併發環境下紅黑樹在插入和刪除時需要rebalance,性能不如跳錶。

    JAVA基本數據類型

    (1個字節是8個bit) 整數型:byte(1字節)、short(2字節)、int(4字節)、long(8字節) 浮點型:float(4字節)、double(8字節) 布爾型:boolean(1字節) 字符型:char(2字節)

    IO與NIO

    包括 類File,outputStream,inputStream,writer,readerseralizable(5類1接口)

    NIO三大核心內容 selector(選擇器,用於監聽channel),channel(通道),buffer(緩衝區)

    NIO與IO區別,IO面向流,NIO面向緩衝區;io阻塞,nio非阻塞

    異常類

    throwable為父類,子為error跟exception,exception分runtime(空指針,越界等)跟checkexception(sql,io,找不到類等異常)

    LVS(4層與7層)原理

    • 由前端虛擬負載均衡器和後端真實服務器群組成;
    • 請求發送給虛擬服務器后其根據包轉發策略以及負載均衡調度算法轉發給真實服務器
    • 所謂四層(lvs,f5)就是基於IP+端口的負載均衡;七層(nginx)就是基於URL等應用層信息的負載均衡

    StringBuilder與StringBuffer

    • StringBuilder 更快;
    • StringBuffer是線程安全的

    interrupt/isInterrupted/interrupt區別

    • interrupt() 調用該方法的線程的狀態為將被置為”中斷”狀態(set操作)
    • isinterrupted() 是作用於調用該方法的線程對象所對應的線程的中斷信號是true還是false(get操作)。例如我們可以在A線程中去調用B線程對象的isInterrupted方法,查看的是A
    • interrupted()是靜態方法:內部實現是調用的當前線程的isInterrupted(),並且會重置當前線程的中斷狀態(getandset)

    sleep與wait區別

    sleep屬於線程類,wait屬於object類;sleep不釋放鎖

    CountDownLatch和CyclicBarrier區別

    • con用於主線程等待其他子線程任務都執行完畢后再執行,cyc用於一組線程相互等待大家都達到某個狀態后,再同時執行;
    • CountDownLatch是不可重用的,CyclicBarrier可重用

    終止線程方法

    • 使用退出標誌,說線程正常退出;
    • 通過判斷this.interrupted() throw new InterruptedException()來停止 使用String常量池作為鎖對象會導致兩個線程持有相同的鎖,另一個線程不執行,改用其他如new Object()

    ThreadLocal的原理和應用

    原理:

    線程中創建副本,訪問自己內部的副本變量,內部實現是其內部類名叫ThreadLocalMap的成員變量threadLocals,key為本身,value為實際存值的變量副本

    應用:

    • 用來解決數據庫連接,存放connection對象,不同線程存放各自session;
    • 解決simpleDateFormat線程安全問題;
    • 會出現內存泄漏,顯式remove..不要與線程池配合,因為worker往往是不會退出的;

    threadLocal 內存泄漏問題

    如果是強引用,設置tl=null,但是key的引用依然指向ThreadLocal對象,所以會有內存泄漏,而使用弱引用則不會; 但是還是會有內存泄漏存在,ThreadLocal被回收,key的值變成null,導致整個value再也無法被訪問到; 解決辦法:在使用結束時,調用ThreadLocal.remove來釋放其value的引用;

    如果我們要獲取父線程的ThreadLocal值呢

    ThreadLocal是不具備繼承性的,所以是無法獲取到的,但是我們可以用InteritableThreadLocal來實現這個功能。InteritableThreadLocal繼承來ThreadLocal,重寫了createdMap方法,已經對應的get和set方法,不是在利用了threadLocals,而是interitableThreadLocals變量。

    這個變量會在線程初始化的時候(調用init方法),會判斷父線程的interitableThreadLocals變量是否為空,如果不為空,則把放入子線程中,但是其實這玩意沒啥鳥用,當父線程創建完子線程后,如果改變父線程內容是同步不到子線程的。。。同樣,如果在子線程創建完后,再去賦值,也是沒啥鳥用的

    線程狀態

    線程池有5種狀態:running,showdown,stop,Tidying,TERMINATED。

    • running:線程池處於運行狀態,可以接受任務,執行任務,創建線程默認就是這個狀態了

    • showdown:調用showdown()函數,不會接受新任務,但是會慢慢處理完堆積的任務。

    • stop:調用showdownnow()函數,不會接受新任務,不處理已有的任務,會中斷現有的任務。

    • Tidying:當線程池狀態為showdown或者stop,任務數量為0,就會變為tidying。這個時候會調用鈎子函數terminated()。

    • TERMINATED:terminated()執行完成。

    在線程池中,用了一個原子類來記錄線程池的信息,用了int的高3位表示狀態,後面的29位表示線程池中線程的個數。

    Java中的線程池是如何實現的?

    • 線程中線程被抽象為靜態內部類Worker,是基於AQS實現的存放在HashSet中;
    • 要被執行的線程存放在BlockingQueue中;
    • 基本思想就是從workQueue中取出要執行的任務,放在worker中處理;

    如果線程池中的一個線程運行時出現了異常,會發生什麼

    如果提交任務的時候使用了submit,則返回的feature里會存有異常信息,但是如果數execute則會打印出異常棧。但是不會給其他線程造成影響。之後線程池會刪除該線程,會新增加一個worker。

    線程池原理

    • 提交一個任務,線程池裡存活的核心線程數小於corePoolSize時,線程池會創建一個核心線程去處理提交的任務
    • 如果線程池核心線程數已滿,即線程數已經等於corePoolSize,一個新提交的任務,會被放進任務隊列workQueue排隊等待執行。
    • 當線程池裡面存活的線程數已經等於corePoolSize了,並且任務隊列workQueue也滿,判斷線程數是否達到maximumPoolSize,即最大線程數是否已滿,如果沒到達,創建非核心線程執行提交的任務。
    • 如果當前的線程數達到了maximumPoolSize,還有新的任務過來的話,直接採用拒絕策略處理。

    拒絕策略

    • AbortPolicy直接拋出異常阻止線程運行;
    • CallerRunsPolicy如果被丟棄的線程任務未關閉,則執行該線程;
    • DiscardOldestPolicy移除隊列最早線程嘗試提交當前任務
    • DiscardPolicy丟棄當前任務,不做處理

    newFixedThreadPool (固定數目線程的線程池)

    • 阻塞隊列為無界隊列LinkedBlockingQueue
    • 適用於處理CPU密集型的任務,適用執行長期的任務

    newCachedThreadPool(可緩存線程的線程池)

    • 阻塞隊列是SynchronousQueue
    • 適用於併發執行大量短期的小任務

    newSingleThreadExecutor(單線程的線程池)

    • 阻塞隊列是LinkedBlockingQueue
    • 適用於串行執行任務的場景,一個任務一個任務地執行

    newScheduledThreadPool(定時及周期執行的線程池)

    • 阻塞隊列是DelayedWorkQueue
    • 周期性執行任務的場景,需要限制線程數量的場景

    java鎖相關

    synchronized實現原理

    contentionList(請求鎖線程隊列) entryList(有資格的候選者隊列) waitSet(wait方法后阻塞隊列) onDeck(競爭候選者) ower(競爭到鎖線程) !ower(執行成功釋放鎖后狀態); Synchronized 是非公平鎖。

    Synchronized 在線程進入 ContentionList 時,等待的線程會先嘗試自旋獲取鎖,如果獲取不到就進入 ContentionList,這明顯對於已經進入隊列的線程是不公平的,還有一個不公平的事情就是自旋獲取鎖的線程還可能直接搶佔 OnDeck 線程的鎖資源。

    底層是由一對monitorenter和monitorexit指令實現的(監視器鎖)

    每個對象有一個監視器鎖(monitor)。當monitor被佔用時就會處於鎖定狀態,線程執行monitorenter指令時嘗試獲取monitor的所有權,過程:

    • 如果monitor的進入數為0,則該線程進入monitor,然後將進入數設置為1,該線程即為monitor的所有者。
    • 如果線程已經佔有該monitor,只是重新進入,則進入monitor的進入數加1.
    • 如果其他線程已經佔用了monitor,則該線程進入阻塞狀態,直到monitor的進入數為0,再重新嘗試獲取monitor的所有權。

    ReentrantLock 是如何實現可重入性的 ?

    內部自定義了同步器 Sync,加鎖的時候通過CAS 算法 ,將線程對象放到一個雙向鏈表 中,每次獲取鎖的時候 ,看下當前維 護的那個線程ID和當前請求的線程ID是否一樣,一樣就可重入了;

    ReentrantLock如何避免死鎖?

    • 響應中斷lockInterruptibly()
    • 可輪詢鎖tryLock()
    • 定時鎖tryLock(long time)

    tryLock 和 lock 和 lockInterruptibly 的區別

    (1):tryLock 能獲得鎖就返回 true,不能就立即返回 false,

    (2):tryLock(long timeout,TimeUnit unit),可以增加時間限制,如果超過該時間段還沒獲得鎖,返回 false

    (3):lock 能獲得鎖就返回 true,不能的話一直等待獲得鎖

    (4):lock 和 lockInterruptibly,如果兩個線程分別執行這兩個方法,但此時中斷這兩個線程, lock 不會拋出異常,而 lockInterruptibly 會拋出異常。

    CountDownLatch和CyclicBarrier的區別是什麼

    CountDownLatch是等待其他線程執行到某一個點的時候,在繼續執行邏輯(子線程不會被阻塞,會繼續執行),只能被使用一次。最常見的就是join形式,主線程等待子線程執行完任務,在用主線程去獲取結果的方式(當然不一定),內部是用計數器相減實現的(沒錯,又特么是AQS),AQS的state承擔了計數器的作用,初始化的時候,使用CAS賦值,主線程調用await()則被加入共享線程等待隊列裏面,子線程調用countDown的時候,使用自旋的方式,減1,知道為0,就觸發喚醒。

    CyclicBarrier迴環屏障,主要是等待一組線程到底同一個狀態的時候,放閘。CyclicBarrier還可以傳遞一個Runnable對象,可以到放閘的時候,執行這個任務。CyclicBarrier是可循環的,當調用await的時候如果count變成0了則會重置狀態,如何重置呢,CyclicBarrier新增了一個字段parties,用來保存初始值,當count變為0的時候,就重新賦值。還有一個不同點,CyclicBarrier不是基於AQS的,而是基於RentrantLock實現的。存放的等待隊列是用了條件變量的方式。

    synchronized與ReentrantLock區別

    • 都是可重入鎖; R是显示獲取和釋放鎖,s是隱式;
    • R更靈活可以知道有沒有成功獲取鎖,可以定義讀寫鎖,是api級別,s是JVM級別;
    • R可以定義公平鎖;Lock是接口,s是java中的關鍵字

    什麼是信號量Semaphore

    信號量是一種固定資源的限制的一種併發工具包,基於AQS實現的,在構造的時候會設置一個值,代表着資源數量。信號量主要是應用於是用於多個共享資源的互斥使用,和用於併發線程數的控制(druid的數據庫連接數,就是用這個實現的),信號量也分公平和非公平的情況,基本方式和reentrantLock差不多,在請求資源調用task時,會用自旋的方式減1,如果成功,則獲取成功了,如果失敗,導致資源數變為了0,就會加入隊列裏面去等待。調用release的時候會加一,補充資源,並喚醒等待隊列。

    Semaphore 應用

    • acquire() release() 可用於對象池,資源池的構建,比如靜態全局對象池,數據庫連接池;
    • 可創建計數為1的S,作為互斥鎖(二元信號量)

    可重入鎖概念

    (1):可重入鎖是指同一個線程可以多次獲取同一把鎖,不會因為之前已經獲取過還沒釋放而阻塞;

    (2):reentrantLock和synchronized都是可重入鎖

    (3):可重入鎖的一個優點是可一定程度避免死鎖

    ReentrantLock原理(CAS+AQS)

    CAS+AQS隊列來實現

    (1):先通過CAS嘗試獲取鎖, 如果此時已經有線程佔據了鎖,那就加入AQS隊列並且被掛起;

    (2): 當鎖被釋放之後, 排在隊首的線程會被喚醒CAS再次嘗試獲取鎖,

    (3):如果是非公平鎖, 同時還有另一個線程進來嘗試獲取可能會讓這個線程搶到鎖;

    (4):如果是公平鎖, 會排到隊尾,由隊首的線程獲取到鎖。

    AQS 原理

    Node內部類構成的一個雙向鏈表結構的同步隊列,通過控制(volatile的int類型)state狀態來判斷鎖的狀態,對於非可重入鎖狀態不是0則去阻塞;

    對於可重入鎖如果是0則執行,非0則判斷當前線程是否是獲取到這個鎖的線程,是的話把state狀態+1,比如重入5次,那麼state=5。 而在釋放鎖的時候,同樣需要釋放5次直到state=0其他線程才有資格獲得鎖

    AQS兩種資源共享方式

    • Exclusive:獨佔,只有一個線程能執行,如ReentrantLock
    • Share:共享,多個線程可以同時執行,如Semaphore、CountDownLatch、ReadWriteLock,CyclicBarrier

    CAS原理

    內存值V,舊的預期值A,要修改的新值B,當A=V時,將內存值修改為B,否則什麼都不做;

    CAS的缺點:

    (1):ABA問題; (2):如果CAS失敗,自旋會給CPU帶來壓力; (3):只能保證對一個變量的原子性操作,i++這種是不能保證的

    CAS在java中的應用:

    (1):Atomic系列

    公平鎖與分公平鎖

    (1):公平鎖指在分配鎖前檢查是否有線程在排隊等待獲取該鎖,優先分配排隊時間最長的線程,非公平直接嘗試獲取鎖 (2):公平鎖需多維護一個鎖線程隊列,效率低;默認非公平

    獨佔鎖與共享鎖

    (1):ReentrantLock為獨佔鎖(悲觀加鎖策略) (2):ReentrantReadWriteLock中讀鎖為共享鎖 (3): JDK1.8 郵戳鎖(StampedLock), 不可重入鎖 讀的過程中也允許獲取寫鎖后寫入!這樣一來,我們讀的數據就可能不一致,所以,需要一點額外的代碼來判斷讀的過程中是否有寫入,這種讀鎖是一種樂觀鎖, 樂觀鎖的併發效率更高,但一旦有小概率的寫入導致讀取的數據不一致,需要能檢測出來,再讀一遍就行

    4種鎖狀態

    • 無鎖

    • 偏向鎖 會偏向第一個訪問鎖的線程,當一個線程訪問同步代碼塊獲得鎖時,會在對象頭和棧幀記錄里存儲鎖偏向的線程ID,當這個線程再次進入同步代碼塊時,就不需要CAS操作來加鎖了,只要測試一下對象頭裡是否存儲着指向當前線程的偏向鎖 如果偏向鎖未啟動,new出的對象是普通對象(即無鎖,有稍微競爭會成輕量級鎖),如果啟動,new出的對象是匿名偏向(偏向鎖) 對象頭主要包括兩部分數據:Mark Word(標記字段, 存儲對象自身的運行時數據)、class Pointer(類型指針, 是對象指向它的類元數據的指針)

    • 輕量級鎖(自旋鎖) (1):在把線程進行阻塞操作之前先讓線程自旋等待一段時間,可能在等待期間其他線程已經 解鎖,這時就無需再讓線程執行阻塞操作,避免了用戶態到內核態的切換。(自適應自旋時間為一個線程上下文切換的時間)

    • (2):在用自旋鎖時有可能造成死鎖,當遞歸調用時有可能造成死鎖

    • (3):自旋鎖底層是通過指向線程棧中Lock Record的指針來實現的

    • 重量級鎖

    輕量級鎖與偏向鎖的區別

    (1):輕量級鎖是通過CAS來避免進入開銷較大的互斥操作

    (2):偏向鎖是在無競爭場景下完全消除同步,連CAS也不執行

    自旋鎖升級到重量級鎖條件

    (1):某線程自旋次數超過10次;

    (2):等待的自旋線程超過了系統core數的一半;

    讀寫鎖了解嘛,知道讀寫鎖的實現方式嘛

    常用的讀寫鎖ReentrantReanWritelock,這個其實和reentrantLock相似,也是基於AQS的,但是這個是基於共享資源的,不是互斥,關鍵在於state的處理,讀寫鎖把高16為記為讀狀態,低16位記為寫狀態,就分開了,讀讀情況其實就是讀鎖重入,讀寫/寫讀/寫寫都是互斥的,只要判斷低16位就好了。

    zookeeper實現分佈式鎖

    (1):利用節點名稱唯一性來實現,加鎖時所有客戶端一起創建節點,只有一個創建成功者獲得鎖,解鎖時刪除節點。

    (2):利用臨時順序節點實現,加鎖時所有客戶端都創建臨時順序節點,創建節點序列號最小的獲得鎖,否則監視比自己序列號次小的節點進行等待

    (3):方案2比1好處是當zookeeper宕機后,臨時順序節點會自動刪除釋放鎖,不會造成鎖等待;

    (4):方案1會產生驚群效應(當有很多進程在等待鎖的時候,在釋放鎖的時候會有很多進程就過來爭奪鎖)。

    (5):由於需要頻繁創建和刪除節點,性能上不如redis鎖

    volatile變量

    (1):變量可見性

    (2):防止指令重排序

    (3):保障變量單次讀,寫操作的原子性,但不能保證i++這種操作的原子性,因為本質是讀,寫兩次操作

    volatile如何保證線程間可見和避免指令重排

    volatile可見性是有指令原子性保證的,在jmm中定義了8類原子性指令,比如write,store,read,load。而volatile就要求write-store,load-read成為一個原子性操作,這樣子可以確保在讀取的時候都是從主內存讀入,寫入的時候會同步到主內存中(準確來說也是內存屏障),指令重排則是由內存屏障來保證的,由兩個內存屏障:

    • 一個是編譯器屏障:阻止編譯器重排,保證編譯程序時在優化屏障之前的指令不會在優化屏障之後執行。
    • 第二個是cpu屏障:sfence保證寫入,lfence保證讀取,lock類似於鎖的方式。java多執行了一個“load addl $0x0, (%esp)”操作,這個操作相當於一個lock指令,就是增加一個完全的內存屏障指令。

    JVM

    jre、jdk、jvm的關係:

    jdk是最小的開發環境,由jre++java工具組成。

    jre是java運行的最小環境,由jvm+核心類庫組成。

    jvm是虛擬機,是java字節碼運行的容器,如果只有jvm是無法運行java的,因為缺少了核心類庫。

    JVM內存模型

    (1):堆<對象,靜態變量,共享

    (2):方法區<存放類信息,常量池,共享>(java8移除了永久代(PermGen),替換為元空間(Metaspace))

    (3):虛擬機棧<線程執行方法的時候內部存局部變量會存堆中對象的地址等等數據>

    (4):本地方法棧<存放各種native方法的局部變量表之類的信息>

    (5):程序計數器<記錄當前線程執行到哪一條字節碼指令位置>

    對象4種引用

    (1):強(內存泄露主因)

    (2):軟(只有軟引用的話,空間不足將被回收),適合緩存用

    (3):弱(只,GC會回收)

    (4):虛引用(用於跟蹤GC狀態)用於管理堆外內存

    對象的構成:

    一個對象分為3個區域:對象頭、實例數據、對齊填充

    對象頭:主要是包括兩部分,1.存儲自身的運行時數據比如hash碼,分代年齡,鎖標記等(但是不是絕對哦,鎖狀態如果是偏向鎖,輕量級鎖,是沒有hash碼的。。。是不固定的)2.指向類的元數據指針。還有可能存在第三部分,那就是數組類型,會多一塊記錄數組的長度(因為數組的長度是jvm判斷不出來的,jvm只有元數據信息)

    實例數據:會根據虛擬機分配策略來定,分配策略中,會把相同大小的類型放在一起,並按照定義順序排列(父類的變量也會在哦)

    對齊填充:這個意義不是很大,主要在虛擬機規範中對象必須是8字節的整數,所以當對象不滿足這個情況時,就會用佔位符填充

    如果判斷一個對象是否存活:

    一般判斷對象是否存活有兩種算法,一種是引用計數,另外一種是可達性分析。在java中主要是第二種

    java是根據什麼來執行可達性分析的:

    根據GC ROOTS。GC ROOTS可以的對象有:虛擬機棧中的引用對象,方法區的類變量的引用,方法區中的常量引用,本地方法棧中的對象引用。

    JVM 類加載順序

    (1):加載 獲取類的二進制字節流,將其靜態存儲結構轉化為方法區的運行時數據結構

    (2):校驗 文件格式驗證,元數據驗證,字節碼驗證,符號引用驗證

    (3):準備 在方法區中對類的static變量分配內存並設置類變量數據類型默認的初始值,不包括實例變量,實例變量將會在對象實例化的時候隨着對象一起分配在Java堆中

    (4):解析 將常量池內的符號引用替換為直接引用的過程

    (5):初始化 為類的靜態變量賦予正確的初始值(Java代碼中被顯式地賦予的值)

    JVM三種類加載器

    (1):啟動類加載器(home) 加載jvm核心類庫,如java.lang.*等

    (2):擴展類加載器(ext), 父加載器為啟動類加載器,從jre/lib/ext下加載類庫

    (3):應用程序類加載器(用戶classpath路徑) 父加載器為擴展類加載器,從環境變量中加載類

    雙親委派機制

    (1):類加載器收到類加載的請求

    (2):把這個請求委託給父加載器去完成,一直向上委託,直到啟動類加載器

    (3):啟動器加載器檢查能不能加載,能就加載(結束);否則,拋出異常,通知子加載器進行加載

    (4):保障類的唯一性和安全性以及保證JDK核心類的優先加載

    雙親委派模型有啥作用:

    保證java基礎類在不同的環境還是同一個Class對象,避免出現了自定義類覆蓋基礎類的情況,導致出現安全問題。還可以避免類的重複加載。

    如何打破雙親委派模型?

    (1):自定義類加載器,繼承ClassLoader類重寫loadClass方法;

    (2):SPI

    tomcat是如何打破雙親委派模型:

    tomcat有着特殊性,它需要容納多個應用,需要做到應用級別的隔離,而且需要減少重複性加載,所以劃分為:/common 容器和應用共享的類信息,/server容器本身的類信息,/share應用通用的類信息,/WEB-INF/lib應用級別的類信息。整體可以分為:boostrapClassLoader->ExtensionClassLoader->ApplicationClassLoader->CommonClassLoader->CatalinaClassLoader(容器本身的加載器)/ShareClassLoader(共享的)->WebAppClassLoader。雖然第一眼是滿足雙親委派模型的,但是不是的,因為雙親委派模型是要先提交給父類裝載,而tomcat是優先判斷是否是自己負責的文件位置,進行加載的。

    SPI: (Service Provider interface)

    (1):服務提供接口(服務發現機制):

    (2):通過加載ClassPath下META_INF/services,自動加載文件里所定義的類

    (3):通過ServiceLoader.load/Service.providers方法通過反射拿到實現類的實例

    SPI應用?

    (1):應用於JDBC獲取數據庫驅動連接過程就是應用這一機制

    (2):apache最早提供的common-logging只有接口.沒有實現..發現日誌的提供商通過SPI來具體找到日誌提供商實現類

    雙親委派機制缺陷?

    (1):雙親委派核心是越基礎的類由越上層的加載器進行加載, 基礎的類總是作為被調用代碼調用的API,無法實現基礎類調用用戶的代碼….

    (2):JNDI服務它的代碼由啟動類加載器去加載,但是他需要調獨立廠商實現的應用程序,如何解決? 線程上下文件類加載器(Thread Context ClassLoader), JNDI服務使用這個線程上下文類加載器去加載所需要的SPI代碼,也就是父類加載器請求子類加載器去完成類加載動作Java中所有涉及SPI的加載動作基本上都採用這種方式,例如JNDI,JDBC

    導致fullGC的原因

    (1):老年代空間不足

    (2):永久代(方法區)空間不足

    (3):顯式調用system.gc()

    堆外內存的優缺點

    Ehcache中的一些版本,各種 NIO 框架,Dubbo,Memcache 等中會用到,NIO包下ByteBuffer來創建堆外內存 堆外內存,其實就是不受JVM控制的內存。

    相比於堆內內存有幾個優勢:

    減少了垃圾回收的工作,因為垃圾回收會暫停其他的工作。 加快了複製的速度。因為堆內在 flush 到遠程時,會先複製到直接內存(非堆內存),然後在發送;而堆外內存相當於省略掉了複製這項工作。 可以擴展至更大的內存空間。比如超過 1TB 甚至比主存還大的空間。

    缺點總結如下:

    堆外內存難以控制,如果內存泄漏,那麼很難排查,通過-XX:MaxDirectMemerySize來指定,當達到閾值的時候,調用system.gc來進行一次full gc 堆外內存相對來說,不適合存儲很複雜的對象。一般簡單的對象或者扁平化的比較適合 jstat查看內存回收概況,實時查看各個分區的分配回收情況, jmap查看內存棧,查看內存中對象佔用大小, jstack查看線程棧,死鎖,性能瓶頸

    JVM七種垃圾收集器

    (1): Serial 收集器 複製算法,單線程,新生代)

    (2): ParNew 收集器(複製算法,多線程,新生代)

    (3): Parallel Scavenge 收集器(多線程,複製算法,新生代,高吞吐量)

    (4):Serial Old 收集器(標記-整理算法,老年代)

    (5):Parallel Old 收集器(標記-整理算法,老年代,注重吞吐量的場景下,jdk8默認採用 Parallel Scavenge + Parallel Old 的組合)

    (6):CMS 收集器(標記-清除算法,老年代,垃圾回收線程幾乎能做到與用戶線程同時工作,吞吐量低,內存碎片)以犧牲吞吐量為代價來獲得最短回收停頓時間-XX:+UseConcMarkSweepGC jdk1.8 默認垃圾收集器Parallel Scavenge(新生代)+Parallel Old(老年代) jdk1.9 默認垃圾收集器G1

    使用場景:

    (1):應用程序對停頓比較敏感

    (2):在JVM中,有相對較多存活時間較長的對象(老年代比較大)會更適合使用CMS

    cms垃圾回收過程:

    (1):初始標識<找到gcroot(stw)>

    GC Roots有以下幾種:

    1:系統類加載器加載的對象

    2:處於激活狀態的線程

    3:JNI棧中的對象

    4:正在被用於同步的各種鎖對象

    5:JVM自身持有的對象,比如系統類加載器等。

    (2):併發標記(三色標記算法) 三色標記算法處理併發標記出現對象引用變化情況: 黑:自己+子對象標記完成 灰:自己完成,子對象未完成 白:未標記; 併發標記 黑->灰->白 重新標記 灰->白引用消失,黑引用指向->白,導致白漏標 cms處理辦法是incremental update方案 (增量更新)把黑色變成灰色 多線程下併發標記依舊會產生漏標問題,所以cms必須remark一遍(jdk1.9以後不用cms了)

    G1 處理方案:

    SATB(snapshot at the begining)把白放入棧中,標記過程是和應用程序併發運行的(不需要Stop-The-World) 這種方式會造成某些是垃圾的對象也被當做是存活的,所以G1會使得佔用的內存被實際需要的內存大。不過下一次就回收了 ZGC 處理方案: 顏色指針(color pointers) 2*42方=4T

    (3):重新標記(stw)

    (4)併發清理

    備註:重新標記是防止標記成垃圾之後,對象被引用

    (5):G1 收集器(新生代 + 老年代,在多 CPU 和大內存的場景下有很好的性能) G1在java9 便是默認的垃圾收集器,是cms 的替代者 邏輯分代,用分區(region)的思想(默認分2048份) 還是有stw 為解決CMS算法產生空間碎片HotSpot提供垃圾收集器,通過-XX:+UseG1GC來啟用

    G1中提供了三種模式垃圾回收模式

    (1):young gc(eden region被耗盡無法申請內存時,就會觸發)

    (2):mixed gc(當老年代大小占整個堆大小百分比達到該閾值時,會觸發)

    (3):full gc(對象內存分配速度過快,mixed gc來不及回收,導致老年代被填滿,就會觸發)

    (8):ZGC和shenandoah (oracle產收費) no stw

    arthas 監控工具

    (1):dashboard命令查看總體jvm運行情況

    (2):jvm显示jvm詳細信息

    (3):thread 显示jvm裏面所有線程信息(類似於jstack) 查看死鎖線程命令thread -b

    (4):sc * 显示所有類(search class)

    (5):trace 跟蹤方法

    定位頻繁full GC,堆內存滿 oom

    第一步:jps獲取進程號 第二步:jmap -histo pid | head -20 得知有個對象在不斷創建 備註:jmap如果線上服務器堆內存特別大,,會卡死需堆轉存(一般會說在測試環境壓測,導出轉存) -XX:+HeapDumpOnOutOfMemoryError或jmap -dumpLformat=b,file=xxx pid 轉出文件進行分析 (arthas沒有實現jmap命令)heapdump –live /xxx/xx.hprof導出文件

    G1垃圾回收器(重點)

    回收過程 (1):young gc(年輕代回收)–當年輕代的Eden區用盡時–stw 第一階段,掃描根。 根是指static變量指向的對象,正在執行的方法調用鏈條上的局部變量等 第二階段,更新RS(Remembered Sets)。 處理dirty card queue中的card,更新RS。此階段完成后,RS可以準確的反映老年代對所在的內存分段中對象的引用 第三階段,處理RS。 識別被老年代對象指向的Eden中的對象,這些被指向的Eden中的對象被認為是存活的對象。 第四階段,複製對象。 此階段,對象樹被遍歷,Eden區內存段中存活的對象會被複制到Survivor區中空的內存分段 第五階段,處理引用。 處理Soft,Weak,Phantom,Final,JNI Weak 等引用。

    (2):concrruent marking(老年代併發標記) 當堆內存使用達到一定值(默認45%)時,不需要Stop-The-World,在併發標記前先進行一次young gc

    (3):混合回收(mixed gc) 併發標記過程結束以後,緊跟着就會開始混合回收過程。混合回收的意思是年輕代和老年代會同時被回收

    (4):Full GC? Full GC是指上述方式不能正常工作,G1會停止應用程序的執行,使用單線程的內存回收算法進行垃圾回收,性能會非常差,應用程序停頓時間會很長。要避免Full GC的發生,一旦發生需要進行調整。

    什麼時候發生Full GC呢?

    比如堆內存太小,當G1在複製存活對象的時候沒有空的內存分段可用,則會回退到full gc,這種情況可以通過增大內存解決

    儘管G1堆內存仍然是分代的,但是同一個代的內存不再採用連續的內存結構

    年輕代分為Eden和Survivor兩個區,老年代分為Old和Humongous兩個區

    新分配的對象會被分配到Eden區的內存分段上

    Humongous區用於保存大對象,如果一個對象佔用的空間超過內存分段Region的一半;

    如果對象的大小超過一個甚至幾個分段的大小,則對象會分配在物理連續的多個Humongous分段上。

    Humongous對象因為佔用內存較大並且連續會被優先回收

    為了在回收單個內存分段的時候不必對整個堆內存的對象進行掃描(單個內存分段中的對象可能被其他內存分段中的對象引用)引入了RS數據結構。RS使得G1可以在年輕代回收的時候不必去掃描老年代的對象,從而提高了性能。每一個內存分段都對應一個RS,RS保存了來自其他分段內的對象對於此分段的引用

    JVM會對應用程序的每一個引用賦值語句object.field=object進行記錄和處理,把引用關係更新到RS中。但是這個RS的更新並不是實時的。G1維護了一個Dirty Card Queue

    那為什麼不在引用賦值語句處直接更新RS呢?

    這是為了性能的需要,使用隊列性能會好很多。

    線程本地分配緩衝區(TLAB: Thread Local Allocation Buffer)?

    棧上分配->tlab->堆上分配 由於堆內存是應用程序共享的,應用程序的多個線程在分配內存的時候需要加鎖以進行同步。為了避免加鎖,提高性能每一個應用程序的線程會被分配一個TLAB。TLAB中的內存來自於G1年輕代中的內存分段。當對象不是Humongous對象,TLAB也能裝的下的時候,對象會被優先分配於創建此對象的線程的TLAB中。這樣分配會很快,因為TLAB隸屬於線程,所以不需要加鎖

    PLAB: Promotion Thread Local Allocation Buffer

    G1會在年輕代回收過程中把Eden區中的對象複製(“提升”)到Survivor區中,Survivor區中的對象複製到Old區中。G1的回收過程是多線程執行的,為了避免多個線程往同一個內存分段進行複製,那麼複製的過程也需要加鎖。為了避免加鎖,G1的每個線程都關聯了一個PLAB,這樣就不需要進行加鎖了

    OOM問題定位方法

    (1):jmap -heap 10765如上圖,可以查看新生代,老生代堆內存的分配大小以及使用情況;

    (2):jstat 查看GC收集情況

    (3):jmap -dump:live,format=b,file=到本地

    (4):通過MAT工具打開分析

    DUBBO

    dubbo流程

    (1):生產者(Provider)啟動,向註冊中心(Register)註冊

    (2):消費者(Consumer)訂閱,而後註冊中心通知消費者

    (3):消費者從生產者進行消費

    (4):監控中心(Monitor)統計生產者和消費者

    Dubbo推薦使用什麼序列化框架,還有哪些?

    推薦使用Hessian序列化,還有Duddo、FastJson、Java自帶序列化

    Dubbo默認使用的是什麼通信框架,還有哪些?

    默認使用 Netty 框架,也是推薦的選擇,另外內容還集成有Mina、Grizzly。

    Dubbo有哪幾種負載均衡策略,默認是哪種?

    (1):隨機調用<默認>

    (2):權重輪詢

    (3):最少活躍數

    (4):一致性Hash

    RPC流程

    (1)消費者調用需要消費的服務,

    (2):客戶端存根將方法、入參等信息序列化發送給服務端存根

    (3):服務端存根反序列化操作根據解碼結果調用本地的服務進行相關處理

    (4):本地服務執行具體業務邏輯並將處理結果返回給服務端存根

    (5):服務端存根序列化

    (6):客戶端存根反序列化

    (7):服務消費方得到最終結果

    RPC框架的實現目標PC框架的實現目標是把調用、編碼/解碼的過程給封裝起來,讓用戶感覺上像調用本地服務一樣的調用遠程服務

    服務暴露、服務引用、服務調用(TODO)

    Redis

    redis單線程為什麼執行速度這麼快?

    (1):純內存操作,避免大量訪問數據庫,減少直接讀取磁盤數據,redis將數據儲存在內存裏面,讀寫數據的時候都不會受到硬盤 I/O 速度的限制,所以速度快

    (2):單線程操作,避免了不必要的上下文切換和競爭條件,也不存在多進程或者多線程導致的切換而消耗CPU,不用去考慮各種鎖的問題,不存在加鎖釋放鎖操作,沒有因為可能出現死鎖而導致的性能消耗

    (3):採用了非阻塞I/O多路復用機制

    Redis數據結構底層實現

    String:

    (1)Simple dynamic string(SDS)的數據結構

    struct sdshdr{
     //記錄buf數組中已使用字節的數量
     //等於 SDS 保存字符串的長度
     int len;
     //記錄 buf 數組中未使用字節的數量
     int free;
     //字節數組,用於保存字符串
     char buf[];
    }

    它的優點: (1)不會出現字符串變更造成的內存溢出問題

    (2)獲取字符串長度時間複雜度為1

    (3)空間預分配, 惰性空間釋放free字段,會默認留夠一定的空間防止多次重分配內存

    應用場景: String 緩存結構體用戶信息,計數

    Hash:

    數組+鏈表的基礎上,進行了一些rehash優化; 1.Reids的Hash採用鏈地址法來處理衝突,然後它沒有使用紅黑樹優化。

    2.哈希表節點採用單鏈表結構。

    3.rehash優化 (採用分而治之的思想,將龐大的遷移工作量劃分到每一次CURD中,避免了服務繁忙)

    應用場景: 保存結構體信息可部分獲取不用序列化所有字段

    List:

    應用場景: (1):比如twitter的關注列表,粉絲列表等都可以用Redis的list結構來實現

    (2):list的實現為一個雙向鏈表,即可以支持反向查找和遍歷

    Set:

    內部實現是一個 value為null的HashMap,實際就是通過計算hash的方式來快速排重的,這也是set能提供判斷一個成員 是否在集合內的原因。 應用場景: 去重的場景,交集(sinter)、並集(sunion)、差集(sdiff),實現如共同關注、共同喜好、二度好友等功能

    Zset:

    內部使用HashMap和跳躍表(SkipList)來保證數據的存儲和有序,HashMap里放的是成員到score的映射,而跳躍表裡存放的是所有的成員,排序依據是HashMap里存的score,使用跳躍表的結構可以獲得比較高的查找效率,並且在實現上比較簡單。 跳錶:每個節點中維持多個指向其他節點的指針,從而達到快速訪問節點的目的 應用場景: 實現延時隊列

    redis事務

    (1):Multi開啟事務

    (2):Exec執行事務塊內命令

    (3):Discard 取消事務

    (4):Watch 監視一個或多個key,如果事務執行前key被改動,事務將打斷

    redis事務的實現特徵

    (1):所有命令都將會被串行化的順序執行,事務執行期間,Redis不會再為其它客戶端的請求提供任何服務,從而保證了事物中的所有命令被原子的執行

    (2):Redis事務中如果有某一條命令執行失敗,其後的命令仍然會被繼續執行

    (3):在事務開啟之前,如果客戶端與服務器之間出現通訊故障並導致網絡斷開,其後所有待執行的語句都將不會被服務器執行。然而如果網絡中斷事件是發生在客戶端執行EXEC命令之後,那麼該事務中的所有命令都會被服務器執行

    (4):當使用Append-Only模式時,Redis會通過調用系統函數write將該事務內的所有寫操作在本次調用中全部寫入磁盤。

    然而如果在寫入的過程中出現系統崩潰,如電源故障導致的宕機,那麼此時也許只有部分數據被寫入到磁盤,而另外一部分數據卻已經丟失。

    Redis服務器會在重新啟動時執行一系列必要的一致性檢測,一旦發現類似問題,就會立即退出並給出相應的錯誤提示。此時,我們就要充分利用Redis工具包中提供的redis-check-aof工具,該工具可以幫助我們定位到數據不一致的錯誤,並將已經寫入的部分數據進行回滾。修復之後我們就可以再次重新啟動Redis服務器了

    Redis的同步機制?

    (1):全量拷貝, 1.slave第一次啟動時,連接Master,發送PSYNC命令,

    2.master會執行bgsave命令來生成rdb文件,期間的所有寫命令將被寫入緩衝區。

    1. master bgsave執行完畢,向slave發送rdb文件

    2. slave收到rdb文件,丟棄所有舊數據,開始載入rdb文件

    3. rdb文件同步結束之後,slave執行從master緩衝區發送過來的所以寫命令。

    4. 此後 master 每執行一個寫命令,就向slave發送相同的寫命令。

      (2):增量拷貝 如果出現網絡閃斷或者命令丟失等異常情況,從節點之前保存了自身已複製的偏移量和主節點的運行ID

    5. 主節點根據偏移量把複製積壓緩衝區里的數據發送給從節點,保證主從複製進入正常狀態。

      redis集群模式性能優化

      (1) Master最好不要做任何持久化工作,如RDB內存快照和AOF日誌文件

      (2) 如果數據比較重要,某個Slave開啟AOF備份數據,策略設置為每秒同步一次

      (3) 為了主從複製的速度和連接的穩定性,Master和Slave最好在同一個局域網內

      (4) 盡量避免在壓力很大的主庫上增加從庫

      (5) 主從複製不要用圖狀結構,用單向鏈表結構更為穩定,即:Master <- Slave1 <- Slave2 <- Slave3…這樣的結構方便解決單點故障問題,實現Slave對Master的替換。如果Master掛了,可以立刻啟用Slave1做Master,其他不變。

      Redis集群方案

      (1):官方cluster方案

      (2):twemproxy

      代理方案twemproxy是一個單點,很容易對其造成很大的壓力,所以通常會結合keepalived來實twemproy的高可用

      (3):codis 基於客戶端來進行分片

    集群不可用場景

    (1):master掛掉,且當前master沒有slave

    (2):集群超過半數以上master掛掉,無論是否有slave集群進入fail狀態

    redis 最適合的場景

    (1):會話緩存session cache

    (2):排行榜/計數器ZRANGE

    (3):發布/訂閱

    緩存淘汰策略

    (1):先進先出算法(FIFO)

    (2):最近使用最少Least Frequently Used(LFU)

    (3):最長時間未被使用的Least Recently Used(LRU)

    當存在熱點數據時,LRU的效率很好,但偶發性的、周期性的批量操作會導致LRU命中率急劇下降,緩存污染情況比較嚴重

    redis過期key刪除策略

    (1):惰性刪除,cpu友好,但是浪費cpu資源

    (2):定時刪除(不常用)

    (3):定期刪除,cpu友好,節省空間

    緩存雪崩以及處理辦法

    同一時刻大量緩存失效;

    處理方法:

    (1):緩存數據增加過期標記

    (2):設置不同的緩存失效時間

    (3):雙層緩存策略C1為短期,C2為長期

    (4):定時更新策略

    緩存擊穿原因以及處理辦法

    頻繁請求查詢系統中不存在的數據導致;

    處理方法:

    (1):cache null策略,查詢反饋結果為null仍然緩存這個null結果,設置不超過5分鐘過期時間

    (2):布隆過濾器,所有可能存在的數據映射到足夠大的bitmap中 google布隆過濾器:基於內存,重啟失效不支持大數據量,無法在分佈式場景 redis布隆過濾器:可擴展性,不存在重啟失效問題,需要網絡io,性能低於google

    redis阻塞原因

    (1):數據結構使用不合理bigkey

    (2):CPU飽和

    (3):持久化阻塞,rdb fork子線程,aof每秒刷盤等

    hot key出現造成集群訪問量傾斜解決辦法

    (1):使用本地緩存

    (2): 利用分片算法的特性,對key進行打散處理(給hot key加上前綴或者後綴,把一個hotkey 的數量變成 redis 實例個數N的倍數M,從而由訪問一個 redis key 變成訪問 N * M 個redis key)

    Redis分佈式鎖

    2.6版本以後lua腳本保證setnx跟setex進行原子性(setnx之後,未setex,服務掛了,鎖不釋放) a獲取鎖,超過過期時間,自動釋放鎖,b獲取到鎖執行,a代碼執行完remove鎖,a和b是一樣的key,導致a釋放了b的鎖。 解決辦法:remove之前判斷value(高併發下value可能被修改,應該用lua來保證原子性)

    Redis如何做持久化

    bgsave做鏡像全量持久化,aof做增量持久化。因為bgsave會耗費較長時間,不夠實時,在停機的時候會導致大量丟失數據 ,所以需要aof來配合使用。在redis實例重啟時,會使用bgsave持久化文件重新構建內存,再使用aof重放近期的操作指令來 實 現完整恢復重啟之前的狀態。

    對方追問那如果突然機器掉電會怎樣?

    取決於aof日誌sync屬性的配置,如果不要求性能,在每條寫指令時都sync一下磁盤,就不會丟失數據。但是在高性能的要求下每次都sync是不現實的,一般都使用定時sync,比如1s1次,這個時候最多就會丟失1s的數據.

    redis鎖續租問題?

    (1):基於redis的redission分佈式可重入鎖RLock,以及配合java集合中lock;

    (2):Redission 內部提供了一個監控鎖的看門狗,不斷延長鎖的有效期,默認檢查鎖的超時時間是30秒

    (3):此方案的問題:如果你對某個redis master實例,寫入了myLock這種鎖key的value,此時會異步複製給對應的master ,slave實例。但是這個過程中一旦發生redis master宕機,主備切換,redis slave變為了redis master。

    接着就會導致,客戶端2來嘗試加鎖的時候,在新的redis master上完成了加鎖,而客戶端1也以為自己成功加了鎖。 此時就會導致多個客戶端對一個分佈式鎖完成了加鎖 解決辦法:只需要將新的redis實例,在一個TTL時間內,對客戶端不可用即可,在這個時間內,所有客戶端鎖將被失效或者自動釋放.

    bgsave的原理是什麼?

    fork和cow。fork是指redis通過創建子進程來進行bgsave操作,cow指的是copy on write,子進程創建后,父子進程共享數據段,父進程繼續提供讀寫服務,寫進的頁面數據會逐漸和子進程分離開來。

    RDB與AOF區別

    (1):R文件格式緊湊,方便數據恢復,保存rdb文件時父進程會fork齣子進程由其完成具體持久化工作,最大化redis性能,恢復大數據集速度更快,只有手動提交save命令或關閉命令時才觸發備份操作;

    (2):A記錄對服務器的每次寫操作(默認1s寫入一次),保存數據更完整,在redis重啟是會重放這些命令來恢複數據,操作效率高,故障丟失數據更少,但是文件體積更大;

    1億個key,其中有10w個key是以某個固定的已知的前綴開頭的,如果將它們全部找出來?

    使用keys指令可以掃出指定模式的key列表。 如果這個redis正在給線上的業務提供服務,那使用keys指令會有什麼問題? redis的單線程的。keys指令會導致線程阻塞一段時間,線上服務會停頓,直到指令執行完畢,服務才能恢復。這個時候可以使用scan指令,scan指令可以無阻塞的提取出指定模式的key列表,但是會有一定的重複概率,在客戶端做一次去重就可以了 ,但是整體所花費的時間會比直接用keys指令長。

    如何使用Redis做異步隊列?

    一般使用list結構作為隊列,rpush生產消息,lpop消費消息。當lpop沒有消息的時候,要適當sleep一會再重試。

    可不可以不用sleep呢?

    list還有個指令叫blpop,在沒有消息的時候,它會阻塞住直到消息到來。

    能不能生產一次消費多次呢?

    使用pub/sub主題訂閱者模式,可以實現1:N的消息隊列。

    pub/sub有什麼缺點?

    在消費者下線的情況下,生產的消息會丟失,得使用專業的消息隊列如rabbitmq等。

    redis如何實現延時隊列?

    使用sortedset,想要執行時間的時間戳作為score,消息內容作為key調用zadd來生產消息,消費者用zrangebyscore指令獲取N秒之前的數據輪詢進行處理。

    為啥redis zset使用跳躍鏈表而不用紅黑樹實現?

    (1):skiplist的複雜度和紅黑樹一樣,而且實現起來更簡單。

    (2):在併發環境下紅黑樹在插入和刪除時需要rebalance,性能不如跳錶。

    MYSQL

    數據庫三範式

    一: 確保每列的原子性

    二:非主鍵列不存在對主鍵的部分依賴 (要求每個表只描述一件事情)

    三: 滿足第二範式,並且表中的列不存在對非主鍵列的傳遞依賴

    數據庫主從複製原理

    (1):主庫db的更新事件(update、insert、delete)被寫到binlog

    (2):主庫創建一個binlog dump thread線程,把binlog的內容發送到從庫

    (3):從庫創建一個I/O線程,讀取主庫傳過來的binlog內容並寫入到relay log.

    (4):從庫還會創建一個SQL線程,從relay log裏面讀取內容寫入到slave的db.

    複製方式分類

    (1):異步複製(默認) 主庫寫入binlog日誌后即可成功返回客戶端,無須等待binlog日誌傳遞給從庫的過程,但是一旦主庫宕機,就有可能出現丟失數據的情況。

    (2)半同步複製:( 5.5版本之後) (安裝半同步複製插件)確保從庫接收完成主庫傳遞過來的binlog內容已經寫入到自己的relay log(傳送log)后才會通知主庫上面的等待線程。如果等待超時,則關閉半同步複製,並自動轉換為異步複製模式,直到至少有一台從庫通知主庫已經接收到binlog信息為止

    存儲引擎

    (1):Myiasm是mysql默認的存儲引擎,不支持數據庫事務,行級鎖,外鍵;插入更新需鎖表,效率低,查詢速度快,Myisam使用的是非聚集索引

    (2):innodb 支持事務,底層為B+樹實現,適合處理多重併發更新操作,普通select都是快照讀,快照讀不加鎖。InnoDb使用的是聚集索引

    聚集索引

    (1):聚集索引就是以主鍵創建的索引

    (2):每個表只能有一個聚簇索引,因為一個表中的記錄只能以一種物理順序存放,實際的數據頁只能按照一顆 B+ 樹進行排序

    (3):表記錄的排列順序和與索引的排列順序一致

    (4):聚集索引存儲記錄是物理上連續存在

    (5):聚簇索引主鍵的插入速度要比非聚簇索引主鍵的插入速度慢很多

    (6):聚簇索引適合排序,非聚簇索引不適合用在排序的場合,因為聚簇索引恭弘=叶 恭弘節點本身就是索引和數據按相同順序放置在一起,索引序即是數據序,數據序即是索引序,所以很快。非聚簇索引恭弘=叶 恭弘節點是保留了一個指向數據的指針,索引本身當然是排序的,但是數據並未排序,數據查詢的時候需要消耗額外更多的I/O,所以較慢

    (7):更新聚集索引列的代價很高,因為會強制innodb將每個被更新的行移動到新的位置

    非聚集索引

    (1):除了主鍵以外的索引

    (2):聚集索引的恭弘=叶 恭弘節點就是數據節點,而非聚簇索引的恭弘=叶 恭弘節點仍然是索引節點,並保留一個鏈接指向對應數據塊

    (3):聚簇索引適合排序,非聚簇索引不適合用在排序的場合

    (4):聚集索引存儲記錄是物理上連續存在,非聚集索引是邏輯上的連續。

    使用聚集索引為什麼查詢速度會變快?

    使用聚簇索引找到包含第一個值的行后,便可以確保包含後續索引值的行在物理相鄰

    建立聚集索引有什麼需要注意的地方嗎?

    在聚簇索引中不要包含經常修改的列,因為碼值修改后,數據行必須移動到新的位置,索引此時會重排,會造成很大的資源浪費

    InnoDB 表對主鍵生成策略是什麼樣的?

    優先使用用戶自定義主鍵作為主鍵,如果用戶沒有定義主鍵,則選取一個Unique鍵作為主鍵,如果表中連Unique鍵都沒有定義的話,則InnoDB會為表默認添加一個名為row_id隱藏列作為主鍵。

    非聚集索引最多可以有多少個?

    每個表你最多可以建立249個非聚簇索引。非聚簇索引需要大量的硬盤空間和內存

    BTree 與 Hash 索引有什麼區別?

    (1):BTree索引可能需要多次運用折半查找來找到對應的數據塊 (2):HASH索引是通過HASH函數,計算出HASH值,在表中找出對應的數據 (3):大量不同數據等值精確查詢,HASH索引效率通常比B+TREE高 (4):HASH索引不支持模糊查詢、範圍查詢和聯合索引中的最左匹配規則,而這些Btree索引都支持

    數據庫索引優缺點

    (1):需要查詢,排序,分組和聯合操作的字段適合建立索引

    (2):索引多,數據更新表越慢,盡量使用字段值不重複比例大的字段作為索引,聯合索引比多個獨立索引效率高

    (3):對數據進行頻繁查詢進建立索引,如果要頻繁更改數據不建議使用索引

    (4):當對表中的數據進行增加、刪除和修改的時候,索引也要動態的維護,降低了數據的維護速度。

    索引的底層實現是B+樹,為何不採用紅黑樹,B樹?

    (1):B+Tree非恭弘=叶 恭弘子節點只存儲鍵值信息,降低B+Tree的高度,所有恭弘=叶 恭弘子節點之間都有一個鏈指針,數據記錄都存放在恭弘=叶 恭弘子節點中

    (2): 紅黑樹這種結構,h明顯要深的多,效率明顯比B-Tree差很多

    (3):B+樹也存在劣勢,由於鍵會重複出現,因此會佔用更多的空間。但是與帶來的性能優勢相比,空間劣勢往往可以接受,因此B+樹的在數據庫中的使用比B樹更加廣泛

    索引失效條件

    (1):條件是or,如果還想讓or條件生效,給or每個字段加個索引

    (2):like開頭%

    (3):如果列類型是字符串,那一定要在條件中將數據使用引號引用起來,否則不會使用索引

    (4):where中索引列使用了函數或有運算

    數據庫事務特點

    ACID 原子性,一致性,隔離性,永久性

    數據庫事務說是如何實現的?

    (1):通過預寫日誌方式實現的,redo和undo機制是數據庫實現事務的基礎

    (2):redo日誌用來在斷電/數據庫崩潰等狀況發生時重演一次刷數據的過程,把redo日誌里的數據刷到數據庫里,保證了事務 的持久性(Durability)

    (3):undo日誌是在事務執行失敗的時候撤銷對數據庫的操作,保證了事務的原子性

    數據庫事務隔離級別

    (1):讀未提交read-uncommitted– 臟,不可重複讀–幻讀 A讀取了B未提交的事務,B回滾,A 出現臟讀;

    (2):不可重複讀read-committed– 不可重複讀–幻讀 A只能讀B已提交的事務,但是A還沒結束,B又更新數據隱式提交,然後A又讀了一次出現不可重複讀;

    (3):可重複讀repeatable-read<默認>– 幻讀 事務開啟,不允許其他事務的UPDATE修改操作 A讀取B已提交的事務,然而B在該表插入新的行,之後A在讀取的時候多出一行,出現幻讀;

    (4):串行化serializable–

    七種事務傳播行為

    (1)Propagation.REQUIRED<默認> 如果當前存在事務,則加入該事務,如果當前不存在事務,則創建一個新的事務。

    (2)Propagation.SUPPORTS 如果當前存在事務,則加入該事務;如果當前不存在事務,則以非事務的方式繼續運行。

    (3)Propagation.MANDATORY 如果當前存在事務,則加入該事務;如果當前不存在事務,則拋出異常。

    (4)Propagation.REQUIRES_NEW 重新創建一個新的事務,如果當前存在事務,延緩當前的事務。

    (5)Propagation.NOT_SUPPORTED 以非事務的方式運行,如果當前存在事務,暫停當前的事務。

    (6)Propagation.NEVER 以非事務的方式運行,如果當前存在事務,則拋出異常。

    (7)Propagation.NESTED 如果沒有,就新建一個事務;如果有,就在當前事務中嵌套其他事務。

    產生死鎖的四個必要條件

    (1):互斥: 資源x的任意一個時刻只能被一個線程持有 (2):佔有且等待:線程1佔有資源x的同時等待資源y,並不釋放x (3):不可搶佔:資源x一旦被線程1佔有,其他線程不能搶佔x (4):循環等待:線程1持有x,等待y,線程2持有y,等待x 當全部滿足時才會死鎖

    @Transaction

    底層實現是AOP,動態代理 (1):實現是通過Spring代理來實現的。生成當前類的代理類,調用代理類的invoke()方法,在invoke()方法中調用 TransactionInterceptor攔截器的invoke()方法;

    (2):非public方式其事務是失效的;

    (3):自調用也會失效,因為動態代理機制導致

    (4)多個方法外層加入try…catch,解決辦法是可以在catch里 throw new RuntimeException()來處理

    分佈式事務

    XA方案

    有一個事務管理器的概念,負責協調多個數據庫(資源管理器)的事務 不適合高併發場景,嚴重依賴數據庫層面,同步阻塞問題;協調者故障則所有參与者會阻塞

    TCC方案

    嚴重依賴代碼補償和回滾,一般銀行用,和錢相關的支付、交易等相關的場景,我們會用TCC Try,對各個服務的資源做檢測,對資源進行鎖定或者預留 Confirm,在各個服務中執行實際的操作 Cancel,如果任何一個服務的業務方法執行出錯,那麼這裏就需要進行補償,即執行已操作成功的業務邏輯的回滾操作

    可靠消息最終一致性方案

    1):本地消息服務 本地消息表其實是國外的 ebay 搞出來的這麼一套思想。 主動方是認證服務,有個消息異常處理系統,mq,還有消息消費端應用系統,還有採集服務;

    • 在我認證返回數據中如果有發票是已經認證的,在處理認證數據的操作與發送消息在同一個本地事務中,業務執行完,消息數據也同時存在一條待確認的數據;
    • 發送消息給mq,,mq發送消息給消息消費端服務,同時存一份消息數據,然後發送給採集服務,進行抵賬表更新操作;
    • 採集服務邏輯處理完以後反饋給消息消費端服務,其服務刪除消息數據,同時通知認證服務,把消息記錄改為已確認成功費狀態;
    • 對於異常流程,消息異常處理系統會查詢認證服務中過期未確認的消息發送給mq,相當於重試

    2):獨立消息最終一致性方案: A 主動方應用系統,B消息服務子系統,C消息狀態確認子系統,C2消息管理子系統 D 消息恢復子系統,mq ,消息消費端E ,被動系統F

     流程:
    A預發送消息給B,然後執行A業務邏輯,B存儲預發送消息,A執行完業務邏輯發送業務操作結果給B,B更新預發送消息為確認併發送消息狀態同時發送消息給mq,然後被E監聽然後發送給F消費掉
    C:對預發送消息異常的處理,去查詢待確認狀態超時的消息,去A中查詢進行數據處理,如果A中業務處理成功了,那麼C需改消息狀態為確認併發送狀態,然後發送消息給mq;如果A中業務處理失敗了..那麼C直接把消息刪除即可.
    C2 : 查詢消息的頁面,對消息的可視化,以及批量處理死亡消息;
    D: B給mq放入數據如果失敗,,通過D去重試,多次重試失敗,消息設置為死亡 
    E:確保F執行完成,發送消息給B刪除消息
    優化建議: 
     (1)數據庫:如果用redis,持久化要配置成appendfsync always,確保每次新添加消息都能持久化進磁盤
     (2)在被動方應用業務冪等性判斷比較麻煩或者比較耗性能情況下,增加消息日誌記錄表.用於判斷之前有無發送過;

    最大努力通知性(定期校對)

    (1)業務主動方完成業務處理之後,設置時間階梯型通知規則向業務活動的被動方發送消息,允許消息丟失.

    (2)被動方根據定時策略,向主動方查詢,恢復丟失的業務消息

    (3)被動方的處理結果不影響主動方的處理結果

    (4)需增加業務查詢,通知服務,校對系統服務的建設成本

    (5)適用於對業務最終一致性的時間敏感度低,跨企業的業務通知活動

    (6)比如銀行通知,商戶通知,交易業務平台間商戶通知,多次通知,查詢校對等

    Seata(阿里)

    應用層基於SQL解析實現了自動補償,從而最大程度的降低業務侵入性; 將分佈式事務中TC(事務協調者)獨立部署,負責事務的註冊、回滾; 通過全局鎖實現了寫隔離與讀隔離。

    網絡

    TCP和UDP的比較

    TCP向上層提供面向連接的可靠服務 ,UDP向上層提供無連接不可靠服務。 雖然 UDP 並沒有 TCP 傳輸來的準確,但是也能在很多實時性要求高的地方有所作為 對數據準確性要求高,速度可以相對較慢的,可以選用TCP

    TCP三次握手

    TCP四次揮手

    (1):客戶端發送終止命令FIN

    (2):服務端收到后回復ACK,處於close_wait狀態

    (3):服務器將關閉前需要發送信息發送給客戶端后處於last_ack狀態

    (4):客戶端收到FIN后發送ack后處於tim-wait而後進入close狀態

    為什麼要進行第三次握手

    為了防止服務器端開啟一些無用的連接增加服務器開銷以及防止已失效的連接請求報文段突然又傳送到了服務端

    JDK1.8新特性

    Lambda表達式

    java也開始承認了函數式編程, 就是說函數既可以作為參數,也可以作為返回值, 大大的簡化了代碼的開發

    default關鍵字

    打破接口裡面是只能有抽象方法,不能有任何方法的實現,接口裡面也可以有方法的實現了

    新時間日期APILocalDate | LocalTime | LocalDateTime

    之前使用的java.util.Date月份從0開始,我們一般會+1使用,很不方便,java.time.LocalDate月份和星期都改成了enum java.util.Date和SimpleDateFormat都不是線程安全的,而LocalDate和LocalTime和最基本的String一樣,是不變類型,不但線程安全,而且不能修改。 新接口更好用的原因是考慮到了日期時間的操作,經常發生往前推或往後推幾天的情況。用java.util.Date配合Calendar要寫好多代碼,而且一般的開發人員還不一定能寫對。

    JDK1.7與JDK1.8 ConcurrentHashMap對比

    (1):JDK1.7版本的ReentrantLock+Segment+HashEntry(數組)

    (2):JDK1.7採用segment的分段鎖機制實現線程安全

    (3):JDK1.8版本中synchronized+CAS+HashEntry(數組)+紅黑樹

    (4):JDK1.8採用CAS+Synchronized保證線程安全

    (5):查詢時間複雜度從原來的遍歷鏈表O(n),變成遍歷紅黑樹O(logN)

    1.8 HashMap數組+鏈表+紅黑樹來實現hashmap,當碰撞的元素個數大於8時 & 總容量大於64,會有紅黑樹的引入 除了添加之後,效率都比鏈表高,1.8之後鏈表新進元素加到末尾

    JDK1.8使用synchronized來代替重入鎖ReentrantLock?

    (1):因為粒度降低了,在相對而言的低粒度加鎖方式,synchronized並不比ReentrantLock差

    (2):基於JVM的synchronized優化空間更大

    (3):在大數據量下,基於API的ReentrantLock會比基於JVM的內存壓力開銷更多的內存

    JDK1.9新特性

    模塊系統:

    模塊是一個包的容器,Java 9 最大的變化之一是引入了模塊系統(Jigsaw 項目)。

    集合工廠方法

    通常,您希望在代碼中創建一個集合(例如,List 或 Set ),並直接用一些元素填充它。 實例化集合,幾個 “add” 調用,使得代碼重複。 Java 9,添加了幾種集合工廠方法:

    Set<Integer> ints = Set.of(1, 2, 3);
    List<String> strings = List.of("first", "second");

    改進的 Stream API

    Stream 接口中添加了 4 個新的方法:dropWhile, takeWhile, ofNullable。還有個 iterate 方法的新重載方法

    改進的 Javadoc:

    Javadoc 現在支持在 API 文檔中的進行搜索。另外,Javadoc 的輸出現在符合兼容 HTML5 標準。

    redis代理集群模式,spring有哪些註解,b+b 紅黑樹區別,三次握手,valitile重排序底層代碼, cas 事務的4個特性,java8 java11 特性, filter和interceptor的區別 @autowired原理, dispatcherservlet,分佈式事務解決方案spring都有哪些模塊,fork join隊列,排序算法,

    集合

    java的集合框架有哪幾種:

    兩種:collection和map,其中collection分為set和List。

    List你使用過哪些

    ArrayList和linkedList使用的最多,也最具代表性。

    你知道vector和ArrayList和linkedList的區別嘛

    ArrayList實現是一個數組,可變數組,默認初始化長度為10,也可以我們設置容量,但是沒有設置的時候是默認的空數組,只有在第一步add的時候會進行擴容至10(重新創建了數組),後續擴容按照3/2的大小進行擴容,是線程不安全的,適用多讀取,少插入的情況

    linkedList是基於雙向鏈表的實現,使用了尾插法的方式,內部維護了鏈表的長度,以及頭節點和尾節點,所以獲取長度不需要遍歷。適合一些插入/刪除頻繁的情況。

    Vector是線程安全的,實現方式和ArrayList相似,也是基於數組,但是方法上面都有synchronized關鍵詞修飾。其擴容方式是原來的兩倍。

    hashMap和hashTable和ConcurrentHashMap的區別

    hashMap是map類型的一種最常用的數據結構,其底部實現是數組+鏈表(在1.8版本后變為了數組+鏈表/紅黑樹的方式),其key是可以為null的,默認hash值為0。擴容以2的冪等次(為什麼。。。因為只有是2的冪等次的時候(n-1)&x==x%n,當然不一定只有一個原因)。是線程不安全的

    hashTable的實現形式和hashMap差不多,它是線程安全的,是繼承了Dictionary,也是key-value的模式,但是其key不能為null。

    ConcurrentHashMap是JUC併發包的一種,在hashMap的基礎上做了修改,因為hashmap其實是線程不安全的,那在併發情況下使用hashTable嘛,但是hashTable是全程加鎖的,性能不好,所以採用分段的思想,把原本的一個數組分成默認16段,就可以最多容納16個線程併發操作,16個段叫做Segment,是基於ReetrantLock來實現的

    說說你了解的hashmap吧

    hashMap是Map的結構,內部用了數組+鏈表的方式,在1.8后,當鏈表長度達到8的時候,會變成紅黑樹,這樣子就可以把查詢的複雜度變成O(nlogn)了,默認負載因子是0.75,為什麼是0.75呢?

    我們知道當負載因子太小,就很容易觸發擴容,如果負載因子太大就容易出現碰撞。所以這個是空間和時間的一個均衡點,在1.8的hashmap介紹中,就有描述了,貌似是0.75的負載因子中,能讓隨機hash更加滿足0.5的泊松分佈。

    除此之外,1.7的時候是頭插法,1.8后就變成了尾插法,主要是為了解決rehash出現的死循環問題,而且1.7的時候是先擴容后插入,1.8則是先插入后擴容(為什麼?正常來說,如果先插入,就有可能節點變為樹化,那麼是不是多做一次樹轉化,比1.7要多損耗,個人猜測,因為讀寫問題,因為hashmap並不是線程安全的,如果說是先擴容,后寫入,那麼在擴容期間,是訪問不到新放入的值的,是不是不太合適,所以會先放入值,這樣子在擴容期間,那個值是在的)。

    1.7版本的時候用了9次擾動,5次異或,4次位移,減少hash衝突,但是1.8就只用了兩次,覺得就足夠了一次異或,一次位移。

    concurrentHashMap呢

    concurrentHashMap是線程安全的map結構,它的核心思想是分段鎖。在1.7版本的時候,內部維護了segment數組,默認是16個,segment中有一個table數組(相當於一個segmeng存放着一個hashmap。。。),segment繼承了reentrantlock,使用了互斥鎖,map的size其實就是segment數組的count和。而在1.8的時候做了一個大改版,廢除了segment,採用了cas加synchronize方式來進行分段鎖(還有自旋鎖的保證),而且節點對象改用了Node不是之前的HashEntity。

    Node可以支持鏈表和紅黑樹的轉化,比如TreeBin就是繼承了Node,這樣子可以直接用instanceof來區分。1.8的put就很複雜來,會先計算出hash值,然後根據hash值選出Node數組的下標(默認數組是空的,所以一開始put的時候會初始化,指定負載因子是0.75,不可變),判斷是否為空,如果為空,則用cas的操作來賦值首節點,如果失敗,則因為自旋,會進入非空節點的邏輯,這個時候會用synchronize加鎖頭節點(保證整條鏈路鎖定)這個時候還會進行二次判斷,是否是同一個首節點,在分首節點到底是鏈表還是樹結構,進行遍歷判斷。

    concurrentHashMap的擴容方式

    1.7版本的concurrentHashMap是基於了segment的,segment內部維護了HashEntity數組,所以擴容是在這個基礎上的,類比hashmap的擴容,

    1.8版本的concurrentHashMap擴容方式比較複雜,利用了ForwardingNode,先會根據機器內核數來分配每個線程能分到的busket數,(最小是16),這樣子可以做到多線程協助遷移,提升速度。然後根據自己分配的busket數來進行節點轉移,如果為空,就放置ForwardingNode,代表已經遷移完成,如果是非空節點(判斷是不是ForwardingNode,是就結束了),加鎖,鏈路循環,進行遷移。

    hashMap的put方法的過程

    判斷key是否是null,如果是null對應的hash值就是0,獲得hash值過後則進行擾動,(1.7是9次,5次異或,4次位移,1.8是2次),獲取到的新hash值找出所在的index,(n-1)&hash,根據下標找到對應的Node/entity,然後遍歷鏈表/紅黑樹,如果遇到hash值相同且equals相同,則覆蓋值,如果不是則新增。如果節點數大於8了,則進行樹化(1.8)。完成后,判斷當前的長度是否大於閥值,是就擴容(1.7是先擴容在put)。

    為什麼修改hashcode方法要修改equals

    都是map惹的禍,我們知道在map中判斷是否是同一個對象的時候,會先判斷hash值,在判斷equals的,如果我們只是重寫了hashcode,沒有順便修改equals,比如Intger,hashcode就是value值,如果我們不改寫equals,而是用了Object的equals,那麼就是判斷兩者指針是否一致了,那就會出現valueOf和new出來的對象會對於map而言是兩個對象,那就是個問題了

    TreeMap了解嘛

    TreeMap是Map中的一種很特殊的map,我們知道Map基本是無序的,但是TreeMap是會自動進行排序的,也就是一個有序Map(使用了紅黑樹來實現),如果設置了Comparator比較器,則會根據比較器來對比兩者的大小,如果沒有則key需要是Comparable的子類(代碼中沒有事先check,會直接拋出轉化異常,有點坑啊)。

    LinkedHashMap了解嘛

    LinkedHashMap是HashMap的一種特殊分支,是某種有序的hashMap,和TreeMap是不一樣的概念,是用了HashMap+鏈表的方式來構造的,有兩者有序模式:訪問有序,插入順序,插入順序是一直存在的,因為是調用了hashMap的put方法,並沒有重載,但是重載了newNode方法,在這個方法中,會把節點插入鏈表中,訪問有序默認是關閉的,如果打開,則在每次get的時候都會把鏈表的節點移除掉,放到鏈表的最後面。這樣子就是一個LRU的一種實現方式。

    數據結構+算法

    TODO(未完待續)

    總結

    內容過於硬核了,導致很多排版細節,我沒辦法做得像其他期一樣精緻了,大家見諒。

    涉及的內容和東西太多了,可能很多都是點到為止,也有很多不全的,也有很多錯誤的點,已經快3W字了,我校驗實在困難,我會放在GitHub上面,大家可以跟我一起更新這個文章,造福後人吧。

    搞不好下次我需要看的時候,我都得看着這個複習了。

    我是敖丙,一個在互聯網苟且偷生的工具人。

    你知道的越多,你不知道的越多,人才們的 【三連】 就是丙丙創作的最大動力,我們下期見!

    注:如果本篇博客有任何錯誤和建議,歡迎人才們留言,你快說句話啊!

    文章持續更新,可以微信搜索「 三太子敖丙 」第一時間閱讀,回復【資料】【面試】【簡歷】有我準備的一線大廠面試資料和簡歷模板,本文 GitHub https://github.com/JavaFamily 已經收錄,有大廠面試完整考點,歡迎Star。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※別再煩惱如何寫文案,掌握八大原則!
  • 使用 Prometheus-Operator 監控 Calico

    使用 Prometheus-Operator 監控 Calico

    原文鏈接:https://fuckcloudnative.io/posts/monitoring-calico-with-prometheus-operator/

    Calico 中最核心的組件就是 Felix,它負責設置路由表和 ACL 規則等,以便為該主機上的 endpoints 資源正常運行提供所需的網絡連接。同時它還負責提供有關網絡健康狀況的數據(例如,報告配置其主機時發生的錯誤和問題),這些數據會被寫入 etcd,以使其對網絡中的其他組件和操作人員可見。

    由此可見,對於我們的監控來說,監控 Calico 的核心便是監控 Felix,Felix 就相當於 Calico 的大腦。本文將學習如何使用 Prometheus-Operator 來監控 Calico。

    本文不會涉及到 Calico 和 Prometheus-Operator 的部署細節,如果不知道如何部署,請查閱官方文檔和相關博客。

    1. 配置 Calico 以啟用指標

    默認情況下 Felix 的指標是被禁用的,必須通過命令行管理工具 calicoctl 手動更改 Felix 配置才能開啟,需要提前配置好命令行管理工具。

    本文使用的 Calico 版本是 v3.15.0,其他版本類似。先下載管理工具:

    $ wget https://github.com/projectcalico/calicoctl/releases/download/v3.15.0/calicoctl -O /usr/local/bin/calicoctl
    $ chmod +x /usr/local/bin/calicoctl
    

    接下來需要設置 calicoctl 配置文件(默認是 /etc/calico/calicoctl.cfg)。如果你的 Calico 後端存儲使用的是 Kubernetes API,那麼配置文件內容如下:

    apiVersion: projectcalico.org/v3
    kind: CalicoAPIConfig
    metadata:
    spec:
      datastoreType: "kubernetes"
      kubeconfig: "/root/.kube/config"
    

    如果 Calico 後端存儲使用的是 etcd,那麼配置文件內容如下:

    apiVersion: projectcalico.org/v3
    kind: CalicoAPIConfig
    metadata:
    spec:
      datastoreType: "etcdv3"
      etcdEndpoints: https://192.168.57.51:2379,https://192.168.57.52:2379,https://192.168.57.53:2379
      etcdKeyFile: /opt/kubernetes/ssl/server-key.pem
      etcdCertFile: /opt/kubernetes/ssl/server.pem
      etcdCACertFile: /opt/kubernetes/ssl/ca.pem
    

    你需要將其中的證書路徑換成你的 etcd 證書路徑。

    配置好了 calicoctl 之後就可以查看或修改 Calico 的配置了,先來看一下默認的 Felix 配置:

    $ calicoctl get felixConfiguration default -o yaml
    
    apiVersion: projectcalico.org/v3
    kind: FelixConfiguration
    metadata:
      creationTimestamp: "2020-06-25T14:37:28Z"
      name: default
      resourceVersion: "269031"
      uid: 52146c95-ff97-40a9-9ba7-7c3b4dd3ba57
    spec:
      bpfLogLevel: ""
      ipipEnabled: true
      logSeverityScreen: Info
      reportingInterval: 0s
    

    可以看到默認的配置中沒有啟用指標,需要手動修改配置,命令如下:

    $ calicoctl patch felixConfiguration default  --patch '{"spec":{"prometheusMetricsEnabled": true}}'
    

    Felix 暴露指標的端口是 9091,可通過檢查監聽端口來驗證是否開啟指標:

    $ ss -tulnp|grep 9091
    tcp    LISTEN     0      4096   [::]:9091               [::]:*                   users:(("calico-node",pid=13761,fd=9))
    
    $ curl -s http://localhost:9091/metrics
    # HELP felix_active_local_endpoints Number of active endpoints on this host.
    # TYPE felix_active_local_endpoints gauge
    felix_active_local_endpoints 1
    # HELP felix_active_local_policies Number of active policies on this host.
    # TYPE felix_active_local_policies gauge
    felix_active_local_policies 0
    # HELP felix_active_local_selectors Number of active selectors on this host.
    # TYPE felix_active_local_selectors gauge
    felix_active_local_selectors 0
    ...
    

    2. Prometheus 採集 Felix 指標

    啟用了 Felix 的指標后,就可以通過 Prometheus-Operator 來採集指標數據了。Prometheus-Operator 在部署時會創建 Prometheus、PodMonitor、ServiceMonitor、AlertManager 和 PrometheusRule 這 5 個 CRD 資源對象,然後會一直監控並維持這 5 個資源對象的狀態。其中 Prometheus 這個資源對象就是對 Prometheus Server 的抽象。而 PodMonitor 和 ServiceMonitor 就是 exporter 的各種抽象,是用來提供專門提供指標數據接口的工具,Prometheus 就是通過 PodMonitor 和 ServiceMonitor 提供的指標數據接口去 pull 數據的。

    ServiceMonitor 要求被監控的服務必須有對應的 Service,而 PodMonitor 則不需要,本文選擇使用 PodMonitor 來採集 Felix 的指標。

    PodMonitor 雖然不需要應用創建相應的 Service,但必須在 Pod 中指定指標的端口和名稱,因此需要先修改 DaemonSet calico-node 的配置,指定端口和名稱。先用以下命令打開 DaemonSet calico-node 的配置:

    $ kubectl -n kube-system edit ds calico-node
    

    然後在線修改,在 spec.template.sepc.containers 中加入以下內容:

            ports:
            - containerPort: 9091
              name: http-metrics
              protocol: TCP
    

    創建 Pod 對應的 PodMonitor:

    # prometheus-podMonitorCalico.yaml
    apiVersion: monitoring.coreos.com/v1
    kind: PodMonitor
    metadata:
      labels:
        k8s-app: calico-node
      name: felix
      namespace: monitoring
    spec:
      podMetricsEndpoints:
      - interval: 15s
        path: /metrics
        port: http-metrics
      namespaceSelector:
        matchNames:
        - kube-system
      selector:
        matchLabels:
          k8s-app: calico-node
    
    $ kubectl apply -f prometheus-podMonitorCalico.yaml
    

    有幾個參數需要注意:

    • PodMonitor 的 name 最終會反應到 Prometheus 的配置中,作為 job_name。

    • podMetricsEndpoints.port 需要和被監控的 Pod 中的 ports.name 相同,此處為 http-metrics。

    • namespaceSelector.matchNames 需要和被監控的 Pod 所在的 namespace 相同,此處為 kube-system。

    • selector.matchLabels 的標籤必須和被監控的 Pod 中能唯一標明身份的標籤對應。

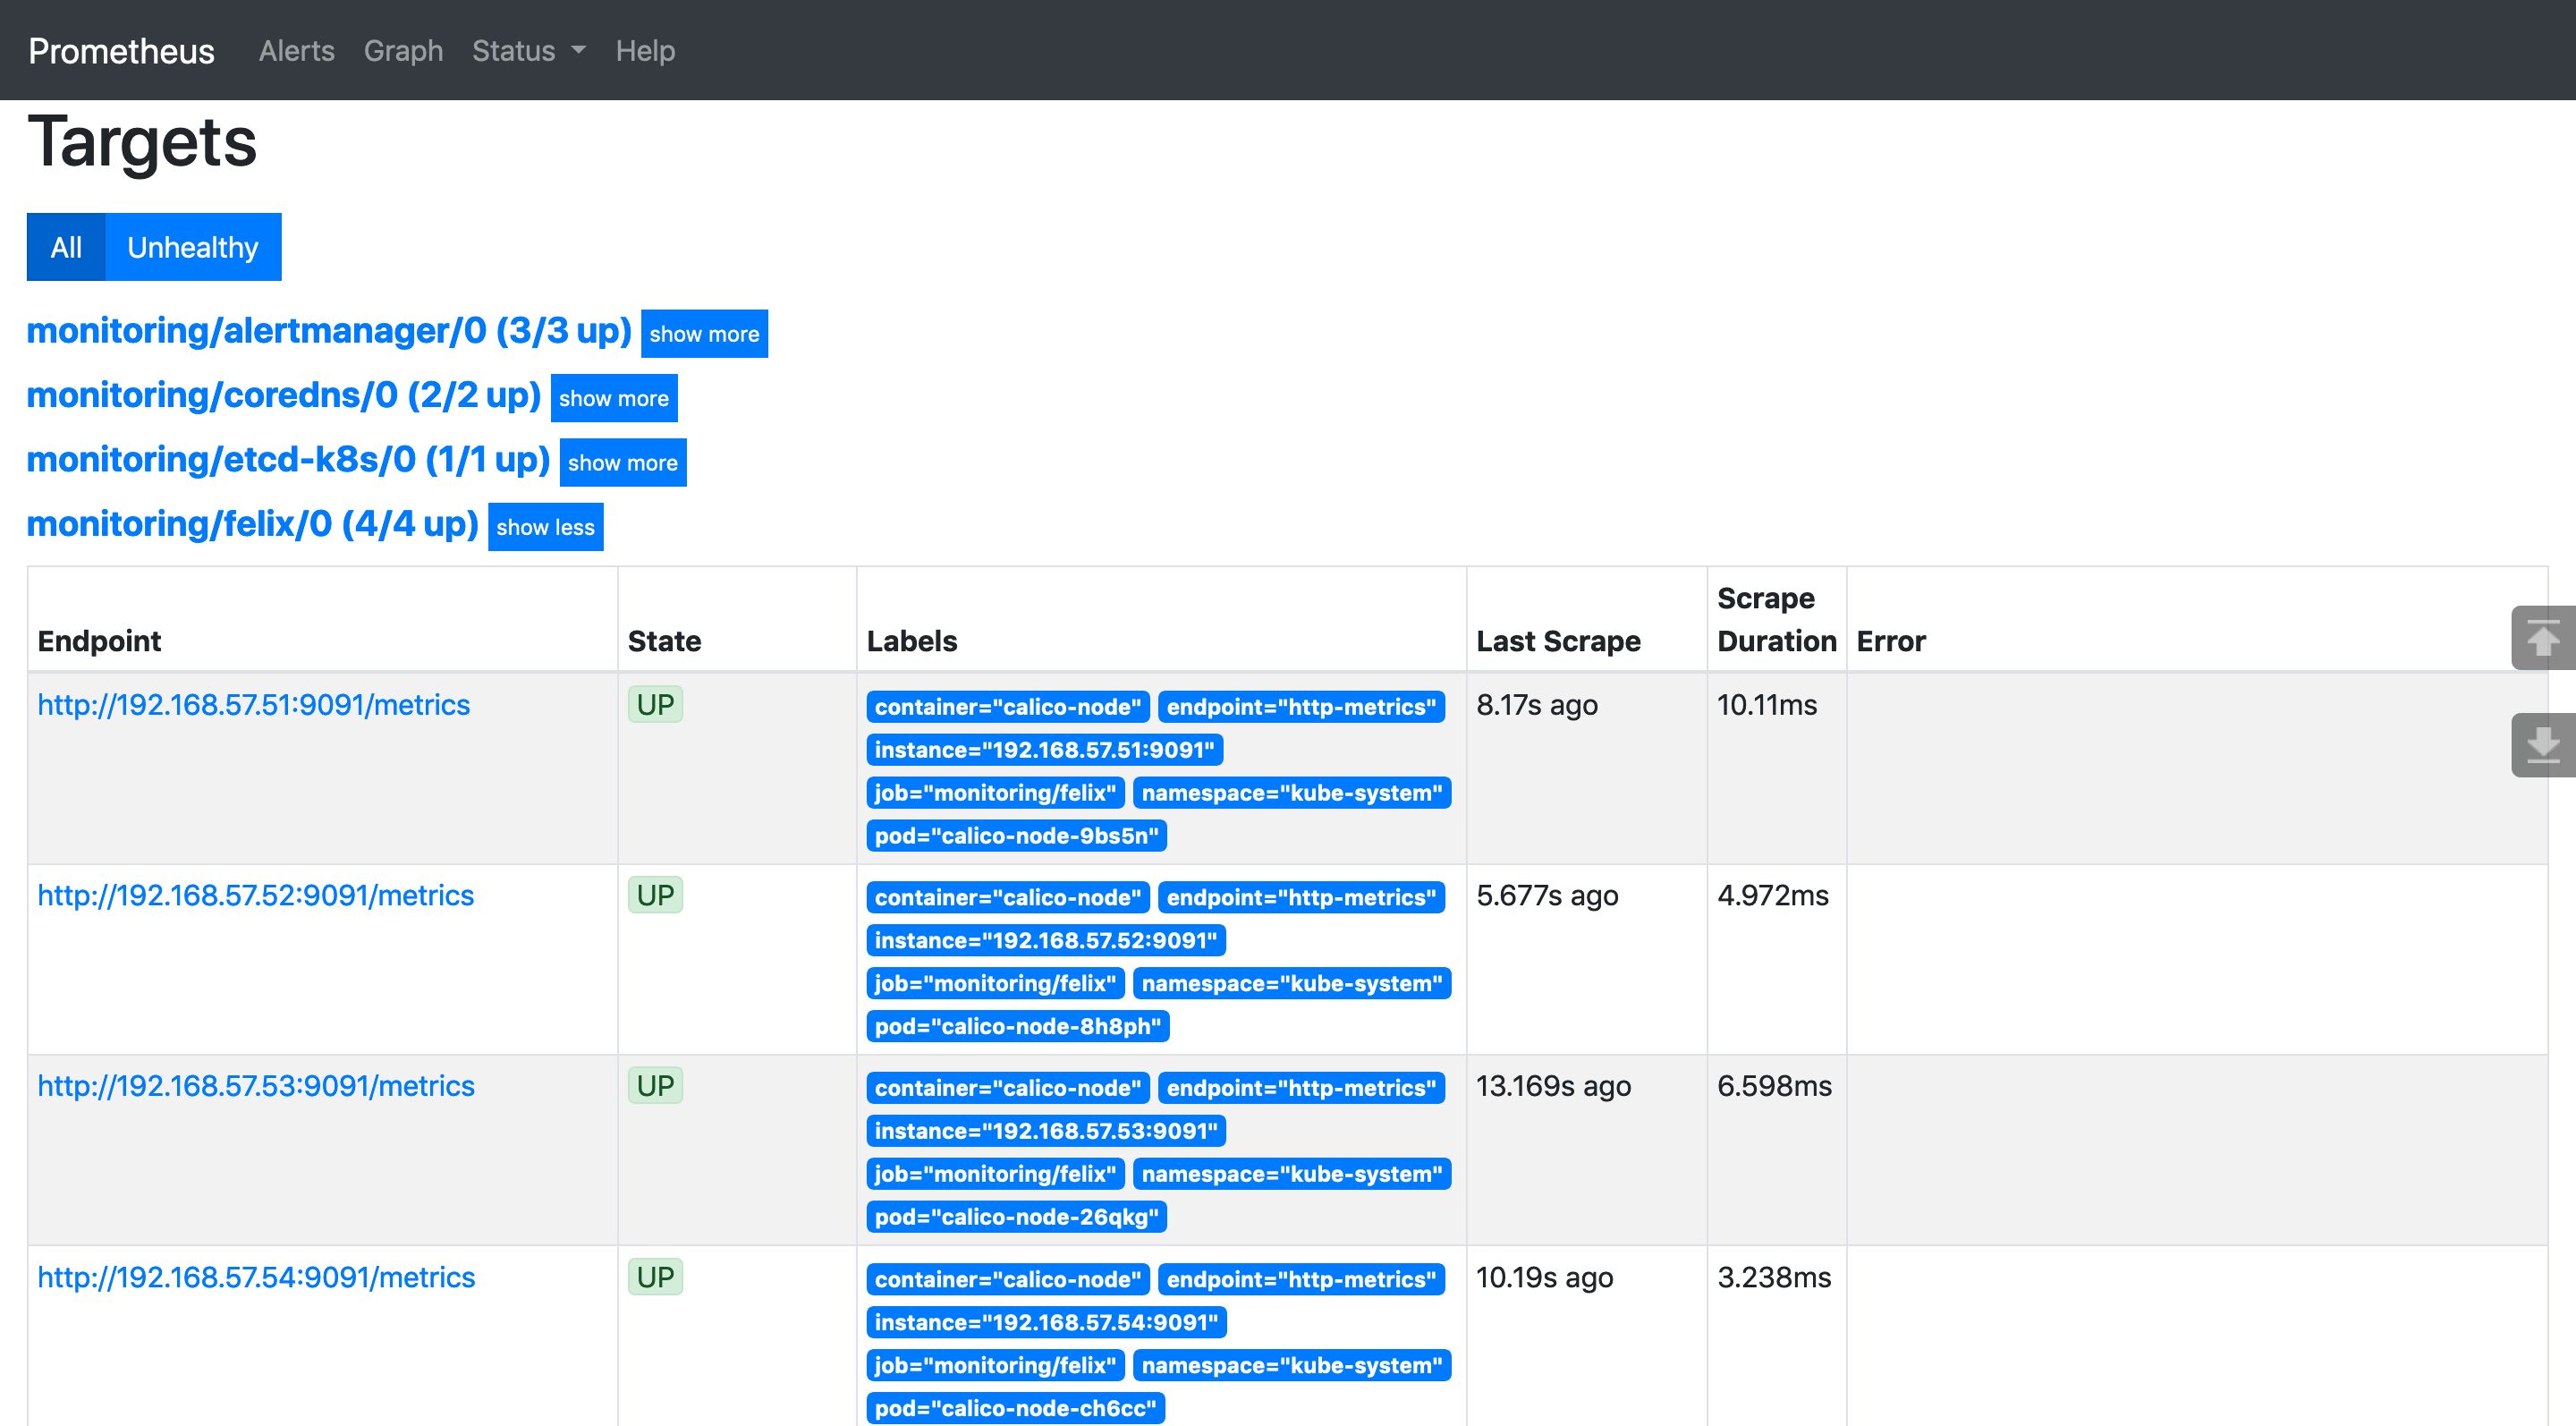
    最終 Prometheus-Operator 會根據 PodMonitor 來修改 Prometheus 的配置文件,以實現對相關的 Pod 進行監控。可以打開 Prometheus 的 UI 查看監控目標:

    注意 Labels 中有 pod="calico-node-xxx",表明監控的是 Pod。

    3. 可視化監控指標

    採集完指標之後,就可以通過 Grafana 的儀錶盤來展示監控指標了。Prometheus-Operator 中部署的 Grafana 無法實時修改儀錶盤的配置(必須提前將儀錶盤的 json 文件掛載到 Grafana Pod 中),而且也不是最新版(7.0 以上版本),所以我選擇刪除 Prometheus-Operator 自帶的 Grafana,自行部署 helm 倉庫中的 Grafana。先進入 kube-prometheus 項目的 manifests 目錄,然後將 Grafana 相關的部署清單都移到同一個目錄下,再刪除 Grafana:

    $ cd kube-prometheus/manifests
    $ mkdir grafana
    $ mv grafana-* grafana/
    $ kubectl delete -f grafana/
    

    然後通過 helm 部署最新的 Grafana:

    $ helm install grafana stable/grafana -n monitoring
    

    訪問 Grafana 的密碼保存在 Secret 中,可以通過以下命令查看:

    $ kubectl -n monitoring get secret grafana -o yaml
    
    apiVersion: v1
    data:
      admin-password: MnpoV3VaMGd1b3R3TDY5d3JwOXlIak4yZ3B2cTU1RFNKcVY0RWZsUw==
      admin-user: YWRtaW4=
      ldap-toml: ""
    kind: Secret
    metadata:
    ...
    

    對密碼進行解密:

    $ echo -n "MnpoV3VaMGd1b3R3TDY5d3JwOXlIak4yZ3B2cTU1RFNKcVY0RWZsUw=="|base64 -d
    

    解密出來的信息就是訪問密碼。用戶名是 admin。通過用戶名和密碼登錄 Grafana 的 UI:

    添加 Prometheus-Operator 的數據源:

    Calico 官方沒有單獨 dashboard json,而是將其放到了 ConfigMap 中,我們需要從中提取需要的 json,提取出 felix-dashboard.json 的內容,然後將其中的 datasource 值替換為 prometheus。你可以用 sed 替換,也可以用編輯器,大多數編輯器都有全局替換的功能。如果你實在不知道如何提取,可以使用我提取好的 json:

    修改完了之後,將 json 內容導入到 Grafana:

    最後得到的 Felix 儀錶盤如下圖所示:

    如果你對我截圖中 Grafana 的主題配色很感興趣,可以參考這篇文章:Grafana 自定義主題。

    Kubernetes 1.18.2 1.17.5 1.16.9 1.15.12離線安裝包發布地址http://store.lameleg.com ,歡迎體驗。 使用了最新的sealos v3.3.6版本。 作了主機名解析配置優化,lvscare 掛載/lib/module解決開機啟動ipvs加載問題, 修復lvscare社區netlink與3.10內核不兼容問題,sealos生成百年證書等特性。更多特性 https://github.com/fanux/sealos 。歡迎掃描下方的二維碼加入釘釘群 ,釘釘群已經集成sealos的機器人實時可以看到sealos的動態。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※教你寫出一流的銷售文案?

  • YoyoGo基於ASP.NET Core設計的Golang實現

    YoyoGo基於ASP.NET Core設計的Golang實現

    YoyoGo

    YoyoGo 是一個用 Go 編寫的簡單,輕便,快速的 微服務框架,目前已實現了Web框架的能力,但是底層設計已支持多種服務架構。

    Github

    https://github.com/yoyofx/yoyogo

    特色

    • 漂亮又快速的路由器
    • 中間件支持 (handler func & custom middleware)
    • 對 REST API 友好
    • 支持 MVC 模式
    • 受到許多出色的 Go Web 框架的啟發

    框架安裝

    go get github.com/yoyofx/yoyogo
    

    安裝依賴 (由於某些原因國內下載不了依賴)

    go version < 1.13

    window 下在 cmd 中執行:
    set GO111MODULE=on
    set  GOPROXY=https://goproxy.cn
    
    linux  下執行:
    export GO111MODULE=on
    export GOPROXY=https://goproxy.cn
    

    go version >= 1.13

    go env -w GOPROXY=https://goproxy.cn,direct
    

    簡單的例子

    package main
    import ...
    
    func main() {
        YoyoGo.CreateDefaultBuilder(func(router Router.IRouterBuilder) {
            router.GET("/info",func (ctx *Context.HttpContext) {    // 支持Group方式
                ctx.JSON(200, Context.M{"info": "ok"})
            })
        }).Build().Run()       //默認端口號 :8080
    }
    

    實現進度

    標準功能

    • [X] 打印Logo和日誌(YoyoGo)
    • [X] 統一程序輸入參數和環境變量 (YoyoGo)
    • [X] 簡單路由器綁定句柄功能
    • [X] HttpContext 上下文封裝(請求,響應)
    • [X] 靜態文件端點(靜態文件服務器)
    • [X] JSON 序列化結構(Context.M)
    • [X] 獲取請求文件並保存
    • [X] 獲取請求數據(form-data,x-www-form-urlencoded,Json ,XML,Protobuf 等)
    • [X] Http 請求的綁定模型(Url, From,JSON,XML,Protobuf)

    響應渲染功能

    • [X] Render Interface
    • [X] JSON Render
    • [X] JSONP Render
    • [X] Indented Json Render
    • [X] Secure Json Render
    • [X] Ascii Json Render
    • [X] Pure Json Render
    • [X] Binary Data Render
    • [X] TEXT
    • [X] Protobuf
    • [X] MessagePack
    • [X] XML
    • [X] YAML
    • [X] File
    • [X] Image
    • [X] Template
    • [X] Auto formater Render

    中間件

    • [X] Logger
    • [X] StaticFile
    • [X] Router Middleware
    • [ ] Session
    • [ ] CORS
    • [ ] GZip
    • [X] Binding
    • [ ] Binding Valateion

    路由

    • [x] GET,POST,HEAD,PUT,DELETE 方法支持
    • [x] 路由解析樹與表達式支持
    • [x] RouteData路由數據 (/api/:version/) 與 Binding的集成
    • [x] 路由組功能
    • [ ] MVC默認模板功能
    • [ ] 路由過濾器 Filter

    MVC

    • [x] 路由請求觸發Controller&Action
    • [X] Action方法參數綁定
    • [ ] 內部對象的DI化
    • [ ] 關鍵對象的參數傳遞

    Dependency injection

    • [X] 抽象集成第三方DI框架
    • [X] MVC模式集成
    • [X] 框架級的DI支持功能

    擴展

    • [ ] 配置
    • [ ] WebSocket
    • [ ] JWT
    • [ ] swagger
    • [ ] GRpc
    • [ ] OAuth2
    • [ ] Prometheus
    • [ ] 安全

    進階範例

    package main
    import ...
    
    func main() {
    	webHost := CreateCustomWebHostBuilder().Build()
    	webHost.Run()
    }
    
    // 自定義HostBuilder並支持 MVC 和 自動參數綁定功能,簡單情況也可以直接使用CreateDefaultBuilder 。
    func CreateCustomBuilder() *Abstractions.HostBuilder {
    	return YoyoGo.NewWebHostBuilder().
    		SetEnvironment(Context.Prod).
    		UseFastHttp().
    		//UseServer(YoyoGo.DefaultHttps(":8080", "./Certificate/server.pem", "./Certificate/server.key")).
    		Configure(func(app *YoyoGo.WebApplicationBuilder) {
    			app.UseStatic("Static")
    			app.UseEndpoints(registerEndpointRouterConfig)
    			app.UseMvc(func(builder *Mvc.ControllerBuilder) {
    				builder.AddController(contollers.NewUserController)
    			})
    		}).
    		ConfigureServices(func(serviceCollection *DependencyInjection.ServiceCollection) {
    			serviceCollection.AddTransientByImplements(models.NewUserAction, new(models.IUserAction))
    		}).
    		OnApplicationLifeEvent(getApplicationLifeEvent)
    }
    
    //region endpoint 路由綁定函數
    func registerEndpoints(router Router.IRouterBuilder) {
    	router.GET("/error", func(ctx *Context.HttpContext) {
    		panic("http get error")
    	})
    
        //POST 請求: /info/:id ?q1=abc&username=123
    	router.POST("/info/:id", func (ctx *Context.HttpContext) {
            qs_q1 := ctx.Query("q1")
            pd_name := ctx.Param("username")
    
            userInfo := &UserInfo{}
            
            _ = ctx.Bind(userInfo)    // 手動綁定請求對象
    
            strResult := fmt.Sprintf("Name:%s , Q1:%s , bind: %s", pd_name, qs_q1, userInfo)
    
            ctx.JSON(200, Std.M{"info": "hello world", "result": strResult})
        })
    
        // 路由組功能實現綁定 GET 請求:  /v1/api/info
    	router.Group("/v1/api", func(router *Router.RouterGroup) {
    		router.GET("/info", func (ctx *Context.HttpContext) {
    	        ctx.JSON(200, Std.M{"info": "ok"})
            })
    	})
        
        // GET 請求: HttpContext.RequiredServices獲取IOC對象
    	router.GET("/ioc", func (ctx *Context.HttpContext) {
            var userAction models.IUserAction
            _ = ctx.RequiredServices.GetService(&userAction)
            ctx.JSON(200, Std.M{"info": "ok " + userAction.Login("zhang")})
        })
    }
    
    //endregion
    
    //region 請求對象
    type UserInfo struct {
    	UserName string `param:"username"`
    	Number   string `param:"q1"`
    	Id       string `param:"id"`
    }
    
    // ----------------------------------------- MVC 定義 ------------------------------------------------------
    
    // 定義Controller
    type UserController struct {
    	*Controller.ApiController
    	userAction models.IUserAction    // IOC 對象參數
    }
    
    // 構造器依賴注入
    func NewUserController(userAction models.IUserAction) *UserController {
    	return &UserController{userAction: userAction}
    }
    
    // 請求對象的參數化綁定
    type RegiserRequest struct {
    	Controller.RequestParam
    	UserName string `param:"username"`
    	Password string `param:"password"`
    }
    
    // Register函數自動綁定參數
    func (this *UserController) Register(ctx *Context.HttpContext, request *RegiserRequest) ActionResult.IActionResult {
    	result := Controller.ApiResult{Success: true, Message: "ok", Data: request}
    	return ActionResult.Json{Data: result}
    }
    
    // use userAction interface by ioc  
    func (this *UserController) GetInfo() Controller.ApiResult {
    	return this.OK(this.userAction.Login("zhang"))
    }
    
    
    // Web程序的開始與停止事件
    func fireApplicationLifeEvent(life *YoyoGo.ApplicationLife) {
    	printDataEvent := func(event YoyoGo.ApplicationEvent) {
    		fmt.Printf("[yoyogo] Topic: %s; Event: %v\n", event.Topic, event.Data)
    	}
    	for {
    		select {
    		case ev := <-life.ApplicationStarted:
    			go printDataEvent(ev)
    		case ev := <-life.ApplicationStopped:
    			go printDataEvent(ev)
    			break
    		}
    	}
    }


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

  • 重學 Java 設計模式:實戰備忘錄模式「模擬互聯網系統上線過程中,配置文件回滾場景」

    重學 Java 設計模式:實戰備忘錄模式「模擬互聯網系統上線過程中,配置文件回滾場景」

    作者:小傅哥
    博客:https://bugstack.cn – 原創系列專題文章

    沉澱、分享、成長,讓自己和他人都能有所收穫!

    一、前言

    實現不了是研發的借口?

    實現不了,有時候是功能複雜度較高難以實現,有時候是工期較短實現不完。而編碼的行為又是一個不太好量化的過程,同樣一個功能每個人的實現方式不一樣,遇到開發問題解決問題的速度也不一樣。除此之外還很不好給產品解釋具體為什麼要這個工期時間,這就像蓋樓的圖紙最終要多少水泥砂漿一樣。那麼這時研發會盡可能的去通過一些經驗,制定流程規範、設計、開發、評審等,確定一個可以完成的時間範圍,又避免風險的時間點后。再被壓縮,往往會出一些矛盾點,能壓縮要解釋為什麼之前要那麼多時間,不能壓縮又有各方不斷施加的壓力。因此有時候不一定是借口,是要考慮如何讓整個團隊健康的發展。

    鼓勵有時比壓力要重要!

    在學習的過程中,很多時候我們聽到的都是,你要怎樣,怎樣,你瞧瞧誰誰誰,哪怕今天聽不到這樣的聲音了,但因為曾經反覆聽到過而導致內心抗拒。雖然也知道自己要去學,但是很難堅持,學着學着就沒有了方向,看到還有那麼多不會的就更慌了,以至於最後心態崩了,更不願意學。其實程序員的壓力並不小,想成長几乎是需要一直的學習,就像似乎再也不敢說精通java了一樣,知識量實在是隨着學習的深入,越來越深,越來越廣。所以需要,開心學習,快樂成長!

    臨陣的你好像一直很着急!

    經常的聽到;老師明天就要了你幫我弄弄吧、你給我寫一下完事我就學這次着急、現在這不是沒時間學嗎快給我看看。其實看到的類似的還有很多,很納悶你的着急怎麼來的,不太可能,人在家中坐,禍從天上落。老師怎麼就那個時間找你了,老闆怎麼就今天管你要了,還不是日積月累你沒有學習,臨時抱佛腳亂着急!即使後來真的有人幫你了,但最好不要放鬆,要儘快學會,躲得過初一還有初二呢!

    二、開發環境

    1. JDK 1.8
    2. Idea + Maven
    3. 涉及工程一個,可以通過關注公眾號:bugstack蟲洞棧,回復源碼下載獲取(打開獲取的鏈接,找到序號18)
    工程 描述
    itstack-demo-design-17-00 開發配置文件備忘錄

    三、備忘錄模式介紹

    備忘錄模式是以可以恢復或者說回滾,配置、版本、悔棋為核心功能的設計模式,而這種設計模式屬於行為模式。在功能實現上是以不破壞原對象為基礎增加備忘錄操作類,記錄原對象的行為從而實現備忘錄模式。

    這個設計在我們平常的生活或者開發中也是比較常見的,比如:後悔葯、孟婆湯(一下回滾到0),IDEA編輯和撤銷、小霸王遊戲機存檔。當然還有我們非常常見的Photoshop,如下;

    四、案例場景模擬

    在本案例中我們模擬系統在發布上線的過程中記錄線上配置文件用於緊急回滾

    在大型互聯網公司系統的發布上線一定是易用、安全、可處理緊急狀況的,同時為了可以隔離線上和本地環境,一般會把配置文件抽取出來放到線上,避免有人誤操作導致本地的配置內容發布出去。同時線上的配置文件也會在每次變更的時候進行記錄,包括;版本號、時間、MD5、內容信息和操作人。

    在後續上線時如果發現緊急問題,系統就會需要回滾操作,如果執行回滾那麼也可以設置配置文件是否回滾。因為每一個版本的系統可能會隨着帶着一些配置文件的信息,這個時候就可以很方便的讓系統與配置文件一起回滾操作。

    我們接下來就使用備忘錄模式,模擬如何記錄配置文件信息。實際的使用過程中還會將信息存放到庫中進行保存,這裏暫時只是使用內存記錄。

    五、備忘錄模式記錄配置文件版本信息

    備忘錄的設計模式實現方式,重點在於不更改原有類的基礎上,增加備忘錄類存放記錄。可能平時雖然不一定非得按照這個設計模式的代碼結構來實現自己的需求,但是對於功能上可能也完成過類似的功能,記錄系統的信息。

    除了現在的這個案例外,還可以是運營人員在後台erp創建活動對信息的記錄,方便運營人員可以上下修改自己的版本,而不至於因為誤操作而丟失信息。

    1. 工程結構

    itstack-demo-design-17-00
    └── src
        ├── main
        │   └── java
        │       └── org.itstack.demo.design
        │           ├── Admin.java
        │           ├── ConfigFile.java
        │           ├── ConfigMemento.java
        │           └── ConfigOriginator.java
        └── test
            └── java
                └── org.itstack.demo.design.test
                    └── ApiTest.java
    

    備忘錄模式模型結構

    • 以上是工程結構的一個類圖,其實相對來說並不複雜,除了原有的配置類(ConfigFile)以外,只新增加了三個類。
    • ConfigMemento:備忘錄類,相當於是對原有配置類的擴展
    • ConfigOriginator:記錄者類,獲取和返回備忘錄類對象信息
    • Admin:管理員類,用於操作記錄備忘信息,比如你一些列的順序執行了什麼或者某個版本下的內容信息

    2. 代碼實現

    2.1 配置信息類

    public class ConfigFile {
    
        private String versionNo; // 版本號
        private String content;   // 內容
        private Date dateTime;    // 時間
        private String operator;  // 操作人
        
        // ...get/set
    }
    
    • 配置類可以是任何形式的,這裏只是簡單的描述了一個基本的配置內容信息。

    2.2 備忘錄類

    public class ConfigMemento {
    
        private ConfigFile configFile;
    
        public ConfigMemento(ConfigFile configFile) {
            this.configFile = configFile;
        }
    
        public ConfigFile getConfigFile() {
            return configFile;
        }
    
        public void setConfigFile(ConfigFile configFile) {
            this.configFile = configFile;
        }
        
    }
    
    • 備忘錄是對原有配置類的擴展,可以設置和獲取配置信息。

    2.3 記錄者類

    public class ConfigOriginator {
    
        private ConfigFile configFile;
    
        public ConfigFile getConfigFile() {
            return configFile;
        }
    
        public void setConfigFile(ConfigFile configFile) {
            this.configFile = configFile;
        }
    
        public ConfigMemento saveMemento(){
            return new ConfigMemento(configFile);
        }
    
        public void getMemento(ConfigMemento memento){
            this.configFile = memento.getConfigFile();
        }
    
    }
    
    • 記錄者類除了對ConfigFile配置類增加了獲取和設置方法外,還增加了保存saveMemento()、獲取getMemento(ConfigMemento memento)。
    • saveMemento:保存備忘錄的時候會創建一個備忘錄信息,並返回回去,交給管理者處理。
    • getMemento:獲取的之後並不是直接返回,而是把備忘錄的信息交給現在的配置文件this.configFile,這部分需要注意。

    2.4 管理員類

    public class Admin {
    
        private int cursorIdx = 0;
        private List<ConfigMemento> mementoList = new ArrayList<ConfigMemento>();
        private Map<String, ConfigMemento> mementoMap = new ConcurrentHashMap<String, ConfigMemento>();
    
        public void append(ConfigMemento memento) {
            mementoList.add(memento);
            mementoMap.put(memento.getConfigFile().getVersionNo(), memento);
            cursorIdx++;
        }
    
        public ConfigMemento undo() {
            if (--cursorIdx <= 0) return mementoList.get(0);
            return mementoList.get(cursorIdx);
        }
    
        public ConfigMemento redo() {
            if (++cursorIdx > mementoList.size()) return mementoList.get(mementoList.size() - 1);
            return mementoList.get(cursorIdx);
        }
    
        public ConfigMemento get(String versionNo){
            return mementoMap.get(versionNo);
        }
    
    }
    
    • 在這個類中主要實現的核心功能就是記錄配置文件信息,也就是備忘錄的效果,之後提供可以回滾和獲取的方法,拿到備忘錄的具體內容。
    • 同時這裏設置了兩個數據結構來存放備忘錄,實際使用中可以按需設置。List<ConfigMemento>、Map<String, ConfigMemento>。
    • 最後是提供的備忘錄操作方法;存放(append)、回滾(undo)、返回(redo)、定向獲取(get),這樣四個操作方法。

    3. 測試驗證

    3.1 編寫測試類

    @Test
    public void test() {
        Admin admin = new Admin();
        ConfigOriginator configOriginator = new ConfigOriginator();
        configOriginator.setConfigFile(new ConfigFile("1000001", "配置內容A=哈哈", new Date(), "小傅哥"));
        admin.append(configOriginator.saveMemento()); // 保存配置
        configOriginator.setConfigFile(new ConfigFile("1000002", "配置內容A=嘻嘻", new Date(), "小傅哥"));
        admin.append(configOriginator.saveMemento()); // 保存配置
        configOriginator.setConfigFile(new ConfigFile("1000003", "配置內容A=么么", new Date(), "小傅哥"));
        admin.append(configOriginator.saveMemento()); // 保存配置
        configOriginator.setConfigFile(new ConfigFile("1000004", "配置內容A=嘿嘿", new Date(), "小傅哥"));
        admin.append(configOriginator.saveMemento()); // 保存配置  
    
        // 歷史配置(回滾)
        configOriginator.getMemento(admin.undo());
        logger.info("歷史配置(回滾)undo:{}", JSON.toJSONString(configOriginator.getConfigFile()));  
    
        // 歷史配置(回滾)
        configOriginator.getMemento(admin.undo());
        logger.info("歷史配置(回滾)undo:{}", JSON.toJSONString(configOriginator.getConfigFile()));  
    
        // 歷史配置(前進)
        configOriginator.getMemento(admin.redo());
        logger.info("歷史配置(前進)redo:{}", JSON.toJSONString(configOriginator.getConfigFile()));   
    
        // 歷史配置(獲取)
        configOriginator.getMemento(admin.get("1000002"));
        logger.info("歷史配置(獲取)get:{}", JSON.toJSONString(configOriginator.getConfigFile()));
    }
    
    • 這個設計模式的學習有一部分重點是體現在了單元測試類上,這裏包括了四次的信息存儲和備忘錄歷史配置操作。
    • 通過上面添加了四次配置后,下面分別進行操作是;回滾1次、再回滾1次,之後向前進1次,最後是獲取指定的版本配置。具體的效果可以參考測試結果。

    3.2 測試結果

    23:12:09.512 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(回滾)undo:{"content":"配置內容A=嘿嘿","dateTime":159209829432,"operator":"小傅哥","versionNo":"1000004"}
    23:12:09.514 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(回滾)undo:{"content":"配置內容A=么么","dateTime":159209829432,"operator":"小傅哥","versionNo":"1000003"}
    23:12:09.514 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(前進)redo:{"content":"配置內容A=嘿嘿","dateTime":159209829432,"operator":"小傅哥","versionNo":"1000004"}
    23:12:09.514 [main] INFO  org.itstack.demo.design.test.ApiTest - 歷史配置(獲取)get:{"content":"配置內容A=嘻嘻","dateTime":159320989432,"operator":"小傅哥","versionNo":"1000002"}
    
    Process finished with exit code 0
    
    • 從測試效果上可以看到,歷史配置按照我們的指令進行了回滾和前進,以及最終通過指定的版本進行獲取,符合預期結果。

    六、總結

    • 此種設計模式的方式可以滿足在不破壞原有屬性類的基礎上,擴充了備忘錄的功能。雖然和我們平時使用的思路是一樣的,但在具體實現上還可以細細品味,這樣的方式在一些源碼中也有所體現。
    • 在以上的實現中我們是將配置模擬存放到內存中,如果關機了會導致配置信息丟失,因為在一些真實的場景里還是需要存放到數據庫中。那麼此種存放到內存中進行回復的場景也不是沒有,比如;Photoshop、運營人員操作ERP配置活動,那麼也就是即時性的一般不需要存放到庫中進行恢復。另外如果是使用內存方式存放備忘錄,需要考慮存儲問題,避免造成內存大量消耗。
    • 設計模式的學習都是為了更好的寫出可擴展、可管理、易維護的代碼,而這個學習的過程需要自己不斷的嘗試實際操作,理論的知識與實際結合還有很長一段距離。切記多多上手!

    七、推薦閱讀

    • 1. 重學 Java 設計模式:實戰工廠方法模式「多種類型商品不同接口,統一發獎服務搭建場景」
    • 2. 重學 Java 設計模式:實戰原型模式「上機考試多套試,每人題目和答案亂序排列場景」
    • 3. 重學 Java 設計模式:實戰橋接模式「多支付渠道(微信、支付寶)與多支付模式(刷臉、指紋)場景」
    • 4. 重學 Java 設計模式:實戰組合模式「營銷差異化人群發券,決策樹引擎搭建場景」
    • 5. 重學 Java 設計模式:實戰外觀模式「基於SpringBoot開發門面模式中間件,統一控制接口白名單場景」
    • 6. 重學 Java 設計模式:實戰享元模式「基於Redis秒殺,提供活動與庫存信息查詢場景」
    • 7. 重學 Java 設計模式:實戰備忘錄模式「模擬互聯網系統上線過程中,配置文件回滾場景」

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※幫你省時又省力,新北清潔一流服務好口碑

  • dubbo源碼解析之負載均衡

    dubbo源碼解析之負載均衡

    在分佈式系統中,負載均衡是必不可少的一個模塊,dubbo 中提供了五種負載均衡的實現,在閱讀這塊源碼之前,建議先學習負載均衡的基礎知識。把看源碼當做一個印證自己心中所想的過程,這樣會得到事半功倍的效果

    以下源碼分析基於 dubbo 2.77 版本

    類結構

    先來看一下這一塊的類結構圖

    大部分算法都是在權重比的基礎上進行負載均衡,RandomLoadBalance 是默認的算法

    類型 描述 是否默認 是否加權
    RandomLoadBalance 隨機 是 是,默認權重相同
    RoundRobinLoadBalance 輪訓 否 是,默認權重相同
    LeastActiveLoadBalance 最少活躍數調用 否 不完全是,默認權重相同,僅在活躍數相同時按照權重比隨機
    ConsistentHashLoadBalance 一致性hash 否 否
    ShortestResponseLoadBalance 最短時間調用 否 不完全是,默認權重相同,僅在預估調用相同時按照權重比隨機

    AbstractLoadBalance

    AbstractLoadBalance 對一些通用的操作做了處理,是一個典型的模板方法模式的實現

    select 方法只做一些簡單的範圍校驗,具體的實現有子類通過 doSelect 方法去實現

        @Override
        public <T> Invoker<T> select(List<Invoker<T>> invokers, URL url, Invocation invocation) {
            if (CollectionUtils.isEmpty(invokers)) {
                return null;
            }
            if (invokers.size() == 1) {
                return invokers.get(0);
            }
            return doSelect(invokers, url, invocation);
        }
    

    getWeight方法封裝了獲取一個調用者的權重值的方法,並加入了預熱處理

        int getWeight(Invoker<?> invoker, Invocation invocation) {
            int weight;
            URL url = invoker.getUrl();
            // Multiple registry scenario, load balance among multiple registries.
            // 註冊中心不需要預熱
            if (REGISTRY_SERVICE_REFERENCE_PATH.equals(url.getServiceInterface())) {
                weight = url.getParameter(REGISTRY_KEY + "." + WEIGHT_KEY, DEFAULT_WEIGHT);
            } else {
                // 獲取配置的權重值
                weight = url.getMethodParameter(invocation.getMethodName(), WEIGHT_KEY, DEFAULT_WEIGHT);
                if (weight > 0) {
                    // 獲取服務提供者啟動時的時間戳
                    long timestamp = invoker.getUrl().getParameter(TIMESTAMP_KEY, 0L);
                    if (timestamp > 0L) {
                        //  獲取啟動時長
                        long uptime = System.currentTimeMillis() - timestamp;
                        // 當前時間小於服務提供者啟動時間,直接給一個最小權重1
                        if (uptime < 0) {
                            return 1;
                        }
                        // 獲取預熱時間
                        int warmup = invoker.getUrl().getParameter(WARMUP_KEY, DEFAULT_WARMUP);
                        // 如果小於預熱時間,計算權重
                        if (uptime > 0 && uptime < warmup) {
                            weight = calculateWarmupWeight((int)uptime, warmup, weight);
                        }
                    }
                }
            }
            // 取與零比較的最大值,保證不會出現負值權重
            return Math.max(weight, 0);
        }
    

    calculateWarmupWeight 方法用來計算權重,保證隨着預熱時間的增加,權重逐漸達到設置的權重

        static int calculateWarmupWeight(int uptime, int warmup, int weight) {
            // 運行時間/(預熱時間/權重)
            int ww = (int) ( uptime / ((float) warmup / weight));
            // 保證計算的權重最小值是1,並且不能超過設置的權重
            return ww < 1 ? 1 : (Math.min(ww, weight));
        }
    

    RandomLoadBalance

    隨機調用是負載均衡算法中最常用的算法之一,也是 dubbo 的默認負載均衡算法,實現起來也較為簡單
    隨機調用的缺點是在調用量比較少的情況下,有可能出現不均勻的情況

    	@Override
        protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
            // Number of invokers
            int length = invokers.size();
            // Every invoker has the same weight?
            boolean sameWeight = true;
            // the weight of every invokers
            int[] weights = new int[length];
            // the first invoker's weight
            int firstWeight = getWeight(invokers.get(0), invocation);
            weights[0] = firstWeight;
            // The sum of weights
            int totalWeight = firstWeight;
            for (int i = 1; i < length; i++) {
                int weight = getWeight(invokers.get(i), invocation);
                // save for later use
                // 依次把權重放到數組對應的位置
                weights[i] = weight;
                // Sum
                // 累加權重
                totalWeight += weight;
                // 如果出現權重不一樣的,sameWeight 設為false
                if (sameWeight && weight != firstWeight) {
                    sameWeight = false;
                }
            }
            if (totalWeight > 0 && !sameWeight) {
                // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on totalWeight.
                // 在總權重裏面隨機選擇一個偏移量
                int offset = ThreadLocalRandom.current().nextInt(totalWeight);
                // Return a invoker based on the random value.
                for (int i = 0; i < length; i++) {
                    offset -= weights[i];
                    // 依次用偏移量減去當前權重,小於0說明選中
                    if (offset < 0) {
                        return invokers.get(i);
                    }
                }
            }
            // If all invokers have the same weight value or totalWeight=0, return evenly.
            // 如果所有的調用者有同樣的權重或者總權重為0,則隨機選擇一個
            return invokers.get(ThreadLocalRandom.current().nextInt(length));
        }
    

    RoundRobinLoadBalance

    輪訓算法避免了隨機算法在小數據量產生的不均勻問題,我個人認為,輪訓算法可以理解為隨機算法的一種特例,在大量請求的情況下,從調用次數看,和隨機並無區別,主要區別在於短時間內的調用分配上

    加權輪訓算法給人的直觀感受,實現起來並不複雜,算出一權重總量,依次調用即可
    例如A,B,C 三個節點的權重比依次 1,200,1000,如果依次輪訓調用,就會出現先調用A 10 次,再調用B 200次,最後調用 C 1000次,不斷重複前面的過程
    但這樣有一個問題,我們可以發現C 被練習調用1000次,會對C瞬間造成很大的壓力

    dubbo的新版本採用的是平滑加權輪詢算法,輪訓的過程中節點之間穿插調用,可以避免了上面說的問題,因此這塊源碼看起來會稍有難度

    輪訓算法 在dubbo 在升級的過程中,做過多次優化,有興趣的可以去了解下該算法的優化過程,也是件很有意思的事情

    public class RoundRobinLoadBalance extends AbstractLoadBalance {
        public static final String NAME = "roundrobin";
    
        private static final int RECYCLE_PERIOD = 60000;
    
        protected static class WeightedRoundRobin {
            // 權重值
            private int weight;
            // 當前權重值
            private AtomicLong current = new AtomicLong(0);
            // 最後一次使用該對象時間
            private long lastUpdate;
    
            public int getWeight() {
                return weight;
            }
    
            public void setWeight(int weight) {
                this.weight = weight;
                current.set(0);
            }
    
            // 獲取自增權重基數的當前權重值
            public long increaseCurrent() {
                return current.addAndGet(weight);
            }
    
            public void sel(int total) {
                current.addAndGet(-1 * total);
            }
    
            public long getLastUpdate() {
                return lastUpdate;
            }
    
            // 設置最後一次更新時間戳
            public void setLastUpdate(long lastUpdate) {
                this.lastUpdate = lastUpdate;
            }
        }
    
        private ConcurrentMap<String, ConcurrentMap<String, WeightedRoundRobin>> methodWeightMap = new ConcurrentHashMap<String, ConcurrentMap<String, WeightedRoundRobin>>();
    
        /**
         * get invoker addr list cached for specified invocation
         * <p>
         * <b>for unit test only</b>
         *
         * @param invokers
         * @param invocation
         * @return
         */
        protected <T> Collection<String> getInvokerAddrList(List<Invoker<T>> invokers, Invocation invocation) {
            String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
            Map<String, WeightedRoundRobin> map = methodWeightMap.get(key);
            if (map != null) {
                return map.keySet();
            }
            return null;
        }
    
        @Override
        protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
            // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
            String key = invokers.get(0).getUrl().getServiceKey() + "." + invocation.getMethodName();
            // 獲取對應的 WeightedRoundRobin map,如果不存在,new 一個map放進去
            ConcurrentMap<String, WeightedRoundRobin> map = methodWeightMap.computeIfAbsent(key, k -> new ConcurrentHashMap<>());
            int totalWeight = 0;
            long maxCurrent = Long.MIN_VALUE;
            long now = System.currentTimeMillis();
            Invoker<T> selectedInvoker = null;
            WeightedRoundRobin selectedWRR = null;
            for (Invoker<T> invoker : invokers) {
                // 服務提供者在的唯一標識
                String identifyString = invoker.getUrl().toIdentityString();
                int weight = getWeight(invoker, invocation);
                WeightedRoundRobin weightedRoundRobin = map.computeIfAbsent(identifyString, k -> {
                    WeightedRoundRobin wrr = new WeightedRoundRobin();
                    wrr.setWeight(weight);
                    return wrr;
                });
                // 如果權重改變了,更新 weightedRoundRobin 裏面權重的值
                if (weight != weightedRoundRobin.getWeight()) {
                    //weight changed
                    weightedRoundRobin.setWeight(weight);
                }
                // 當前權重自增自身權重
                long cur = weightedRoundRobin.increaseCurrent();
                // 設置最後一次更新時間戳
                weightedRoundRobin.setLastUpdate(now);
                // 如果當前權重大於最大當前權重
                if (cur > maxCurrent) {
                    // 重置最大當前權重的值
                    maxCurrent = cur;
                    // 把當前提供者設為選中的提供者
                    selectedInvoker = invoker;
                    // 把當前輪訓權重實例設為選中
                    selectedWRR = weightedRoundRobin;
                }
                // 累計總權重
                totalWeight += weight;
            }
            // 提供者有變化
            if (invokers.size() != map.size()) {
                // 超過60s沒有使用,刪除掉
                map.entrySet().removeIf(item -> now - item.getValue().getLastUpdate() > RECYCLE_PERIOD);
            }
            if (selectedInvoker != null) {
                // 減去總權重
                // 關於這個地方為什麼要減去總權重,是一個很容易造成迷惑的地方
                // 我的理解:每一次調用循環 每個提供者的 當前權重 都會自增自己的權重
                // 因此在選中后(只有一個被選中),再減去總權重,正好保證了所有 WeightedRoundRobin 中當前權重之和永遠等於0
                selectedWRR.sel(totalWeight);
                return selectedInvoker;
            }
            // 理論上不會走到這個地方
            // should not happen here
            return invokers.get(0);
        }
    
    }
    

    LeastActiveLoadBalance

    最少活躍數調用算法是指在調用時判斷此時每個服務提供者此時正在處理的請求個數,選取最小的調用

    dubbo 在實現該算法時的具體邏輯如下

    1. 選取所有活躍數最少的提供者
    2. 如果只有一個,直接返回
    3. 如果權重不同,加權隨機選擇一個
    4. 如果權重相同,隨機選擇一個
        @Override
        protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
            // Number of invokers
            int length = invokers.size();
            // The least active value of all invokers
            // 最少活躍數量
            int leastActive = -1;
            // The number of invokers having the same least active value (leastActive)
            // 有同樣活躍值的提供者數量
            int leastCount = 0;
            // The index of invokers having the same least active value (leastActive)
            int[] leastIndexes = new int[length];
            // the weight of every invokers
            // 每一個提供者的權重
            int[] weights = new int[length];
            // The sum of the warmup weights of all the least active invokers
            // 最少活躍提供者的總權重
            int totalWeight = 0;
            // The weight of the first least active invoker
            int firstWeight = 0;
            // Every least active invoker has the same weight value?
            // 所有的最少活躍提供者是否擁有同樣的權重值
            boolean sameWeight = true;
    
    
            // Filter out all the least active invokers
            for (int i = 0; i < length; i++) {
                Invoker<T> invoker = invokers.get(i);
                // Get the active number of the invoker
                // 活躍數量
                int active = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName()).getActive();
                // Get the weight of the invoker's configuration. The default value is 100.
                // 獲取權重值
                int afterWarmup = getWeight(invoker, invocation);
                // save for later use
                // 保存權重留着後面用
                weights[i] = afterWarmup;
                // If it is the first invoker or the active number of the invoker is less than the current least active number
                // 如果是第一個提供者,或者當前活躍數量比最少的少
                if (leastActive == -1 || active < leastActive) {
                    // Reset the active number of the current invoker to the least active number
                    // 重置最少活躍數量
                    leastActive = active;
                    // Reset the number of least active invokers
                    // 重置最少活躍提供者的數量
                    leastCount = 1;
                    // Put the first least active invoker first in leastIndexes
                    // 把最少活躍提供者的索引保存起來
                    leastIndexes[0] = i;
                    // Reset totalWeight
                    // 重置總權重
                    totalWeight = afterWarmup;
                    // Record the weight the first least active invoker
                    // 記錄第一個最少活躍提供者的權重
                    firstWeight = afterWarmup;
                    // Each invoke has the same weight (only one invoker here)
                    // 每個最少活躍提供者是否有同樣的權重???
                    sameWeight = true;
                    // If current invoker's active value equals with leaseActive, then accumulating.
                    // 如果當前活躍數量等於最少活躍數量
                } else if (active == leastActive) {
                    // Record the index of the least active invoker in leastIndexes order
                    // 最少活躍提供者的索引依次放入 leastIndexes
                    leastIndexes[leastCount++] = i;
                    // Accumulate the total weight of the least active invoker
                    // 累計最少活躍提供者的總權重
                    totalWeight += afterWarmup;
                    // If every invoker has the same weight?
                    // 如果當前權重和第一個最少活躍的權重不同,sameWeight 設為false
                    if (sameWeight && afterWarmup != firstWeight) {
                        sameWeight = false;
                    }
                }
            }
            // Choose an invoker from all the least active invokers
            // 最少活躍提供者只有一個,直接返回
            if (leastCount == 1) {
                // If we got exactly one invoker having the least active value, return this invoker directly.
                return invokers.get(leastIndexes[0]);
            }
            // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
            if (!sameWeight && totalWeight > 0) {
                // If (not every invoker has the same weight & at least one invoker's weight>0), select randomly based on 
                // totalWeight.
                int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
                // Return a invoker based on the random value.
                for (int i = 0; i < leastCount; i++) {
                    int leastIndex = leastIndexes[i];
                    offsetWeight -= weights[leastIndex];
                    if (offsetWeight < 0) {
                        return invokers.get(leastIndex);
                    }
                }
            }
            // 權重相同,隨機選取一個
            // If all invokers have the same weight value or totalWeight=0, return evenly.
            return invokers.get(leastIndexes[ThreadLocalRandom.current().nextInt(leastCount)]);
        }
    

    ShortestResponseLoadBalance

    最短時間調用調用算法是指預估出來每個處理完請求的提供者所需時間,然後又選擇最少最短時間的提供者進行調用,整體處理邏輯和最少活躍數算法基本相似

    dubbo 在實現該算法時的具體邏輯如下

    1. 選取所有預估處理時間最短的提供者
    2. 如果只有一個,直接返回
    3. 如果權重不同,加權隨機選擇一個
    4. 如果權重相同,隨機選擇一個
        @Override
        protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
            // Number of invokers
            int length = invokers.size();
            // Estimated shortest response time of all invokers
            // 最少響應時間
            long shortestResponse = Long.MAX_VALUE;
            // The number of invokers having the same estimated shortest response time
            // 最少響應時間的提供者數量
            int shortestCount = 0;
            // The index of invokers having the same estimated shortest response time
            int[] shortestIndexes = new int[length];
            // the weight of every invokers
            int[] weights = new int[length];
            // The sum of the warmup weights of all the shortest response  invokers
            // 最少響應時間的提供者的總權重
            int totalWeight = 0;
            // The weight of the first shortest response invokers
            // 第一個最少響應時間的權重
            int firstWeight = 0;
            // Every shortest response invoker has the same weight value?
            // 所有的最少響應時間提供者是否擁有同樣的權重值
            boolean sameWeight = true;
    
            // Filter out all the shortest response invokers
            for (int i = 0; i < length; i++) {
                Invoker<T> invoker = invokers.get(i);
                RpcStatus rpcStatus = RpcStatus.getStatus(invoker.getUrl(), invocation.getMethodName());
                // Calculate the estimated response time from the product of active connections and succeeded average elapsed time.
                //  平均響應成功時間
                long succeededAverageElapsed = rpcStatus.getSucceededAverageElapsed();
                // 活躍的連接連接數量
                int active = rpcStatus.getActive();
                // 預估響應時間
                long estimateResponse = succeededAverageElapsed * active;
                // 獲取權重值
                int afterWarmup = getWeight(invoker, invocation);
                // 保存權重留着後面用
                weights[i] = afterWarmup;
                // Same as LeastActiveLoadBalance
                // 如果預估時間小於最少的響應時間
                if (estimateResponse < shortestResponse) {
                    // 重置最少響應時間
                    shortestResponse = estimateResponse;
                    // 最少響應時間的提供者數量設為1
                    shortestCount = 1;
                    // 保存提供者下標
                    shortestIndexes[0] = i;
                    // 重置最少響應時間的提供者的總權重
                    totalWeight = afterWarmup;
                    // 重置第一個最少響應時間的權重
                    firstWeight = afterWarmup;
                    sameWeight = true;
                    // 如果當前最少響應時間等於最少響應時間
                } else if (estimateResponse == shortestResponse) {
                    // 最少最少響應時間的下標依次放入 shortestIndexes
                    shortestIndexes[shortestCount++] = i;
                    // 累計最少響應時間的總權重
                    totalWeight += afterWarmup;
                    // 如果當前權重和第一個最少響應時間的權重不同,sameWeight 設為false
                    if (sameWeight && i > 0
                            && afterWarmup != firstWeight) {
                        sameWeight = false;
                    }
                }
            }
            // 最少最少響應時間只有一個,直接返回
            if (shortestCount == 1) {
                return invokers.get(shortestIndexes[0]);
            }
            // 如擁有不同的權重,在權重的基礎上隨機選取一個,可以參考 RandomLoadBalance,有同樣的寫法
            if (!sameWeight && totalWeight > 0) {
                int offsetWeight = ThreadLocalRandom.current().nextInt(totalWeight);
                for (int i = 0; i < shortestCount; i++) {
                    int shortestIndex = shortestIndexes[i];
                    offsetWeight -= weights[shortestIndex];
                    if (offsetWeight < 0) {
                        return invokers.get(shortestIndex);
                    }
                }
            }
            // 權重相同,隨機選取一個
            return invokers.get(shortestIndexes[ThreadLocalRandom.current().nextInt(shortestCount)]);
        }
    

    ConsistentHashLoadBalance

    一致性hash算法是一種廣泛應用與分佈式緩存中的算法,該算法的優勢在於新增和刪除節點后,只有少量請求發生變動,大部分請求仍舊映射到原來的節點
    為了防止節點過少,造成節點分佈不均勻,一般採用虛擬節點的方式,dubbo默認的是160個虛擬節點

    網上關於一致性hash算法的文章有很多,這裏就不再多贅述,以下是dubbo中的實現,需要說明的是, 一致性hash算法中權重配置不起作用

        @Override
        protected <T> Invoker<T> doSelect(List<Invoker<T>> invokers, URL url, Invocation invocation) {
            String methodName = RpcUtils.getMethodName(invocation);
            // {group}/{interfaceName}:{version} + methoName 獲取當前消費者的唯一標示
            String key = invokers.get(0).getUrl().getServiceKey() + "." + methodName;
            // using the hashcode of list to compute the hash only pay attention to the elements in the list
            int invokersHashCode = invokers.hashCode();
            // 獲取當前消費者的一致性hash選擇器
            ConsistentHashSelector<T> selector = (ConsistentHashSelector<T>) selectors.get(key);
            // 如果 selector 還沒初始化,或者 invokers 已經變化,重新初始化 selector
            if (selector == null || selector.identityHashCode != invokersHashCode) {
                selectors.put(key, new ConsistentHashSelector<T>(invokers, methodName, invokersHashCode));
                selector = (ConsistentHashSelector<T>) selectors.get(key);
            }
            return selector.select(invocation);
        }
        // 一致性hash選擇器
        private static final class ConsistentHashSelector<T> {
    
            // 存儲hash環的數據結構 節點 -> 提供者
            private final TreeMap<Long, Invoker<T>> virtualInvokers;
    
            // 虛擬節點數量
            private final int replicaNumber;
    
            // 用來標示所有提供者是唯一標示
            private final int identityHashCode;
            // 用來存儲計算hash值參數下標的數組,例如計算第一個和第三個參數 該數組為[0,2]
            private final int[] argumentIndex;
    
            ConsistentHashSelector(List<Invoker<T>> invokers, String methodName, int identityHashCode) {
                this.virtualInvokers = new TreeMap<Long, Invoker<T>>();
                this.identityHashCode = identityHashCode;
                URL url = invokers.get(0).getUrl();
                // 虛擬節點數量,默認 160
                this.replicaNumber = url.getMethodParameter(methodName, HASH_NODES, 160);
                // 默認只對第一個參數進行hash
                String[] index = COMMA_SPLIT_PATTERN.split(url.getMethodParameter(methodName, HASH_ARGUMENTS, "0"));
                argumentIndex = new int[index.length];
                for (int i = 0; i < index.length; i++) {
                    argumentIndex[i] = Integer.parseInt(index[i]);
                }
                for (Invoker<T> invoker : invokers) {
                    String address = invoker.getUrl().getAddress();
                    // 關於這個地方為什麼要除以4,我理解的是md5後為16字節的數組,計算hash值只需要用到四個字節,所以可以用四次
                    // 因此除以4,算是一個性能優化點
                    for (int i = 0; i < replicaNumber / 4; i++) {
                        // md5, 獲得一個長度為16的字節數組
                        byte[] digest = md5(address + i);
                        for (int h = 0; h < 4; h++) {
                            // 如果h=0,則用第0,1,2,3四個字節進行位運算,得出一個0-2^32-1的值
                            // 如果h=1,則用第4,5,6,7四個字節進行位運算,得出一個0-2^32-1的值
                            // 如果h=2,則用第8,9,10,11四個字節進行位運算,得出一個0-2^32-1的值
                            // 如果h=3,則用第12,13,14,15四個字節進行位運算,得出一個0-2^32-1的值
                            long m = hash(digest, h);
                            virtualInvokers.put(m, invoker);
                        }
                    }
                }
            }
    
            public Invoker<T> select(Invocation invocation) {
                String key = toKey(invocation.getArguments());
                byte[] digest = md5(key);
                return selectForKey(hash(digest, 0));
            }
            // 根據配置生成計算hash值的key
            private String toKey(Object[] args) {
                StringBuilder buf = new StringBuilder();
                for (int i : argumentIndex) {
                    if (i >= 0 && i < args.length) {
                        buf.append(args[i]);
                    }
                }
                return buf.toString();
            }
    
            private Invoker<T> selectForKey(long hash) {
                // 找到hash值在hash環上的位置
                // ceilingEntry 方法返回大於或者等於當前key的鍵值對
                Map.Entry<Long, Invoker<T>> entry = virtualInvokers.ceilingEntry(hash);
                // 如果返回為空,說明落在了hash環中2的32次方-1的最後,直接返回第一個
                if (entry == null) {
                    entry = virtualInvokers.firstEntry();
                }
                return entry.getValue();
            }
            // 得出一個0-2^32-1的值, 四個字節組成一個長度為32位的二進制数字並轉化為long值
            private long hash(byte[] digest, int number) {
                return (((long) (digest[3 + number * 4] & 0xFF) << 24)
                        | ((long) (digest[2 + number * 4] & 0xFF) << 16)
                        | ((long) (digest[1 + number * 4] & 0xFF) << 8)
                        | (digest[number * 4] & 0xFF))
                        & 0xFFFFFFFFL;
            }
    
            private byte[] md5(String value) {
                MessageDigest md5;
                try {
                    md5 = MessageDigest.getInstance("MD5");
                } catch (NoSuchAlgorithmException e) {
                    throw new IllegalStateException(e.getMessage(), e);
                }
                md5.reset();
                byte[] bytes = value.getBytes(StandardCharsets.UTF_8);
                md5.update(bytes);
                return md5.digest();
            }
    
        }
    

    總結

    以上就是dubbo負載均衡源碼的全部解析,如果還是不明白,可以看下官方文檔的解析  
    http://dubbo.apache.org/zh-cn/docs/source_code_guide/loadbalance.html

    dubbo的負載均衡算法總體來說並不複雜,代碼寫的也很優雅,簡潔,看起來很舒服,而且有很多細節的處理值得稱讚,例如預熱處理,輪訓算法的平滑處理等。

    我們平時使用時,可以根據自己的業務場景,選擇適合自己的算法,當然,一般情況下,默認的的隨機算法就能滿足我們的日常需求,而且隨機算法的性能足夠好。

    如果覺得dubbo提供的五種算法都不能滿足自己的需求,還可以通過dubbo的SPI機制很方便的擴展自己的負載均衡算法。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

    ※教你寫出一流的銷售文案?

  • 從0到1打造數據可信的數據產品:解析數據治理在過程可信變革中的運作流程

    從0到1打造數據可信的數據產品:解析數據治理在過程可信變革中的運作流程

    摘要:本文針對“數據牽引改進,工具固化規範”這一思路在業務團隊落地過程中的動作流程進行詳細闡述,並明確了支撐整個流程的關鍵角色定義和組織運作形式。

    目的

    為實現雲服務開發的過程可信,需要基於數據對各個服務產品部的可信變革動作進行數據採集、進展可視、目標牽引、能力評估,最終用數據反映目標達成。與傳統的“基於數據晾曬驅動業務團隊改進,6+1指標度量”的運作方式有本質的區別,我們是基於統一的作業工具上產生的客觀數據呈現,識別研發過程中基本的流程斷裂點和質量缺失動作,和業務團隊達成一致的目標后,把大部分改進動作固話到作業工具中自動化承載,我們稱這個思路為“數據牽引改進,工具固化規範”,也就是我們不僅告訴業務團隊哪裡有問題,同時也要基於我們的作業工具,輔助業務團隊一起改進完善。

    本文針對“數據牽引改進,工具固化規範”這一思路在業務團隊落地過程中的動作流程進行詳細闡述,並明確了支撐整個流程的關鍵角色定義和組織運作形式。

    數據牽引改進,是指關注軟件交付過程中各種度量數據的收集、統計、分析和反饋,通過可視化的數據客觀反映整個研發過程的狀態,以全局視角分析系統約束點,並和業務團隊達成共識,提煉出客觀有效的改進目標;工具固化規範,針對識別出來的Gap點和重點問題進行分析,制定出可以在作業工具承載的模板規範,以及需要工程師行為做出改變的能力要求,並在作業工具上對這些規範要求的落地效果進行檢查,用數據度量改進效果。最後,對改進項目進行總結分享,打造學習型組織,不斷驅動持續改進和價值交付,牽引研發團隊模式和文化的轉變。

    2020年的研發過程可信圍繞CleanCode、構建、開源、E2E追溯四個領域開展,這也是公司要求的可信變革中最基本、最重要、投入產出比最大的四個點。

    整體流程說明

    整個運作流程,圍繞數據,按照“定義軟件工程規範->定義數據分析模型->工具實現數據度量和分析->數據運營發現實際軟件工程活動和規範的偏差->工具輔助團隊改進->工具固化軟件工程規範”這個流程進行實施,並對最終效果進行階段性總結。隨着業務團隊能力的提升以及軟件工程規範性、開發模式的改變,對最初定義的軟件工程規範,會階段性的進行完善,循環往複、持續優化,最終讓業務團隊在遵守公司要求的研發過程可信規範的前提下,實現業務成功。

    1) 定義軟件工程規範:圍繞公司可信變革的目標,BU對各個服務產品部的研發模式規範和能力要求,COE制定適合BU現狀的軟件工程規範;

    2) 定義數據模型:COE針對制定的軟件工程規範,提煉出核心的、有針對性、可用工具度量的數據模型,並且和各個服務產品部達成一致;

    3) 工具實現數據度量和分析:根據這幾個數據模型,數據分析工具自動從數據源進行採集、匯總、計算,並把結果呈現在數據看板上;業務團隊可以打開匯總數據,根據明細數據進行動作規範自檢和改進;

    4) 數據運營發現實際軟件工程活動和規範的偏差:數據治理小組在實際運營過程中,分析度量指標的數據,識別業務團隊實際的軟件工程活動和要求規範不一致的Gap點和關鍵問題;

    5) 工具輔助業務團隊改進:COE針對分析出來的Gap點和關鍵問題,制定相應的改進措施,作業工具承載流程規範模板化整改,並針對業務團隊的不規範行為,制定適合各個服務產品部的公約要求,促使業務團隊人員能力提升;

    6) 工具固化軟件工程規範:針對業務團隊的公約要求,在作業工具上進行check,最終作業工具承載了整個軟件工程規範要求,以及融入到作業流程中的規範要求事前檢查。

    三層數據分析模型

    我們採用了三層數據分析模型,由作業工具自動採集用戶研發過程行為明細數據,數據分析工具進行准實時匯總計算呈現總體目標,三層數據系統性的輔助業務團隊系統性的識別研發過程中的不規範點和能力短板,讓業務團隊“知其然,知其所以然”。這三層數據模型是層層深入,迭代完善,下層支撐上層的關係。

    第一層:目標、進展、結果數據分析;和公司可信變革目標牽引對齊,結合BU實際情況,形成BU的整體可信要求,並在數據分析看板上呈現各個服務產品部要達成的過程可信目標、每日的改進進展和最終完成情況;例如,對各個服務產品部要求達成CleanCode的目標。

    第二層:詞法/語法分析數據;COE針對第一層的目標牽引,分解出來的具體實施環節的度量指標,只有這些分解的指標都完成,第一層的目標才達成。這一層數據的目的主要是圍繞幫助業務團隊分析自己的能力短板在哪裡,進行有針對性的改進指;通過打開匯總數據的層層下鑽,用明細數據來分析業務團隊在DevSecOps軟件工程規範流程中關鍵動作執行的缺失點,並針對性的制定改進規範要求,牽引作業工具或者業務團隊補齊該部分缺失動作;例如,CleanCode的過程可信目標達成,可以分解成:靜態檢查配置合規率、Committer合入保障率、代碼倉Clean三個目標,只有這三個目標達成,就可以認為CleanCode總體目標達成。

    第三層:語義分析數據:COE打開第二層數據,不僅要看這些關鍵動過做沒做,還要看做的效果怎麼樣,最終效果體現在業務團隊的DevSecOps軟件工程規範提升;這一層的數據分析聚焦在防止為了指標而做第二層的數據,而是看業務團隊是否在真正參考BU制定的規範牽引的目標,提升業務交付過程中的效能、可信、質量能力,以及最終產生實際的業務效果。通過打開各個團隊的明細數據分析審視業務團隊執行的關鍵動作是否符合規範,是否在合適的階段點執行,執行效果是否有效;並階段性的總結和提煉經驗,形成知識資產固化到作業工具。例如,針對第二層的靜態檢查配置合規率,可以分解為:靜態檢查配置有效性和靜態檢查執行有效性。靜態檢查配置有效性,包括:檢查靜態檢查工具配置的數量、是否符合BU的配置規範,以及是否在代碼合入主幹master時進行了配置;靜態檢查執行有效性,主要看是否每一次MR提交時都執行靜態檢查、是否發現問題在研發活動的最早階段,攔截的問題的效果怎麼樣。只有第三層的動作度量都達成后,才可以說第二層的目標是達成的。

    數據治理過程流程圖

    為了實現“數據牽引改進,工具固化規範”這個目標,準確、一致、准實時的數據是核心關鍵,但因為數據採集不完整、業務團隊不規範、數據呈現維度不一致等原因,數據的準確性有一個不斷提升的過程,因此需要對各個層級展示的數據進行治理。整個數據治理過程中,由“業務團隊/作業工具/治理小組/數據分析工具(阿基米德)/COE”五個角色緊密配合,而且以年/半年為目標,不斷總結經驗,循環往複、持續優化的過程。

    a) COE:和公司可信變革目標牽引對齊,結合BU能力現狀,形成BU的整體可信要求;

    b) COE:針對BU的業務現狀,定義出適合BU現狀的軟件工程規範要求;業務團隊:和BU發布的各個領域的軟件工程規範牽引目標達成一致;

    c) COE:針對規範分解出核心的度量指標,並制定度量數據模型;

    d) 研發用戶:在使用作業工具進行研發活動;作業工具:承載了BU各個服務產品部在使用過程中沉澱的行為數據;

    e) 數據分析(阿基米德):准實時接入作業工具的數據,展示各個服務產品部當前的研發能力現狀;

    f) COE:和各個服務產品部達成一致,制定各個服務產品部的年度牽引目標;

    g) 數據分析(阿基米德):用數據呈現各個服務產品部的牽引目標和能力現狀,統一數據口徑;呈現月/周/天的明細數據,以及支撐Gap分析和重點問題的數據視圖;

    h) COE:根據牽引目標和能力現狀,分析Gap原因和關鍵問題;治理小組:在數據運營過程中,根據數據分析團隊當前的能力現狀是否和數據呈現一致;

    i) 研發用戶:可以實時登錄數據工具(阿基米德)進行查看各個層級的明細數據;

    j) 治理小組:根據准實時進展數據,分析當前團隊研發過程中的實際問題,並匯總給COE;

    k) COE:結合細粒度的分析數據、以及治理小組匯總出來的各個服務產品部的實際問題,制定規範和改進措施,包括作業工具的規範和研發用戶的動作行為公約;

    l) 作業工具:承載作業工具上落地的規範要求;治理小組:作為接口人,承接研發工程師的行為規範公約,結合各個服務產品部實際情況來負責落地;

    m) 研發用戶:按照規範要求和針對數據的自檢進行研發過程行為規範化;

    n) 研發工具:對研發用戶的行為規範是否滿足要求進行自動化檢查;最終目標是讓整個軟件工程規範都固化在工具中進行承載;

    o) 數據分析(阿基米德):呈現按照規範改進后的明細數據和匯總目標;研發用戶:自助查看整改后的明細數據;

    p) COE:根據數據改進的效果,以及過程中暴露的問題進行總結后形成經驗資產,並持續改進;

    數據流圖

    過程可信的數據在各個工具系統中採集、流轉、匯聚、分析、呈現,整個數據流圖如下:

    其中,識別出6個重要的全量數據源:

    a) 代碼庫數據:該數據由伏羲的服務信息樹上配置的代碼庫數據,加上阿基米德上人工配置的代碼庫,構成各個雲服務發布到生產倉的代碼全集;

    b) Workitem信息流數據:當前識別vision上的需求、問題、task,加上Gitlab/Codeclub上的issue,構成可識別的Workitem數據全集;

    c) SRE現網包數據:包括普羅部署、CCE、CPS、CDK各種類型部署的包數據,構成全量現網包數據;

    d) 開源二進制包數據:開源中心倉數據(java、python、go、nodejs四種)語言,加上公司c/c++的數據構成全量開源二進制包數據;

    e) 研發過程配置數據:阿基米德上配置的committer數據是全量的committer數據;阿基米德上識別出來的主分支是全量的主分支(邏輯“master”)數據;

    f) 伏羲研發過程數據:伏羲三個庫,MongoDB的靜態檢查、門禁數據;MySQL中的測試、發布數據;MySQL中包和多個流水線的對應關係數據;一起構成了以“包”為維度的全量伏羲研發過程數據;

    運作組織

    數據治理運營團隊

    按照過程可信在BU的落地策略,在CleanCode、構建、開源、E2E追溯四個領域設置數據治理運營團隊,由 “數據分析工具(阿基米德)—COE—各個服務產品部接口人組成的治理小組”三個角色組成,以“指標度量為牽引,數據的客觀呈現為落地方式,業務的價值反饋為最終目的”的原則來落地數據治理工作。

    COE的職責:

    1) 和公司可信變革目標牽引對齊,結合BU能力現狀,形成BU的整體可信要求;定義出適合BU現狀的軟件工程規範要求;針對規範分解出核心的度量指標,並制定度量數據模型;

    2) 利用作業工具已經產生的數據,和治理小組一起分析識別數據質量的問題,按照三層數據分析模型,層層打開,識別業務團隊能力Gap點。

    3) 分析典型問題,識別作業流的斷裂點進行補齊,和業務團隊的不規範動作,制定規範和公約要求,逐步改善數據質量。

    4) 事後歸納總結,識別出流程缺失,組織缺失,責任缺失等機制行問題,並固化到作業工具中。

    治理小組:

    1) 結合各個服務產品部的實際情況,承接COE的數據治理規範在各個服務產品部的落地;

    2) 識別數據治理動作在各個服務產品部落地過程中的實際問題,和COE一起分析,提出系統性的解決思路,最終固化到作業工具中。

    3) 跟蹤過程可信在業務團隊落地的過程中的進展,為業務團隊最終達成可信變革目標負責,為改進過程產生實際的業務價值負責;

    數據分析工具(阿基米德):

    1) 確保接入的數據準確、實時、一致,用數據實時反映BU各個服務產品部的能力現狀,為COE和治理小組的數據運營提供數據支撐;

    2) 系統性的落地COE的方案設計,實現整個BU統一標準的數據看板,能夠清晰的通過數據識別出來業務團隊的能力Gap,牽引業務團隊達成整體改進目標;

    3) 按照三層數據模型進行數據展示,層層下鑽,讓業務團隊“知其然,知其所以然”,牽引業務團隊中的每一個人都能自己進行改進;

    4) 通過數據分析,識別DevSecOps軟件工程規範在BU的業務團隊落地過程中的重點問題,以及該問題背後的流程、制度缺失,促使最終規範固化在作業工具中。

    例會設置

    “數據驅動DevSecOps能力提升例會”為研發領域數據治理相關問題的求助和裁決例會。

    會議分為三個階段:

    1) 第一階段,例行議題,形式類似於“體檢報告”,用數據反映業務團隊的現狀和問題;

    2) 第二階段,申報議題,形式類似於“專家會診”,討論某一個具體數據治理過程中的問題和Top困難求助;

    3) 第三階段,靈活安排議題,形式類似於“問題總結”,針對某一類的具體問題,進行集中討論和歸納總結定義,形成BU的規範流程和章程總結。

    主數據承載系統

    主數據是指具有高業務價值的、可以在企業內跨越多個業務部門被重複使用的數據,是單一、準確、權威的數據來源。和業務型數據、分析型數據相比,主數據主要有以下幾個特徵:

    1) 特徵一致性:也就是能否保證主數據的關鍵特徵在不同應用、不同系統中的高度一致,直接關係了數據治理成敗;

    2) 識別唯一性:在一個系統、一個平台,甚至一個企業範圍內,同一主數據實體要求具有唯一的數據標識,即數據編碼;

    3) 長期有效性:貫穿該業務對象的整個生命周期甚至更長,當該主數據失去其效果時,系統採取的措施通常為軟刪除,而不是物理刪除;

    4) 業務穩定性:在業務過程中其識別信息和關鍵特徵會被業務過程中產生的數據繼承、引用和複製。除非該主數據本身的特徵發生變化,否則該主數據不會隨着業務的過程中被其他系統修改。

    主數據源識別原則:

    a) 如果有多個數據源構成同類型數據的主數據,兩種處理策略:

    1)選取一個源系統逐步收編其他源系統的數據,變成唯一主數據源

    2)如果1)不能實現,由阿基米德系統進行封裝后屏蔽多個數據源系統,該類型數據的唯一數據源變成阿基米德,待後續1)實現后,阿基米德該類型主數據源失效。

    3)當數據在多個作業系統中進行流轉時,判斷是否作為主數據源的標準是:數據在該系統有實際的業務動作產生,而不是只承載數據的流轉。

    b) 如果確定為唯一數據源,其他消費該類型數據的系統不能和數據源產生衝突。

    所有數據僅能在數據源產生,其它系統只能讀取不能修改。下游發現的數據源質量問題,應當在數據源頭進行修正。

    c) 主數據使用方不得改變原始數據,但可以進行擴展。

    數據消費方不得對獲取的數據進行增、刪、改,但可以在數據的基礎上進行屬性擴展。

    d) 在滿足信息安全的前提下充分共享,不得拒絕合理的數據共享需求。

    數據如果不流轉,不僅不會產生業務價值,還增加存儲成本;只有不斷流轉,對業務團隊產生實際價值時,還能得到使用效果的反饋,促進數據價值的進一步提升。

    原則為:核心資產安全優先,非關鍵資產效率優先。

    一類主數據源

    二類主數據源


    點擊關注,第一時間了解華為雲新鮮技術~

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

    ※別再煩惱如何寫文案,掌握八大原則!

  • Shader專題:卡通着色(一)控制顏色的藝術

    Shader專題:卡通着色(一)控制顏色的藝術

    什麼是 Shader?

    關於什麼是 Shader ,各種百科各種教程都有說過,但是今天我們就從一個另一個角度去試着理解什麼是 Shader?

    我們先看下 Shade 的英文意思,如下:
    v.給…遮擋(光線);把…塗暗

    其中 把…塗暗 更貼近我們想要的意思。
    所以:Shader 這個單詞從字面上理解,就是把什麼東西塗暗。

    再強調一次:Shader 從單詞字面上理解,就是把什麼東西塗暗。
    再強調一次:把什麼東西塗暗的就是 Shader,就是着色器。

    Shader 把什麼塗暗了?

    當然是遊戲世界的各個物體,總所周知:有光明就有黑暗,有光照物體就有明暗對比,同時也會有陰影,而 Shader 之所以叫 Shader 是因為起初的時候,Shader 就是用來給物體增加明暗對比的,有了明暗對比,物體在遊戲世界中就會更加立體,從而畫面會更加真實。

    所以 Shader 的作用就是給物體添加明暗對比。

    Shader 為什麼叫 Shader

    當然以上純屬個人推測。現在 Shader 不止可以給物體添加明暗對比,而且還可以做很多濾鏡效果,也可以做很多性能優化(比如減少包大小、減少圖片內存等)的事情。

    也許,一開始給 Shader 起名叫 Shader 的時候,Shader 功能非常有限,僅僅只是給物體添加明暗對比(也就是光照計算),後來由於硬件和軟件的發展, 很多離線渲染(電影 CG)的算法都逐步應用在實時渲染(主要是 遊戲 和3D 仿真等),Shader 能做的事情就越來越多,發展到今天,Shader 主要的功能並不只有光照計算。這樣導致,在概念理解上給很多初學者增加了很多阻礙。

    教練有一次聽過一位搞圖形學的朋友說:“我們搞實時渲染的都是那些搞視頻(離線渲染)玩剩的”。

    Shader 是着色器

    什麼是 Shader,中文叫做着色器,也就是給物體上色的意思,也就是說寫 Shader 就是給物體上色的藝術。而這個上色不只是簡單的色彩填充,而是涵蓋了非常多的技巧(幾何計算、顏色計算、貼圖等)

    所以中文的着色器,是一個非常精準的翻譯。

    群內的笑笑說了一個比較不錯的說法:Shader 主要是光線數據作用在不同數據的物體上產生不同效果。

    Shader 學習的順序

    不管是 Shader 還是其它某個科目,都有一些最常用、最簡單的知識點。

    而這些知識點很容易學以致用,也就是說,這種知識點,我們學習完了就能馬上落地。

    所以,教練要做的就是,把 Shader 中的知識點按照是否常用和是否簡單這兩個維度進行排列篩選,然後把它們一個個整理成案例,這樣童鞋們的學習體驗就會大幅上升。

    主題式研究第三個階段

    • 第一個階段:確定主題(關鍵字)
    • 第二個階段:搜索資料、搜索信息(搜集情報)
    • 第三個階段:構建知識體系(畫腦圖、寫大綱)

    到此,Shader 這個主題,我們目前已經到了第三個階段,也就是構建知識體系的階段。

    當然,這一整篇,都再講,我們要怎麼怎麼做,接下來幹嗎,並沒有學習 Shader 的任何一個知識點。

    那麼今天就學習一點 Shader 知識意思一下。

    顏色的控制

    現有一張貼圖,如下:

    用來控制顏色的 shader 代碼如下:

    float4 frag (v2f i) : SV_Target
    {
        // 圖片上每個像素的顏色值
        float4 color = tex2D(_MainTex, i.uv);
                    
        // 返回顏色,表示將改像素的顏色值輸出到屏幕上
        return color;
    }
    

    我們只看方法中的代碼,先不要在意一些細節。

    雖然,我們沒有 Shader 的語法學習經驗,但是憑我們的 C# 經驗,可以將上述代碼推測個大概來。

    首先 float4 是一個類型,可以存儲 4 個 float 數值。而顏色一般都是由 r(red 紅色)、g(green,綠色)、b(blue,藍色)、a(alpha,透明度) 四個值控制。所以 float4 可以存儲一個顏色。

    現在,我們把圖片中每個像素顏色重的紅色值設置為 0,圖片結果則如下所示:

    代碼如下所示:

    float4 frag (v2f i) : SV_Target
    {
        // 圖片上每個像素的顏色值
        float4 color = tex2D(_MainTex, i.uv);
                    
        color.r = 0;
    
        // 返回顏色,表示將改像素的顏色值輸出到屏幕上
        return color;
    }
    

    我們看到,圖片變成了藍綠色。

    小結

    Shader 是一門控制顏色的藝術,Shader 的核心也是如此。
    在此篇,我們學習了 Shader 的兩個重要知識點:

    1. float4 結構體
    2. 顏色的 rgb 控制

    這兩個知識點非常簡單,也非常基礎,但是是非常常用的兩個知識點。

    這片文章的內容就這些。

    知識地圖

    相關下載:

    轉載請註明地址:liangxiegame.com

    更多內容
    QFramework 地址:https://github.com/liangxiegame/QFramework
    QQ 交流群:623597263
    涼鞋的主頁:https://liangxiegame.com/zhuanlan
    關注公眾號:liangxiegame 獲取第一時間更新通知及更多的免費內容。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※南投搬家前需注意的眉眉角角,別等搬了再說!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

  • 理解C#中的ValueTask

    原文:https://devblogs.microsoft.com/dotnet/understanding-the-whys-whats-and-whens-of-valuetask/
    作者:Stephen
    翻譯:xiaoxiaotank
    備註:本文要求讀者對Task有一定的了解,文章文字描述較多,但內容十分充實,相信你認真閱讀後,一定讓你受益匪淺。

    前言

    Task類是在.NET Framework 4引入的,位於System.Threading.Tasks命名空間下,它與派生的泛型類Task<TResult>已然成為.NET編程的主力,也是以async/await(C# 5引入的)語法糖為代表的異步編程模型的核心。

    隨後,我會向大家介紹.NET Core 2.0中的新成員ValueTask/ValueTask<TResult>,來幫助你在日常開發用例中降低內存分配開銷,提升異步性能。

    Task

    雖然Task的用法有很多,但其最核心的是“承諾(promise)”,用來表示某個操作最終完成。

    當你初始化一個操作后,會獲取一個與該操作相關的Task,當這個操作完成時,Task也同樣會完成。這個操作的完成情況可能有以下幾種:

    • 作為初始化操作的一部分同步完成,例如:訪問一些已被緩存的數據
    • 恰好在你獲取到Task實例的時候異步完成,例如:訪問雖然沒被緩存但是訪問速度非常快的數據
    • 你已經獲取到了Task實例,並等待了一段時間后,才異步完成,例如:訪問一些網絡數據

    由於操作可能會異步完成,所以當你想要使用最終結果時,你可以通過阻塞來等待結果返回(不過這違背了異步操作的初衷);或者,使用回調方法,它會在操作完成時被調用,.NET 4通過Task.ContinueWith方法顯式實現了這個回調方法,如:

    SomeOperationAsync().ContinueWith(task =>
    {
        try
        {
            TResult result = task.Result;
            UseResult(result);
        }
        catch(Exception ex)
        {
            HandleException(ex);
        }
    })
    

    而在.NET 4.5中,Task通過結合await,大大簡化了對異步操作結果的使用,它能夠優化上面說的所有情況,無論操作是同步完成、快速異步完成還是已經(隱式地)提供回調之後異步完成,都不在話下,寫法如下:

    TResult result = await SomeOperationAsync();
    UseResult(result);
    

    Task作為一個類(class),非常靈活,並因此帶來了很多好處。例如:

    • 它可以被任意數量的調用者併發await多次
    • 你可以把它存儲到字典中,以便任意數量的後續使用者對其進行await,進而把這個字典當成異步結果的緩存
    • 如果需要的話,你可以通過阻塞等待操作完成
    • 另外,你還可以對Task使用各種各樣的操作(稱為“組合器”,combinators),例如使用Task.WhenAny異步等待任意一個操作率先完成。

    不過,在大多數情況下其實用不到這種靈活性,只需要簡單地調用異步操作並await獲取結果就好了:

    TResult result = await SomeOperationAsync();
    UseResult(result);
    

    在這種用法中,我們不需要多次await task,不需要處理併發await,不需要處理同步阻塞,也不需要編寫組合器,我們只是異步等待操作的結果。這就是我們編寫同步代碼(例如TResult result = SomeOperation())的方式,它很自然地轉換為了async/await的方式。

    此外,Task也確實存在潛在缺陷,特別是在需要創建大量Task實例且要求高吞吐量和高性能的場景下。Task 是一個類(class),作為一個類,這意味着每創建一個操作,都需要分配一個對象,而且分配的對象越多,垃圾回收器(GC)的工作量也會越大,我們花在這個上面的資源也就越多,本來這些資源可以用於做其他事情。慶幸的是,運行時(Runtime)和核心庫在許多情況下都可以緩解這種情況。

    例如,你寫了如下方法:

    public async Task WriteAsync(byte value)
    {
        if (_bufferedCount == _buffer.Length)
        {
            await FlushAsync();
        }
        _buffer[_bufferedCount++] = value;
    }
    

    一般來說,緩衝區中會有可用空間,也就無需Flush,這樣操作就會同步完成。這時,不需要Task返回任何特殊信息,因為沒有返回值,返回Task與同步方法返回void沒什麼區別。因此,運行時可以簡單地緩存單個非泛型Task,並將其反覆用作任何同步完成的方法的結果(該單例是通過Task.CompletedTask公開的)。

    或者,你的方法是這樣的:

    public async Task<bool> MoveNextAsync()
    {
        if (_bufferedCount == 0)
        {
            // 緩存數據
            await FillBuffer();
        }
        return _bufferedCount > 0;
    }
    

    一般來說,我們想的是會有一些緩存數據,這樣_bufferedCount就不會等於0,直接返回true就可以了;只有當沒有緩存數據(即_bufferedCount == 0)時,才需要執行可能異步完成的操作。而且,由於只有true和false這兩種可能的結果,所以只需要兩個Task<bool>對象來分別表示true和false,因此運行時可以將這兩個對象緩存下來,避免內存分配。只有當操作異步完成時,該方法才需要分配新的Task<bool>,因為調用方在知道操作結果之前,就要得到Task<bool>對象,並且要求該對象是唯一的,這樣在操作完成后,就可以將結果存儲到該對象中。

    運行時也為其他類型型維護了一個類似的小型緩存,但是想要緩存所有內容是不切實際的。例如下面這個方法:

    public async Task<int> ReadNextByteAsync()
    {
        if (_bufferedCount == 0)
        {
            await FillBuffer();
        }
    
        if (_bufferedCount == 0)
        {
            return -1;
        }
    
        _bufferedCount--;
        return _buffer[_position++];
    }
    

    通常情況下,上面的案例也會同步完成。但是與上一個返回Task<bool>的案例不同,該方法返回的Int32的可能值約有40億個結果,如果將它們都緩存下來,大概會消耗數百GB的內存。雖然運行時保留了一個小型緩存,但也只保留了一小部分結果值,因此,如果該方法同步完成(緩衝區中有數據)的返回值是4,它會返回緩存的Task<int>,但是如果它同步完成的返回值是42,那就會分配一個新的Task<int>,相當於調用了Task.FromResult(42)。

    許多框架庫的實現也嘗試通過維護自己的緩存來進一步緩解這種情況。例如,.NET Framework 4.5中引入的MemoryStream.ReadAsync重載方法總是會同步完成,因為它只從內存中讀取數據。它返回一個Task<int>對象,其中Int32結果表示讀取的字節數。ReadAsync常常用在循環中,並且每次調用時請求的字節數是相同的(僅讀取到數據末尾時才有可能不同)。因此,重複調用通常會返回同步結果,其結果與上一次調用相同。這樣,可以維護單個Task實例的緩存,即緩存最後一次成功返回的Task實例。然後在後續調用中,如果新結果與其緩存的結果相匹配,它還是返回緩存的Task實例;否則,它會創建一個新的Task實例,並把它作為新的緩存Task,然後將其返回。

    即使這樣,在許多操作同步完成的情況下,仍需強制分配Task<TResult>實例並返回。

    同步完成時的ValueTask

    正因如此,在.NET Core 2.0 中引入了一個新類型——ValueTask<TResult>,用來優化性能。之前的.NET版本可以通過引用NuGet包使用:System.Threading.Tasks.Extensions

    ValueTask<TResult>是一個結構體(struct),用來包裝TResult或Task<TResult>,因此它可以從異步方法中返回。並且,如果方法是同步成功完成的,則不需要分配任何東西:我們可以簡單地使用TResult來初始化ValueTask<TResult>並返回它。只有當方法異步完成時,才需要分配一個Task<TResult>實例,並使用ValueTask<TResult>來包裝該實例。另外,為了使ValueTask<TResult>更加輕量化,併為成功情形進行優化,所以拋出未處理異常的異步方法也會分配一個Task<TResult>實例,以方便ValueTask<TResult>包裝Task<TResult>,而不是增加一個附加字段來存儲異常(Exception)。

    這樣,像MemoryStream.ReadAsync這類方法將返回ValueTask<int>而不需要關注緩存,現在可以使用以下代碼:

    public override ValueTask<int> ReadAsync(byte[] buffer, int offset, int count)
    {
        try
        {
            int bytesRead = Read(buffer, offset, count);
            return new ValueTask<int>(bytesRead);
        }
        catch (Exception e)
        {
            return new ValueTask<int>(Task.FromException<int>(e));
        }
    }
    

    異步完成時的ValueTask

    能夠編寫出在同步完成時無需為結果類型產生額外內存分配的異步方法是一項很大的突破,.NET Core 2.0引入ValueTask<TResult>的目的,就是將頻繁使用的新方法定義為返回ValueTask<TResult>而不是Task<TResult>。

    例如,我們在.NET Core 2.1中的Stream類中添加了新的ReadAsync重載方法,以傳遞Memory<byte>來替代byte[],該方法的返回類型就是ValueTask<int>。這樣,Streams(一般都有一種同步完成的ReadAsync方法,如前面的MemoryStream示例中所示)現在可以在使用過程中更少的分配內存。

    但是,在處理高吞吐量服務時,我們依舊需要考慮如何盡可能地避免額外內存分配,這就要想辦法減少或消除異步完成時的內存分配。

    使用await異步編程模型時,對於任何異步完成的操作,我們都需要返回代表該操作最終完成的對象:調用者需要能夠傳遞在操作完成時調用的回調方法,這就要求在堆上有一個唯一的對象,用作這種特定操作的管道,但是,這並不意味着有關操作完成后能否重用該對象的任何信息。如果對象可以重複使用,則API可以維護一個或多個此類對象的緩存,並將其復用於序列化操作,也就是說,它不能將同一對象用於多個同時進行中的異步操作,但可以復用於非并行訪問下的對象。

    在.NET Core 2.1中,為了支持這種池化和復用,ValueTask<TResult>進行了增強,不僅可以包裝TResult和Task<TResult>,還可以包裝新引入的接口IValueTaskSource<TResult>。類似於Task<TResult>,IValueTaskSource<TResult>提供表示異步操作所需的核心支持;

    public interface IValueTaskSource<out TResult>
    {
        ValueTaskSourceStatus GetStatus(short token);
        void OnCompleted(Action<object> continuation, object state, short token, ValueTaskSourceOnCompletedFlags flags);
        TResult GetResult(short token);
    }
    
    • GetStatus用於實現諸如ValueTask<TResult>.IsCompleted之類的屬性,返回指示異步操作是否仍在掛起或是否已完成以及完成情況(成功或失敗)的指示。
    • OnCompleted用於ValueTask<TResult>的等待者(awaiter),它與調用者提供的回調方法掛鈎,當異步操作完成時,等待者繼續執行回調方法。
    • GetResult用於檢索操作的結果,以便在操作完成后,等待者可以獲取TResult或傳播可能發生的任何異常。

    大多數開發人員永遠都不需要用到此接口(指IValueTaskSource<TResult>):方法只是簡單地將包裝該接口實例的ValueTask<TResult>實例返回給調用者,而調用者並不需要知道內部細節。該接口的主要作用是為了讓開發人員在編寫性能敏感的API時可以盡可能地避免額外內存分配。

    .NET Core 2.1中有幾個類似的API。最值得關注的是Socket.ReceiveAsync和Socket.SendAsync,添加了新的重載,例如:

    public ValueTask<int> ReceiveAsync(Memory<byte> buffer, SocketFlags socketFlags, CancellationToken cancellationToken = default);
    

    此重載返回ValueTask<int>。

    如果操作同步完成,則可以簡單地構造具有正確結果的ValueTask<int>,例如:

    int result = …;
    return new ValueTask<int>(result);
    

    如果它異步完成,則可以使用實現此接口的池對象:

    IValueTaskSource<int> vts = …;
    return new ValueTask<int>(vts);
    

    該Socket實現維護了兩個這樣的池對象,一個用於Receive,一個用於Send,這樣,每次未完成的對象只要不超過一個,即使這些重載是異步完成的,它們最終也不會額外分配內存。NetworkStream也因此受益。

    例如,在.NET Core 2.1中,Stream公開了一個方法:

    public virtual ValueTask<int> ReadAsync(Memory<byte> buffer, CancellationToken cancellationToken = default);
    

    NetworkStream的重載方法NetworkStream.ReadAsync,內部實際邏輯只是交給了Socket.ReceiveAsync去處理,所以將優勢從Socket帶到了NetworkStream中,使得NetworkStream.ReadAsync也有效地不進行額外內存分配了。

    非泛型的ValueTask

    當在.NET Core 2.0中引入ValueTask<TResult>時,它純粹是為了優化異步方法同步完成的情況——避免必須分配一個Task<TResult>實例用於存儲TResult。這也意味着非泛型的ValueTask是不必要的(因為沒有TResult):對於同步完成的情況,返回值為Task的方法可以返回Task.CompletedTask單例,此單例由async Task方法的運行時隱式返回。

    然而,隨着即使異步完成也要避免額外內存分配需求的出現,非泛型的ValueTask又變得必不可少。因此,在.NET Core 2.1中,我們還引入了非泛型的ValueTask和IValueTaskSource。它們提供泛型版本對應的非泛型版本,使用方式類似,只是GetResult返回void。

    實現IValueTaskSource / IValueTaskSource

    大多數開發人員都不需要實現這兩個接口,它們也不是特別容易實現。如果您需要的話,.NET Core 2.1的內部有幾種實現可以用作參考,例如

    • AwaitableSocketAsyncEventArgs
    • AsyncOperation
    • DefaultPipeReader

    為了使想要這樣做的開發人員更輕鬆地進行開發,將在.NET Core 3.0中計劃引入ManualResetValueTaskSourceCore<TResult>結構體(譯註:目前已引入),用於實現接口的所有邏輯,並可以被包裝到其他實現了IValueTaskSource和IValueTaskSource<TResult>的包裝器對象中,這個包裝器對象只需要單純地將大部分實現交給該結構體就可以了。

    ValueTask的有效消費模式

    從表面上看,ValueTask和ValueTask<TResult>的使用限制要比Task和Task<TResult>大得多 。不過沒關係,這甚至就是我們想要的,因為主要的消費方式就是簡單地await它們。

    但是,由於ValueTask和ValueTask<TResult>可能包裝可復用的對象,因此,與Task和Task<TResult>相比,如果調用者偏離了僅await它們的設計目的,則它們在使用上實際回受到很大的限制。通常,以下操作絕對不能用在ValueTask/ValueTask<TResult>上:

    • await ValueTask/ValueTask<TResult>多次。

      因為底層對象可能已經被回收了,並已由其他操作使用。而Task/Task<TResult>永遠不會從完成狀態轉換為未完成狀態,因此您可以根據需要等待多次,並且每次都會得到相同的結果。

    • 併發await ValueTask/ValueTask<TResult>。

      底層對象期望一次只有單個調用者的單個回調來使用,並且嘗試同時等待它可能很容易引入競爭條件和細微的程序錯誤。這也是第一個錯誤操作的一個更具體的情況——await ValueTask/ValueTask<TResult>多次。相反,Task/Task<TResult>支持任意數量的併發等待

    • 使用.GetAwaiter().GetResult()時操作尚未完成。

      IValueTaskSource / IValueTaskSource<TResult>接口的實現中,在操作完成前是沒有強制要求支持阻塞的,並且很可能不會支持,所以這種操作本質上是一種競爭狀態,也不可能按照調用方的意願去執行。相反,Task/Task<TResult>支持此功能,可以阻塞調用者,直到任務完成。

    如果您使用ValueTask/ValueTask<TResult>,並且您確實需要執行上述任一操作,則應使用.AsTask()獲取Task/Task<TResult>實例,然後對該實例進行操作。並且,在之後的代碼中您再也不應該與該ValueTask/ValueTask<TResult>進行交互。
    簡單說就是使用ValueTask/ValueTask<TResult>時,您應該直接await它(可以有選擇地加上.ConfigureAwait(false)),或直接調用AsTask()且再也不要使用它,例如:

    // 以這個方法為例
    public ValueTask<int> SomeValueTaskReturningMethodAsync();
    …
    // GOOD
    int result = await SomeValueTaskReturningMethodAsync();
    
    // GOOD
    int result = await SomeValueTaskReturningMethodAsync().ConfigureAwait(false);
    
    // GOOD
    Task<int> t = SomeValueTaskReturningMethodAsync().AsTask();
    
    // WARNING
    ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
    ... // 將實例存儲到本地會使它被濫用的可能性更大,
        // 不過這還好,適當使用沒啥問題
    
    // BAD: await 多次
    ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
    int result = await vt;
    int result2 = await vt;
    
    // BAD: 併發 await (and, by definition then, multiple times)
    ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
    Task.Run(async () => await vt);
    Task.Run(async () => await vt);
    
    // BAD: 在不清楚操作是否完成的情況下使用 GetAwaiter().GetResult()
    ValueTask<int> vt = SomeValueTaskReturningMethodAsync();
    int result = vt.GetAwaiter().GetResult();
    

    另外,開發人員可以選擇使用另一種高級模式,最好你在衡量后確定它可以帶來好處之後再使用。具體來說,ValueTask/ValueTask<TResult>確實公開了一些與操作的當前狀態有關的屬性,例如:

    • IsCompleted,如果操作尚未完成,則返回false;如果操作已完成,則返回true(這意味着該操作不再運行,並且可能已經成功完成或以其他方式完成)
    • IsCompletedSuccessfully,當且僅當它已完成並成功完成才返回true(意味着嘗試等待它或訪問其結果不會導致引發異常)

    舉個例子,對於一些執行非常頻繁的代碼,想要避免在異步執行時進行額外的性能損耗,並在某個本質上會使ValueTask/ValueTask<TResult>不再使用的操作(如await、.AsTask())時,可以先檢查這些屬性。例如,在 .NET Core 2.1的SocketsHttpHandler實現中,代碼在連接上發出讀操作,並返回一個ValueTask<int>實例。如果該操作同步完成,那麼我們不用關注能否取消該操作。但是,如果它異步完成,在運行時就要發出取消請求,這樣取消請求會將連接斷開。由於這是一個非常常用的代碼,並且通過分析表明這樣做的確有細微差別,因此代碼的結構基本上如下:

    int bytesRead;
    {
        ValueTask<int> readTask = _connection.ReadAsync(buffer);
        if (readTask.IsCompletedSuccessfully)
        {
            bytesRead = readTask.Result;
        }
        else
        {
            using (_connection.RegisterCancellation())
            {
                bytesRead = await readTask;
            }
        }
    }
    

    這種模式是可以接受的,因為在ValueTask<int>的Result被訪問或自身被await之後,不會再被使用了。

    新異步API都應返回ValueTask / ValueTask 嗎?

    當然不是,Task/Task<TResult>仍然是默認選擇

    正如上文所強調的那樣,Task/Task<TResult>比ValueTask/ValueTask<TResult>更加容易正確使用,所以除非對性能的影響大於可用性的影響,否則Task/Task<TResult>仍然是最優的。

    此外,返回ValueTask<TResult>會比返回Task<TResult>多一些小開銷,例如,await Task<TResult>比await ValueTask<TResult>會更快一些,所以如果你可以使用緩存的Task實例(例如,你的API返回Task或Task<bool>),你或許應該為了更好地性能而仍使用Task和Task<bool>。而且,ValueTask/ValueTask<TResult>相比Task/Task<TResult>有更多的字段,所以當它們被await、並將它們的字段存儲在調用異步方法的狀態機中時,它們會在該狀態機對象中佔用更多的空間。

    但是,如果是以下情況,那你應該使用ValueTask/ValueTask<TResult>:

    1. 你希望API的調用者只能直接await它
    2. 避免額外的內存分配的開銷對API很重要
    3. 你預期該API常常是同步完成的,或者在異步完成時你可以有效地池化對象。

    在添加抽象、虛擬或接口方法時,您還需要考慮這些方法的重載/實現是否存在這些情況。

    ValueTask和ValueTask 的下一步是什麼?

    對於.NET Core庫,我們將依然會看到新的API被添加進來,其返回值是Task/Task<TResult>,但在適當的地方,我們也將看到添加了新的以ValueTask/ValueTask<TResult>為返回值的API。

    ValueTask/ValueTask<TResult>的一個關鍵例子就是在.NET Core 3.0添加新的IAsyncEnumerator<T>支持。IEnumerator<T>公開了一個返回bool的MoveNext方法,異步IAsyncEnumerator<T>則會公開一個MoveNextAsync方法。剛開始設計此功能時,我們認為MoveNextAsync 應返回Task<bool>,一般情況下,通過緩存的Task<bool>在同步完成時可以非常高效地執行此操作。但是,考慮到我們期望的異步枚舉的廣泛性,並且考慮到它們基於是基於接口的,其可能有許多不同的實現方式(其中一些可能會非常關注性能和內存分配),並且鑒於絕大多數的消費者將通過await foreach來使用,我們決定MoveNextAsync返回ValueTask<bool>。這樣既可以使同步完成案例變得很快,又可以使用可重用的對象來使異步完成案例的內存分配也減少。實際上,在實現異步迭代器時,C#編譯器會利用此優勢,以使異步迭代器盡可能免於額外內存分配。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※別再煩惱如何寫文案,掌握八大原則!

  • 東京奧運聖火傳遞福島起點 被查出輻射量異常

    摘錄自2019年12月4日自由時報報導

    日本東京奧運聖火明年3月底從福島縣的足球國練中心「J-VILLAGE」出發,但日本環境省今(4日)透露,「J-VILLAGE」相鄰的停車場有部分區域空間輻射量較高,當局已要求東京電力公司再次去污。

    J-VILLAGE位於福島縣濱通南部,2011年福島核災發生後,由於此處距離福島核一廠僅有20公里,被政府借用為核災事故處理的對應據點,該中心今年4月下旬才全面恢復營運,因具有災區重建的重大象徵意義,所以被選為聖火傳遞的起點。

    根據《共同社》報導,環保團體綠色和平組織10月對J-VILLAGE周圍展開調查,發現異常的輻射量,隨後將結果送交環境省。

    環境省表示,空間輻射量較高的是與J-VILLAGE相鄰的楢葉町營停車場部分區域,已要求東電對該地區未經鋪設的地面再次去污。東電3日去除了周圍約0.03立方米的土和草,調查放射性物質的種類等。

    根據東電的調查,在去污地區1公尺高的位置測得每小時1.79微西弗的輻射量,超過日本政府訂定的0.23微西弗的去污標準。地表輻射量為70.2微西弗。

    本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※教你寫出一流的銷售文案?

  • 北極熊身上遭噴黑字「T-34」 專家震驚:失去保護色恐難覓食

    摘錄自2019年12月4日上報報導

    隨著全球暖化加劇,近幾個月以來常見北極熊出現在俄羅斯北方。但是近期在社群媒流傳的影片可見,有隻北極熊身體側邊被噴上黑色字母和數字「T-34」,目前專家正在調查這部影片的確切拍攝地點是否位於俄羅斯,並且警告這樣的行為可能會影響北極熊的生活技能,使牠們失去原有的保護色,難以在白雪覆蓋的地區捕獵食物。

    《英國廣播公司》(BBC)報導,這部影片被世界自然基金會(World Wildlife Fund,WWF)成員卡夫里(Sergey Kavry)發布在Facebook,之後又被當地媒體廣泛分享。卡夫里說,這部影片被分享在通訊軟體WhatsApp的一個俄羅斯東部楚科奇自治區(Chukotka)當地居民的群組裡,而負責監控野生動物的科學家也不會以噴漆的方式將北極熊進行編號。

    由於「T-34」戰車是蘇聯在第二次世界大戰(World War Two)戰勝德國納粹的重要關鍵,卡夫里說:「我不知道這段影片究竟是在哪個區域、地區,或哪裡的附近拍攝。如果這是個傳遞軍事訊息的舉動……某種程度來說是對歷史不尊重。」

    俄羅斯北方生態問題研究所(Institute Of The Biological Problems Of The North)科學家科赫涅夫(Anatoly Kochnev)指出,北極熊不太可能在未被麻醉的情況下,任人在牠身上噴字。

    科赫涅夫提到,這隻北極熊被噴漆的當下可能無法活動,或是可能靜止不動,因為牠被噴上的字樣均勻,而且大小相同。此外,他認為這可能發生在俄羅斯北部地區新地島(Novaya Zemlya),因為先前有專家團隊將北極熊進行麻醉,阻止牠們在人類居住地遊蕩。

    科赫涅夫說,如今要將這隻北極熊的噴漆洗掉可能要花上好幾週的時間,而且這會對牠的白色保護色造成影響,使牠難以在冰雪覆蓋的地方順利捕食獵物。

    俄羅斯媒體推測,在北極熊身上噴漆的舉動,可能是基於附近居民對於許多北極熊屢次闖入人類居住地的恐懼與不滿。隨著全球暖化日漸加劇,新地島2月宣布進入緊急狀態,因為有超過50隻北極熊出現在該地區,牠們在人口密集居住的建築物周遭漫步、尋找食物。

    本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務