作者: admin

  • 實時web應用方案——SignalR(.net core)

    實時web應用方案——SignalR(.net core)

    何為實時

    先從理論上解釋一下兩者的區別。

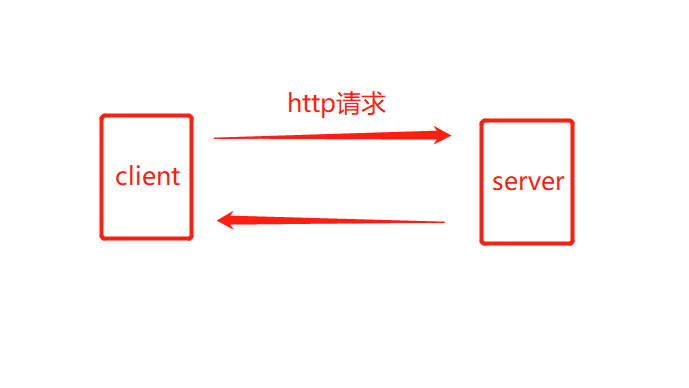
    大多數傳統的web應用是這樣的:客戶端發起http請求到服務端,服務端返回對應的結果。像這樣:


    也就是說,傳統的web應用都是客戶端主動發起請求到服務端。

    那麼實時web應用呢?它不需要主動發起請求,服務端可以主動推送信息到客戶端。

    舉栗子的話,實時聊天工具、web遊戲等都可以算是實時應用。

    什麼是SignalR

    如果想做一個實時應用,最好用web socket。很早以前我也寫過web socket的實現方式,但不夠全面,這裏再補上一篇。

    來說說signalR,它是一款開源的實時框架,可以使用三種方式實現通信(long polling、server sent events、web socket)。它很好的整合了底層技術,讓我們可以不用關注底層技術實現而把精力聚焦在業務實現上。一個完整的signalR包括客戶端和服務端,服務端支持net core/net framework,還支持大部分客戶端,比如瀏覽器和桌面應用。

    回落機制

    為了兼容不同瀏覽器(客戶端)和服務端,signalR採用了回落機制,使得它可以根據情況協商使用不同的底層傳輸方式。假如瀏覽器不支持web socket,就自動降級使用sse,再不行就long polling。當然,也可以禁用這種機制,指定其中一種。

    三種通信方式

    long polling(長輪詢)

    長輪詢是客戶端發起請求到服務端,服務器有數據就會直接返回。如果沒有數據就保持連接並且等待,一直到有新的數據返回。如果請求保持到一段時間仍然沒有返回,這時候就會超時,然後客戶端再次發起請求。

    這種方式優點就是簡單,缺點就是資源消耗太多,基本是不考慮的。

    server sent events(sse)

    如果使用了sse,服務器就擁有了向客戶端推送的能力,這些信息和流信息差不多,期間會保持連接。

    這種方式優點還是簡單,也支持自動重連,綜合來講比long polling好用。缺點也很明顯,不支持舊的瀏覽器不說,還只能發送本文信息,而且瀏覽器對sse還有連接數量的限制(6個)。

    web socket

    web socket允許客戶端和服務端同時向對方發送消息(也就是雙工通信),而且不限制信息類型。雖然瀏覽器同樣有連接數量限制(可能是50個),但比sse強得多。理論上最優先使用。

    進入正題

    開始之前,還需要了解RPC和Hub的概念。

    RPC:全程Remote Procedure Call,字面意思遠程服務調用,可以像調用本地方法一樣調用遠程服務。前端可以調用後端方法,後端也可以調用前端方法。

    Hub:基於RPC,接受從客戶端發過來的消息,也同時負責把服務端的消息發送給客戶端。客戶端可以調用Hub裏面的方法,服務端可以通過Hub調用客戶端裏面的方法。

    好了,概念已經理解清楚了,接下來上代碼。

    在項目里新增Hub類:

    using Microsoft.AspNetCore.SignalR;
    using System.Threading.Tasks;
    
    namespace SignalRDemo.Server
    {
        public class SignalRHub : Hub
        {
            /// <summary>
            /// 客戶連接成功時觸發
            /// </summary>
            /// <returns></returns>
            public override async Task OnConnectedAsync()
            {
                var cid = Context.ConnectionId;
    
                //根據id獲取指定客戶端
                var client = Clients.Client(cid);
    
                //向指定用戶發送消息
                await client.SendAsync("Self", cid);
    
                //像所有用戶發送消息
                await Clients.All.SendAsync("AddMsg", $"{cid}加入了聊天室");
            }
        }
    }

    為了讓外部可以訪問,我們還需要一個控制器。在控制器里聲明隨便建一個:

    using Microsoft.AspNetCore.Mvc;
    using Microsoft.AspNetCore.SignalR;
    using SignalRDemo.Server;
    using System.Threading.Tasks;
    
    namespace SignalRDemo.Controllers
    {
        public class HomeController : Controller
        {
            private readonly IHubContext<SignalRHub> _countHub;
    
            public HomeController(IHubContext<SignalRHub> countHub)
            {
                _countHub = countHub;
            }
    
            /// <summary>
            /// 發送信息
            /// </summary>
            /// <param name="msg"></param>
            /// <param name="id"></param>
            /// <returns></returns>
            public async Task Send(string msg, string id)
            {
                await _countHub.Clients.All.SendAsync("AddMsg", $"{id}:{msg}");
            }
        }
    }

    再然後進入StartUp設置端點:

    endpoints.MapHub<SignalRHub>("/hub");

    完成以後,配置signalr客戶端:

    setupConn = () => {
        conn = new signalR.HubConnectionBuilder()
            .withUrl("/hub")
            .build();
    
        conn.on("AddMsg", (obj) => {
            $('#msgPanel').append(`<p>${obj}</p>`);
        });
    
        conn.on("Finished", () => {
            conn.stop();
            $('#msgPanel').text('log out!');
        });
    
        conn.on("Self", (obj) => {
            $('#userId').text(obj);
        });
    
        conn.start()
            .catch(err => console.log(err));
    }

    要注意withUrl裏面的路徑就是之前設置好的端點。

    運行效果:


     Hub還支持組操作,比如:

    //將用戶添加到A組
    await
    Groups.AddToGroupAsync(Context.ConnectionId, "GroupA");
    //將用戶踢出A組
    await Groups.RemoveFromGroupAsync(Context.ConnectionId, "GroupA");
    //向A組所有成員廣播消息
    await Clients.Group("GroupA").SendAsync("AddMsg", "群組消息");

    更多操作請參考官方文檔。

    本文演示demo的源碼見git,地址:https://gitee.com/muchengqingxin/SignalRDemo.git

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • 2020/6/11 JavaScript高級程序設計 DOM

    2020/6/11 JavaScript高級程序設計 DOM

    DOM(文檔對象模型)是針對HTML和XML文檔的一個API(應用程序接口)。他描繪了一個層次化的節點樹,允許開發人員添加、移除和修改頁面的某一部分。

    10.1 節點層次

    DOM將任何HTML和XML文檔描繪成一個由多層節點構成的結構。

    文檔節點(Document)是每個文檔的根節點。文檔節點只有一個子節點(HTML文檔中實終是<html>),我們稱之為文檔元素(每個文檔只能有一個文檔元素)。文檔元素是文檔的最外層元素,其他所有元素都包含在文檔元素中。

    每一段標記都能通過樹中一個節點來表示,包括特性、文檔類型、註釋等,共有12種節點類型。這些類型都繼承自一個基類型。

    10.1.1 Node類型

     JavaScript中的所有節點類型都繼承自Node類型,所有的節點類型都共享相同的基本屬性和方法。

    nodeType屬性:表明節點的類型(12種)

    eg:Node.ELEMENT_NODE(1);  //元素節點

    通過該屬性可以確定一個節點的類型,可以通過類型字面量判等,也可以通過数字值比較。

    if (someNode.nodeType == Node.ELEMENT_NODE){  //在IE中無效
        alert("Node is element.");
    }
    
    if (someNode.nodeType == 1){  //適用於任何瀏覽器
        alert("Node is element.");
    }

    1. nodeName和nodeValue屬性

    可以了解節點的具體信息。

    對於元素節點,nodeName保存的始終是標籤名,nodeValue的值始終是null。

    2. 節點關係


    • 屬性:
    1 childNodes屬性 保存NodeList對象(類數組,但不是數組),這個對象也有length屬性。可以通過方括號,也可以通過item()方法訪問節點。可以通過Array.prototype.slice()方法將其轉換為數組。
    2 parentNode屬性 指向父節點。
    3 previousSibling / nextSibling屬性 訪問同一列表中的其他屬性。即前一個和后一個同胞節點。
    4 firstChild / lastChild屬性 指向childNodes列表的第一個和最後一個節點。
    • 方法:
    1 hasChildNodes() 檢驗是否存在子節點。存在時返回true。
    2 ownerDocument() 指向整個文檔的文檔節點。方便直接到達頂端。

    3. 操作節點

    1 appendChild() 向childNodes列表的末尾添加一個節點。返回新的節點。由於任何一個節點不能同時出現在多個位置上,所以當傳入的節點是父節點的子節點時,這個節點會變成最後一個子節點。
    2 insertBefore()

    將節點插入到childNodes列表中一個特定的位置。接收兩個參數:要插入的節點和作為參照的節點。

    插入節點后,被插入節點會成為參照節點的前一個同胞節點,同時被方法返回。省略參照節點時與appendChild()執行相同的操作。

    3 replaceChild() 替換節點(複製所有的關係指針)。接收兩個參數:要插入的節點和要替換的節點。被替換的節點將從文檔樹中移除,但仍然在文檔中,只是沒有了自己的位置(指針)。
    4 removeChild() 移除節點。返回被移除的節點。同樣被移除的節點仍然在文檔中。

    PS1:使用這幾個方法必須取得父節點(使用parentNode屬性)。

    PS2:不是所有類型的節點都有子節點。在不支持子節點的節點上調用這些方法,會拋出錯誤。

    4. 其他方法

    1 cloneNode()

    創建調用這個方法的節點的一個完全相同的副本。接受一個布爾值參數,表示是否執行深複製(true則執行深複製)。

    • 深複製:複製節點以及整個子節點樹
    • 淺複製:只複製節點本身

    複製后返回的節點歸文檔所有,沒有為他指定父節點。要通過其他的方法把他加入到文檔中。

    IE>9及其他瀏覽器會計入空白節點。

    2 normalize()

    處理文檔樹中的文本節點。

    • 出現文本節點不包含文本 => 刪除空白文本節點
    • 接連出現兩個文本節點 => 合併為一個文本節點

    10.1.2 Document類型

    Document類型表示文檔。

    • document對象是HTMLDocument的一個實例,表示整個HTML頁面。
    • document對象是window對象的一個屬性,可以作為全局對象來訪問。

    Document節點的特徵:

    • nodeType的值為9;
    • nodeName的值是”#document”;
    • nodeValue和parentNode的值為null;
    • ownerDocument的值為null。

    1. 文檔的子節點

    1 DocumentType(最多一個) <!DOCTYPE>標籤,可以通過document.doctype屬性來訪問他的信息。
    2 Element(最多一個)

    文檔元素<html>。

    通過documentElement屬性或childNodes列表(在無處理指令的情況下是firstChild)訪問可快速找到html元素。

    document.body屬性可以指向<body>元素(因為該元素使用頻率高,為了便於開發增添該屬性)。

    3 ProcessingInstruction 表示處理指令。
    4 Comment 註釋。

    2. 文檔信息

    作為HTMLDocument的實例,document對象還有一些特殊的屬性。

    1 title <title>元素中的文本,是當前頁面的標題。
    2 URL 完整的URL。
    3 domain

    頁面的域名。僅domain可以設置。但有一定的限制:

    • 不能設置為URL中不包含的域
    • 如果域名一開始是“鬆散的”(wrox.com),那麼就不能再將其設置回“緊繃的”(p2p.wrox.com)

    作用:將每個頁面的document.domain設置為相同的值,就可以互相訪問對方包含的JavaScript對象了。(解決跨域問題)

    4 referrer 鏈接到當前頁面的那個頁面的URL。在沒有來源頁面的情況下是空字符串。

    3. 查找元素

    1 getElementById() 參數為要取得元素的ID。找到返回該元素,沒有找到返回null。如果有多個id值相同,則只會返回第一個。
    2 getElementByTagName() 參數為要取得元素的標籤名。返回元素的NodeList。在HTML文檔中,返回的是HTMLCollection對象。可以通過方括號或者item()方法來訪問。
    3 nameItem() HTMLCollection對象的方法。通過元素的name屬性取得集合中的項(第一項)。同時HTMLCollection對象還支持按名稱訪問項。
    4 getElementByName() 返回帶有給定name屬性的所有元素(一個HTMLCollection)。

    4. DOM的一致性檢測

    ducument.implementation屬性:提供關於實現了DOM 哪些部分的信息的對象。

     他有一個方法,hasFeature()。接收兩個參數:要檢測的DOM功能的名稱和版本號。如果支持給定名稱和版本的功能,則返回true。

    檢驗結果true不意味着現實與規範一致,最好除了檢測hasFeature()之外,同時使用能力檢測。

    5. 文檔寫入

    write() / writeln():接受一個字符串,即寫入輸出流中的文本。write()會原樣寫入,writeln()會在字符串末尾添加一個換行符(\n)。這兩個方法可以向頁面中動態的加入內容。

    //在頁面加載過程中輸出當前的日期和時間
    document.write("<strong>" + (new Date()).toString() + "</strong>");

    同時還可以用來動態的包含外部資源,例如JavaScript文件等。

    document.write("<script type=\"text/javascript\" src=\"file.js\"> + "<\/script>");

    PS:由於不能直接包含字符串”</script>”(這樣會導致該字符串被解釋為腳本的結束,後面的代碼無法運行),所以要將這個字符串分開寫。

    在頁面被呈現的過程中,會直接輸出內容。如果在文檔加載結束后(window.onload)再調用write(),那麼輸出的內容會重寫整個頁面。

    方法open()和close()分別用於打開和關閉網頁的輸出流。

    10.1.3 Element類型

    Element類型提供了對元素標籤名、子節點及特性的訪問。Element節點具有以下特徵:

    • nodeType值為1;
    • nodeName的值為元素的標籤名;
    • nodeValue的值為null;
    • parentNode可能是Document或Element;

    tagName屬性:返回訪問元素的標籤名(與nodeName相同)。 => 在HTML中標籤名始終以全部大寫表示,需要檢驗標籤類型時最好調用toLowerCase()方法。

    1. HTML元素

    所有HTML元素都由HTMLElement類型表示。HTMLElement類型直接繼承自Element並添加了一些屬性。

    • id,元素在文檔中的唯一標識;
    • title,有關元素的附加說明信息,一般通過工具提示條显示出來;
    • dir,語言的方向(”ltr”,即left-to-right)或“rtl”;
    • className,與元素的class特性對應,為元素制定的CSS類。

    2. 取得特性


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※別再煩惱如何寫文案,掌握八大原則!

  • IOT設備SmartConfig實現

    IOT設備SmartConfig實現

    一般情況下,IOT設備(針對wifi設備)在智能化過程中需要連接到家庭路由。但在此之前,需要將wifi信息(通常是ssid和password,即名字和密碼)發給設備,這一步驟被稱為配網。移動設備如Android、iOS等扮演發送wifi信息的角色,簡單來說就是移動應用要與IOT設備建立通信,進而交換數據。針對配網這一步驟,市面上一般有兩種做法:

    • AP連接方式:IOT設備發出AP(Access Point,可理解為路由器,可發出wifi)信息;移動設備STA(Station,可以連接wifi)連接到IOT設備AP,接着就可以發送wifi(家庭路由的wifi)信息給設備了。另外,也可互換角色,及移動設備釋放熱點,IOT設備進行連接。
    • SmartConfig(一鍵配置)方式:不需要建立連接,移動設備將wifi信息(需提前獲取)寫入數據包,組播循環發出此數據包;IOT設備處於監聽所有網絡的模式,接收到UDP包后解析出wifi信息拿去連網。

    可以發現,SmartConfig不需建立連接,步驟較少,實現起來也較容易,並且用戶也無需進行過多的操作。本文的IOT設備基於ESP32開發板,解釋原理及實現如何通過Android APP發出UDP包實現SmartConfig。知識點:計算機網絡、UDP、組播、DatagramSocket …

    一、網絡知識回顧

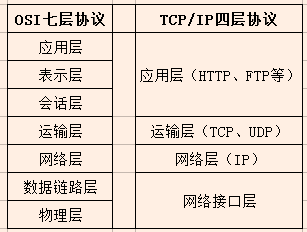
    計算機網絡分層結構如下:

    • 應用層:體系中的最高層。任務是通過應用程序間的交互來完成特定網絡應用。不同的網絡應用對應不同的協議:如HTTP、DNS、SMTP。其交互的數據單元稱為報文。
    • 運輸層:複雜向兩台主機中進程直接的通信提供通用的數據傳輸服務,使用端口作為向上傳遞的進程標識,主要有TCP和UDP。
    • 網絡層:負責為分組交換網絡上的不同主機提供通信服務,使用IP協議。
    • 網絡接口層:包括數據鏈路層和物理層,傳輸單位分別是幀和比特。

    1. IP協議

    IP(Internet Protocol)協議是網絡層的主要協議。其版本有IPv4(32位)、IPv6(128位)。與IP協議配套使用的還有地址解析協議(ARP)、網際控制報文協議(ICMP,重要應用即常見的PING,測試連通性)、網際組管理協議(IGMP)。

    IP數據報格式,由首部和數據部分兩部分組成:

    IP地址分類如下:

    1.1 兩級IP地址

    IP地址是每一台主機唯一的標識符,由網絡號和主機號組成。A、B、C三類均為單播地址(一對一),D類為多播地址(一對多)。

    1.2 三級IP地址

    在兩級中新增了子網號字段,也稱為劃分子網。其方法是從主機號借用若干位作為子網號。

    子網掩碼:是一個網絡或子網的重要屬性,可通過子網掩碼計算出目的主機所處於哪一個子網。若沒有劃分子網,則使用默認子網掩碼(A類255.0.0.0、B類255.255.0.0、C類255.255.255.0)

    1.3 無分類編址

    無分類編址(CIDR)也稱為構造超網,使用網絡前綴+主機號規則,並使用斜線標明前綴位數,如:

    128.15.34.77/20
    
    1.4 IP多播

    多播又稱為組播,提供一對多的通信,大大節約網絡資源。IP數據報中不能寫入某一個IP地址,需寫入多播組的標識符(需要接收的主機與此標識符關聯)。D類地址即為多播組的標識符,所以多播地址(D類)只能作為目的地址。分為本局域網上的硬件多播、互聯網多播兩種。

    多播使用到的協議:

    • IGMP(網際組管理協議):讓連接在本地局域網上的多播路由器(能夠運行多播協議的路由器)知道本局域網上是否有主機(進程)參加或退出了某個多播組。
    • 多播路由選擇協議:用於多播路由器之間的協同工作,以便讓多播數據報以最小的代價傳輸。

    2. UDP協議

    運輸層向上面的應用層提供通信服務,通信的端點並不是主機而是主機中進程,使用協議端口號標識進程(如HTTP為80)。UDP協議是運輸層中重要的兩個協議之一。

    • UDP是無連接的
    • UDP使用盡最大努力交付,不保證可靠交付
    • UDP是面向報文的
    • UDP沒有擁塞控制
    • UDP支持一對一,一對多,多對一和多對多
    • UDP首部開銷小

    二、Java中的UDP

    1. Socket

    socket是在應用層和傳輸層之間的一個抽象層,它把TCP/IP層複雜的操作抽象為幾個簡單的接口供應用層調用已實現進程在網絡中通信。簡單來說,socket是一種接口,對傳輸層(TCP/UPD協議)進行了的封裝。

    socket通信:

    • TCP socket:需建立連接,TCP三次握手,基於流的通信(InputStrea和OutputStream)
    • UDP socket:無需建立連接,基於報文的通信。可以組播的形式發出報文,適合本場景中的配網步驟。

    2. Java中的socket

    2.1 類解釋

    Java為Socket編程封裝了幾個重要的類(均為客戶端-服務端模式):

    Socket類:
    實現了一個客戶端socket,作為兩台機器通信的終端,默認採用TCP。connect()方法請求socket連接、getXXXStream()方法獲取輸入/出流、close()關閉流。

    ServerSocket類:
    實現了一個服務器的socket,等待客戶端的連接請求。bind()方法綁定一個IP地址和端口、accept()方法監聽並返回一個Socket對象(會阻塞)、close()關閉一個socket。

    SocketAddress # InetSocketAddress類:
    前者是一個抽象類,提供了一個socket地址,不關心傳輸層協議;後者繼承自前者,表示帶有IP地址和端口號的socket地址。

    DatagramSocket類:
    實現了一個發送和接收數據報的socket,使用UDP。send()方法發送一個數據報(DatagramPacket)、receive()方法接收一個數據報(一直阻塞接至收到數據報或超時)、close()方法關閉一個socket。

    DatagramPacket類:
    使用DatagramSocket時的數據報載體。

    2.2 UDP實例

    SmartConfig採用UDP實現,所以在前述知識的基礎下,先編寫一個例子熟悉java udp的使用,首先建立服務端的代碼:

    public class UDPServer {
        /**
         * 設置緩衝區的長度
         */
        private static final int BUFFER_SIZE = 255;
        /**
         * 指定端口,客戶端需保持一致
         */
        private static final int PORT = 8089;
    
        public static void main(String[] args) {
            DatagramSocket datagramSocket = null;
            try {
                datagramSocket = new DatagramSocket(PORT);
                DatagramPacket datagramPacket = new DatagramPacket(new byte[BUFFER_SIZE], BUFFER_SIZE);
                while (true) {
                    // 接收數據報,處於阻塞狀態
                    datagramSocket.receive(datagramPacket);
                    System.out.println("Receive data from client:" + new String(datagramPacket.getData()));
                    // 服務器端發出響應信息
                    byte[] responseData = "Server response".getBytes();
                    datagramPacket.setData(responseData);
                    datagramSocket.send(datagramPacket);
                }
            } catch (IOException e) {
                e.printStackTrace();
            } finally {
                if (datagramSocket != null) {
                    datagramSocket.close();
                }
            }
        }
    }
    

    客戶端發出數據報:

    public class UDPClient {
        /**
         * 指定端口,與服務端保持一致
         */
        private static final int PORT = 8089;
        /**
         * 超時重發時間
         */
        private static final int TIME_OUT = 2000;
        /**
         * 最大重試次數
         */
        private static final int MAX_RETRY = 3;
    
        public static void main(String[] args) throws IOException {
            try {
                byte[] sendMsg = "Client msg".getBytes();
                // 創建數據報
                DatagramSocket socket = new DatagramSocket();
                // 設置阻塞超時時間
                socket.setSoTimeout(TIME_OUT);
                // 創建server主機的ip地址(此處使用了本機地址)
                InetAddress inetAddress = InetAddress.getByName("192.168.xxx.xxx");
                // 發送和接收的數據報文
                DatagramPacket sendPacket = new DatagramPacket(sendMsg, sendMsg.length, inetAddress, PORT);
                DatagramPacket receivePacket = new DatagramPacket(new byte[sendMsg.length], sendMsg.length);
                // 數據報文可能丟失,設置重試計數器
                int tryTimes = 0;
                boolean receiveResponse = false;
                // 將數據報文發送出去
                socket.send(sendPacket);
                while (!receiveResponse && (tryTimes < MAX_RETRY)) {
                    try {
                        // 阻塞接收數據報文
                        socket.receive(receivePacket);
                        // 檢查返回的數據報文
                        if (!receivePacket.getAddress().equals(inetAddress)) {
                            throw new IOException("Unknown server's data");
                        }
                        receiveResponse = true;
                    } catch (InterruptedIOException e) {
                        // 重試
                        tryTimes++;
                        System.out.println("TimeOut, try " + (MAX_RETRY - tryTimes) + " times");
                    }
                }
                if (receiveResponse) {
                    System.out.println("Receive from server:" + new String(receivePacket.getData()));
                } else {
                    System.out.println("No data!");
                }
                socket.close();
            } catch (SocketException e) {
                e.printStackTrace();
            }
        }
    }
    

    運行結果:

    * 發現客戶端收到的數據被截斷了,這是因為沒有重置接收包的長度,在服務端datagramPacket.setLength()可解決。

    三、SmartConfig

    根據前面的socket相關應用,基本想到如何實現一鍵配置。在實際應用中,原理一樣,只是增加了組播(這一點需要和IOT設備端共同確定,數據的格式也需協定)。在實現中,需要針對不同IP組播地址發出循環的UDP報文,增加設備端接收到的可能性;同時APP也要開啟服務端程序監聽發出數據報的響應,以此更新UI或進行下一步的數據通信。相關核心代碼如下:

    // 對每一個組播地址循環發出報文 
    while (!mIsInterrupt && System.currentTimeMillis() - currentTime < mParameter
             .getTimeoutGuideCodeMillisecond()) {
         mSocketClient.sendData(gcBytes2,
                 mParameter.getTargetHostname(),
                 mParameter.getTargetPort(),
                 mParameter.getIntervalGuideCodeMillisecond());
         // 跳出條件,發出UDP報文達到一定時間
         if (System.currentTimeMillis() - startTime > mParameter.getWaitUdpSendingMillisecond()) {
             break;
         }
    }
    

    組播地址設置:

    public String getTargetHostname() {
        if (mBroadcast) {
            return "255.255.255.255";
        } else {
            int count = __getNextDatagramCount();
            return "234." + (count + 1) + "." + count + "." + count;
        }
    }
    

    完整代碼省略(利益相關,代碼匿了^_^),基本思路很簡單。最終的實現是IOT設備收到UDP發出的wifi信息,並以此成功連接wifi,連接服務器,進而綁定賬號。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

  • mybatis緩存之一級緩存(二)

    mybatis緩存之一級緩存(二)

    這篇文章介紹下mybatis的一級緩存的生命周期

    一級緩存的產生

    一級緩存的產生,並不是看mappper的xml文件的select方法,看下面的例子

    mapper.xml

        <select id="getById" resultType="entity.TempEntity">
           select * from  temp where id = #{id}
        </select>
    

    test

        @Test
        public  void testSelectAsUpdate() throws IOException {
            InputStream inputStream = Resources.getResourceAsStream("mybatis.xml");
            SqlSessionFactory build = new SqlSessionFactoryBuilder().build(inputStream);
            SqlSession sqlSession = build.openSession();
            sqlSession.update("dao.Temp03Dao.getById", 1);
            sqlSession.update("dao.Temp03Dao.getById", 1);
        }


    執行結果

    2020-06-26 17:33:27,899 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:33:27,922 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:33:27,923 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:33:27,923 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    

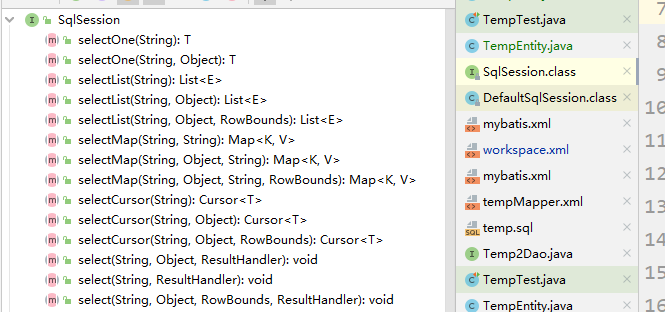
    我們可以看到執行了2次查詢。說明並沒有產生緩存。說明和sqlsession調用的方法是有關係的

    只有調用上圖中的方法才會產生一級緩存

    一級緩存的銷毀

    1.關閉session

    這個是根據debug看到的一級緩存的最終結構。下面是整個依賴的類圖

    test

     @Test
        public  void test() throws IOException, NoSuchFieldException, IllegalAccessException {
            InputStream inputStream = Resources.getResourceAsStream("mybatis.xml");
            SqlSessionFactory build = new SqlSessionFactoryBuilder().build(inputStream);
            SqlSession sqlSession = build.openSession();
            TempEntity tempEntity1 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity1);
    
            Field executorField = sqlSession.getClass().getDeclaredField("executor");
            executorField.setAccessible(true);
            CachingExecutor  cachingExecutor = (CachingExecutor) executorField.get(sqlSession);
    
            Field declaredField = cachingExecutor.getClass().getDeclaredField("delegate");
            declaredField.setAccessible(true);
            SimpleExecutor simpleExecutor  = (SimpleExecutor) declaredField.get(cachingExecutor);
    
            Field localCacheField = simpleExecutor.getClass().getSuperclass().getDeclaredField("localCache");
            localCacheField.setAccessible(true);
            PerpetualCache perpetualCache = (PerpetualCache) localCacheField.get(simpleExecutor);
    
            Field cacheField = perpetualCache.getClass().getDeclaredField("cache");
            cacheField.setAccessible(true);
            Map<Object,Object> map= (Map<Object, Object>) cacheField.get(perpetualCache);
            logger.info("緩存關閉前");
            for (Map.Entry<Object,Object> objectObjectEntry:map.entrySet()){
                logger.info(objectObjectEntry.getKey() + "===" + objectObjectEntry.getValue());
            }
            sqlSession.close();
            logger.info("緩存關閉后");
    
            for (Map.Entry<Object,Object> objectObjectEntry:map.entrySet()){
                logger.info(objectObjectEntry.getKey() + "=" + objectObjectEntry.getValue());
            }
        }
    

    運行結果

    2020-06-26 17:38:52,777 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:38:52,801 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:38:52,824 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:38:52,824 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:38:52,825 INFO [TempTest] - 緩存關閉前
    2020-06-26 17:38:52,826 INFO [TempTest] - -1654591322:461730790:dao.Temp03Dao.getById:0:2147483647:select * from  temp where id = ?:1:dev===[TempEntity{id=1, value1='11111', value2='aaaaa'}]
    2020-06-26 17:38:52,827 INFO [TempTest] - 緩存關閉后
    

    可以看到session關閉后,緩存就不存在了

    2.Commit提交

    test

        @Test
        public  void testCommit() throws IOException {
            InputStream inputStream = Resources.getResourceAsStream("mybatis.xml");
            SqlSessionFactory build = new SqlSessionFactoryBuilder().build(inputStream);
            SqlSession sqlSession = build.openSession();
            TempEntity tempEntity1 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity1);
            sqlSession.commit();
            TempEntity tempEntity2 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity2);
            logger.info(tempEntity1 == tempEntity2);
    
        }
    

    運行結果

    2020-06-26 17:40:40,821 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:40:40,846 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:40:40,862 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:40:40,862 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:40:40,863 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:40:40,863 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:40:40,864 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:40:40,864 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:40:40,864 INFO [TempTest] - false
    

    說明sqlSession.commit時會清空緩存

    3.Rollback

    test

        @Test
        public  void testRollback() throws IOException {
            InputStream inputStream = Resources.getResourceAsStream("mybatis.xml");
            SqlSessionFactory build = new SqlSessionFactoryBuilder().build(inputStream);
            SqlSession sqlSession = build.openSession();
            TempEntity tempEntity1 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity1);
            sqlSession.rollback();
            TempEntity tempEntity2 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity2);
            logger.info(tempEntity1 == tempEntity2);
    
        }
    

    執行結果

    2020-06-26 17:42:23,793 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:42:23,833 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:42:23,843 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:42:23,843 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:42:23,844 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:42:23,844 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:42:23,845 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:42:23,845 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:42:23,845 INFO [TempTest] - false
    

    sqlSession.rollback()也會清空緩存

    4.update更新

    這裡是在第一次查詢后,緊接着進行update操作。這裏與表無關。就是操作其它表,也會清空緩存。

    test

        @Test
        public  void testForUpdate() throws IOException {
            InputStream inputStream = Resources.getResourceAsStream("mybatis.xml");
            SqlSessionFactory build = new SqlSessionFactoryBuilder().build(inputStream);
            SqlSession sqlSession = build.openSession();
            TempEntity tempEntity1 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity1);
            sqlSession.update("dao.Temp03Dao.updateById", 1);
            TempEntity tempEntity2 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity2);
            logger.info(tempEntity1 == tempEntity2);
    
        }
    

    運行結果

    2020-06-26 17:45:43,997 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:45:44,034 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:45:44,048 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:45:44,049 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:45:44,049 DEBUG [dao.Temp03Dao.updateById] - ==>  Preparing: update temp set value1 = 'ffffff' where id = ? 
    2020-06-26 17:45:44,049 DEBUG [dao.Temp03Dao.updateById] - ==> Parameters: 1(Integer)
    2020-06-26 17:45:44,050 DEBUG [dao.Temp03Dao.updateById] - <==    Updates: 1
    2020-06-26 17:45:44,051 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:45:44,051 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:45:44,052 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:45:44,053 INFO [TempTest] - TempEntity{id=1, value1='ffffff', value2='aaaaa'}
    2020-06-26 17:45:44,053 INFO [TempTest] - false
    

    這裏還是在一個session會話中。記得之前有人給我說只要在一個session會話中,執行update不會清空緩存。這裏的代碼就證明了

    5.clearCache 主動清除

    test

        @Test
        public  void testClearCatch() throws IOException {
            InputStream inputStream = Resources.getResourceAsStream("mybatis.xml");
            SqlSessionFactory build = new SqlSessionFactoryBuilder().build(inputStream);
            SqlSession sqlSession = build.openSession();
            TempEntity tempEntity1 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity1);
            sqlSession.clearCache();
            TempEntity tempEntity2 = sqlSession.selectOne("dao.Temp03Dao.getById", 1);
            logger.info(tempEntity2);
            logger.info(tempEntity1 == tempEntity2);
    
        }
    

    運行結果

    2020-06-26 17:48:42,085 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:48:42,110 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:48:42,124 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:48:42,124 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:48:42,125 DEBUG [dao.Temp03Dao.getById] - ==>  Preparing: select * from temp where id = ? 
    2020-06-26 17:48:42,125 DEBUG [dao.Temp03Dao.getById] - ==> Parameters: 1(Integer)
    2020-06-26 17:48:42,126 DEBUG [dao.Temp03Dao.getById] - <==      Total: 1
    2020-06-26 17:48:42,126 INFO [TempTest] - TempEntity{id=1, value1='11111', value2='aaaaa'}
    2020-06-26 17:48:42,126 INFO [TempTest] - false
    

    一級緩存 臟讀問題

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※別再煩惱如何寫文案,掌握八大原則!
  • 十、深度優先 && 廣度優先

    十、深度優先 && 廣度優先

    原文地址

    一、什麼是“搜索”算法?

    • 算法是作用於具體數據結構之上的,深度優先搜索算法和廣度優先搜索算法都是基於“圖”這種數據結構的。
    • 因為圖這種數據結構的表達能力很強,大部分涉及搜索的場景都可以抽象成“圖”。
    • 圖上的搜索算法,最直接的理解就是,在圖中找出從一個頂點出發,到另一個頂點的路徑。
    • 具體方法有很多,兩種最簡單、最“暴力”的方法為深度優先、廣度優先搜索,還有A、 IDA等啟髮式搜索算法。
    • 圖有兩種主要存儲方法,鄰接表和鄰接矩陣。
    • 以無向圖,採用鄰接表存儲為例:
    public class Graph {
        // 頂點的個數
        private int v;
        // 每個頂點後面有個鏈表
        private LinkedList<Integer>[] adj;
    
        public Graph(int v) {
            this.v = v;
            adj = new LinkedList[v];
            for (int i = 0; i < v; i++) {
                adj[i] = new LinkedList<>();
            }
        }
    
        /**
         * 添加邊
         * @param s 頂點
         * @param t 頂點
         */
        public void addEdge(int s,int t){
            // 無向圖一條邊存兩次(聯想微信好友)
            adj[s].add(t);
            adj[t].add(s);
        }
    }
    

    二、廣度優先搜索(BFS)

    • 廣度優先搜索(Breadth-First-Search),簡稱為 BFS。
    • 它是一種“地毯式”層層推進的搜索策略,即先查找離起始頂點最近的,然後是次近的,依次往外搜索。

    2.1、實現過程

    /**
     * 圖的廣度優先搜索,搜索一條從 s 到 t 的路徑。
     * 這樣求得的路徑就是從 s 到 t 的最短路徑。
     *
     * @param s 起始頂點
     * @param t 終止頂點
     */
    public void bfs(int s, int t) {
        if (s == t) {
            return;
        }
        // visited 記錄已經被訪問的頂點,避免頂點被重複訪問。如果頂點 q 被訪問,那相應的visited[q]會被設置為true。
        boolean[] visited = new boolean[v];
        visited[s] = true;
        // queue 是一個隊列,用來存儲已經被訪問、但相連的頂點還沒有被訪問的頂點。因為廣度優先搜索是逐層訪問的,只有把第k層的頂點都訪問完成之後,才能訪問第k+1層的頂點。
        // 當訪問到第k層的頂點的時候,需要把第k層的頂點記錄下來,稍後才能通過第k層的頂點來找第k+1層的頂點。
        // 所以,用這個隊列來實現記錄的功能。
        Queue<Integer> queue = new LinkedList<>();
        queue.add(s);
        // prev 用來記錄搜索路徑。當從頂點s開始,廣度優先搜索到頂點t后,prev數組中存儲的就是搜索的路徑。
        // 不過,這個路徑是反向存儲的。prev[w]存儲的是,頂點w是從哪個前驅頂點遍歷過來的。
        // 比如,通過頂點2的鄰接表訪問到頂點3,那prev[3]就等於2。為了正向打印出路徑,需要遞歸地來打印,就是print()函數的實現方式。
        int[] prev = Arrays.stream(new int[v]).map(f -> -1).toArray();
    
        while (queue.size() != 0) {
            int w = queue.poll();
            LinkedList<Integer> wLinked = adj[w]; // 表示:鄰接表存儲時頂點為w,所對應的鏈表
            for (int i = 0; i < wLinked.size(); ++i) {
                int q = wLinked.get(i);
                // 判斷頂點 q 是否被訪問
                if (!visited[q]) {
                    // 未被訪問
                    prev[q] = w;
                    if (q == t) {
                        print(prev, s, t);
                        return;
                    }
                    visited[q] = true;
                    queue.add(q);
                }
            }
        }
    }
    
    // 遞歸打印s->t的路徑
    private void print(int[] prev, int s, int t) {
        if (prev[t] != -1 && t != s) {
            print(prev, s, prev[t]);
        }
        System.out.print(t + " ");
    }
    

    原理如下:

    2.2、複雜度分析

    • 最壞情況下,終止頂點 t 離起始頂點 s 很遠,需要遍歷完整個圖才能找到。
    • 這個時候,每個頂點都要進出一遍隊列,每個邊也都會被訪問一次,所以,廣度優先搜索的時間複雜度是 O(V+E)。
    • 其中,V 表示頂點的個數,E 表示邊的個數。
    • 對於一個連通圖來說,也就是說一個圖中的所有頂點都是連通的,E肯定要大於等於 V-1,所以,廣度優先搜索的時間複雜度也可以簡寫為 O(E)。
    • 廣度優先搜索的空間消耗主要在幾個輔助變量 visited 數組、queue 隊列、prev 數組上。
    • 這三個存儲空間的大小都不會超過頂點的個數,所以空間複雜度是 O(V)。

    三、深度優先搜索(DFS)

    • 深度優先搜索(Depth-First-Search),簡稱DFS。
    • 最直觀的例子就是“走迷宮,假設站在迷宮的某個岔路口,然後想找到出口。
    • 隨意選擇一個岔路口來走,走着走着發現走不通的時候,就回退到上一個岔路口,重新選擇一條路繼續走,直到最終找到出口。這種走法就是一種深度優先搜索策略。
    • 如下圖所示,在圖中應用深度優先搜索,來找某個頂點到另一個頂點的路徑。
    • 搜索的起始頂點是 s,終止頂點是 t,在圖中尋找一條從頂點 s 到頂點 t 的路徑。
    • 用深度遞歸算法,把整個搜索的路徑標記出來了。實線箭頭表示遍歷,虛線箭頭表示回退。
    • 從圖中可以看出,深度優先搜索找出來的路徑,並不是頂點 s 到頂點 t 的最短路徑。

    3.1、實現過程

    // 全局變量或者類成員變量,標記是否找到終點 t
    boolean found = false;
    
    /**
     * 深度優先搜索
     *
     * @param s 起始頂點
     * @param t 終止頂點
     */
    public void dfs(int s, int t) {
        found = false;
        // 標記頂點是否被訪問
        boolean[] visited = new boolean[v];
        // prev 用來記錄搜索路徑,prev[w] = a 表示 w 頂點的上一級節點為 a
        int[] prev = Arrays.stream(new int[v])
                .map(f -> -1).toArray();
    
        recurDfs(s, t, visited, prev);
        print(prev, s, t);
    }
    
    private void recurDfs(int w, int t, boolean[] visited, int[] prev) {
        if (found == true) {
            return;
        }
        visited[w] = true;
        if (w == t) {
            found = true;
            return;
        }
        LinkedList<Integer> wLinked = adj[w];
        for (int i = 0; i < wLinked.size(); ++i) {
            int q = wLinked.get(i);
            if (!visited[q]) {
                prev[q] = w;
                recurDfs(q, t, visited, prev);
            }
        }
    }
    

    3.2、複雜度分析

    • 深度搜索中每條邊最多會被訪問兩次,一次是遍歷,一次是回退。
    • 所以,深度優先搜索算法的時間複雜度是 O(E), E 表示邊的個數。
    • 深度優先搜索算法的消耗內存主要是 visited、 prev 數組和遞歸調用棧。
    • visited、 prev 數組的大小跟頂點的個數V成正比,遞歸調用棧的最大深度不會超過頂點的個數,所以總的空間複雜度就是 O(V)。

    四,兩者對比

    • 廣度優先搜索和深度優先搜索是圖上的兩種最常用、最基本的搜索算法,比起其他高級的搜索算法,比如A、 IDA等,要簡單粗暴,沒有什麼優化,所以,也被
      叫作暴力搜索算法。
    • 所以,這兩種搜索算法僅適用於狀態空間不大,也就是說圖不大的搜索。
    • 廣度優先搜索,通俗的理解就是,地毯式層層推進,從起始頂點開始,依次往外遍歷。
    • 廣度優先搜索需要藉助隊列來實現,遍歷得到的路徑就是,起始頂點到終止頂點的最短路徑。
    • 深度優先搜索用的是回溯思想,非常適合用遞歸實現。換種說法,深度優先搜索是藉助棧來實現的。
    • 在執行效率方面,深度優先和廣度優先搜索的時間複雜度都是 O(E),空間複雜度是 O(V)。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • springboot的jar為何能獨立運行

    springboot的jar為何能獨立運行

    歡迎訪問我的GitHub

    https://github.com/zq2599/blog_demos
    內容:所有原創文章分類匯總及配套源碼,涉及Java、Docker、Kubernetes、DevOPS等;

    能獨立運行的jar文件

    在開發springboot應用時,通過java -jar命令啟動應用是常用的方式,今天就來一起了解這個簡單操作背後的技術;

    開發demo

    開發一個springboot應用作為本次研究的對象,對應的版本信息如下:

    • JDK:1.8.0_211
    • springboot:2.3.1.RELEASE
    • maven:3.6.0

    接下來開發springboot應用,這個應用異常簡單:

    1. springboot應用名為springbootstarterdemo,pom.xml文件內容:
    <?xml version="1.0" encoding="UTF-8"?>
    <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
             xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
        <modelVersion>4.0.0</modelVersion>
        <parent>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-parent</artifactId>
            <version>2.3.1.RELEASE</version>
            <relativePath/> <!-- lookup parent from repository -->
        </parent>
        <groupId>com.bolingcavalry</groupId>
        <artifactId>springbootstarterdemo</artifactId>
        <version>0.0.1-SNAPSHOT</version>
        <name>springbootstarterdemo</name>
        <description>Demo project for Spring Boot</description>
        <properties>
            <java.version>1.8</java.version>
        </properties>
        <dependencies>
            <dependency>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-starter-web</artifactId>
            </dependency>
        </dependencies>
        <build>
            <plugins>
                <plugin>
                    <groupId>org.springframework.boot</groupId>
                    <artifactId>spring-boot-maven-plugin</artifactId>
                </plugin>
            </plugins>
        </build>
    </project>
    
    1. 只有一個java類,裏面有個http接口:
    package com.bolingcavalry.springbootstarterdemo;
    
    import org.springframework.boot.SpringApplication;
    import org.springframework.boot.autoconfigure.SpringBootApplication;
    import org.springframework.web.bind.annotation.RequestMapping;
    import org.springframework.web.bind.annotation.RestController;
    
    import java.util.Date;
    
    @SpringBootApplication
    @RestController
    public class SpringbootstarterdemoApplication {
    
        public static void main(String[] args) {
            SpringApplication.run(SpringbootstarterdemoApplication.class, args);
        }
        @RequestMapping(value = "/hello")
        public String hello(){
            return "hello " + new Date();
        }
    }
    
    1. 編碼完成,在pom.xml所在目錄執行命令
    mvn clean package -U -DskipTests
    
    1. 構建成功后,在target目錄下得到文件springbootstarterdemo-0.0.1-SNAPSHOT.jar
    2. 就是這個springbootstarterdemo-0.0.1-SNAPSHOT.jar,此時執行java -jar springbootstarterdemo-0.0.1-SNAPSHOT.jar就能啟動應用,如下圖:

    接下來就用這個springbootstarterdemo-0.0.1-SNAPSHOT.jar來分析jar文件能夠獨立啟動的原因;

    java -jar做了什麼

    • 先要弄清楚java -jar命令做了什麼,在oracle官網找到了該命令的描述:

      If the -jar option is specified, its argument is the name of the JAR file containing class and resource files for the application. The startup class must be indicated by the Main-Class manifest header in its source code.

    • 再次秀出我蹩腳的英文翻譯:

    1. 使用-jar參數時,後面的參數是的jar文件名(本例中是springbootstarterdemo-0.0.1-SNAPSHOT.jar);
    2. 該jar文件中包含的是class和資源文件;
    3. 在manifest文件中有Main-Class的定義;
    4. Main-Class的源碼中指定了整個應用的啟動類;(in its source code)
    • 小結一下:
      java -jar會去找jar中的manifest文件,在那裡面找到真正的啟動類;

    探查springbootstarterdemo-0.0.1-SNAPSHOT.jar

    1. springbootstarterdemo-0.0.1-SNAPSHOT.jar是前面的springboot工程的構建結果,是個壓縮包,用常見的壓縮工具就能解壓,我這裏的環境是MacBook Pro,用unzip即可解壓;

    2. 解壓後有很多內容,我們先關注manifest相關的,下圖紅框中就是manifest文件:

    3. 打開上圖紅框中的文件,內容如下:

    Spring-Boot-Classpath-Index: BOOT-INF/classpath.idx
    Implementation-Title: springbootstarterdemo
    Implementation-Version: 0.0.1-SNAPSHOT
    Start-Class: com.bolingcavalry.springbootstarterdemo.Springbootstarter
     demoApplication
    Spring-Boot-Classes: BOOT-INF/classes/
    Spring-Boot-Lib: BOOT-INF/lib/
    Build-Jdk-Spec: 1.8
    Spring-Boot-Version: 2.3.1.RELEASE
    Created-By: Maven Jar Plugin 3.2.0
    Implementation-Vendor: Pivotal Software, Inc.
    Main-Class: org.springframework.boot.loader.JarLauncher
    
    1. 在上述內容可見Main-Class的值org.springframework.boot.loader.JarLauncher,這個和前面的java官方文檔對應上了,正是這個JarLauncher類的代碼中指定了真正的啟動類;

    疑惑出現

    1. 在MANIFEST.MF文件中有這麼一行內容:
    Start-Class: com.bolingcavalry.springbootstarterdemo.Springbootstarter
     demoApplication
    
    1. 前面的java官方文檔中,只提到過Main-Class ,並沒有提到Start-Class;
    2. Start-Class的值是SpringbootstarterdemoApplication,這是我們的java代碼中的唯一類,也只真正的應用啟動類;
    3. 所以問題就來了:理論上看,執行java -jar命令時JarLauncher類會被執行,但實際上是SpringbootstarterdemoApplication被執行了,這其中發生了什麼呢?

    猜測

    動手之前先猜一下,個人覺得原因應該如下:

    1. java -jar命令會啟動JarLauncher;
    2. Start-Class是給JarLauncher用的;
    3. JarLauncher根據Start-Class找到了SpringbootstarterdemoApplication,然後執行它;

    分析JarLauncher

    1. 先下載SpringBoot源碼,我下載的是2.3.1版本,地址:https://github.com/spring-projects/spring-boot/releases/tag/v2.3.1.RELEASE

    2. JarLauncher所在的工程是spring-boot-loader,先弄明白JarLauncher的繼承關係,如下圖,可見JarLauncher繼承自ExecutableArchiveLauncher,而ExecutableArchiveLauncher的父類Launcher位於最頂層,是個抽象類:

    3. java -jar執行的是JarLauncher的main方法,如下,會實例化一個JarLauncher對象,然後執行其launch方法,並且將所有入參都帶入:

    public static void main(String[] args) throws Exception {
    	new JarLauncher().launch(args);
    }
    
    1. 上面的launch方法在父類Launcher中:
    protected void launch(String[] args) throws Exception {
        // 將jar解壓后運行的方式叫做exploded mode
        // 如果是exploded mode,就不能支持通過URL加載jar
        // 如果不是exploded mode,就可以通過URL加載jar
    	if (!isExploded()) {
    	    // 如果允許通過URL加載jar,就在此註冊對應的處理類
    		JarFile.registerUrlProtocolHandler();
    	}
    	// 創建classLoader
    	ClassLoader classLoader = createClassLoader(getClassPathArchivesIterator());
    	// jarmode是創建docker鏡像時用到的參數,使用該參數是為了生成帶有多個layer信息的鏡像
    	// 這裏暫時不關注jarmode
    	String jarMode = System.getProperty("jarmode");
    	//如果沒有jarmode參數,launchClass的值就來自getMainClass()返回
    	String launchClass = (jarMode != null && !jarMode.isEmpty()) ? JAR_MODE_LAUNCHER : getMainClass();
    	launch(args, launchClass, classLoader);
    }
    
    1. 可見要重點關注的是getMainClass()方法,在看這個方法之前,我們先去關注一個重要的成員變量archive,是JarLauncher的父類ExecutableArchiveLauncher的archive,如下可見,該變量又來自方法createArchive:
    public ExecutableArchiveLauncher() {
    		try {
    			this.archive = createArchive();
    			this.classPathIndex = getClassPathIndex(this.archive);
    		}
    		catch (Exception ex) {
    			throw new IllegalStateException(ex);
    		}
    	}
    
    1. 方法來自Launcher.createArchive,如下所示,可見成員變量archive實際上是個JarFileArchive對象:
    protected final Archive createArchive() throws Exception {
    		ProtectionDomain protectionDomain = getClass().getProtectionDomain();
    		CodeSource codeSource = protectionDomain.getCodeSource();
    		URI location = (codeSource != null) ? codeSource.getLocation().toURI() : null;
    		String path = (location != null) ? location.getSchemeSpecificPart() : null;
    		if (path == null) {
    			throw new IllegalStateException("Unable to determine code source archive");
    		}
    		File root = new File(path);
    		if (!root.exists()) {
    			throw new IllegalStateException("Unable to determine code source archive from " + root);
    		}
    		return (root.isDirectory() ? new ExplodedArchive(root) : new JarFileArchive(root));
    	}
    
    1. 現在回到getMainClass()方法,可見his.archive.getManifest方法返回的是META-INF/MANIFEST.MF文件的內容,然後getValue(START_CLASS_ATTRIBUTE)方法實際上就是從META-INF/MANIFEST.MF中取得了Start-Class的屬性:
    @Override
    	protected String getMainClass() throws Exception {
    	    // 對應的是JarFileArchive.getManifest方法,
    	    // 進去后發現對應的就是JarFile.getManifest方法,
    	    // JarFile.getManifest對應的就是META-INF/MANIFEST.MF文件的內容
    		Manifest manifest = this.archive.getManifest();
    		String mainClass = null;
    		if (manifest != null) {
    		    // 對應的是META-INF/MANIFEST.MF文件中的Start-Class的屬性
    			mainClass = manifest.getMainAttributes().getValue(START_CLASS_ATTRIBUTE);
    		}
    		if (mainClass == null) {
    			throw new IllegalStateException("No 'Start-Class' manifest entry specified in " + this);
    		}
    		return mainClass;
    	}
    
    1. 從上述分析可知:getMainClass()方法返回的是META-INF/MANIFEST.MF中取得了Start-Class的屬性com.bolingcavalry.springbootstarterdemo.SpringbootstarterdemoApplication,再次回到launch方法中,可見最終運行的代碼是launch(args, launchClass, classLoader),它的launchClass參數就是com.bolingcavalry.springbootstarterdemo.SpringbootstarterdemoApplication:
    protected void launch(String[] args) throws Exception {
    		if (!isExploded()) {
    			JarFile.registerUrlProtocolHandler();
    		}
    		ClassLoader classLoader = createClassLoader(getClassPathArchivesIterator());
    		String jarMode = System.getProperty("jarmode");
    		// 這裏的launchClass等於"com.bolingcavalry.springbootstarterdemo.SpringbootstarterdemoApplication"
    		String launchClass = (jarMode != null && !jarMode.isEmpty()) ? JAR_MODE_LAUNCHER : getMainClass();
    		// 這裏就是啟動SpringbootstarterdemoApplication的地方
    		launch(args, launchClass, classLoader);
    	}
    
    1. 展開launch(args, launchClass, classLoader),最終查到了MainMethodRunner類:
    public class MainMethodRunner {
    
    	private final String mainClassName;
    
    	private final String[] args;
    
    	/**
    	 * Create a new {@link MainMethodRunner} instance.
    	 * @param mainClass the main class
    	 * @param args incoming arguments
    	 */
    	public MainMethodRunner(String mainClass, String[] args) {
    	    // mainClassName被賦值為"com.bolingcavalry.springbootstarterdemo.SpringbootstarterdemoApplication"
    		this.mainClassName = mainClass;
    		this.args = (args != null) ? args.clone() : null;
    	}
    
    	public void run() throws Exception {
    	    // 得到SpringbootstarterdemoApplication的Class對象
    		Class<?> mainClass = Class.forName(this.mainClassName, false, Thread.currentThread().getContextClassLoader());
    		// 得到SpringbootstarterdemoApplication的main方法對象
    		Method mainMethod = mainClass.getDeclaredMethod("main", String[].class);
    		mainMethod.setAccessible(true);
    		// 通過反射執行main方法
    		mainMethod.invoke(null, new Object[] { this.args });
    	}
    }
    

    終於,真相大白了;

    小結

    最後盡可能簡短做個小結,先看jar是如何產生的,如下圖,maven插件生成的jar文件中,有常見的class、jar,也有符合java規範的MANIFEST.MF文件,並且,還在MANIFEST.MF文件中額外生成了名為Start-Class的配置,這裏面是我們編寫的應用啟動類SpringbootstarterdemoApplication:

    啟動類是JarLauncher,它是如何與MANIFEST.MF文件關聯的呢?從下圖可以看出,最終是通過JarFile類的成員變量manifestSupplier關聯上的:

    再來看看關鍵代碼的執行情況,如下圖:

    至此,SpringBoot的jar獨立運行的基本原理已經清楚,探究的過程中,除了熟悉關鍵代碼流程,還對jar中的文件有了更多了解,如果您正在學習SpringBoot,希望本文能給您一些參考;

    官方文檔

    1. 最後附上SpringBoot官方文檔,可以看到Start-Class描述信息:

    2. 上述文檔明確提到:Start-Class定義的是實際的啟動類,此時的您應該對一切都瞭然於胸,產生本該如此的感慨;

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

  • 高雄鼓勵換電動機車 最高補助額達 2.3 萬

    高雄市機車總數達 201 萬輛,成為都市的污染源之一,為了鼓勵機車族更換電動機車,高雄市政府環保局推動補助政策,換車最高可獲得 2.3 萬元的補助。   高雄市政府環境保護局空噪科長鄭嵐 26 日下午表示,根據交通部機動車輛統計資料,高雄市截至 103 年 12 月底掛牌的使用中機車,總數約 201 萬輛,為鼓勵民眾汰舊換購電動車輛,高雄市環保局持續推動淘汰補助方案,除了經濟部工業局補助純購電動機車,機車族可獲得補助 7,200 元到 10,000 元外,若搭配汰舊二行程機車,再加碼補助至 17,400 元到 23,000 元。   他表示,同時,為了提升友善充電環境,高雄環保局近年來也積極推動充電站架設,除了原有公用及私有充電站,103 年完成社區大樓與電動機車經銷商等 25 座,共有充電站 217 站,讓高雄市騎乘電動車市民處處皆有電可充,建構低碳生活圈。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※教你寫出一流的銷售文案?

  • 中興攜手國家電網組合資公司 建成都無線汽車充電站

    中興子公司中興新能源汽車與國家電網四川省電力公司達成協議,將在成都組建合資公司。此合資公司在傳統集中式充電模式的基礎上分佈式建設無線汽車充電站,第一批支援無線充電的社區巴士同日會在成都正式投入運營。   除社區巴士外,中興還將逐步推廣支持無線充電的大型公車專案,而房車的無線充電技術亦已成熟,用戶如有條件和需要,可對房車和停車廠進行改造,即可享有無線充電功能。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※台北網頁設計公司全省服務真心推薦

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※推薦評價好的iphone維修中心

  • 新能源汽車入北京 改為備案制

    在中國的全球新能源汽車大會上,北京市科委新能源與新材料處處長許心超透露,北京市新能源汽車準入方式有所調整,由先前的新能源汽車目錄方式改為備案方式,車型只要備案即可在北京銷售、上牌。   先前規定,按照《北京市示範應用新能源小客車生企業及品目錄》,北京市共有 7 款新能源汽車可在備案之後直接銷售、上牌。而這次許心超表示,按照中央的要求,準入方式也在改變,主要採取備案制,只要備案了就可銷售,政府則加強事後監管。
    這意味著所有中國純電動汽車都可以進京銷售、上牌,享受財政補貼,而不再像以前必須要先進入嚴格的北京市新能源汽車目錄。   另一方面,為了讓純電動汽車的使用者迅速找到充電樁,相關部門也在進行改進,一是和百度合作,標注所有充電樁的電子地圖將很快上線;二是印製北京充電樁地圖;三是辦充電體驗周活動,在 2 月 2 日至 6 日,將分 2 次聯合所有北京的汽車企業,做充電實際體驗。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※台北網頁設計公司這麼多該如何選擇?

    ※智慧手機時代的來臨,RWD網頁設計為架站首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※回頭車貨運收費標準

  • 中國最大太陽能電動車充電站 於北京CBD首度投用

    據報導,位於中國北京CBD地區華茂中心停車場的太陽能電動汽車公共充電站於近日正式建成並投入試運營。這座中國目前最大的電動汽車智慧充電站共有100台充電樁,包括兩座地面太陽能智慧充電站和地下充電站。   該電站太陽能模組轉換效率達22%,裝機容量目前為25kW,投資額約為1300萬元人民幣(下同)。 此充電站收費標準初步定在1.37元人民幣/kWh,其中含有0.57元人民幣的基礎電費。其提供快充和慢充兩種充電服務,慢充最長時間為兩個半小時,快充僅需20分鐘。該充電站不僅可為市場上幾乎所有類型的電動車充電,且車主可通過手機達到預約、支付等充電操作。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案