作者: admin

  • 電動車免牌照稅 可望延長至 2018 年

    為鼓勵購買低汙染的環保車輛,電動汽車將再延長牌照稅免稅期 3 年。包括電動小客車、巴士與貨車,免徵牌照稅優惠將可持續至 2018 年 1 月 5 日為止。   為基於扶植國內電動車研發製造的需要,立法院財政委員會 12 日將審查由行政院提出的用牌照稅法修正草案,授權給地方政府對以電能為動力的電動汽車,免徵牌照稅優惠期間,可以再延長 3 年。經濟日報指出,這項減稅法案可望趕在立法院本會期結束前完成修法程序,以便接續提供減免。   財政部指出,免徵電動車使用照稅優惠措施自 2012 年 1 月 5 日施行至今,國庫釋出的免稅利益將近新台幣 1,000 萬元,平均每年約為 300 萬元。過去 3 年,申請免稅的電動車由 319 輛成長到 574 輛,減稅金額也從約 200 萬元倍增至近 400 萬元。財政部認為,電動車申請免稅案件逐年增加,代表電動車的使用與購買意願也在上升。  

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※台北網頁設計公司這麼多該如何選擇?

    ※智慧手機時代的來臨,RWD網頁設計為架站首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※回頭車貨運收費標準

  • 不畏油價跌 美電動車 12 月創最高單月銷售紀錄

    儘管美國汽油零售價格跟隨國際原油同步下挫到每加侖 2 美元的低水準,2014 年美國電動車銷售強勁增加 23%,12 月並創下單月最佳紀錄;顯見電動車已蔚為一股持久的趨勢,不受油價影響。   根據電動車專業網站 InsideEVs 統計,2014 年 12 月美國賣出 12,874 輛電動車,為統計以來最高單月銷售紀錄。至於 2014 年全年,電動車銷售勁揚 23%,達到 119,710 輛。   就個別品牌來看,全美電動車銷售冠軍是日產 Leaf,2014 年總計售出 30,200 輛,遙遙領先亞軍通用汽車雪佛蘭 Volt 的 18,805 輛。起價介於 3.5 萬到 4 萬美元的特斯拉 Model S 排名第 3,全年銷量為 17,300 輛,市占不及 15%。不過,在 12 月 Model S 首度擊敗售價較低的日產 Leaf(約 3 萬美元)。   2014 年美國電動車市場唯一新上市車款是 BMW,分別在 5 月及 8 月推出 i3 與 i8 ,加總的銷量僅 6,647 輛。展望 2015 年,將有數款新型電動車上路,尤其是在休旅車和越野車市場。而特斯拉的 Model X 則預計 2015 年下半年登場,是今年最受期待的電動車。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • 2014中國高新汽車國際峰會圓滿閉幕,廣受業界好評

    第三屆中國高新汽車國際峰會已於2014年12月9日在上海浦東嘉里大酒店完美落幕。本屆峰會由法蘭克福展覽(上海)有限公司和中國國家發展和改革委員會國際合作中心聯合主辦,共邀請到包括政府官員、行業協會代表和知名整車企業在內的14位重量級演講嘉賓出席,共同探討未來汽車產業革新的重要創新技術、市場趨勢和發展戰略方針。為期一整天的峰會由一個主論壇和兩個分論壇組成,共迎來386位與會代表,專業領域橫跨汽車全產業鏈。

    法蘭克福展覽(上海)有限公司總經理李慶新先生表示:“由於整體定位和結構調整,峰會由往年的兩天精簡為一天時間,但是本屆峰會的參會代表人數仍再創新高。由此印證了中國高新汽車國際峰會作為汽車行業的年度盛會,為業內重要政策決策者、企業高管和投資者建立了交流契機和合作機會。與會代表對我們表達了支持和鼓勵,我們非常高興可以收到如此正面的肯定。我們相信中國高新汽車國際峰會將會成為討論汽車行業發展趨勢、最新技術以及業界精英交流討論的高端平台。”

    參會代表和演講嘉賓滿意會議定位,共同關注汽車行業未來合作契機

    本屆峰會以「關注未來汽車發展趨勢,聚焦零部件產業升級」為主題,共邀請到多位政府領導蒞臨並致辭。其中包括:

    • 鄭惠強先生,全國政協常委、上海市人大副主任
    • 李鋼先生,國家發改委產業協調司處長
    • 徐秉金先生,中歐協會會長、商務部原副部長

    峰會由上海市新能源汽車推進辦公室主任劉建華先生擔任首位演講嘉賓,就「發起『新能源汽車走進社區』倡議」議題發表真知灼見。除此之外,強大演講嘉賓陣容包括來自寶馬、特斯拉、沃爾沃、上汽和北汽等國內外知名整車企業。首次擔任演講嘉賓的上海汽車集團股份有限公司汽車工程中心車身開發總監邱國華博士此次主要圍繞上汽集團電動汽車發展戰略展開介紹,並評價道:“中國高新汽車國際峰會是一個高端的汽車行業交流平台,議題定位準確。主題覆蓋整車、能源和材料等一系熱門話題。峰會聚集了汽車行業的技術戰略研究和市場分析等高端人才,我認為這是一個非常出色的活動。”

    特斯拉中國區公共政策和充電基礎設施總監高翔先生同樣也分享了他的感想,並表示:“本屆峰會邀請了很多政府政策制定者,他們的政策導向對於未來電動車的發展影響很大。我認為電動汽車產業正得到大眾越來越多的關注。我希望通過中國高新汽車國際峰會這個深入的交流平台,在政策環境和行業環境得到突破,未來能夠制定完善的行業標準,希望有更多的車企投入到電動汽車的開發中。”

    上海大眾汽車有限公司信息系統部高級經理邱振捷先生擔任”用互聯網思維造車”主題的演講嘉賓,關注電動汽車行業的前瞻性概念。他認為:“去年我是峰會的參會代表,而今年我非常榮幸可以擔任演講嘉賓出席本屆峰會。中國高新汽車國際峰會是一個齊聚行業精英的平台,活動的整體規劃和安排超出我的預期。在這裏我遇到了很多零部件企業和整車廠,我非常願意和他們互相交流經驗,這給我工作帶來很多幫助。”

    已經連續第二年出席的三菱綜合材料管理(上海)有限公司戰略企劃部經理徐冬榮先生對峰會在新能源汽車未來發展前景產生積極作用表示肯定,說道:“演講嘉賓介紹了最新的電動汽車技術和資訊,通過本屆峰會我瞭解到很多高新汽車的最新行業發展趨勢和扶持政策。我認為新能源汽車的未來發展前景是非常巨大的,因此發展速度和技術瓶頸將是最需要關注的問題。”

    首次參會的參會代表德國ThyssenKrupp System Engineering GmbH的業務發展專員Elena Kaplun女士希望通過中國高新汽車國際峰會洞察中國汽車行業的最新潛在投資機會,她表示道:“我對中國汽車市場有了深入的認識和瞭解。我對新能源汽車和輕量化汽車技術發展的話題很感興趣,嘉賓的演講內容對市場研究和業務發展戰略規劃很有幫助。除此之外,我還有機會在這裏拓展我的人脈,更可以和卓越的業界人士有進一步的合作機會如特斯拉、BMW和上汽等,我非常高興能夠參加此次活動!”

    2014 年中國高新汽車國際峰會同期舉行的 Automechanika Shanghai — 上海國際汽車零配件、維修檢測診斷設備及服務用品展覽會,是亞洲規模最大的汽車零部件、維修檢測診斷設備及汽車用品展覽會。

    欲瞭解更多有關峰會詳情,敬請訪問官方網站

    或發郵件至。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※別再煩惱如何寫文案,掌握八大原則!

  • 北京路燈變充電樁 望每天為一萬輛車充電

    北京市首批路燈充電樁改造已經展開,位於昌平區京密北路上的八十八盞路燈,從傳統高壓鈉燈改造為LED燈,可讓十幾輛電動汽車同時充電;此外,昌平區內還設置了八個純電動汽車慢充樁,專供電動車充電,充電時間約為四、五個小時,且白天晚上皆可充電。北京市科委指出,希望今年內能達成北京五環內建成五公里半徑的快速充電網路和每天為一萬輛車充電的目標。   除北京市內,連接北京與上海全程1262公里的京滬高速公路也將開通全線快速充電系統。平均每五十公里將設一座充電站,最快三十分鐘可充電完成。同等里程電費支出為燃油車的一半,全程充電費不到人民幣400元(約合新臺幣2052元)。   目前中國大陸的國家電網已完成2.4萬個充電樁,形成「兩縱一橫」網路,規模為世界之最。但據報導,其目前已建成的四百多座充電站幾乎沒有盈利,處於全線虧損,而在深圳市營運的七座充電站,每年虧損額超過1000萬人民幣(約5132.3萬元)。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

  • 通用推雪佛蘭 Bolt 欲與定價相當的 Tesla Model 3 抗衡

    通用推雪佛蘭 Bolt 欲與定價相當的 Tesla Model 3 抗衡

      美國底特律汽車展於 1 月 12 日開幕,通用汽車(GM)新款電動車雪佛蘭 Bolt(Chevrolet Bolt)首度亮相,預料未來將與電動車大廠特斯拉(Tesla)激烈競爭。   雪佛蘭 Bolt 每次充電可行駛 200 英里,達到先前油電混合車款 Volt 的 4 倍之多, 電池由韓國樂金化學(LG Chem)所製造,預計於 2017 年上市,售價約為 3 萬美元,可望與同樣預定 2017 年上市,售價約 3.5 萬美元的 Model 3 車款競相抗衡。根據知情人士表示,Bolt 為掀背式(Hatchback)設計,外型傾向跨界車款。   通用汽車盼能藉雪佛蘭 Bolt,加強消費者對該品牌具備完整產品線的印象,也希望能將此車款擴及至包括中國等全球市場。     (Source:)

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※別再煩惱如何寫文案,掌握八大原則!

  • 產能尚未滿載 特斯拉要到 2020 年才可能獲利

    特斯拉執行長 Elon Musk 在世界汽車業大會 (Automotive News World Congress) 中表示,以目前狀況看來,特斯拉的電動車在 2020 年前都無法開始獲利。   根據華爾街日報報導,特斯拉的 Model 3 電動車在現有會計原則下,至少要等到 2020 年產能滿載時才能正式轉盈。Model 3 是特斯拉功能性較少的電動車,一台可能售價約介於 3 萬到 4 萬美元之間,比起其他 Model S 系列一台動輒超過 10 萬美元來說相對便宜,Model 3 預計在 2017 年推出。特斯拉的股價盤後下跌 7%,來到 189.95 美元。   對於電動車的發展,Musk 也要求其他汽車公司盡速推出自家電動車。特斯拉目前電動車銷售量約為 35,000 台,預計到 2025 年可賣出數百萬台。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • Tesla 股價大跌 穆斯克荷包失血 28 億美元

    電動車大廠特斯拉(Tesla) 股價重創,不僅投資人損失慘重,公司創辦人穆斯克(Elon Musk)財富更是大失血。根據經濟日報報導,Tesla 股價 2014 年 9 月至今大跌 34%,穆斯克財富也蒸發 28 億美元。   穆斯克表示,Tesla 在中國的銷售低迷,使曾經超搶手的 Tesla 股票價格 14 日大跌 11.56 美元,跌幅約 6%,若和去年 9 月每股 291.42 美元的高價相比,Tesla 股票在這段期間崩跌掉 3 分之 1 的價值。   穆斯克則擁有逾 2,800 萬股的 Tesla 股票,相當流通股總數的 4 分之 1 左右,這意味股價大跌讓穆斯克 28 億美元的財富煙消雲散。不過,雖然上述損失數字很可觀,但穆斯克本身可能不太意外,他在去年 9 月曾警告說,Tesla 的股價「有點太高」,當時投資人不予理會,Tesla 股價還接著上漲至每股 281.19 美元。

    本站聲明:網站內容來源於EnergyTrend https://www.energytrend.com.tw/ev/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

  • python高級-閉包-裝飾器

    閉包內容:

    1. 匿名函數:能夠完成簡單的功能,傳遞這個函數的引用,只有功能

    2. 普通函數:能夠完成複雜的功能,傳遞這個函數的引用,只有功能

    3. 閉包:能夠完成較為複雜的功能,傳遞這個閉包中的函數以及數據,因此傳遞是功能+數據

    4. 對象:能夠完成最複雜的功能,傳遞很多數據+很多功能,因此傳遞的是數據+功能

    ———————————————————

    1. 對全局函數進行修改:在函數當中加global,在閉包中外邊中的變量加nonlocal

    2. 閉包定義:有兩個函數嵌套使用,裏面的函數可以使用外面函數所傳輸的參數,最後可傳遞的是裏面函數的結構與數據(個人理解)。

    3. 最後閉包可以在python中引申出裝飾器 ———————————————————

     1 def closure():
     2     # 在函數內部再定義一個函數,
     3     # 並且這個函數用到了外邊函數的變量,那麼將這個函數以及用到的一些變量稱之為閉包
     4     def closure_in(x):
     5         print('---------我是打不死的%s--------' %x)
     6     return closure_in
     7 ​
     8 x = closure()
     9 x('小強')
    10 ​
    11 print('*'*20)
    12 # -----加餐---------
    13 def closure_1(a,b,c):
    14     def closure_on(x):
    15         print('-----%s加餐-------' %b)
    16         print(a*x + c)
    17     return closure_on
    18 ​
    19 demo = closure_1(2,'小強',3) #傳closure_1函數
    20 demo(4) #傳clsure_on函數
    21 ​
    22 #注:函數不加括號,調用的是函數本身【function】;函數加括號,調用的是函數的return結果。


    裝飾器內容:

    代碼要遵守‘開放封閉’原則;對已經寫好的函數遵守封閉,對功能擴展遵守開放;

     1 # 裝飾器的作用:為了對原來的代碼上進行擴展
     2 def decoration(func):
     3     def call_func():
     4         print('-------正在裝飾 -------' )
     5         func()
     6     return call_func
     7 ​
     8 #@decoration     #--->demo_new = decoration(demo)
     9 def demo():
    10    print('demo----')
    11 ​
    12 demo_new = decoration(demo)
    13 demo_new()


    使用裝飾器來測試一個函數的運行時:

     1 import time
     2 def set_func(func):
     3     def call_func():
     4         start_time = time.time()
     5         func()
     6         stop_func = time.time()
     7         print(‘alltimes is %f’ %(stop_func-start_fun))
     8     return call_func
     9 @set_func
    10 def test1():
    11     print(‘——-test1———’)    
    12 test1()
    13 ​
    14 #等價於:
    15 @set_func==test1 = set_func(test1)
    16 ​


    1. 沒有參數,沒有返回值的函數進行裝飾:
     1 def set_func(func):
     2     def call_func():
     3         print(‘———test2——-’)
     4         print(‘———-test3——’)
     5         func()
     6     return call_func
     7     
     8 @set_func
     9 def test1():
    10     print(‘——test1——-   ’)


    2. 對有參數無返回值的函數進行裝飾:
     1 def set_func(func):
     2     def call_func(a):  #變
     3         print(‘———test2——-’)
     4         print(‘———-test3——’)
     5         func(a) #變
     6     return call_func
     7     
     8 @set_func
     9 def test1(num):
    10     print(‘——test1——- %d    ’ %num)
    11 ​
    12 test1(100) —->call_func(100)
    13 test1(200)——>call_func(200)


    復現裝飾器原理:

    ————————————————————————-

    只要遇到@函數 裝飾器(這句話),在程序中就已經執行了!!
    3. 不定長參數的函數裝飾:
     1 def set_func(func):
     2     def call_func(*args,**kwargs):  #變
     3         print(‘———test2——-’)
     4         print(‘———-test3——’)
     5         func(*args,**kwargs) #(拆包)將元祖拆開,每個進行傳輸;
     6         #func(args,kwargs)—>不行,相當於傳遞了兩個參數:一個元祖,一個字典。
     7     return call_func
     8     
     9 @set_func
    10 def test1(num,*args,**kwargs):
    11     print(‘——test1——- %d    ’ %num)
    12     print(‘——test1——-   ’ , args)
    13     print(‘——test1——- ’ ,kwargs )
    14     
    15 test1(100)  
    16 test1(100,200)
    17 test1(100,200,300,mm=100)

    注意:*args保存不定長參數,以元祖保存,**kwargs保存字典形式(mm=…)

    4.對應的返回值參數進行裝飾、通用裝飾器:
     1 #通用裝飾器
     2 def set_func(func):
     3     print(“開始進行裝飾———-”)
     4     def call_func(*args,**kwargs):  #變
     5         print(‘———test2——-’)
     6         print(‘———-test3——’)
     7         return func(*args,**kwargs) #(拆包)將元祖拆開,每個進行傳輸;如果沒有return ret返回none。
     8         #func(args,kwargs)—>不行,相當於傳遞了兩個參數:一個元祖,一個字典。
     9     return call_func
    10     
    11 @set_func
    12 def test1(num,*args,**kwargs):
    13     print(‘——test1——- %d    ’ %num)
    14     print(‘——test1——-   ’ , args)
    15     print(‘——test1——- ’ ,kwargs )
    16     return ‘ok’    #—-返回給上面的func(),然後return func—ret
    17     
    18 ret = test1(100)
    19 ​


    5. 多個裝飾器對同一個函數進行裝飾:
     1 def add_qx(func):
     2     print(“——開始進行裝飾權限1———-”)
     3     def call_func(*args,**kwargs):  #變
     4         print(‘這是權限驗證1’)
     5         return func(*args,**kwargs)
     6     return call_func
     7     
     8 ​
     9 def add_xx(func):
    10     print(“——開始進行裝飾xx功能———-”)
    11     def call_func(*args,**kwargs):  #變
    12         print(‘這是xx權限驗證’)
    13         return func(*args,**kwargs)
    14     return call_func
    15     
    16 @add_qx
    17 @add_xx
    18 def test1():
    19     print(‘——test1——-’) 
    20 ​
    21 test1()
    22 ​


    首先執行第一個,但是第一個裝飾器下面不是函數(裝飾器原則:下面必須是函數,否則不執行),所以第一個函數先等待,等第二個裝飾器執行后形成函數在交給第一個裝飾器;所以運行結果是:

    1. 開始進行裝飾xx的功能,

    2. 開始進行裝飾權限1,

    3. 這是權限驗證1,

    4. 這是xx權限驗證,

    5. ——-test1——-,

    ——————裝飾器練習—————- 輸出格式:<td><h1>haha</h1></td>

     1 def set_func_1(func):
     2     def call_func():
     3         return ‘<h1>’ + func() + ’</h1>’
     4     return call_func
     5     
     6 ​
     7 def set_func_2(func):
     8     def call_func():
     9         return ‘<td>’ + func() + ’</td>’
    10     return call_func
    11     
    12 @set_func_1()
    13 @set_func_2()
    14 def get_str():
    15     return ‘haha’
    16     
    17 print(get_str()) 

    18 最後執行的效果: <h1><td>haha</td></h1>
    6. 用類對函數進行裝飾(了解):
     1 class Test(object):
     2     def __init__(self,func):
     3         self.func = fun
     4         
     5     def __call__(self):
     6         print(‘這裡是裝飾器的功能。。。。’)
     7         return self.func()
     8         
     9 @Test
    10 def get_str():
    11     return ‘haha’
    12     
    13 print(get_str())


    以上就是裝飾器與閉包的全部內容,希望有所收穫,如果有錯誤,希望指出,感謝!!


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※教你寫出一流的銷售文案?

  • 常見的索引模型淺析

    常見的索引模型淺析

      索引的出現是為了提高數據庫查詢的效率,就像書的目錄一樣。常見的索引模型有哈希表、有序數組、B+樹。

    • 自適應哈希索引(AHI)

      哈希表是一種常見的數據結構,即通過哈希算法計算出一個数字在表中的位置,並將数字存入該表。哈希索引就是通過哈希表來實現的,一般情況下查找時間複雜度為O(1)。InnoDB會監控對錶上各索引頁的查詢,會自動根據訪問的頻率和模式為某些熱點頁建立哈希索引,所以又叫自適應哈希索引,訪問模式一樣指查詢的條件一樣。

      比如我們維護一張身份證信息和用戶姓名的表,需要根據身份證號查詢姓名,哈希索引大概是這樣的:

      哈希索引適合只有等值查詢的場景,例如select * from T where index_col = ‘##’。哈希索引是無序的,如果需要區間查詢,那就要把所有數據掃描一遍。

    • 有序數組索引

      有序數組在等值查詢和區間查詢場景中效率都很高,同樣用上面的表舉例,索引大概是這樣的:

      要查詢某條數據或者區間的時候,使用二分法時間複雜度為O(logN)。但如果需要在中間更新數據時,那麼就要移動後面所有的數據。有序數組索引只適用於靜態存儲引擎,比如保存2019年度學校所有學生信息。

    • B+樹索引

      B+樹是為磁盤或其他直接存取輔助設備設計的一種平衡查找樹。下面是一顆高度為2的B+樹,所有記錄都在恭弘=叶 恭弘子結點上順序存放,恭弘=叶 恭弘子結點通過指針相連。

      B+樹索引就是B+樹在數據庫中的實現,由於B+索引在數據庫中具有高扇出性,在數據庫中B+樹的高度一般為2~4層。查找某一鍵值的行記錄時最多只需要2~4次IO。以InnoDB的一個整数字段索引為例,這顆B+樹大概是1200叉樹,這裏N叉樹的N取決於數據塊的大小。高度為4的時候就可以存1200的3次方個值,大概為17億。考慮到樹根的數據塊總是在內存中,一個10億行的表上一個整数字段的索引,查找一個值最多只需要訪問3次磁盤。

      在InnoDB存儲引擎中,表是根據主鍵順序存放的。根據恭弘=叶 恭弘子結點內容,B+樹索引又分為聚簇索引和輔助索引。

      • 聚簇索引:按照每張表的主鍵構造一顆B+樹,恭弘=叶 恭弘子結點的key是主鍵值, value是該行的其他字段值,聚簇索引的恭弘=叶 恭弘子結點也稱為數據頁。
      • 輔助索引:恭弘=叶 恭弘子結點的內容是主鍵的值。

    我們用一個例子來說明上面的概念,創建一張表,在字段k上有索引:

    create table T(
    id int primary key, 
    k int not null, 
    name varchar(16),
    index (k))engine=InnoDB;

      表中R1~R5的(ID,k)值分別為(100,1)、(200,2)、(300,3)、(500,5)和(600,6),兩顆B+樹如下,可以明顯看到這兩個顆樹的區別。

      使用普通索引查詢時,例如 select * from T where k = 2,需要先搜索k索引樹,得到ID的值為200;再到ID索引搜索一次。這個過程就叫做回表,非主鍵索引查詢需要多搜索一棵樹。

      參考資料:《MySQL實戰45講》

           《MySQL技術內幕:InnoDB存儲引擎》第二版

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※台北網頁設計公司全省服務真心推薦

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※推薦評價好的iphone維修中心

  • 4. union-find算法

    4. union-find算法

      算法的主題思想:

      1.優秀的算法因為能夠解決實際問題而變得更為重要;

      2.高效算法的代碼也可以很簡單;

      3.理解某個實現的性能特點是一個挑戰;

      4.在解決同一個問題的多種算法之間進行選擇時,科學方法是一種重要的工具;

      5.迭代式改進能夠讓算法的效率越來越高效;


       1. 動態連通性

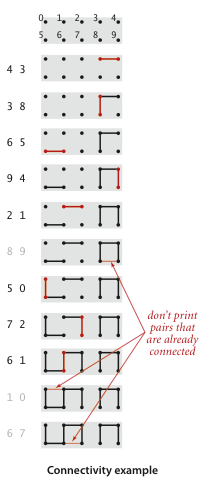
      動態連接:輸入是一對整數對的序列,其中每個整數代表某種類型的對象(或觸點),我們將整數對p q 解釋為意味着p連接到q。我們假設“連接到”是等價關係:

      對稱性:如果p連接到q,則q 連接到p。

      傳遞性:如果p連接到q且q 連接到r,則p連接到r。
      自反性:p與p連接。
      等價關係將對象劃分為多個等價類 或連接的組件。等價類稱為連通分量或分量。
      我們的目標是編寫一個程序,以從序列中過濾掉多餘的對:當程序從輸入中讀取整數對 p q時,只有在該對點不等價的情況下,才應將對寫入到輸出中,並且將p連接到q。如果等價,則程序應忽略整數對pq 並繼續讀取下對。


      動態連通性問題的應用:

        1.網絡

        2.變量名等價性

        3.數學集合

          在更高的抽象層次上,可以將輸入的所有整數看做屬於不同的數學集合。

       2. 定義問題

      設計算法的第一個任務就是精確地定義問題。

      算法解決的問題越大,它完成任務所需的時間和空間可能越多。我們不可能預先知道這其間的量化關係,通常只會在發現解決問題很困難,或是代價巨大,或是發現算法所提供的信息比原問題所需要的更加有用時修改問題。例如,連通性問題只要求我們的程序能夠判斷出給定的整數對是否相連,但並沒有要求給出兩者之間的通路上的所有連接。這樣的要求更難,並會得出另一組不同的算法。

      為了定義和說明問題,先設計一份API  來封裝基本操作: 初始化,連接兩個觸點,查找某個觸點的分量 ,判斷兩個觸點是否屬於同一分量,分量的數量:

        /// <summary>
        /// 動態連通API
        /// </summary>
        public interface IUnionFind
        {
            /// <summary>
            /// 連接
            /// </summary>
            /// <param name="p"></param>
            /// <param name="q"></param>
            void Union(int p, int q);
    
            /// <summary>
            /// 查找觸點 p 的分量標識符
            /// </summary>
            /// <param name="p"></param>
            /// <returns></returns>
            int Find(int p);
    
            /// <summary>
            /// 判斷兩個觸點是否處於同一分量
            /// </summary>
            /// <param name="p"></param>
            /// <param name="q"></param>
            /// <returns></returns>
            bool Connected(int p, int q);
    
            /// <summary>
            /// 連通分量的數量
            /// </summary>
            /// <returns></returns>
            int Count();
        }

      為解決動態連通性問題設計算法的任務轉化為實現這份API:

        1. 定義一種數據結構表示已知的連接;

        2. 基於此數據結構高效的實現API的方法;

      數據結構的性質會直接影響算法的效率。這裏,以觸點為索引,觸點和連接分量都是用 int 值表示,將會使用分量中某個觸點的值作為分量的標識符。所以,一開始,每個觸點都是只含有自己的分量,分量標識符為觸點的值。由此,可以初步實現一部分方法:


        public class FirstUnionFind:IUnionFind
        {
            private int[] id;//* 分量id 以觸點作為索引
            private int count;//分量數量
    
            public FirstUnionFind(int n)
            {
                count = n;
                id = new int[n];
                for (var i = 0; i < n; i++)
                {
                    id[i] = i; // 第一個 i 作為觸點,第二個 i 作為觸點的值
                }
            }
    
            public int Count()
            {
                return count;
            }
    
            public bool Connected(int p, int q)
            {
                return Find(p) == Find(q);
            }
    
            public int Find(int p)
            {
                
            }
    
            public void Union(int p, int q)
            {
                
            }
        }


      Union-find 的成本模型 是數組的訪問次數(無論讀寫)。

       3. quick-find算法實現

      quick-find 算法是保證當且僅當 id[p] 等於 id[q] 時,p 和 q 是連通的。也就是說,在同一個連通分量中的所有觸點在 id[ ] 中的值全部相等。

      所以 Find 方法只需返回 id[q],Union 方法需要先判斷 Find(p)  是否等於 Find(q) ,若相等直接返回;若不相等,需要將 q 所在的連通分量中所有觸點的 id [ ] 值全部更新為 id[p]。

        public class QuickFindUF: IUnionFind
        {
            private int[] id;//* 分量id 以觸點作為索引
            private int count;//分量數量
    
            public QuickFindUF(int n)
            {
                count = n;
                id = new int[n];
                for (var i = 0; i < n; i++)
                {
                    id[i] = i; // 第一個 i 作為觸點,第二個 i 作為觸點的值
                }
            }
    
            public int Count()
            {
                return count;
            }
    
            public bool Connected(int p, int q)
            {
                return Find(p) == Find(q);
            }
    
            public int Find(int p)
            {
                return id[p];
            }
    
            public void Union(int p, int q)
            {
                var pID = Find(p);
                var qID = Find(q);
    
                if (pID == qID)
                    return;
    
                for (var i = 0; i < id.Length; i++)
                {
                    if (id[i] == qID)
                        id[i] = pID;
                }
                count--; //連通分量減少
            }
    
            public void Show()
            {
                for(var i = 0;i<id.Length;i++)
                    Console.WriteLine("索引:"+i+",值:"+ id[i] );
                Console.WriteLine("連通分量數量:"+count);
            }
        }


      算法分析

      Find() 方法只需訪問一次數組,所以速度很快。但是對於處理大型問題,每對輸入 Union() 方法都需要掃描整個數組。

      每一次歸併兩個分量的 Union() 方法訪問數組的次數在 N+3 到 2N+1 之間。由代碼可知,兩次 Find 操作訪問兩次數組,掃描數組會訪問N次,改變其中一個分量中所有觸點的值需要訪問 1 到 N – 1 次(最好情況是該分量中只有一個觸點,最壞情況是該分量中有 N – 1個觸點),2+N+N-1。

      如果使用quick-find 算法來解決動態連通性問題並且最後只得到一個連通分量,至少需要調用 N-1 次Union() 方法,那麼至少需要 (N+3)(N-1) ~ N^2 次訪問數組,是平方級別的。


       4. quick-union算法實現

      quick-union 算法重點提高 union 方法的速度,它也是基於相同的數據結構 — 已觸點為索引的 id[ ] 數組,但是 id[ ] 的值是同一分量中另一觸點的索引(名稱),也可能是自己(根觸點)——這種聯繫成為鏈接。

      在實現 Find() 方法時,從給定觸點,鏈接到另一個觸點,知道到達根觸點,即鏈接指向自己。同時修改 Union() 方法,分別找到 p q 的根觸點,將其中一個根觸點鏈接到根觸點。

    public class QuickUnionUF : IUnionFind
        {
            private int[] id;
            private int count;
    
            public QuickUnionUF(int n)
            {
                count = n;
                id = new int[n];
                for (var i = 0; i < n; i++)
                {
                    id[i] = i; // 第一個 i 作為觸點,第二個 i 作為觸點的值
                }
            }
    
            public int Count()
            {
                return count;
            }
    
            public bool Connected(int p, int q)
            {
                return Find(p) == Find(q);
            }
    
            public int Find(int p)
            {
                while (p != id[p])
                    p = id[p];
                return p;
            }
    
            public void Union(int p, int q)
            {
                var pRoot = Find(p);
                var qRoot = Find(q);
    
                if (pRoot == qRoot)
                    return;
    
                id[pRoot] =qRoot;
    count
    --; //連通分量減少 } public void Show() { for (var i = 0; i < id.Length; i++) Console.WriteLine("索引:" + i + ",值:" + id[i]); Console.WriteLine("連通分量數量:" + count); } }


      森林表示

      id[ ] 數組用父鏈接的形式表示一片森林,用節點表示觸點。無論從任何觸點所對應的節點隨着鏈接查找,最後都將到達含有該節點的根節點。初始化數組之後,每個節點的鏈接都指向自己。


      算法分析

      定義:一棵樹的大小是它的節點的數量。樹中一個節點的深度是它到根節點的路徑上鏈接數。樹的高度是它的所有節點中的最大深度。

      quick-union 算法比 quick-find 算法更快,因為它對每對輸入不需要遍歷整個數組。

      分析quick-union 算法的成本比 quick-find 算法的成本要困難,因為quick-union 算法依賴於輸入的特點。在最好的情況下,find() 方法只需訪問一次數組就可以得到一個觸點的分量表示;在最壞情況下,需要 2i+1 次數組訪問(i 時觸點的深度)。由此得出,該算法解決動態連通性問題,在最佳情況下的運行時間是線性級別,最壞情況下的輸入是平方級別。解決了 quick-find 算法中 union() 方法總是線性級別,解決動態連通性問題總是平方級別。

      quick-union 算法中 find() 方法訪問數組的次數為 1(到達根節點只需訪問一次) 加上 給定觸點所對應節點的深度的兩倍(while 循環,一次讀,一次寫)。union() 訪問兩次 find() ,如果兩個觸點不在同一分量還需加一次寫數組。

       假設輸入的整數對是有序的 0-1, 0-2,0-3 等,N-1 對之後N個觸點將全部處於相同的集合之中,且得到的樹的高度為 N-1。由上可知,對於整數對 0-i , find() 訪問數組的次數為 2i + 1,因此,處理 N 對整數對所需的所有訪問數組的總次數為 3+5+7+ ……+(2N+1) ~ n^2


      5.加權 quick-union 算法實現

      簡單改動就可以避免 quick-union算法 出現最壞情況。quick-union算法 union 方法是隨意將一棵樹連接到另一棵樹,改為總是將小樹連接到大樹,這需要記錄每一棵樹的大小,稱為加權quick-union算法。

      代碼:

        public class WeightedQuickUnionUF: IUnionFind
        {
            int[] sz;//以觸點為索引的 各個根節點對應的分量樹大小
            private int[] id;
            private int count;
    
            public WeightedQuickUnionUF(int n)
            {
                count = n;
                id = new int[n];
                sz = new int[n];
                for (var i = 0; i < n; i++)
                {
                    id[i] = i; // 第一個 i 作為觸點,第二個 i 作為觸點的值
                    sz[i] = 1;
                }
            }
    
            public int Count()
            {
                return count;
            }
    
            public bool Connected(int p, int q)
            {
                return Find(p) == Find(q);
            }
    
            public int Find(int p)
            {
                while (p != id[p])
                    p = id[p];
                return p;
            }
    
            public void Union(int p, int q)
            {
                var pRoot = Find(p);
                var qRoot = Find(q);
    
                if (pRoot == qRoot)
                    return;
    
                if (sz[pRoot] < sz[qRoot])
                {
                    id[pRoot] = qRoot;
                }
                else
                {
                    id[qRoot] = pRoot;
                }
                    
                count--; //連通分量減少
            }
    
            public void Show()
            {
                for (var i = 0; i < id.Length; i++)
                    Console.WriteLine("索引:" + i + ",值:" + id[i]);
                Console.WriteLine("連通分量數量:" + count);
            }
        }


      算法分析

      加權 quicj-union 算法最壞的情況:


      這種情況,將要被歸併的樹的大小總是相等的(且總是 2 的 冥),都含有 2^n 個節點,高度都正好是 n 。當歸併兩個含有 2^n 個節點的樹時,得到的樹含有 2 ^ n+1 個節點,高度增加到 n+1 。

      節點大小: 1  2  4  8  2^k = N

      高       度: 0  1  2  3  k

      k = logN

      所以加權 quick-union 算法可以保證對數級別的性能。

      對於 N 個觸點,加權 quick-union 算法構造的森林中的任意節點的深度最多為logN。

      對於加權 quick-union 算法 和 N 個觸點,在最壞情況下 find,connected 和 union 方法的成本的增長量級為 logN。

      對於動態連通性問題,加權 quick-union 算法 是三種算法中唯一可以用於解決大型問題的算法。加權 quick-union 算法 處理 N 個觸點和 M 條連接時最多訪問數組 c M logN 次,其中 c 為常數。


      三個算法處理一百萬個觸點運行時間對比:


      三個算法性能特點:


      6.最優算法 – 路徑壓縮

      在檢查節點的同時將它們直接連接到根節點。

      實現:為 find 方法添加一個循環,將在路徑上的所有節點都直接鏈接到根節點。完全扁平化的樹。


      研究各種基礎問題的基本步驟:

      1. 完整而詳細地定義問題,找出解決問題所必須的基本抽象操作並定義一份API。

      2. 簡潔地實現一種初級算法,給出一個精心組織的開發用例並使用實際數據作為輸入。

      3. 當實現所能解決的問題的最大規模達不到期望時決定改進還是放棄。

      4. 逐步改進實現,通過經驗性分析和數學分析驗證改進后的效果。

      5. 用更高層次的抽象表示數據結構或算法來設計更高級的改進版本。

      6. 如果可能盡量為最壞情況下的性能提供保證,但在處理普通數據時也要有良好的性能。

      7.在適當的時候將更細緻的深入研究留給有經驗的研究者並解決下一個問題。


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※台北網頁設計公司這麼多該如何選擇?

    ※智慧手機時代的來臨,RWD網頁設計為架站首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※回頭車貨運收費標準