標籤: 如何寫文案

  • 死磕哈弗H2S?這款新SUV未來能8萬起就賣瘋的節奏

    死磕哈弗H2S?這款新SUV未來能8萬起就賣瘋的節奏

    車身長寬高為4310×1780×1680mm,軸距達到了2600mm。動力系統:奔騰X40或將搭載1。6L發動機,最大功率116馬力,峰值扭矩達到155牛米。傳動方面搭配5速手動和來自愛信的6速自動變速箱。競爭對手:長城汽車-哈弗H2s指導價:8。38-10。28萬在內飾的設計、用料上,哈弗H2s可謂佔盡優勢。

    一汽奔騰在推出了入門轎車奔騰B30后,又再一次把目光投向火熱的SUV市場。近日一汽全新SUV-奔騰X40正式出現在人們的視野之中!

    它的外觀沿襲了奔騰X80的設計語言,也以動感、大氣的風格為主!開眼角的頭燈造型和六邊形的中網設計很漂亮。

    側面和尾部的設計很厚重、腰線力量感很足夠,車頂還採用了雙色車身的設計。

    內飾則採用黑米雙色的設計,做工和用料也是一貫奔騰的風格。懸浮式中控大屏設計得體。

    其實一汽奔騰X40採用一汽自主研發的A級平台打造而來。車身長寬高為4310×1780×1680mm,軸距達到了2600mm。

    動力系統:

    奔騰X40或將搭載1.6L發動機,最大功率116馬力,峰值扭矩達到155牛米。傳動方面搭配5速手動和來自愛信的6速自動變速箱。

    競爭對手:

    長城汽車-哈弗H2s

    指導價:8.38-10.28萬

    在內飾的設計、用料上,哈弗H2s可謂佔盡優勢。包括髮動機的功率也讓自吸的奔騰X40有些汗顏,但是動力匹配和穩定性上奔騰X40更有優勢。

    編者點評:

    奔騰X40的定位其實很符合現在消費者的需求,而它要是能在價格和配置上多些誠意的話,未來的銷量或迎來爆發。本站聲明:網站內容來源於http://www.auto6s.com/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※別再煩惱如何寫文案,掌握八大原則!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

    ※回頭車貨運收費標準

  • 最值得推薦的法繫緊湊型轎車-308怎麼買才會不吃虧

    最值得推薦的法繫緊湊型轎車-308怎麼買才會不吃虧

    6L手動時尚貴了1萬元,發動機變為3缸1。2T的,性價比也不算很高。所以相比較來說,1。6L手動時尚版的性價比是最高的。豪華版比時尚版貴了5000左右,但是卻多了這麼多的配置,性價比不錯。另外1。2T自動豪華比1。6L自動豪華貴了8000元,相比較手動擋的10000元的差價還是實惠了一些。

    在新款308之前,法系車-標緻在國內幾乎沒有一款可以拿得出手的緊湊型轎車,因為408價格較貴,老款的308實在是太丑了,所以在這個領域標緻的銷量一直比較差。

    但是自從新款308上市之後,這個局面得到了一定程度的改善。憑藉著漂亮的外觀和不算太貴的價格,308十月份也交出了10226輛的銷量,表現還算可以。所以下面我們就來介紹一下這台車究竟哪款車的性價比最高(只介紹新款308)。

    新款308於今年9月25日晚在西安宣布正式上市,新車搭載1.6L、1.2T、1.6T三種動力共計6款車型可以供消費者選擇,指導價為9.97-15.97萬元,不過老款車型改名為308經典,還將繼續在市場上銷售。

    新款308要比老款的308強不少,所以這也是我們只推薦新款308的原因。308的車身尺寸為4590*1820*1488mm,軸距為2675mm,雖然尺寸不是很大,但這也是邁進了主流緊湊型轎車的水平。

    標緻308使用了全新的EMp2平台,所以說相對於老款的拉皮308,進步也是非常大的。內飾造型前衛,並沒有完全照搬308S的內飾風格,使用了標緻家族最新的家族化設計,看起來更加新潮。

    308的配置共分為三個等級,分別為時尚版、豪華版和尊貴版,同級別的配置大致上相等,這樣區分起來就比較簡單了。其中時尚版的主要配置有ESp、上坡輔助、鋁合金輪圈、LED日間行車燈等。這樣的配置水平算是處於中等水平吧!

    1.6L手動時尚版為最低配車型,性價比還行,1.6L自動時尚比手動時尚貴了1.3萬元,只是多了一台6AT變速箱,這個價格確實有點貴了,性價比不高;1.2T手動時尚車型比1.6L手動時尚貴了1萬元,發動機變為3缸1.2T的,性價比也不算很高。

    所以相比較來說,1.6L手動時尚版的性價比是最高的。

    豪華版比時尚版貴了5000左右,但是卻多了這麼多的配置,性價比不錯。另外1.2T自動豪華比1.6L自動豪華貴了8000元,相比較手動擋的10000元的差價還是實惠了一些。另外1.2T車型的推背感更足,也更具有駕駛樂趣。

    所以,1.6L、1.2T自動豪華型性價比很高。

    到了1.6T車型,也就是頂配車型,配置確實比豪華型高了不少,並且1.6T發動機也是標緻的“當家花旦”,性能很不錯。只是高達15.97萬的售價,讓人望而卻步,因為有這麼多錢,為什麼不去買跑得更快的思域、名氣更大的速騰呢?

    所以說,最推薦的還是1.6L、1.2T自動豪華型,其次是1.6L手動時尚版,頂配車型的性價比一般。因為這個價位的競爭對手太強大。不過目前308由於是剛上市,市場優惠較小,所以說和同級別比起來,性價比不是很高,小編覺得本來法系車的銷量就很一般,你如果不把性價比做上去,銷量還是不會有太大的進步的。本站聲明:網站內容來源於http://www.auto6s.com/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

    ※教你寫出一流的銷售文案?

    ※網頁設計最專業,超強功能平台可客製化

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

    ※台中搬家遵守搬運三大原則,讓您的家具不再被破壞!

    【其他文章推薦】

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

    ※教你寫出一流的銷售文案?

    ※網頁設計最專業,超強功能平台可客製化

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

    ※台中搬家遵守搬運三大原則,讓您的家具不再被破壞!

  • 這款美系家轎省油又舒適,看看車主怎麼說

    這款美系家轎省油又舒適,看看車主怎麼說

    配置上沒能显示百公里油耗。輪胎用的是佳通195,真令人無語。升降窗戶按鈕並沒有夜光燈,晚上是要瞎摸的節奏。目前行駛里程:現在開了2000公里,油耗穩定在6。9L/100km,手動擋果然是省油利器。車主:123木頭人購買車型:2016款 15N 自動精英型裸車購買價:10。

    前言

    英朗在中國一直給人居家好車的形象,因此銷量一直都很不錯。無論是底盤的厚實感,還是隔音都給人不錯的印象,事實到底怎麼樣,下面請看幾位車主的說法。

    車主:DJ

    購買車型:2016款 15N 自動精英型

    裸車購買價:9.89萬

    最滿意的點:性價比很高,開起來也比較容易上手。車裡的空間和座椅的舒適性都很好,之前車子載着4個人出外旅遊,無論前後左右的空間,都很寬敞。這車操控性不錯,指向也精準,很容易開。

    最不滿意的點:油耗略微偏高了一點,門板上的儲物空間並不充足。動力也不是很充足,上長坡時會顯得乏力。內飾設計缺乏亮點,別克的車很擅於營造豪華感,但英朗就是一個特例。

    目前行駛里程:現在已經開了3000公里,首保之前的油耗在8.2L/100km,做完首保以後就逐漸下降到7.2L/100km,還是很令人滿意。

    車主:梁先生

    購買車型:2016款 15N 手動進取型

    裸車購買價:8.99萬

    最滿意的點:外觀相當漂亮,特別是那銳利的日間行車燈,簡直攝人心魄。這個價位帶有車身穩定系統也很厚道。油耗很令我滿意。底盤的濾震有厚實感,面對坑窪以及橋頭跳都可以很安穩地應對。

    最不滿意的點:作為一個20年的老煙槍,這車只配點煙器而沒有煙缸,確實太不像話了。配置上沒能显示百公里油耗。輪胎用的是佳通195,真令人無語。升降窗戶按鈕並沒有夜光燈,晚上是要瞎摸的節奏。

    目前行駛里程:現在開了2000公里,油耗穩定在6.9L/100km,手動擋果然是省油利器。

    車主:123木頭人

    購買車型:2016款 15N 自動精英型

    裸車購買價:10.19萬

    最滿意的點:外觀時尚靚麗,紅色車身看起來更顯高貴。操控算是很優良,轉向基本指哪打哪。座椅的材質較為柔軟,後排座椅可以放倒,而前排也可以放得很低。性價比夠高,許多該有配置都有了。

    最不滿意的點:動力很一般,油門響應也不夠快,緊急超車時動力並不能很好跟上。白色車身不耐臟,而且髒了以後,清潔麻煩。內飾設計比較普通,沒有別克應有的水準,感覺略微有點失望。

    目前行駛里程:到現在為止,已經開了8700公里,百公里綜合油耗為7.5L左右,上到高速可以下降到6.5左右,很令我滿意。

    編者總結:

    從以上三位車主的說法中,可以看出英朗確實是一款居家好車,省心舒適。不過,如果你想要動力與很好的操控,就不該對它有所眷戀了。本站聲明:網站內容來源於http://www.auto6s.com/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※教你寫出一流的銷售文案?

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※回頭車貨運收費標準

    ※別再煩惱如何寫文案,掌握八大原則!

    ※超省錢租車方案

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

    ※推薦台中搬家公司優質服務,可到府估價

  • 聚焦共享車新政 海馬汽車與易鑫金融達成20000台戰略合作

    聚焦共享車新政 海馬汽車與易鑫金融達成20000台戰略合作

    福美來品牌新變 樹立共享車市場典範自九月底以來,海馬汽車開啟聚焦福美來品牌的全新戰略,將福美來從產品品牌升級為品類品牌,繼福美來轎車、福美來七座版后,再將福美來專車版納入福美來品牌體系,並與福美來七座版一道作為福美來家轎品牌下的首發明星組合進軍汽車租賃市場以及互聯網+汽車金融時代的家庭用車市場,則是福美來品牌新變后的一大重要營銷舉措。

    月初,隨着《網絡預約出租汽車經營服務管理暫行辦法》的正式實施,各地的網約車細則也在陸續出台,共享車市場面臨整肅和洗牌,不少車型被網約車准入指標的高門檻拒之門外。不過,隨着汽車共享經濟的異軍突起,共享車市場發展趨勢不可逆轉。新政策的出台對廣大車企而言既是挑戰,更是機遇。抓住機會,創新變革,則有望分得共享經濟紅利。而福美來旗下的兩大車型–福美來七座版和福美來專車版便是新政施行之初的首批獲益者。

    11月25日,海馬汽車與易鑫金融共享車合作暨福美來系列20000台訂單簽約儀式在海馬汽車大本營–海南海口成功舉行,福美來旗下兩大車型福美來七座版和福美來專車版分別憑藉七座大空間、愉悅尊貴等產品力優勢,以及穩定可靠的產品品質獲得易鑫金融的青睞。雙方達成20000輛車的供車合作協議,共同發力共享車市場。

    易鑫金融是中國領先的互聯網汽車金融交易平台,易鑫金融旗下的易鑫車貸App及daikuan.com為廣大消費者提供新車貸款、二手車貸款、車主貸款,汽車租賃以及汽車保險等全方位的汽車金融服務。目前,累計服務用戶超1000萬人,日均線上個人車貸需求金額20億元,資產規模近200億元

    福美來兩大旗艦車型 全面滿足共享車市場需求

    作為2016年9月上市的多座版家用轎車,福美來七座版的超大空間、舒適安全等優點廣受市場認可。福美來七座版在整車尺寸上極具優勢,同時內部座椅角度也可進行靈活調整,實現了60種座椅組合方式,真正將空間的靈活多變性發揮到了極致,可最大限度滿足多人集體出行、商務接待、載物等需求。此外,福美來七座版在安全上也下足了功夫。

    除了諸多厚道的主、被動安全配備,海馬自身對車輛實地安全測試和安全舒適駕乘做到嚴格把關,真正讓消費者感到安心和舒心,並且以互聯網思維為原點,結合家庭用戶兼顧商務用戶的使用需求,配備了HM-Link極智車載互聯繫統、高效T動力、及多項科技配置,使得福美來七座版給消費者帶來超越同級的舒適尊享駕乘感。

    憑藉七座大空間的核心優勢、結合安靜舒適、強力安全和智能科技等強悍產品力,福美來七座版為多人出行提供更具溫情和性價比的解決方案,全面滿足了商務與多口之家的出行所需,從眾多車型中脫穎而出,成為了汽車租賃市場的先行者。

    七座大空間,福美來七座版完美承載多人出行

    相對於福美來七座版的適合多人出行優勢,福美來專車版在整車尊享駕控方面同樣惹人注目。據悉,福美來專車版是在海馬M8的基礎上針對共享車市場進行升級的定製版本,是福美來品牌升級后的又一重磅舉措。

    兼具舒適與安全,福美來專車版精準駕控愉悅尊享

    福美來專車版是海馬汽車在整車造車技術上的最高體現,在自主中高級車市場中,以整體造車解決方案獨樹一幟,轎跑底盤配合渦輪增壓發動機營造出強悍T動力,并力求通過精準駕控、全面安全、愉悅尊享等智能技術的應用為消費者提供了尊享高檔的駕乘享受,是一款充分洞察消費者用車需求后傾力打造的中高級座駕,非常適用於專車市場以及互聯網+汽車金融時代的家庭用車市場。

    福美來品牌新變 樹立共享車市場典範

    自九月底以來,海馬汽車開啟聚焦福美來品牌的全新戰略,將福美來從產品品牌升級為品類品牌,繼福美來轎車、福美來七座版后,再將福美來專車版納入福美來品牌體系,並與福美來七座版一道作為福美來家轎品牌下的首發明星組合進軍汽車租賃市場以及互聯網+汽車金融時代的家庭用車市場,則是福美來品牌新變后的一大重要營銷舉措。

    海馬汽車集團股份有限公司執行董事、一汽海馬汽車有限公司總經理盧國綱說道:“借力此次合作,福美來品牌正式開啟共享車模式,一方面希望可以幫助有用車需求的用戶提供更加靈活方便、更高性價比、更豐富的車型選擇;幫助用戶避免不必要的消費,以租賃代替購買,養成更加共享和環保的出行方式,另一方面,希望可以解決大城市公共交通無法消化的出行需求。”福美來20000輛車進軍共享車市場,從租賃車和專車兩方面入手,在滿足廣大用戶高端出行需求的同時,也以強力安全、安靜舒適為駕乘者提供尊享優越的出行體驗,使用戶以更低費用獲取更具性價比的超值服務。

    共享車經濟的發展,對汽車行業而言既是挑戰也是機遇。此次海馬與易鑫金融的聯袂合作,不僅是一汽海馬以市場為導向的积極應對,更是其在“互聯網+共享車+汽車營銷+移動出行”方面做出的前瞻布局。我們有理由相信,海馬攜手易鑫金融飲得共享車市場頭啖湯的同時,也必將成為汽車業和金融資本開展互聯網營銷創新的理想範本。

    海馬汽車概況

    海馬汽車集團股份有限公司(簡稱海馬汽車集團)位於海南省海口市金盤工業區金盤路12-8號,註冊資金16.5億元,總資產150億元,在深交所掛牌上市,股票代碼為000572,以汽車產業為主業,致力於中國民族汽車工業的發展。

    海馬汽車集團旗下有海馬轎車有限公司、海馬商務汽車有限公司、一汽海馬汽車有限公司、上海海馬研發有限公司、海馬財務有限公司、金盤實業有限公司等。

    二十餘年來,海馬汽車集團貼近中國汽車市場,秉承“開放合作、學習創新、自主多贏”的發展理念,堅持“先做精、后做強、再做穩、不爭大”的經營理念,建成海口、鄭州和上海三個產業基地,產品覆蓋麵包車、轎車、MpV、SUV和新能源汽車五大領域,直屬員工1萬多人,關聯企業員工3萬多人,年產值100多億元,累計納稅150多億元。

    海馬汽車集團規劃年產銷整車一百萬輛。

    易鑫金融概況

    易鑫金融是中國領先的互聯網汽車金融交易平台,由易車、騰訊、京東、百度等互聯網巨頭注資60億元。易鑫金融旗下的易鑫車貸App及daikuan.com為廣大消費者提供新車貸款、二手車貸款、車主貸款,汽車租賃以及汽車保險等全方位的汽車金融服務。在線提供230個品牌汽車、2300餘家銀行及金融機構的金融產品可供用戶選擇,線下擁有5000人購車顧問、3萬餘家合作經銷商,服務遍及全國300多個城市。截至目前,累計服務用戶超1000萬人,日均線上個人車貸需求金額20億元,資產規模近200億元。本站聲明:網站內容來源於http://www.auto6s.com/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※超省錢租車方案

    ※別再煩惱如何寫文案,掌握八大原則!

    ※回頭車貨運收費標準

    ※教你寫出一流的銷售文案?

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※網頁設計最專業,超強功能平台可客製化

  • 關於 鎖的四種狀態與鎖升級過程 圖文詳解

    關於 鎖的四種狀態與鎖升級過程 圖文詳解

    一、前言

    鎖的狀態總共有四種,級別由低到高依次為:無鎖、偏向鎖、輕量級鎖、重量級鎖,這四種鎖狀態分別代表什麼,為什麼會有鎖升級?其實在 JDK 1.6之前,synchronized 還是一個重量級鎖,是一個效率比較低下的鎖,但是在JDK 1.6后,Jvm為了提高鎖的獲取與釋放效率對(synchronized )進行了優化,引入了 偏向鎖 和 輕量級鎖 ,從此以後鎖的狀態就有了四種(無鎖、偏向鎖、輕量級鎖、重量級鎖),並且四種狀態會隨着競爭的情況逐漸升級,而且是不可逆的過程,即不可降級,也就是說只能進行鎖升級(從低級別到高級別),不能鎖降級(高級別到低級別),意味着偏向鎖升級成輕量級鎖后不能降級成偏向鎖。這種鎖升級卻不能降級的策略,目的是為了提高獲得鎖和釋放鎖的效率。

    二、鎖的四種狀態

    在 synchronized 最初的實現方式是 “阻塞或喚醒一個Java線程需要操作系統切換CPU狀態來完成,這種狀態切換需要耗費處理器時間,如果同步代碼塊中內容過於簡單,這種切換的時間可能比用戶代碼執行的時間還長”,這種方式就是 synchronized實現同步最初的方式,這也是當初開發者詬病的地方,這也是在JDK6以前 synchronized效率低下的原因,JDK6中為了減少獲得鎖和釋放鎖帶來的性能消耗,引入了“偏向鎖”和“輕量級鎖”。

    所以目前鎖狀態一種有四種,從級別由低到高依次是:無鎖、偏向鎖,輕量級鎖,重量級鎖,鎖狀態只能升級,不能降級

    如圖所示:

    三、鎖狀態的思路以及特點

    鎖狀態 存儲內容 標誌位
    無鎖 對象的hashCode、對象分代年齡、是否是偏向鎖(0) 01
    偏向鎖 偏向線程ID、偏向時間戳、對象分代年齡、是否是偏向鎖(1) 01
    輕量級鎖 指向棧中鎖記錄的指針 00
    重量級鎖 指向互斥量的指針 11

    四、鎖對比

    鎖 優點 缺點 適用場景
    偏向鎖 加鎖和解鎖不需要額外的消耗,和執行非同步方法相比僅存在納秒級的差距 如果線程間存在鎖競爭,會帶來額外的鎖撤銷的消耗 適用於只有一個線程訪問同步塊場景
    輕量級鎖 競爭的線程不會阻塞,提高了程序的響應速度 如果始終得不到索競爭的線程,使用自旋會消耗CPU 追求響應速度,同步塊執行速度非常快
    重量級鎖 線程競爭不使用自旋,不會消耗CPU 線程阻塞,響應時間緩慢 追求吞吐量,同步塊執行速度較慢

    五、Synchronized鎖

    synchronized 用的鎖是存在Java對象頭裡的,那麼什麼是對象頭呢?

    5.1 Java 對象頭

    我們以 Hotspot 虛擬機為例,Hopspot 對象頭主要包括兩部分數據:Mark Word(標記字段) 和 Klass Pointer(類型指針)

    Mark Word:默認存儲對象的HashCode,分代年齡和鎖標誌位信息。這些信息都是與對象自身定義無關的數據,所以Mark Word被設計成一個非固定的數據結構以便在極小的空間內存存儲盡量多的數據。它會根據對象的狀態復用自己的存儲空間,也就是說在運行期間Mark Word里存儲的數據會隨着鎖標誌位的變化而變化。

    Klass Point:對象指向它的類元數據的指針,虛擬機通過這個指針來確定這個對象是哪個類的實例。

    在上面中我們知道了,synchronized 用的鎖是存在Java對象頭裡的,那麼具體是存在對象頭哪裡呢?答案是:存在鎖對象的對象頭的Mark Word中,那麼MarkWord在對象頭中到底長什麼樣,它到底存儲了什麼呢?

    在64位的虛擬機中:

    在32位的虛擬機中:

    下面我們以 32位虛擬機為例,來看一下其 Mark Word 的字節具體是如何分配的

    無鎖:對象頭開闢 25bit 的空間用來存儲對象的 hashcode ,4bit 用於存放對象分代年齡,1bit 用來存放是否偏向鎖的標識位,2bit 用來存放鎖標識位為01

    偏向鎖: 在偏向鎖中劃分更細,還是開闢 25bit 的空間,其中23bit 用來存放線程ID,2bit 用來存放 Epoch,4bit 存放對象分代年齡,1bit 存放是否偏向鎖標識, 0表示無鎖,1表示偏向鎖,鎖的標識位還是01

    輕量級鎖:在輕量級鎖中直接開闢 30bit 的空間存放指向棧中鎖記錄的指針,2bit 存放鎖的標誌位,其標誌位為00

    重量級鎖: 在重量級鎖中和輕量級鎖一樣,30bit 的空間用來存放指向重量級鎖的指針,2bit 存放鎖的標識位,為11

    GC標記: 開闢30bit 的內存空間卻沒有佔用,2bit 空間存放鎖標誌位為11。

    其中無鎖和偏向鎖的鎖標誌位都是01,只是在前面的1bit區分了這是無鎖狀態還是偏向鎖狀態

    關於內存的分配,我們可以在git中openJDK中 markOop.hpp 可以看出:

    public:
      // Constants
      enum { age_bits                 = 4,
             lock_bits                = 2,
             biased_lock_bits         = 1,
             max_hash_bits            = BitsPerWord - age_bits - lock_bits - biased_lock_bits,
             hash_bits                = max_hash_bits > 31 ? 31 : max_hash_bits,
             cms_bits                 = LP64_ONLY(1) NOT_LP64(0),
             epoch_bits               = 2
      };
    
    • age_bits: 就是我們說的分代回收的標識,佔用4字節
    • lock_bits: 是鎖的標誌位,佔用2個字節
    • biased_lock_bits: 是是否偏向鎖的標識,佔用1個字節
    • max_hash_bits: 是針對無鎖計算的hashcode 佔用字節數量,如果是32位虛擬機,就是 32 – 4 – 2 -1 = 25 byte,如果是64 位虛擬機,64 – 4 – 2 – 1 = 57 byte,但是會有 25 字節未使用,所以64位的 hashcode 佔用 31 byte
    • hash_bits: 是針對 64 位虛擬機來說,如果最大字節數大於 31,則取31,否則取真實的字節數
    • cms_bits: 不是64位虛擬機就佔用 0 byte,是64位就佔用 1byte
    • epoch_bits: 就是 epoch 所佔用的字節大小,2字節。

    5.2 Monitor

    Monitor 可以理解為一個同步工具或一種同步機制,通常被描述為一個對象。每一個 Java 對象就有一把看不見的鎖,稱為內部鎖或者 Monitor 鎖。

    Monitor 是線程私有的數據結構,每一個線程都有一個可用 monitor record 列表,同時還有一個全局的可用列表。每一個被鎖住的對象都會和一個 monitor 關聯,同時 monitor 中有一個 Owner 字段存放擁有該鎖的線程的唯一標識,表示該鎖被這個線程佔用。

    Synchronized是通過對象內部的一個叫做監視器鎖(monitor)來實現的,監視器鎖本質又是依賴於底層的操作系統的 Mutex Lock(互斥鎖)來實現的。而操作系統實現線程之間的切換需要從用戶態轉換到核心態,這個成本非常高,狀態之間的轉換需要相對比較長的時間,這就是為什麼 Synchronized 效率低的原因。因此,這種依賴於操作系統 Mutex Lock 所實現的鎖我們稱之為重量級鎖。

    隨着鎖的競爭,鎖可以從偏向鎖升級到輕量級鎖,再升級的重量級鎖(但是鎖的升級是單向的,也就是說只能從低到高升級,不會出現鎖的降級)。JDK 1.6中默認是開啟偏向鎖和輕量級鎖的,我們也可以通過-XX:-UseBiasedLocking=false來禁用偏向鎖。

    六、鎖的分類

    6.2 無鎖

    無鎖是指沒有對資源進行鎖定,所有的線程都能訪問並修改同一個資源,但同時只有一個線程能修改成功。

    無鎖的特點是修改操作會在循環內進行,線程會不斷的嘗試修改共享資源。如果沒有衝突就修改成功並退出,否則就會繼續循環嘗試。如果有多個線程修改同一個值,必定會有一個線程能修改成功,而其他修改失敗的線程會不斷重試直到修改成功。

    6.3 偏向鎖

    初次執行到synchronized代碼塊的時候,鎖對象變成偏向鎖(通過CAS修改對象頭裡的鎖標誌位),字面意思是“偏向於第一個獲得它的線程”的鎖。執行完同步代碼塊后,線程並不會主動釋放偏向鎖。當第二次到達同步代碼塊時,線程會判斷此時持有鎖的線程是否就是自己(持有鎖的線程ID也在對象頭裡),如果是則正常往下執行。由於之前沒有釋放鎖,這裏也就不需要重新加鎖。如果自始至終使用鎖的線程只有一個,很明顯偏向鎖幾乎沒有額外開銷,性能極高。

    偏向鎖是指當一段同步代碼一直被同一個線程所訪問時,即不存在多個線程的競爭時,那麼該線程在後續訪問時便會自動獲得鎖,從而降低獲取鎖帶來的消耗,即提高性能。

    當一個線程訪問同步代碼塊並獲取鎖時,會在 Mark Word 里存儲鎖偏向的線程 ID。在線程進入和退出同步塊時不再通過 CAS 操作來加鎖和解鎖,而是檢測 Mark Word 里是否存儲着指向當前線程的偏向鎖。輕量級鎖的獲取及釋放依賴多次 CAS 原子指令,而偏向鎖只需要在置換 ThreadID 的時候依賴一次 CAS 原子指令即可。

    偏向鎖只有遇到其他線程嘗試競爭偏向鎖時,持有偏向鎖的線程才會釋放鎖,線程是不會主動釋放偏向鎖的。

    關於偏向鎖的撤銷,需要等待全局安全點,即在某個時間點上沒有字節碼正在執行時,它會先暫停擁有偏向鎖的線程,然後判斷鎖對象是否處於被鎖定狀態。如果線程不處於活動狀態,則將對象頭設置成無鎖狀態,並撤銷偏向鎖,恢復到無鎖(標誌位為01)或輕量級鎖(標誌位為00)的狀態。

    6.4 輕量級鎖(自旋鎖)

    輕量級鎖是指當鎖是偏向鎖的時候,卻被另外的線程所訪問,此時偏向鎖就會升級為輕量級鎖,其他線程會通過自旋(關於自旋的介紹見文末)的形式嘗試獲取鎖,線程不會阻塞,從而提高性能。

    輕量級鎖的獲取主要由兩種情況:
    ① 當關閉偏向鎖功能時;
    ② 由於多個線程競爭偏向鎖導致偏向鎖升級為輕量級鎖。

    一旦有第二個線程加入鎖競爭,偏向鎖就升級為輕量級鎖(自旋鎖)。這裏要明確一下什麼是鎖競爭:如果多個線程輪流獲取一個鎖,但是每次獲取鎖的時候都很順利,沒有發生阻塞,那麼就不存在鎖競爭。只有當某線程嘗試獲取鎖的時候,發現該鎖已經被佔用,只能等待其釋放,這才發生了鎖競爭。

    在輕量級鎖狀態下繼續鎖競爭,沒有搶到鎖的線程將自旋,即不停地循環判斷鎖是否能夠被成功獲取。獲取鎖的操作,其實就是通過CAS修改對象頭裡的鎖標誌位。先比較當前鎖標誌位是否為“釋放”,如果是則將其設置為“鎖定”,比較並設置是原子性發生的。這就算搶到鎖了,然後線程將當前鎖的持有者信息修改為自己。

    長時間的自旋操作是非常消耗資源的,一個線程持有鎖,其他線程就只能在原地空耗CPU,執行不了任何有效的任務,這種現象叫做忙等(busy-waiting)。如果多個線程用一個鎖,但是沒有發生鎖競爭,或者發生了很輕微的鎖競爭,那麼synchronized就用輕量級鎖,允許短時間的忙等現象。這是一種折衷的想法,短時間的忙等,換取線程在用戶態和內核態之間切換的開銷。

    6.4 重量級鎖

    重量級鎖顯然,此忙等是有限度的(有個計數器記錄自旋次數,默認允許循環10次,可以通過虛擬機參數更改)。如果鎖競爭情況嚴重,某個達到最大自旋次數的線程,會將輕量級鎖升級為重量級鎖(依然是CAS修改鎖標誌位,但不修改持有鎖的線程ID)。當後續線程嘗試獲取鎖時,發現被佔用的鎖是重量級鎖,則直接將自己掛起(而不是忙等),等待將來被喚醒。

    重量級鎖是指當有一個線程獲取鎖之後,其餘所有等待獲取該鎖的線程都會處於阻塞狀態。

    簡言之,就是所有的控制權都交給了操作系統,由操作系統來負責線程間的調度和線程的狀態變更。而這樣會出現頻繁地對線程運行狀態的切換,線程的掛起和喚醒,從而消耗大量的系統資

    五、總結

    文中講述了鎖的四種狀態以及鎖是如何一步一步升級的過程,文中有理解不到位或者有問題的地方,歡迎大家在評論區中下方指出和交流,謝謝大家

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※教你寫出一流的銷售文案?

    ※別再煩惱如何寫文案,掌握八大原則!

  • 一文了解Docker容器技術的操作

    一文了解Docker容器技術的操作

    一文了解Docker容器技術的操作

    前言一、Docker是什麼二、Docker的安裝及測試Docker的安裝Docker的Hello world測試三、Docker的常見操作鏡像的基本操作容器的基本操作鏡像、容器的導入和導出四、關於DockerFile總結

    前言

    相信點進這篇文章的Coder,不管是在各大技術論壇上、技術交流群,亦或招聘網上,應該都有見到過Doker容器技術的面孔,隨着社會節奏的加快以及迫於生活的壓力,在計算機技術日新月異的今天,真正能夠沉下心來學習一門技術的時間真的不多。趁着這段空閑的時間,濤耶也該是時候把過去學習時所積累的筆記沉澱一下了。本文主要是從是什麼、為什麼、怎麼做的角度來介紹Docker容器技術的入門,能讓初次接觸Docker容器技術的朋友更快更便捷的使用Docker。

    一、Docker是什麼

    對於Docker,官方的介紹如下:

    Docker 是一個開源的應用容器引擎,讓開發者可以打包他們的應用以及依賴包到一個可移植的鏡像中,然後發布到任何流行的 Linux或Windows機器上,也可以實現虛擬化。容器是完全使用沙箱機制,相互之間不會有任何接口。

    在實際的開發過程中,我們往往會因為環境的搭建而浪費過多的時間,而現如今有了Docker容器技術的支持,我們不再過於擔心各種因為環境問題而造成的過多時間的浪費。Docker容器引擎中已經為我們提供了開發過程中所需要的各種鏡像,我們需要有Resid數據庫、Elasticsearch搜索技術、Mq消息隊列等支持,我們都可以使用Docker中的pull命令來從中央倉庫中進行拉取,而不像傳統那樣從各大官網亦或github中進行下載。讀到這裏的朋友應該會有所發現,Docker就有點類似Maven管理工具,或者直接將Docker看做一個裝載了大量“物資”的集裝箱,但Docker的強大之處可並不止步於此,查閱了解后,Docker主要有以下幾大特性:

    • Automating the packaging and deployment of applications(使應用的打包與部署自動化)
    • Creation of lightweight, private PAAS environments(創建輕量、私密的PAAS環境)
    • Automated testing and continuous integration/deployment(實現自動化測試和持續的集成/部署)
    • Deploying and scaling web apps, databases and backend services(部署與擴展webapp、數據庫和後台服務)

    總之,Docker容器是現如今相當火熱的一門技術。之前讀到網上有着這麼一句話:電腦如果有問題,沒有是重裝系統解決不了的。話雖如此,但是一旦重裝系統之後,我們之前系統中所有保存資源都被消除了,我們需要使用QQ增進朋友之間的感情,則要到鵝廠中去下載、安裝;需要網易雲音樂來放鬆心情,則要到官網中安裝、下載,以及需要下載並安裝其他各大軟件才能滿足自己的實際需求,一個不小心還可能會綁架其他垃圾軟件。當然有的朋友會在重裝系統之前自己的資源備份以下,重裝系統之後再直接使用,但依然免不了N個下一步所帶來的時間消耗。假如現在有這麼一個容器,裏面存放着我們需要的所有資源,在我們需要的時候只需要一行簡單的pull命令即可迅速完成所有軟件的下載安裝步驟,這豈不美哉!

    沒錯,Docker容器就是基於這麼一個思想來解決我們各大煩惱。如果對於Docker容器技術的理解還不是特別清楚,可拜讀一下大佬的文章:漫畫 | 從搬家到容器技術 Docker 應用場景解析,這篇文章使用漫畫的形式來給讀者介紹Docker容器的優勢。

    二、Docker的安裝及測試

    Docker的安裝

    我們往往是使用Linux系統來安裝Docker,在之前的文章也有過Linux系統的安裝,這裏就不多介紹了。下面我們就在CentOS Linux release 8.0.1905 (Core)系統下來安裝一下Docker吧。

    首選使用cat /etc/redhat-release查看一下自己的Linux版本:

    [root@iZm5eei156c9h3hrdjpe77Z ~]# cat /etc/redhat-release
    CentOS Linux release 8.0.1905 (Core)

    在安裝Docker之前,我們先把yum更新一下

    update yum

    安裝Docker需要的軟件包

    yum install -y yum-utils device-mapper-persistent-data lvm2

    設置一下docker的yum源,後期在使用的Docker的pull操作都是在此倉庫中下載

     yum-config-manager --add-repo https://download.docker.com/linux/centos/docker-ce.repo

    查看倉庫中所有的docker版本,以便安裝我們需要的Docker版本

    yum list docker-ce --showduplicates | sort -r

    安裝需要的docker版本,此處以Docker17.12.1版本為例

    yum install docker-ce-17.12.1.ce

    成功安裝之後,便可使用docker version/docker -v即可查看所安裝docker的版本

    # docker version
    [root@iZm5eei156c9h3hrdjpe77Z ~]# docker version
    Client:
     Version:    17.12.1-ce
     API version:    1.35
     Go version:    go1.9.4
     Git commit:    7390fc6
     Built:    Tue Feb 27 22:15:20 2018
     OS/Arch:    linux/amd64

    Server:
     Engine:
      Version:    17.12.1-ce
      API version:    1.35 (minimum version 1.12)
      Go version:    go1.9.4
      Git commit:    7390fc6
      Built:    Tue Feb 27 22:17:54 2018
      OS/Arch:    linux/amd64
      Experimental:    false

    # docker -v
    [root@iZm5eei156c9h3hrdjpe77Z ~]# docker -v
    Docker version 17.12.1-ce, build 7390fc6

    之後,我們需要更換docker拉取軟件的服務,這裏使用的是Aliyun鏡像加速器,使用加速器可以提升獲取Docker官方鏡像的速度(一下操作可直接複製執行):

    sudo mkdir -p /etc/docker
    sudo tee /etc/docker/daemon.json <<-'EOF'
    {
      "registry-mirrors": ["https://1ewanek5.mirror.aliyuncs.com"]
    }
    EOF
    sudo systemctl daemon-reload
    sudo systemctl restart docker

    這樣一來,我們便完整的安裝好了Docker。(PS:由於系統環境的問題,在安裝過程中可能需要到其他依賴,只需要根據提示操作即可)

    Docker的Hello world測試

    任何技術的學習,我們都離不開Hello world,Docker也不例外,下面我們來使用Docker來運行一下Hello world吧,在測試之前我們首先使用如下命令來啟動Docker,啟動、重新啟動以及設置開機自啟動:

    # Docker的啟動
    systemctl start docker
    # Docker的重啟
    systemctl restart docker
    # Docker的開機自啟動
    systemctl enable docker     # 一般我們使用開機自啟動的形式

    啟動好Docker之後,我們來在Docker中運行一下hello world:

    # docker 運行hello world
    docker run hello-world

    在我們執行docker run hello-world之後,Docker首先會根據我們的命令查看一下本地是否存在hello-world鏡像,如果存在則會直接運行,如果不存在就會去中央倉庫中拉取(下載)hello-world鏡像(拉取過程極為迅速)之後再來運行。由於我們首次使用Docker,所以執行之後會出現以下結果:

    由於Docker已經幫我們拉取了hello-world鏡像,所以當我們再次運行docker run hello-world之後,則會出現如下結果:

    順便一提,我們在使用Docker拉取所拉取的所有鏡像都來源於Docker的中央倉庫,裏面存放了大量的鏡像可供我們自由使用:https://hub.docker.com/

    三、Docker的常見操作

    啟動docker systemctl start docker,重啟systemctl restart docker,開機docker自啟動systemctl enable docker

    # Docker的啟動
    systemctl start docker
    # Docker的重啟
    systemctl restart docker
    # Docker的開機自啟動
    systemctl enable docker     # 一般我們使用開機自啟動的形式

    鏡像的基本操作

    • 使用search命令來檢索中央倉庫中收錄的鏡像,這裏以tomcat為例
    # 檢索鏡像:docker search [鏡像名稱]
    docker search tomcat

    • 拉取(下載)鏡像:docker pull tomcat(默認最新版本),如果需要其他版本可在中央倉庫中查閱
    # 拉取鏡像:docker pull [鏡像名稱]
    docker pull tomcat
    # 默認拉取的是最新版本,如果需要特定版本,在後面指定即可,以tomcat7.0.1為例
    docker pull tomcat:7.0.1
    • 查看已經下載的本地鏡像:
    # 查看已經下載的本地鏡像
    docker images

    • 刪除本地鏡像
    # 刪除本地鏡像: docker rmi 鏡像名稱/IMAGE ID
    docker rmi tomcat

    容器的基本操作

    • 根據鏡像啟動對應的容器
    # 根據鏡像啟動對應的容器
    docker run -d --name mytomcat tomcat
    # --name 對容器起一個別名
    # -d 對指定的容器進行後台運行
    • 停止運行的容器
    # 停止運行的容器:docker stop 容器名稱/CONTAINER ID
    docker stop mytomcat
    • 查看正在運行的容器
    docker ps       # 查看正在運行的容器
    docker ps -a    # 查看本地所有的容器
    • 刪除容器
    # 注:刪除容器是使用rm,刪除鏡像是rmi,且刪除鏡像之前需要停止運行容器並刪除
    docker rm mytomcat
    • 啟動一個做了端口映射的容器,在之前創建容器之後,我們無法通過ip:端口的形式來訪問Docker中所開啟的服務,因為每一個容器他都是獨立,所以要想訪問,我們則需要通過端口的映射來訪問容器。
    docker run -d --name mytomcat -p 8888:8080 tomcat
    # --name:對容器起一個別名
    # -p:將主機的端口映射到容器的一個端口  主機端口:容器內部的端口 
    # -d:後台運行
    • 查看容器的日誌docker logs mytomcat

    • 容器開機自起動:

    docker update mytomcat --restart=always
    • 進入對應的容器
    docker exec -it mytomcat /bin/bash
    • 本地文件(是centos不是windows)與docker容器中文件之間的互傳,以將ik分詞器插件上傳至elasticsearch容器為例:
    # 先將windows上的文件使用xftp上傳到vmware linux中,然後將文件使用docker命令上傳到docker容器中
    # docker cp 本地路徑 容器名:容器路徑
    docker cp ./elasticsearch-analysis-ik-6.5.4.zip elasticsearch:/usr/share/elasticsearch/plugins
    • 文件的掛載

    Docker容器是獨立,且其相當於是一個及其精簡版的Linux,在我們通過exec命令之後,我們是無法使用vim、vi等命令來對其內部文件進行編輯,在一般情況下我們在創建好容器之後一般會對其配置文件進行編輯,此時我們可以使用Docker中的掛載來將容器內文件掛載到宿主機中。當我們在宿主機中對掛載的文件進行編輯的時候,容器中所被掛載的文件也會做出相應的修改,下面就是docker掛載文件的-v操作(以掛載Es的配置文件和數據文件為例):

    mkdir -p ./resources/elasticsearch/config
    mkdir -p ./resources/elasticsearch/data

    docker run --name elasticsearch -p 9200:9200 \
    -e "discovery.type=single-node" \
    -e ES_JAVA_OPTS="-Xms256m -Xmx256m" \
    -v /resources/elasticsearch/config/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml \
    -v /resources/elasticsearch/data:/usr/share/elasticsearch/data -d elasticsearch:5.6.8

    鏡像、容器的導入和導出

    export:可將docker容器通過export導出為tar文件

    docker export mytomcat > mytomcat.tar

    import:基於tar文件來創建一個新的鏡像

    docker import - mytomcat < mytomcat.tar

    注:以上指示Docker容器中常用的一些命令,對於不同的鏡像的使用,其啟動命令也是會有所區別,後面的一些命令會在使用的時候進行介紹,其他更多Docker操作可參考Docker官方文檔:
    https://docs.docker.com/engine/reference/commandline/docker/

    四、關於DockerFile

    上面我們已經介紹了Docker以及在使用Docker過程中常用的一些命令。而本小結將會介紹Dockerfile,Dockerfile是常用的一種創建鏡像的方式,由file我們也不難知道Dockerfile就是一個Docker文件,可以簡單把它理解成在其內部定義了構建Docker容器的一條條指令,而每一條指令的內容都代表了構建容器的每個流程,Docker通過讀取Dockerfile內的每條指令來構建鏡像。下面我們將會簡單介紹編寫Dockerfile的常用指令及其搭建流程,並最終使用Dockerfile來搭建一個centos鏡像。(PS:本文中的Dockerfile僅僅是簡單介紹,之後Dockerfile的詳細編寫會單獨成文整理)

    Dockerfile官方文檔:https://docs.docker.com/develop/develop-images/dockerfile_best-practices/

    在介紹Dockerfile之前,我們首先通過下面這張圖來直觀的了解下Dockerfile(來源網絡,侵刪。)

    從上圖我們可以大致了解Dockerfile的編寫流程,一個標準的Dockerfile以FROM指令開頭(除註釋之外,註釋通過#進行),一般來說,Dockerfile中的指令主要包括四種類型,該四種類型也就是編寫Dockerfile的一般流程:

    • 指定構建新鏡像的基礎鏡像(父鏡像):FROM
    • 說明所構建鏡像的維護者信息:MAINTAINER(官方已經不贊成使用)、LABEL(建議使用)
    • 對鏡像的操作指令:RUN、ENV、ADD、COPY以及WORKDIR
    • 對容器的啟動指令:CMD、ENTRYPOINT、USER

    下面我們通過Dockerfile的形式來搭建一個nginx容器,並訪問其index.html頁面。

    創建一個工作目錄,用於指定創建新鏡像的所需要的文件(不做要求,但卻是一種創建鏡像的規範)

    mkdir demo_dockerfile
    cd demo_dockerfile
    vim Dockerfile

    編寫Dockerfile文件

    FROM nginx
    LABEL author=taoye email=26647879@qq.com desc="Hello Dockerfile, I am a coder."

    Dockerfile文件寫完之後,我們通過該文件來創建一個新的鏡像,-t參數用於指定創建新鏡像的倉庫和名稱,並設置版本,注意在結尾有.,表示的是指定構建新鏡像過程中的上下文環境的目錄。

    docker build -t demo_nginx/demo_dockerfile:v1.0 .

    執行之後docker build之後便會在本地創建了一個新的鏡像,我們可以通過該鏡像來創建容器並使用curl來進行測試

    docker run --name demo_nginx -d -p 7777:80 demo_nginx/demo_dockerfile:v1.0

    curl localhost:7777

    總結

    本文首先介紹的是對Docker基本認識,其次詳細說明了Docker環境的搭建,之後常見的Docker操作,最後簡單介紹了Dockerfile及通過Dockerfile創建一個簡單nginx容器。在之後文章中會詳細介紹Dockerfile,最好的學習方式莫過於從官方文檔中盡情的無償汲取知識,本文說到底僅僅是在學習Docker官方文檔之後的一個簡單總結,所涉及到的也只是冰山一角。Docker官方文檔中包含了詳細且全面的介紹,涉及到Docker的方方面面,有條件的朋友強烈建議閱讀耐心地閱讀官方文檔:http://docs.docker.com/engine/reference/builder/

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※台北網頁設計公司全省服務真心推薦

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※推薦評價好的iphone維修中心

    ※網頁設計最專業,超強功能平台可客製化

    ※別再煩惱如何寫文案,掌握八大原則!

  • 從消息中間件看分佈式系統的多種套路

    從消息中間件看分佈式系統的多種套路


      消息中間件作為分佈式系統的重要成員,各大公司及開源均有許多解決方案。目前主流的開源解決方案包括RabbitMQ、RocketMQ、Kafka、ActiveMQ等。消息這個東西說簡單也簡單,說難也難。簡單之處在於好用方便,接入簡單使用簡單,異步操作能夠解耦系統間的依賴,同時失敗后也能夠追溯重試。難的地方在於,設計一套可以支撐業務的消息機制,並提供高可用架構,解決消息存儲、消息重試、消息隊列的負載均衡等一系列問題。然而難也不代表沒有方法或者“套路”,熟悉一下原理與實現,多看幾個框架的源碼后多總結勢必能找出一些共性。

      消息框架大同小異,熟練掌握其原理、工作機制是必要的。就拿用的比較多的RocketMQ為引,來說說消息引擎的設計與實現。阿里的消息引擎經過了從Notify到Napoli、再到MetaQ三代的發展,現在已經非常成熟,在不同部門的代碼中現在沒準都還可以從代碼里看到這一系列演進過程。當前的Apache RocketMQ 就是阿里將MetaQ項目捐贈給了Apache基金會,而內部還是沿用MetaQ的名稱。

          首先詮釋幾個消息相關的基本概念。

    • 每個消息隊列都必須建立一個Topic。
    • 消息可以分組,每個消息隊列都至少需要一個生產者Producer和一個消費者Consumer。生產者生產發送消息,消費者接收消費消息。
    • 每個消費者和生產者都會分批提個ID。


    RocketMQ 系統架構


      接下來再來看看RocketMQ的架構,如圖所示,簡要描述一下幾種角色及作用。 

    • NameServer
      • NameServer是消息Topic的註冊中心,用於發現和管理消息生產者、消費者、及路由關係。
    • Broker
      • 消息存儲與轉發的中轉站,使用隊列機制管理數據存儲。Broker中會存儲多份消息數據進行容錯,以Master/Slave的架構保證系統的高可用,Broker中可以部署單個或多個Master。單個Master的場景,Master掛掉后,Producer新產生的消息無法被消費,但已經發送到Broker的消息,由於Slave節點的存在,還能繼續被Consumer所消費;如果部署多個Master則系統能能正常運轉。
      • 另外,Broker中的Master和Slave不是像Zookeeper集群中用選舉機制進行確定,而是固定的配置,這也是在高可用場景需要部署多個Master的原因。
      • 生產者將消息發送到Broker中后,Broker會將消息寫到本地的CommitLog文件中,保存消息。
    • Producer
      • 生產者會和NameServer集群中某一節點建立長鏈接,定時從NamerServeri獲取Topic路由信息,並且和Broker建立心跳。
    • Consumer
      • 消費者需要給生產者一個明確的消費成功的回應,MetaQ才會認為消費成功,否則失敗。失敗后,RocketMQ會將消息重新發回Broker,在指定的延遲時間內進行重試,當重試達到一定的次數后(默認16次),MetaQ則認為此消息不能被消費,消息會被投遞到死信隊列。


      這個架構看其實是否很熟悉?好像接觸過的一些分佈式系統的架構和這個長的都比較像是吧,甚至只要裏面框圖的角色稍微換換就能變成另外一個框架的介紹,比如Dubbo/Redis…。

    並且在RocketMQ架構設計中,要解決的問題與其他分佈式框架也可以觸類旁通。Master/Slave機制,天然的讀寫分離方式都是分佈式高可用系統的典型解決方案。

    負載均衡

      負載均衡是消息框架需要解決的又一個重要問題。當系統中生產者生產了大量消息,而消費者有多個或多台機器時,就需要平衡負載,讓消息均分地被消費者進行消費。目前RocketMQ中使用了多種負載均衡算法。主要有以下幾種,靜態配置由於過於簡單,直接為消費者配置需要消費的隊列,因此直接忽略。

    1. 求平均數法
    2. 環形隊列法
    3. 一致Hash算法
    4. Machine Room算法
    5. 靜態配置

      來看一下源碼,RocketMQ內部對以上負載均衡算法均有實現,並定義了一個接口 AllocateMessageQueueStrategy,採用策略模式,每種負載均衡算法都依靠實現這個接口實現,在運行中,會獲取這個接口的實例,從而動態判斷到底採用的是哪種負載均衡算法。

     1 public interface AllocateMessageQueueStrategy {
     2 
     3     /**
     4      * Allocating by consumer id
     5      *
     6      * @param consumerGroup current consumer group
     7      * @param currentCID current consumer id
     8      * @param mqAll message queue set in current topic
     9      * @param cidAll consumer set in current consumer group
    10      * @return The allocate result of given strategy
    11      */
    12     List<MessageQueue> allocate(
    13         final String consumerGroup,
    14         final String currentCID,
    15         final List<MessageQueue> mqAll,
    16         final List<String> cidAll
    17     );
    18 
    19     /**
    20      * Algorithm name
    21      *
    22      * @return The strategy name
    23      */
    24     String getName();
    25 }


    1. 求平均數法

      顧名思義,就是根據消息隊列的數量和消費者的數量,求出單個消費者上應該負擔的平均消費隊列數,然後根據消費者的ID,按照取模的方式將消息隊列分配到指定的consumer上。具體代碼可以去Github上找,截取核心算法代碼如下, mqAll就是消息隊列的結構,是一個MessageQueue的List,cidAll是消費者ID的列表,也是一個List。考慮mqAll和cidAll固定時以及變化時,當前消費者節點會從隊列中獲取到哪個隊列中的消息,比如當 averageSize 大於1時,這時每個消費者上的消息隊列就不止一個,而分配在每個消費者的上的隊列的ID是連續的。


     1     int index = cidAll.indexOf(currentCID);
     2         int mod = mqAll.size() % cidAll.size();
     3         int averageSize =
     4             mqAll.size() <= cidAll.size() ? 1 : (mod > 0 && index < mod ? mqAll.size() / cidAll.size()
     5                 + 1 : mqAll.size() / cidAll.size());
     6         int startIndex = (mod > 0 && index < mod) ? index * averageSize : index * averageSize + mod;
     7         int range = Math.min(averageSize, mqAll.size() - startIndex);
     8         for (int i = 0; i < range; i++) {
     9             result.add(mqAll.get((startIndex + i) % mqAll.size()));
    10         }
    11         return result;


    2. 環形平均法

      這種算法更為簡單。首先獲取當前消費者在整個列表中的下標index,直接用求余方法得到當前消費者應該處理的消息隊列。注意mqAll的size和cidAll的size可以是任意的。

    • 當ciAll.size() == mqAll.size() 時,該算法就是類似hashtable的求余分桶。
    • 當ciAll.size() > mqAll.size() 時,那麼多出的消費者上並不能獲取到消費的隊列,只有部分消費者能夠獲取到消息隊列並執行,相當於在消費者資源充足的情況下,由於隊列數少,所以使用其中一部分消費者就能滿足需求,不用額外的開銷。
    • 當ciAll.size() < mqAll.size() 時,這樣每個消費者上需要負載的隊列數就超過了1個,並且區別於直接求平均的方式,分配在每個消費者上的消費隊列不是連續的,而是有一定步長的間隔。
    1         int index = cidAll.indexOf(currentCID);
    2         for (int i = index; i < mqAll.size(); i++) {
    3             if (i % cidAll.size() == index) {
    4                 result.add(mqAll.get(i));
    5             }
    6         }
    7         return result;


    3. 一致Hash算法

      循環所有需要消費的隊列,根據隊列toString后的hash值計算出處理當前隊列的最近節點並分配給該節點。routeNode 中方法稍微複雜一些,有時間建議細看,這裏就只說功能。

     1      Collection<ClientNode> cidNodes = new ArrayList<ClientNode>();
     2         for (String cid : cidAll) {
     3             cidNodes.add(new ClientNode(cid));
     4         }
     5 
     6         final ConsistentHashRouter<ClientNode> router; //for building hash ring
     7         if (customHashFunction != null) {
     8             router = new ConsistentHashRouter<ClientNode>(cidNodes, virtualNodeCnt, customHashFunction);
     9         } else {
    10             router = new ConsistentHashRouter<ClientNode>(cidNodes, virtualNodeCnt);
    11         }
    12 
    13         List<MessageQueue> results = new ArrayList<MessageQueue>();
    14         for (MessageQueue mq : mqAll) {
    15             ClientNode clientNode = router.routeNode(mq.toString());
    16             if (clientNode != null && currentCID.equals(clientNode.getKey())) {
    17                 results.add(mq);
    18             }
    19         }
    20 
    21         return results;


    4. Machine Room算法

      基於機房的Hash算法。這個命名看起來很詐唬,其實和上面的普通求余算法是一樣的,只不過多了個配置和過濾,為了把這個說清楚就把源碼貼全一點。可以看到在這個算法的實現類中多了一個成員 consumeridcs,這個就是consumer id的一個集合,按照一定的約定,預先給broker命名,例如us@metaq4,然後給不同集群配置不同的consumeridcs,從而實現不同機房處理不同消息隊列的能力。

     1 /*
     2  * Licensed to the Apache Software Foundation (ASF) under one or more
     3  * contributor license agreements.  See the NOTICE file distributed with
     4  * this work for additional information regarding copyright ownership.
     5  * The ASF licenses this file to You under the Apache License, Version 2.0
     6  * (the "License"); you may not use this file except in compliance with
     7  * the License.  You may obtain a copy of the License at
     8  *
     9  *     http://www.apache.org/licenses/LICENSE-2.0
    10  *
    11  * Unless required by applicable law or agreed to in writing, software
    12  * distributed under the License is distributed on an "AS IS" BASIS,
    13  * WITHOUT WARRANTIES OR CONDITIONS OF ANY KIND, either express or implied.
    14  * See the License for the specific language governing permissions and
    15  * limitations under the License.
    16  */
    17 package com.aliyun.openservices.shade.com.alibaba.rocketmq.client.consumer.rebalance;
    18 
    19 import java.util.ArrayList;
    20 import java.util.List;
    21 import java.util.Set;
    22 import com.aliyun.openservices.shade.com.alibaba.rocketmq.client.consumer.AllocateMessageQueueStrategy;
    23 import com.aliyun.openservices.shade.com.alibaba.rocketmq.common.message.MessageQueue;
    24 
    25 /**
    26  * Computer room Hashing queue algorithm, such as Alipay logic room
    27  */
    28 public class AllocateMessageQueueByMachineRoom implements AllocateMessageQueueStrategy {
    29     private Set<String> consumeridcs;
    30 
    31     @Override
    32     public List<MessageQueue> allocate(String consumerGroup, String currentCID, List<MessageQueue> mqAll,
    33         List<String> cidAll) {
    34         List<MessageQueue> result = new ArrayList<MessageQueue>();
    35         int currentIndex = cidAll.indexOf(currentCID);
    36         if (currentIndex < 0) {
    37             return result;
    38         }
    39         List<MessageQueue> premqAll = new ArrayList<MessageQueue>();
    40         for (MessageQueue mq : mqAll) {
    41             String[] temp = mq.getBrokerName().split("@");
    42             if (temp.length == 2 && consumeridcs.contains(temp[0])) {
    43                 premqAll.add(mq);
    44             }
    45         }
    46 
    47         int mod = premqAll.size() / cidAll.size();
    48         int rem = premqAll.size() % cidAll.size();
    49         int startIndex = mod * currentIndex;
    50         int endIndex = startIndex + mod;
    51         for (int i = startIndex; i < endIndex; i++) {
    52             result.add(mqAll.get(i));
    53         }
    54         if (rem > currentIndex) {
    55             result.add(premqAll.get(currentIndex + mod * cidAll.size()));
    56         }
    57         return result;
    58     }
    59 
    60     @Override
    61     public String getName() {
    62         return "MACHINE_ROOM";
    63     }
    64 
    65     public Set<String> getConsumeridcs() {
    66         return consumeridcs;
    67     }
    68 
    69     public void setConsumeridcs(Set<String> consumeridcs) {
    70         this.consumeridcs = consumeridcs;
    71     }
    72 }


      由於近些年阿裏海外業務的擴展和投入,RocketMQ 等中間件對常見的海外業務場景的支持也更加健全。典型的場景包括跨單元消費以及消息路由。跨單元消費是比較好實現的,就是在consumer中增加一個配置,指定接收消息的來源單元,RocketMQ內部會完成客戶端從指定單元拉取消息的工作。而全球消息路由則是需要一些公共資源,消息的發送方只能將消息發送到一個指定單元/機房,然後將消息路由到另外指定的單元,consumer部署在指定單元。區別在於一個配置在客戶端,一個配置在服務端。


    總結

    從RocketMQ的設計、原理以及用過的個人用過的其他分佈式框架上看,典型的分佈式系統在設計中無外乎要解決的就是以下幾點,RocketMQ全都用上了。

    • 服務的註冊和發現。一般會有一個統一的註冊中心進行管理維護。
    • 服務的提供方和使用方間的通信,可以是異步也可以是同步,例如dubbo服務同步服務,而消息類型就是異步通信。
    • HA——高可用架構。八字決 ———— “主從同步,讀寫分離”。 要再加一句的話可以是“異地多活”。
    • 負載均衡。典型的負載均衡算法在文章內容裏面已經列出好幾種了,常用的基本也就這些。

    當然消息框架設計中用到的套路遠不止這些,包括如何保證消息消費的順序性、消費者和服務端通信、以及消息持久化等問題也是難點和重點,同樣,分佈式緩存系統也需要解決這些問題,先寫到這裏,要完全理解並自己設計一個這樣的框架難度還是相當大的。


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※台北網頁設計公司這麼多該如何選擇?

    ※智慧手機時代的來臨,RWD網頁設計為架站首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※回頭車貨運收費標準

    ※網頁設計最專業,超強功能平台可客製化

    ※別再煩惱如何寫文案,掌握八大原則!

  • SaaS權限設計總結

    SaaS權限設計總結

    2年前轉到SaaS部門之後期間斷斷續續做着權限相關的業務,這篇文章主要回顧下過往的設計以及其原因和利弊。
    不過因為是線上業務,會省略掉很多細節以及賬號體系和權益相關得部分,只討論權限相關。
    本文也不會涉及到技術層面的實現僅討論設計。

    原初的混沌

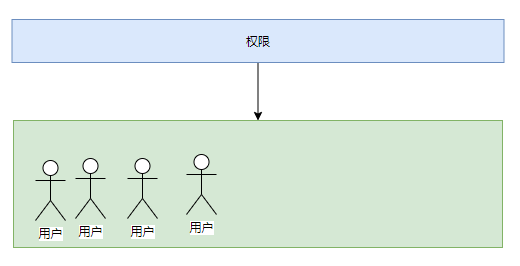
    SaaS和一些內部系統/2C業務的權限最大不同點是他是天然多租戶的。
    用戶之上會有一層組織(Organization)的概念,組織只擁有所有權限的子集(取決於組織購買的服務),並且組織可以自行管理部分權限。
    省略了部門,群組等等概念的簡化圖:

    增加了組織概念:

    剛接手的這塊的時候發現因為歷史原因設計得比較粗糙。
    整個權限系統只有兩個表:權限定義 和 組織權限關係。

    默認情況下組織內的所有用戶都能獲得分配給組織的權限,需要區分對待管理員和用戶的權限都是在代碼中進行硬編碼,手動去除對應權限。

    當時的功能:

    • 組織權限分配 – ACL
    • 組織內用戶權限分配 – 硬編碼

    這個模型嚴重限制了售賣策略和商家的靈活度,在系統中存在大量的硬編碼為了某個業務去修改權限的關係。
    後續在這一版上勉強引入了組織內角色分配的功能,但因為業務設計過於簡單,沒法支撐後續的操作,最後決定重構。

    業務場景驅動

    這中間經歷了兩次模型的調整和服務的變更。
    第一次想做和業務無關之後其他業務可復用的模型,基於RBAC構造了角色,角色”用戶”關係,角色權限關係;為了覆蓋ACL場景構建了”用戶”權限關係;為了多個業務方接入定義了domain,並且權限,”用戶”的定義和角色都和domain掛鈎。
    對外提供的RBAC接口本質上是ACL,”用戶”分配角色,角色內權限變更會引起”用戶”和權限關係的變化。
    至於為什麼要這麼設計,因為考慮到了一個分配角色后能手工修改用戶權限的場景,初步評估這個場景是有必要的。
    為了保證”用戶”分配了多個角色后,如果存在同樣的權限點不會因為之後取消某個角色被全部取消了引入了refCount。

    此時就存在了一個可以直接使用的ACL(obj_access_relation)和外觀看上去是RBAC(但其本質還是ACL)的基礎設施。

    設置了兩個domain,針對組織依舊使用ACL,針對組織內的分配場景使用RBAC。

    增加權限定義概念

    在這之前要說明的是在設計時,組織中存在了一個管理員的概念,他不是某個角色,而是類似於組織creator的概念,其權限等同於組織的權限並且僅有一個,他的定義是為了簡化組織的管理,作為了這個組織的用戶層面映射。

    權限定義這一概念的引入是為了應對組織內分配關係。
    因為現在存在了組織和用戶兩個維度,分配關係最簡單的場景下會有幾種:

    1. 權限用於售賣,組織需要分配,用戶需要分配;
    2. 權限用於售賣,組織需要分配,用戶自動獲得;
    3. 權限用於售賣,組織需要分配,用戶不能獲得;(僅管理員使用)
    4. 權限用於管理用戶,組織自動獲得,用戶需要分配;
    5. 權限用於管理用戶,組織自動獲得,用戶自動獲得。(這個場景就不要用權限了)
    6. 權限用於管理用戶,組織自動獲得,用戶不能獲得;(僅管理員使用)
      對於權限組織

    權限定義內有兩個維度: 組織分配關係(默認獲得,需要分配),用戶分配關係(默認獲得組織的,需要分配,無法獲得)

    經過實踐這一套不是特別方便:

    1. 不同domain需要定義不同的權限,但這個場景兩個domain下的權限其實是一致的;
    2. 過於業務獨立,一些業務場景自定義的東西難以插入其中,比如業務額外定義的權限定義表。

    後續為了更好支持SaaS的權限系統把這套基礎設施複製到了SaaS權限內,這套基礎設施依舊留着給其他業務發光發熱。

    到這一步的權限系統有如下幾個特性:

    1. 組織權限可通過權限定義和分配獲得,組織下存在一個管理者其權限等同於組織權限;
    2. 組織內用戶權限通過權限定義和角色分配獲得,並且約束用戶權限不能大於組織(防止組織的某個權限過期后其用戶還能繼續使用);
    3. 存在系統預設的系統角色,出現條件為組織存在其角色依賴的權限;
    4. 組織可對其擁有的且定義為用戶可分配的權限組裝自定義角色分配給用戶。

    針對用戶的高級功能。

    上述特性中有提到用戶權限不能大於組織,這其實僅僅是針對組織域。
    如果針對用戶層面販賣高級功能,就不能被這一層限制。
    於是又引入了另一個域,其和組織域是正交的,雙方不存在邏輯層面上的關係。
    也就是 管理員通過VIP獲得的權限不會影響到組織權限,用戶通過VIP獲得的權限不受到組織權限約束。

    更多KA定製場景

    做SaaS有一點比較困難的是KA需求,作為最重要的一批客戶,提供了大量現金流。KA的定製需求不能被忽略。
    在迭代中增加了不少定製場景並泛化使用。
    比如:

    • 組織層面的權限定義,為了應對客戶嫌角色分配麻煩,可以組織內開關某個權限;
    • VIP繼承組織權限設計,為了應對客戶在大量購買某VIP分配之後不想重複分配角色;
    • 權限自動賦予某些部門下用戶

    等等

    這些問題的共同點就是分配行為的繁瑣。
    之前引入的權限定義本身就是在組織分配層面解決這個問題,有了一些ABAC的特徵。
    在這些KA需求的迭代中也增加了更多subject attribute,例如組織ID,VIP類型,以及之後的更多拓展。

    基於分配給用戶和解耦用戶直接分配的ACL和RBAC模型在這些領域都不能很好發揮,因為他們的作用前提是發生了分配關係,為了滿足更多的KA場景以及系統本身迭代會引入更多的ABAC元素。

    之後的規劃

    現在線上運行的這一套系統已經和整個商業鏈路打通,客戶的服務購買/續期/增購會有一部分反應到權限系統中,新的功能需要商業化也都會統一接入其中,權限也從最開始的百來個發展到近千個。

    但當前系統的不足也很明顯,整套體系的架構比較雜亂。

    • 最開始做的偽RBAC那一套最後實踐沒有對應的場景,而且容易發生不一致的問題,需要在系統層面移除掉(但ACL本身保留);
    • ABAC實現零散且混亂,這一套要需要體系化重寫;
    • 系統需要泛化到2C場景,打通2B和2C的商業化鏈路;
    • 缺失了數據權限控制(object),但這一套應該不會和當前權限這一套做在一起,兩者的業務對象相差有點多(一個是組織用戶和功能,一個是用戶和各類數據)。

    Written with StackEdit.

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計最專業,超強功能平台可客製化

    ※回頭車貨運收費標準

  • 【Spring註解驅動開發】組件註冊-@ComponentScan-自動掃描組件&指定掃描規則

    寫在前面

    在實際項目中,我們更多的是使用Spring的包掃描功能對項目中的包進行掃描,凡是在指定的包或子包中的類上標註了@Repository、@Service、@Controller、@Component註解的類都會被掃描到,並將這個類注入到Spring容器中。Spring包掃描功能可以使用XML文件進行配置,也可以直接使用@ComponentScan註解進行設置,使用@ComponentScan註解進行設置比使用XML文件配置要簡單的多。

    項目工程源碼已經提交到GitHub:https://github.com/sunshinelyz/spring-annotation

    使用XML文件配置包掃描

    我們可以在Spring的XML配置文件中配置包的掃描,在配置包掃描時,需要在Spring的XML文件中的beans節點中引入context標籤,如下所示。

    <beans xmlns="http://www.springframework.org/schema/beans"
           xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
           xmlns:context="http://www.springframework.org/schema/context"
           xsi:schemaLocation="http://www.springframework.org/schema/beans
                               http://www.springframework.org/schema/beans/spring-beans.xsd
                               http://www.springframework.org/schema/context
                               http://www.springframework.org/context/spring-context.xsd ">
    

    接下來,我們就可以在XML文件中定義要掃描的包了,如下所示。

    <context:component-scan base-package="io.mykit.spring"/>
    

    整個beans.xml文件如下所示。

    <?xml version="1.0" encoding="UTF-8"?>
    <beans xmlns="http://www.springframework.org/schema/beans"
           xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
           xmlns:context="http://www.springframework.org/schema/context"
           xsi:schemaLocation="http://www.springframework.org/schema/beans
           http://www.springframework.org/schema/beans/spring-beans.xsd
           http://www.springframework.org/schema/context
           http://www.springframework.org/schema/context.xsd">
    
        <context:component-scan base-package="io.mykit.spring"/>
    
        <bean id = "person" class="io.mykit.spring.bean.Person">
            <property name="name" value="binghe"></property>
            <property name="age" value="18"></property>
        </bean>
    </beans>
    

    此時,只要在io.mykit.spring包下,或者io.mykit.spring的子包下標註了@Repository、@Service、@Controller、@Component註解的類都會被掃描到,並自動注入到Spring容器中。

    此時,我們分別創建PersonDao、PersonService、和PersonController類,並在這三個類中分別添加@Repository、@Service、@Controller註解,如下所示。

    • PersonDao
    package io.mykit.spring.plugins.register.dao;
    
    import org.springframework.stereotype.Repository;
    
    /**
     * @author binghe
     * @version 1.0.0
     * @description 測試的dao
     */
    @Repository
    public class PersonDao {
    }
    
    • PersonService
    package io.mykit.spring.plugins.register.service;
    
    import org.springframework.stereotype.Service;
    
    /**
     * @author binghe
     * @version 1.0.0
     * @description 測試的Service
     */
    @Service
    public class PersonService {
    }
    
    • PersonController
    package io.mykit.spring.plugins.register.controller;
    
    import org.springframework.stereotype.Controller;
    
    /**
     * @author binghe
     * @version 1.0.0
     * @description 測試的controller
     */
    @Controller
    public class PersonController {
    }
    

    接下來,我們在SpringBeanTest類中新建一個測試方法testComponentScanByXml()進行測試,如下所示。

    @Test
    public void testComponentScanByXml(){
        ApplicationContext context = new ClassPathXmlApplicationContext("beans.xml");
        String[] names = context.getBeanDefinitionNames();
        Arrays.stream(names).forEach(System.out::println);
    }
    

    運行測試用例,輸出的結果信息如下所示。

    personConfig
    personController
    personDao
    personService
    org.springframework.context.annotation.internalConfigurationAnnotationProcessor
    org.springframework.context.annotation.internalAutowiredAnnotationProcessor
    org.springframework.context.annotation.internalCommonAnnotationProcessor
    org.springframework.context.event.internalEventListenerProcessor
    org.springframework.context.event.internalEventListenerFactory
    person
    

    可以看到,除了輸出我們自己創建的bean名稱之外,也輸出了Spring內部使用的一些重要的bean名稱。

    接下來,我們使用註解來完成這些功能。

    使用註解配置包掃描

    使用@ComponentScan註解之前我們先將beans.xml文件中的下述配置註釋。

    <context:component-scan base-package="io.mykit.spring"></context:component-scan>
    

    註釋后如下所示。

    <!--<context:component-scan base-package="io.mykit.spring"></context:component-scan>-->
    

    使用@ComponentScan註解配置包掃描就非常Easy了!在我們的PersonConfig類上添加@ComponentScan註解,並將掃描的包指定為io.mykit.spring即可,整個的PersonConfig類如下所示。

    package io.mykit.spring.plugins.register.config;
    
    import io.mykit.spring.bean.Person;
    import org.springframework.context.annotation.Bean;
    import org.springframework.context.annotation.ComponentScan;
    import org.springframework.context.annotation.Configuration;
    
    /**
     * @author binghe
     * @version 1.0.0
     * @description 以註解的形式來配置Person
     */
    @Configuration
    @ComponentScan(value = "io.mykit.spring")
    public class PersonConfig {
    
        @Bean("person")
        public Person person01(){
            return new Person("binghe001", 18);
        }
    }
    

    沒錯,就是這麼簡單,只需要在類上添加@ComponentScan(value = “io.mykit.spring”)註解即可。

    接下來,我們在SpringBeanTest類中新增testComponentScanByAnnotation()方法,如下所示。

    @Test
    public void testComponentScanByAnnotation(){
        ApplicationContext context = new AnnotationConfigApplicationContext(PersonConfig.class);
        String[] names = context.getBeanDefinitionNames();
        Arrays.stream(names).forEach(System.out::println);
    }
    

    運行testComponentScanByAnnotation()方法輸出的結果信息如下所示。

    org.springframework.context.annotation.internalConfigurationAnnotationProcessor
    org.springframework.context.annotation.internalAutowiredAnnotationProcessor
    org.springframework.context.annotation.internalCommonAnnotationProcessor
    org.springframework.context.event.internalEventListenerProcessor
    org.springframework.context.event.internalEventListenerFactory
    personConfig
    personController
    personDao
    personService
    person
    

    可以看到使用@ComponentScan註解同樣輸出了bean的名稱。

    既然使用XML文件和註解的方式都能夠將相應的類注入到Spring容器當中,那我們是使用XML文件還是使用註解呢?我更傾向於使用註解,如果你確實喜歡使用XML文件進行配置,也可以,哈哈,個人喜好嘛!好了,我們繼續。

    關於@ComponentScan註解

    我們點開ComponentScan註解類,如下所示。

    package org.springframework.context.annotation;
    
    import java.lang.annotation.Documented;
    import java.lang.annotation.ElementType;
    import java.lang.annotation.Repeatable;
    import java.lang.annotation.Retention;
    import java.lang.annotation.RetentionPolicy;
    import java.lang.annotation.Target;
    
    import org.springframework.beans.factory.support.BeanNameGenerator;
    import org.springframework.core.annotation.AliasFor;
    import org.springframework.core.type.filter.TypeFilter;
    
    @Retention(RetentionPolicy.RUNTIME)
    @Target(ElementType.TYPE)
    @Documented
    @Repeatable(ComponentScans.class)
    public @interface ComponentScan {
    
    	@AliasFor("basePackages")
    	String[] value() default {};
    
    	@AliasFor("value")
    	String[] basePackages() default {};
    
    	Class<?>[] basePackageClasses() default {};
    
    	Class<? extends BeanNameGenerator> nameGenerator() default BeanNameGenerator.class;
    
    	Class<? extends ScopeMetadataResolver> scopeResolver() default AnnotationScopeMetadataResolver.class;
    
    	ScopedProxyMode scopedProxy() default ScopedProxyMode.DEFAULT;
    
    	String resourcePattern() default ClassPathScanningCandidateComponentProvider.DEFAULT_RESOURCE_PATTERN;
    
    	boolean useDefaultFilters() default true;
    
    	Filter[] includeFilters() default {};
    
    	Filter[] excludeFilters() default {};
    
    	boolean lazyInit() default false;
    
    	@Retention(RetentionPolicy.RUNTIME)
    	@Target({})
    	@interface Filter {
    		FilterType type() default FilterType.ANNOTATION;
            
    		@AliasFor("classes")
    		Class<?>[] value() default {};
            
    		@AliasFor("value")
    		Class<?>[] classes() default {};
            
    		String[] pattern() default {};
    	}
    }
    

    這裏,我們着重來看ComponentScan類的兩個方法,如下所示。

    Filter[] includeFilters() default {};
    Filter[] excludeFilters() default {};
    

    includeFilters()方法表示Spring掃描的時候,只包含哪些註解,而excludeFilters()方法表示不包含哪些註解。兩個方法的返回值都是Filter[]數組,在ComponentScan註解類的內部存在Filter註解類,大家可以看下上面的代碼。

    1.掃描時排除註解標註的類

    例如,我們現在排除@Controller、@Service和@Repository註解,我們可以在PersonConfig類上通過@ComponentScan註解的excludeFilters()實現。例如,我們在PersonConfig類上添加了如下的註解。

    @ComponentScan(value = "io.mykit.spring", excludeFilters = {
            @Filter(type = FilterType.ANNOTATION, classes = {Controller.class, Service.class, Repository.class})
    })
    

    這樣,我們就使得Spring在掃描包的時候排除了使用@Controller、@Service和@Repository註解標註的類。運行SpringBeanTest類中的testComponentScanByAnnotation()方法,輸出的結果信息如下所示。

    org.springframework.context.annotation.internalConfigurationAnnotationProcessor
    org.springframework.context.annotation.internalAutowiredAnnotationProcessor
    org.springframework.context.annotation.internalCommonAnnotationProcessor
    org.springframework.context.event.internalEventListenerProcessor
    org.springframework.context.event.internalEventListenerFactory
    personConfig
    person
    

    可以看到,輸出的結果信息中不再輸出personController、personService和personDao說明Spring在進行包掃描時,忽略了@Controller、@Service和@Repository註解標註的類。

    2.掃描時只包含註解標註的類

    我們也可以使用ComponentScan註解類的includeFilters()來指定Spring在進行包掃描時,只包含哪些註解標註的類。

    這裏需要注意的是,當我們使用includeFilters()來指定只包含哪些註解標註的類時,需要禁用默認的過濾規則。

    例如,我們需要Spring在掃描時,只包含@Controller註解標註的類,可以在PersonConfig類上添加@ComponentScan註解,設置只包含@Controller註解標註的類,並禁用默認的過濾規則,如下所示。

    @ComponentScan(value = "io.mykit.spring", includeFilters = {
            @Filter(type = FilterType.ANNOTATION, classes = {Controller.class})
    }, useDefaultFilters = false)
    

    此時,我們再次運行SpringBeanTest類的testComponentScanByAnnotation()方法,輸出的結果信息如下所示。

    org.springframework.context.annotation.internalConfigurationAnnotationProcessor
    org.springframework.context.annotation.internalAutowiredAnnotationProcessor
    org.springframework.context.annotation.internalCommonAnnotationProcessor
    org.springframework.context.event.internalEventListenerProcessor
    org.springframework.context.event.internalEventListenerFactory
    personConfig
    personController
    person
    

    可以看到,在輸出的結果中,只包含了@Controller註解標註的組件名稱,並沒有輸出@Service和@Repository註解標註的組件名稱。

    注意:在使用includeFilters()來指定只包含哪些註解標註的類時,結果信息中會一同輸出Spring內部的組件名稱。

    3.重複註解

    不知道小夥伴們有沒有注意到ComponentScan註解類上有一個如下所示的註解。

    @Repeatable(ComponentScans.class)
    

    我們先來看看@ComponentScans註解是個啥,如下所示。

    package org.springframework.context.annotation;
    
    import java.lang.annotation.Documented;
    import java.lang.annotation.ElementType;
    import java.lang.annotation.Retention;
    import java.lang.annotation.RetentionPolicy;
    import java.lang.annotation.Target;
    @Retention(RetentionPolicy.RUNTIME)
    @Target(ElementType.TYPE)
    @Documented
    public @interface ComponentScans {
    	ComponentScan[] value();
    }
    

    可以看到,在ComponentScans註解類中只聲明了一個返回ComponentScan[]數組的value(),說到這裏,大家是不是就明白了,沒錯,這在Java8中是一個重複註解。

    對於Java8不熟悉的小夥伴,可以到【Java8新特性】專欄查看關於Java8新特性的文章。專欄地址小夥伴們可以猛戳下面的鏈接地址進行查看:

    https://mp.weixin.qq.com/mp/appmsgalbum?action=getalbum&__biz=Mzg3MzE1NTIzNA==&scene=1&album_id=1325066823947321344#wechat_redirect

    在Java8中表示@ComponentScan註解是一個重複註解,可以在一個類上重複使用這個註解,如下所示。

    @Configuration
    @ComponentScan(value = "io.mykit.spring", includeFilters = {
            @Filter(type = FilterType.ANNOTATION, classes = {Controller.class})
    }, useDefaultFilters = false)
    @ComponentScan(value = "io.mykit.spring", includeFilters = {
            @Filter(type = FilterType.ANNOTATION, classes = {Service.class})
    }, useDefaultFilters = false)
    public class PersonConfig {
    
        @Bean("person")
        public Person person01(){
            return new Person("binghe001", 18);
        }
    }
    

    運行SpringBeanTest類的testComponentScanByAnnotation()方法,輸出的結果信息如下所示。

    org.springframework.context.annotation.internalConfigurationAnnotationProcessor
    org.springframework.context.annotation.internalAutowiredAnnotationProcessor
    org.springframework.context.annotation.internalCommonAnnotationProcessor
    org.springframework.context.event.internalEventListenerProcessor
    org.springframework.context.event.internalEventListenerFactory
    personConfig
    personController
    personService
    person
    

    可以看到,同時輸出了@Controller註解和@Service註解標註的組件名稱。

    如果使用的是Java8之前的版本,我們就不能直接在類上寫多個@ComponentScan註解了。此時,我們可以在PersonConfig類上使用@ComponentScans註解,如下所示。

    @ComponentScans(value = {
            @ComponentScan(value = "io.mykit.spring", includeFilters = {
                    @Filter(type = FilterType.ANNOTATION, classes = {Controller.class})
            }, useDefaultFilters = false),
            @ComponentScan(value = "io.mykit.spring", includeFilters = {
                    @Filter(type = FilterType.ANNOTATION, classes = {Service.class})
            }, useDefaultFilters = false)
    })
    

    再次運行SpringBeanTest類的testComponentScanByAnnotation()方法,輸出的結果信息如下所示。

    org.springframework.context.annotation.internalConfigurationAnnotationProcessor
    org.springframework.context.annotation.internalAutowiredAnnotationProcessor
    org.springframework.context.annotation.internalCommonAnnotationProcessor
    org.springframework.context.event.internalEventListenerProcessor
    org.springframework.context.event.internalEventListenerFactory
    personConfig
    personController
    personService
    person
    

    與使用多個@ComponentScan註解輸出的結果信息相同。

    總結:我們可以使用@ComponentScan註解來指定Spring掃描哪些包,可以使用excludeFilters()指定掃描時排除哪些組件,也可以使用includeFilters()指定掃描時只包含哪些組件。當使用includeFilters()指定只包含哪些組件時,需要禁用默認的過濾規則

    好了,咱們今天就聊到這兒吧!別忘了給個在看和轉發,讓更多的人看到,一起學習一起進步!!

    項目工程源碼已經提交到GitHub:https://github.com/sunshinelyz/spring-annotation

    寫在最後

    如果覺得文章對你有點幫助,請微信搜索並關注「 冰河技術 」微信公眾號,跟冰河學習Spring註解驅動開發。公眾號回復“spring註解”關鍵字,領取Spring註解驅動開發核心知識圖,讓Spring註解驅動開發不再迷茫。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

    ※教你寫出一流的銷售文案?

    ※回頭車貨運收費標準

    ※別再煩惱如何寫文案,掌握八大原則!

  • 天哪!手動編寫mybatis雛形竟然這麼簡單

    天哪!手動編寫mybatis雛形竟然這麼簡單

    前言

    mybaits 在ORM 框架中,可算是半壁江山了,由於它是輕量級,半自動加載,靈活性和易拓展性。深受廣大公司的喜愛,所以我們程序開發也離不開mybatis 。但是我們有對mabtis 源碼進行研究嗎?或者想看但是不知道怎麼看的苦惱嗎?

    歸根結底,我們還是需要知道為什麼會有mybatis ,mybatis 解決了什麼問題?
    想要知道mybatis 解決了什麼問題,就要知道傳統的JDBC 操作存在哪些痛點才促使mybatis 的誕生。
    我們帶着這些疑問,再來一步步學習吧。

    原始JDBC 存在的問題

    所以我們先來來看下原始JDBC 的操作:
    我們知道最原始的數據庫操作。分為以下幾步:
    1、獲取connection 連接
    2、獲取preparedStatement
    3、參數替代佔位符
    4、獲取執行結果resultSet
    5、解析封裝resultSet 到對象中返回。

    如下是原始JDBC 的查詢代碼,存在哪些問題?

    public static void main(String[] args) {
            String dirver="com.mysql.jdbc.Driver";
            String url="jdbc:mysql://localhost:3306/mybatis?characterEncoding=utf-8";
            String userName="root";
            String password="123456";
    
            Connection connection=null;
            List<User> userList=new ArrayList<>();
            try {
                Class.forName(dirver);
                connection= DriverManager.getConnection(url,userName,password);
    
                String sql="select * from user where username=?";
                PreparedStatement preparedStatement=connection.prepareStatement(sql);
                preparedStatement.setString(1,"張三");
                System.out.println(sql);
                ResultSet resultSet=preparedStatement.executeQuery();
    
                User user=null;
                while(resultSet.next()){
                    user=new User();
                    user.setId(resultSet.getInt("id"));
                    user.setUsername(resultSet.getString("username"));
                    user.setPassword(resultSet.getString("password"));
                    userList.add(user);
                }
            } catch (Exception e) {
                e.printStackTrace();
            }finally {
                try {
                    connection.close();
                } catch (SQLException e) {
                    e.printStackTrace();
                }
            }
    
            if (!userList.isEmpty()) {
                for (User user : userList) {
                    System.out.println(user.toString());
                }
            }
    
        }
    

    小夥伴們發現了上面有哪些不友好的地方?
    我這裏總結了以下幾點:
    1、數據庫的連接信息存在硬編碼,即是寫死在代碼中的。
    2、每次操作都會建立和釋放connection 連接,操作資源的不必要的浪費。
    3、sql 和參數存在硬編碼。
    4、將返回結果集封裝成實體類麻煩,要創建不同的實體類,並通過set方法一個個的注入。

    存在上面的問題,所以mybatis 就對上述問題進行了改進。
    對於硬編碼,我們很容易就想到配置文件來解決。mybatis 也是這麼解決的。
    對於資源浪費,我們想到是用連接池,mybatis 也是這個解決的。
    對於封裝結果集麻煩,我們想到是用JDK的反射機制,好巧,mybatis 也是這麼解決的。

    設計思路

    既然如此,我們就來寫一個自定義吃持久層框架,來解決上述問題,當然是參照mybatis 的設計思路,這樣我們在寫完之後,再來看mybatis 的源碼就恍然大悟,這個地方這樣配置原來是因為這樣啊。
    我們分為使用端和框架端兩部分。

    使用端

    我們在使用mybatis 的時候是不是需要使用SqlMapConfig.xml 配置文件,用來存放數據庫的連接信息,以及mapper.xml 的指向信息。mapper.xml 配置文件用來存放sql 信息。
    所以我們在使用端來創建兩個文件SqlMapConfig.xml 和mapper.xml。

    框架端

    框架端要做哪些事情呢?如下:
    1、獲取配置文件。也就是獲取到使用端的SqlMapConfig.xml 以及mapper.xml的 文件
    2、解析配置文件。對獲取到的文件進行解析,獲取到連接信息,sql,參數,返回類型等等。這些信息都會保存在configuration 這個對象中。
    3、創建SqlSessionFactory,目的是創建SqlSession的一個實例。
    4、創建SqlSession ,用來完成上面原始JDBC 的那些操作。

    那在SqlSession 中 進行了哪些操作呢?
    1、獲取數據庫連接
    2、獲取sql,並對sql 進行解析
    3、通過內省,將參數注入到preparedStatement 中
    4、執行sql
    5、通過反射將結果集封裝成對象

    使用端實現

    好了,上面說了一下,大概的設計思路,主要也是仿照mybatis 主要的類實現的,保證類名一致,方便我們後面閱讀源碼。我們先來配置好使用端吧,我們創建一個maven 項目。
    在項目中,我們創建一個User實體類

    public class User {
        private Integer id;
        private String username;
        private String password;
        private String birthday;
        //getter()和setter()方法
    }
    

    創建SqlMapConfig.xml 和Mapper.xml
    SqlMapConfig.xml

    <?xml version="1.0" encoding="UTF-8" ?>
    <configuration>
        <property name="driverClass" value="com.mysql.jdbc.Driver"></property>
        <property name="jdbcUrl" value="jdbc:mysql://localhost:3306/mybatis?serverTimezone=UTC&amp;characterEncoding=utf8&amp;useUnicode=true&amp;useSSL=false"></property>
        <property name="userName" value="root"></property>
        <property name="password" value="123456"></property>
        
        <mapper resource="UserMapper.xml">
        </mapper>
    </configuration>
    

    可以看到我們xml 中就配置了數據庫的連接信息,以及mapper 一個索引。mybatis中的SqlMapConfig.xml 中還包含其他的標籤,只是豐富了功能而已,所以我們只用最主要的。

    mapper.xml
    是每個類的sql 都會生成一個對應的mapper.xml 。我們這裏就用User 類來說吧,所以我們就創建一個UserMapper.xml

    <?xml version="1.0" encoding="UTF-8" ?>
    <mapper namespace="cn.quellanan.dao.UserDao">
        <select id="selectAll" resultType="cn.quellanan.pojo.User">
            select * from user
        </select>
        <select id="selectByName" resultType="cn.quellanan.pojo.User" paramType="cn.quellanan.pojo.User">
            select * from user where username=#{username}
        </select>
    </mapper>
    

    可以看到有點mybatis 裏面文件的味道,有namespace表示命名空間,id 唯一標識,resultType 返回結果集的類型,paramType 參數的類型。
    我們使用端先創建到這,主要是兩個配置文件,我們接下來看看框架端是怎麼實現的。

    加油哈哈。

    框架端實現

    框架端,我們按照上面的設計思路一步一步來。

    獲取配置

    怎麼樣獲取配置文件呢?我們可以使用JDK自帶自帶的類Resources加載器來獲取文件。我們創建一個自定義Resource類來封裝一下:

    import java.io.InputStream;
    public class Resources {
        public  static InputStream getResources(String path){
            //使用系統自帶的類Resources加載器來獲取文件。
            return Resources.class.getClassLoader().getResourceAsStream(path);
        }
    }
    

    這樣通過傳入路徑,就可以獲取到對應的文件流啦。

    解析配置文件

    上面獲取到了SqlMapConfig.xml 配置文件,我們現在來解析它。
    不過在此之前,我們需要做一點準備工作,就是解析的內存放到什麼地方?
    所以我們來創建兩個實體類Mapper 和Configuration。

    Mapper
    Mapper 實體類用來存放使用端寫的mapper.xml 文件的內容,我們前面說了裏面有.id、sql、resultType 和paramType .所以我們創建的Mapper實體如下:

    public class Mapper {
        private String id;
        private Class<?> resultType;
        private Class<?> parmType;
        private String sql;
        //getter()和setter()方法
    }
    

    這裏我們為什麼不添加namespace 的值呢?
    聰明的你肯定發現了,因為mapper裏面這些屬性表明每個sql 都對應一個mapper,而namespace 是一個命名空間,算是sql 的上一層,所以在mapper中暫時使用不到,就沒有添加了。

    Configuration
    Configuration 實體用來保存SqlMapConfig 中的信息。所以需要保存數據庫連接,我們這裏直接用JDK提供的 DataSource。還有一個就是mapper 的信息。每個mapper 有自己的標識,所以這裏採用hashMap來存儲。如下:

    public class Configuration {
    
        private DataSource dataSource;
        HashMap <String,Mapper> mapperMap=new HashMap<>();
        //getter()和setter方法
        }
    

    XmlMapperBuilder

    做好了上面的準備工作,我們先來解析mapper 吧。我們創建一個XmlMapperBuilder 類來解析。通過dom4j 的工具類來解析XML 文件。我這裏用的dom4j 依賴為:

    		<dependency>
                <groupId>org.dom4j</groupId>
                <artifactId>dom4j</artifactId>
                <version>2.1.3</version>
            </dependency>
    

    思路:
    1、獲取文件流,轉成document。
    2、獲取根節點,也就是mapper。獲取根節點的namespace屬性值
    3、獲取select 節點,獲取其id,sql,resultType,paramType
    4、將select 節點的屬性封裝到Mapper 實體類中。
    5、同理獲取update/insert/delete 節點的屬性值封裝到Mapper 中
    6、通過namespace.id 生成key 值將mapper對象保存到Configuration實體中的HashMap 中。
    7、返回 Configuration實體
    代碼如下:

    
    public class XmlMapperBuilder {
        private Configuration configuration;
        public XmlMapperBuilder(Configuration configuration){
            this.configuration=configuration;
        }
    
        public Configuration loadXmlMapper(InputStream in) throws DocumentException, ClassNotFoundException {
            Document document=new SAXReader().read(in);
    
            Element rootElement=document.getRootElement();
            String namespace=rootElement.attributeValue("namespace");
    
            List<Node> list=rootElement.selectNodes("//select");
    
            for (int i = 0; i < list.size(); i++) {
                Mapper mapper=new Mapper();
                Element element= (Element) list.get(i);
                String id=element.attributeValue("id");
                mapper.setId(id);
                String paramType = element.attributeValue("paramType");
                if(paramType!=null && !paramType.isEmpty()){
                    mapper.setParmType(Class.forName(paramType));
                }
                String resultType = element.attributeValue("resultType");
                if (resultType != null && !resultType.isEmpty()) {
                    mapper.setResultType(Class.forName(resultType));
                }
                mapper.setSql(element.getTextTrim());
                String key=namespace+"."+id;
                configuration.getMapperMap().put(key,mapper);
            }
            return configuration;
        }
    
    }
    

    上面我只解析了select 標籤。大家可以解析對應insert/delete/uupdate 標籤,操作都是一樣的。

    XmlConfigBuilder

    我們再來解析一下SqlMapConfig.xml 配置信息思路是一樣的,
    1、獲取文件流,轉成document。
    2、獲取根節點,也就是configuration。
    3、獲取根節點中所有的property 節點,並獲取值,也就是獲取數據庫連接信息
    4、創建一個dataSource 連接池
    5、將連接池信息保存到Configuration實體中
    6、獲取根節點的所有mapper 節點
    7、調用XmlMapperBuilder 類解析對應mapper 並封裝到Configuration實體中
    8、完
    代碼如下:

    public class XmlConfigBuilder {
        private Configuration configuration;
        public XmlConfigBuilder(Configuration configuration){
            this.configuration=configuration;
        }
    
        public Configuration loadXmlConfig(InputStream in) throws DocumentException, PropertyVetoException, ClassNotFoundException {
    
            Document document=new SAXReader().read(in);
    
            Element rootElement=document.getRootElement();
    
            //獲取連接信息
            List<Node> propertyList=rootElement.selectNodes("//property");
            Properties properties=new Properties();
    
            for (int i = 0; i < propertyList.size(); i++) {
                Element element = (Element) propertyList.get(i);
                properties.setProperty(element.attributeValue("name"),element.attributeValue("value"));
            }
    		//是用連接池
            ComboPooledDataSource dataSource = new ComboPooledDataSource();
            dataSource.setDriverClass(properties.getProperty("driverClass"));
            dataSource.setJdbcUrl(properties.getProperty("jdbcUrl"));
            dataSource.setUser(properties.getProperty("userName"));
            dataSource.setPassword(properties.getProperty("password"));
            configuration.setDataSource(dataSource);
    
            //獲取mapper 信息
            List<Node> mapperList=rootElement.selectNodes("//mapper");
            for (int i = 0; i < mapperList.size(); i++) {
                Element element= (Element) mapperList.get(i);
                String mapperPath=element.attributeValue("resource");
                XmlMapperBuilder xmlMapperBuilder = new XmlMapperBuilder(configuration);
                configuration=xmlMapperBuilder.loadXmlMapper(Resources.getResources(mapperPath));
            }
            return configuration;
        }
    }
    

    創建SqlSessionFactory

    完成解析后我們創建SqlSessionFactory 用來創建Sqlseesion 的實體,這裏為了盡量還原mybatis 設計思路,也也採用的工廠設計模式。
    SqlSessionFactory 是一個接口,裏面就一個用來創建SqlSessionf的方法。
    如下:

    public interface SqlSessionFactory {
        public SqlSession openSqlSession();
    }
    

    單單這個接口是不夠的,我們還得寫一個接口的實現類,所以我們創建一個DefaultSqlSessionFactory。
    如下:

    public class DefaultSqlSessionFactory implements SqlSessionFactory {
    
        private Configuration configuration;
    
        public DefaultSqlSessionFactory(Configuration configuration) {
            this.configuration = configuration;
        }
        public SqlSession openSqlSession() {
            return new DefaultSqlSeeion(configuration);
        }
    }
    

    可以看到就是創建一個DefaultSqlSeeion並將包含配置信息的configuration 傳遞下去。DefaultSqlSeeion 就是SqlSession 的一個實現類。

    創建SqlSession

    在SqlSession 中我們就要來處理各種操作了,比如selectList,selectOne,insert.update,delete 等等。
    我們這裏SqlSession 就先寫一個selectList 方法。
    如下:

    public interface SqlSession {
    
        /**
         * 條件查找
         * @param statementid  唯一標識,namespace.selectid
         * @param parm  傳參,可以不傳也可以一個,也可以多個
         * @param <E>
         * @return
         */
        public <E> List<E> selectList(String statementid,Object...parm) throws Exception;


    然後我們創建DefaultSqlSeeion 來實現SqlSeesion 。

    public class DefaultSqlSeeion implements SqlSession {
        private Configuration configuration;
    	private Executer executer=new SimpleExecuter();
    	
        public DefaultSqlSeeion(Configuration configuration) {
            this.configuration = configuration;
        }
    
    	@Override
        public <E> List<E> selectList(String statementid, Object... parm) throws Exception {
            Mapper mapper=configuration.getMapperMap().get(statementid);
            List<E> query = executer.query(configuration, mapper, parm);
            return query;
        }
    
    }
    

    我們可以看到DefaultSqlSeeion 獲取到了configuration,並通過statementid 從configuration 中獲取mapper。 然後具體實現交給了Executer 類來實現。我們這裏先不管Executer 是怎麼實現的,就假裝已經實現了。那麼整個框架端就完成了。通過調用Sqlsession.selectList() 方法,來獲取結果。

    感覺我們都還沒有處理,就框架搭建好了?騙鬼呢,確實前面我們從獲取文件解析文件,然後創建工廠。都是做好準備工作。下面開始我們JDBC的實現。

    SqlSession 具體實現

    我們前面說SqlSeesion 的具體實現有下面5步
    1、獲取數據庫連接
    2、獲取sql,並對sql 進行解析
    3、通過內省,將參數注入到preparedStatement 中
    4、執行sql
    5、通過反射將結果集封裝成對象

    但是我們在DefaultSqlSeeion 中將實現交給了Executer來執行。所以我們就要在Executer中來實現這些操作。

    我們首先來創建一個Executer 接口,並寫一個DefaultSqlSeeion中調用的query 方法。

    public interface Executer {
    
        <E> List<E> query(Configuration configuration,Mapper mapper,Object...parm) throws Exception;
    
    }
    

    接着我們寫一個SimpleExecuter 類來實現Executer 。
    然後SimpleExecuter.query()方法中,我們一步一步的實現。

    獲取數據庫連接

    因為數據庫連接信息保存在configuration,所以直接獲取就好了。

    //獲取連接
            connection=configuration.getDataSource().getConnection();
    

    獲取sql,並對sql 進行解析

    我們這裏想一下,我們在Usermapper.xml寫的sql 是什麼樣子?

    select * from user where username=#{username}
    

    {username} 這樣的sql 我們改怎麼解析呢?

    分兩步
    1、將sql 找到#{***},並將這部分替換成 ?號

    2、對 #{***} 進行解析獲取到裏面的參數對應的paramType 中的值。

    具體實現用到下面幾個類。
    GenericTokenParser類,可以看到有三個參數,開始標記,就是我們的“#{” ,結束標記就是 “}”, 標記處理器就是處理標記裏面的內容也就是username。

    public class GenericTokenParser {
    
      private final String openToken; //開始標記
      private final String closeToken; //結束標記
      private final TokenHandler handler; //標記處理器
    
      public GenericTokenParser(String openToken, String closeToken, TokenHandler handler) {
        this.openToken = openToken;
        this.closeToken = closeToken;
        this.handler = handler;
      }
    
      /**
       * 解析${}和#{}
       * @param text
       * @return
       * 該方法主要實現了配置文件、腳本等片段中佔位符的解析、處理工作,並返回最終需要的數據。
       * 其中,解析工作由該方法完成,處理工作是由處理器handler的handleToken()方法來實現
       */
      public String parse(String text) {
     	 //具體實現
     	 }
      }
    

    主要的就是parse() 方法,用來獲取操作1 的sql。獲取結果例如:

    select * from user where username=?
    

    那上面用到TokenHandler 來處理參數。
    ParameterMappingTokenHandler實現TokenHandler的類

    
    public class ParameterMappingTokenHandler implements TokenHandler {
    	private List<ParameterMapping> parameterMappings = new ArrayList<ParameterMapping>();
    
    	// context是參數名稱 #{id} #{username}
    
    	@Override
    	public String handleToken(String content) {
    		parameterMappings.add(buildParameterMapping(content));
    		return "?";
    	}
    
    	private ParameterMapping buildParameterMapping(String content) {
    		ParameterMapping parameterMapping = new ParameterMapping(content);
    		return parameterMapping;
    	}
    
    	public List<ParameterMapping> getParameterMappings() {
    		return parameterMappings;
    	}
    
    	public void setParameterMappings(List<ParameterMapping> parameterMappings) {
    		this.parameterMappings = parameterMappings;
    	}
    
    }


    可以看到將參數名稱存放 ParameterMapping 的集合中了。
    ParameterMapping 類就是一個實體,用來保存參數名稱的。

    public class ParameterMapping {
    
        private String content;
    
        public ParameterMapping(String content) {
            this.content = content;
        }
    	//getter()和setter() 方法。
    }
    

    所以我們在我們通過GenericTokenParser類,就可以獲取到解析后的sql,以及參數名稱。我們將這些信息封裝到BoundSql實體類中。

    public class BoundSql {
    
        private String sqlText;
        private List<ParameterMapping> parameterMappingList=new ArrayList<>();
        public BoundSql(String sqlText, List<ParameterMapping> parameterMappingList) {
            this.sqlText = sqlText;
            this.parameterMappingList = parameterMappingList;
        }
        ////getter()和setter() 方法。
      }
    

    好了,那麼分兩步走,先獲取,后解析
    獲取
    獲取原始sql 很簡單,sql 信息就存在mapper 對象中,直接獲取就好了。

    String sql=mapper.getSql()
    

    解析
    1、創建一個ParameterMappingTokenHandler 處理器
    2、創建一個GenericTokenParser 類,並初始化開始標記,結束標記,處理器
    3、執行genericTokenParser.parse(sql);獲取解析后的sql‘’,以及在parameterMappingTokenHandler 中存放了參數名稱的集合。
    4、將解析后的sql 和參數封裝到BoundSql 實體類中。

    /**
         * 解析自定義佔位符
         * @param sql
         * @return
         */
        private BoundSql getBoundSql(String sql){
            ParameterMappingTokenHandler parameterMappingTokenHandler = new ParameterMappingTokenHandler();
            GenericTokenParser genericTokenParser = new GenericTokenParser("#{","}",parameterMappingTokenHandler);
            String parse = genericTokenParser.parse(sql);
            return new BoundSql(parse,parameterMappingTokenHandler.getParameterMappings());
    
        }
    

    將參數注入到preparedStatement 中

    上面的就完成了sql,的解析,但是我們知道上面得到的sql 還是包含 JDBC的 佔位符,所以我們需要將參數注入到preparedStatement 中。
    1、通過boundSql.getSqlText()獲取帶有佔位符的sql.
    2、接收參數名稱集合 parameterMappingList
    3、通過mapper.getParmType() 獲取到參數的類。
    4、通過getDeclaredField(content)方法獲取到參數類的Field。
    5、通過Field.get() 從參數類中獲取對應的值
    6、注入到preparedStatement 中

    		BoundSql boundSql=getBoundSql(mapper.getSql());
            String sql=boundSql.getSqlText();
            List<ParameterMapping> parameterMappingList = boundSql.getParameterMappingList();
    
            //獲取preparedStatement,並傳遞參數值
            PreparedStatement preparedStatement=connection.prepareStatement(sql);
            Class<?> parmType = mapper.getParmType();
    
            for (int i = 0; i < parameterMappingList.size(); i++) {
                ParameterMapping parameterMapping = parameterMappingList.get(i);
                String content = parameterMapping.getContent();
                Field declaredField = parmType.getDeclaredField(content);
                declaredField.setAccessible(true);
                Object o = declaredField.get(parm[0]);
                preparedStatement.setObject(i+1,o);
            }
            System.out.println(sql);
            return preparedStatement;
    

    執行sql

    其實還是調用JDBC 的executeQuery()方法或者execute()方法

    //執行sql
     ResultSet resultSet = preparedStatement.executeQuery();
    

    通過反射將結果集封裝成對象

    在獲取到resultSet 后,我們進行封裝處理,和參數處理是類似的。
    1、創建一個ArrayList
    2、獲取返回類型的類
    3、循環從resultSet中取數據
    4、獲取屬性名和屬性值
    5、創建屬性生成器
    6、為屬性生成寫方法,並將屬性值寫入到屬性中
    7、將這條記錄添加到list 中
    8、返回list

    /**
         * 封裝結果集
         * @param mapper
         * @param resultSet
         * @param <E>
         * @return
         * @throws Exception
         */
        private <E> List<E> resultHandle(Mapper mapper,ResultSet resultSet) throws Exception{
            ArrayList<E> list=new ArrayList<>();
            //封裝結果集
            Class<?> resultType = mapper.getResultType();
            while (resultSet.next()) {
                ResultSetMetaData metaData = resultSet.getMetaData();
                Object o = resultType.newInstance();
                int columnCount = metaData.getColumnCount();
                for (int i = 1; i <= columnCount; i++) {
                    //屬性名
                    String columnName = metaData.getColumnName(i);
                    //屬性值
                    Object value = resultSet.getObject(columnName);
                    //創建屬性描述器,為屬性生成讀寫方法
                    PropertyDescriptor propertyDescriptor = new PropertyDescriptor(columnName,resultType);
                    Method writeMethod = propertyDescriptor.getWriteMethod();
                    writeMethod.invoke(o,value);
                }
                list.add((E) o);
            }
            return list;
        }
    

    創建SqlSessionFactoryBuilder

    我們現在來創建一個SqlSessionFactoryBuilder 類,來為使用端提供一個人口。

    public class SqlSessionFactoryBuilder {
    
        private Configuration configuration;
    
        public SqlSessionFactoryBuilder(){
            configuration=new Configuration();
        }
    
        public SqlSessionFactory build(InputStream in) throws DocumentException, PropertyVetoException, ClassNotFoundException {
            XmlConfigBuilder xmlConfigBuilder = new XmlConfigBuilder(configuration);
            configuration=xmlConfigBuilder.loadXmlConfig(in);
    
            SqlSessionFactory sqlSessionFactory = new DefaultSqlSessionFactory(configuration);
            return sqlSessionFactory;
        }
    }
    

    可以看到就一個build 方法,通過SqlMapConfig的文件流將信息解析到configuration,創建並返回一個sqlSessionFactory 。

    到此,整個框架端已經搭建完成了,但是我們可以看到,只實現了select 的操作,update、inster、delete 的操作我們在我後面提供的源碼中會有實現,這裏只是將整體的設計思路和流程。

    測試

    終於到了測試的環節啦。我們前面寫了自定義的持久層,我們現在來測試一下能不能正常的使用吧。
    見證奇迹的時刻到啦

    我們先引入我們自定義的框架依賴。以及數據庫和單元測試

    <dependency>
                <groupId>mysql</groupId>
                <artifactId>mysql-connector-java</artifactId>
                <version>8.0.11</version>
            </dependency>
            <dependency>
                <groupId>cn.quellanan</groupId>
                <artifactId>myself-mybatis</artifactId>
                <version>1.0.0</version>
            </dependency>
    
            <dependency>
                <groupId>junit</groupId>
                <artifactId>junit</artifactId>
                <version>4.10</version>
            </dependency>
    

    然後我們寫一個測試類
    1、獲取SqlMapperConfig.xml的文件流
    2、獲取Sqlsession
    3、執行查找操作

    @org.junit.Test
        public void test() throws Exception{
            InputStream inputStream= Resources.getResources("SqlMapperConfig.xml");
            SqlSession sqlSession = new SqlSessionFactoryBuilder().build(inputStream).openSqlSession();
            List<User> list = sqlSession.selectList("cn.quellanan.dao.UserDao.selectAll");
    
            for (User parm : list) {
                System.out.println(parm.toString());
            }
            System.out.println();
    
            User user=new User();
            user.setUsername("張三");
            List<User> list1 = sqlSession.selectList("cn.quellanan.dao.UserDao.selectByName", user);
            for (User user1 : list1) {
                System.out.println(user1);
            }
    
        }
    

    可以看到已經可以了,看來我們自定義的持久層框架生效啦。

    優化

    但是不要高興的太早哈哈,我們看上面的測試方法,是不是感覺和平時用的不一樣,每次都都寫死statementId ,這樣不太友好,所以我們接下來來點騷操作,通用mapper 配置。
    我們在SqlSession中增加一個getMapper方法,接收的參數是一個類。我們通過這個類就可以知道statementId .

    /**
         * 使用代理模式來創建接口的代理對象
         * @param mapperClass
         * @param <T>
         * @return
         */
        public <T> T getMapper(Class<T> mapperClass);
    

    具體實現就是利用JDK 的動態代理機制。
    1、通過Proxy.newProxyInstance() 獲取一個代理對象
    2、返回代理對象
    那代理對象執行了哪些操作呢?
    創建代理對象的時候,會實現一個InvocationHandler接口,重寫invoke() 方法,讓所有走這個代理的方法都會執行這個invoke() 方法。那這個方法做了什麼操作?
    這個方法就是通過傳入的類對象,獲取到對象的類名和方法名。用來生成statementid 。所以我們在mapper.xml 配置文件中的namespace 就需要制定為類路徑,以及id 為方法名。
    實現方法:

    @Override
        public <T> T getMapper(Class<T> mapperClass) {
    
            Object proxyInstance = Proxy.newProxyInstance(DefaultSqlSeeion.class.getClassLoader(), new Class[]{mapperClass}, new InvocationHandler() {
                @Override
                public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
    
                    //獲取到方法名
                    String name = method.getName();
                    //類型
                    String className = method.getDeclaringClass().getName();
                    String statementid=className+"."+name;
    
                    return selectList(statementid,args);
                }
            });
    
    
            return (T) proxyInstance;
        }
    

    我們寫一個UserDao

    public interface UserDao {
        List<User> selectAll();
    
        List<User> selectByName(User user);
    }
    

    這個是不是我們熟悉的味道哈哈,就是mapper層的接口。
    然後我們在mapper.xml 中指定namespace 和id

    接下來我們在寫一個測試方法

    @org.junit.Test
        public void test2() throws Exception{
            InputStream inputStream= Resources.getResources("SqlMapperConfig.xml");
            SqlSession sqlSession = new SqlSessionFactoryBuilder().build(inputStream).openSqlSession();
    
            UserDao mapper = sqlSession.getMapper(UserDao.class);
            List<User> users = mapper.selectAll();
            for (User user1 : users) {
                System.out.println(user1);
            }
    
            User user=new User();
            user.setUsername("張三");
            List<User> users1 = mapper.selectByName(user);
            for (User user1 : users1) {
                System.out.println(user1);
            }
    
        }
    

    番外

    自定義的持久層框架,我們就寫完了。這個實際上就是mybatis 的雛形,我們通過自己手動寫一個持久層框架,然後在來看mybatis 的源碼,就會清晰很多。下面這些類名在mybatis 中都有體現。

    這裏拋磚引玉,祝君閱讀源碼愉快。
    覺得有用的兄弟們記得收藏啊。

    厚顏無恥的求波點贊!!!

    本文由博客一文多發平台 OpenWrite 發布!

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※別再煩惱如何寫文案,掌握八大原則!

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

    ※回頭車貨運收費標準

    ※台中搬家公司費用怎麼算?