部落格

  • linux與Windows進程控制

    linux與Windows進程控制

    進程管理控制

    這裏實現的是一個自定義timer用於統計子進程運行的時間。使用方式主要是

    timer [-t seconds] command arguments

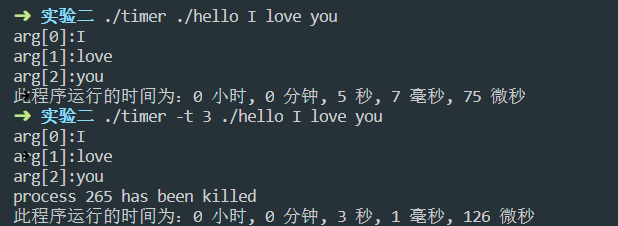
    例如要統計ls的運行時間可以直接輸入timer ls,其後的arguments是指所要運行的程序的參數。如:timer ls -al。如果要指定程序運行多少時間,如5秒鐘,可以輸入timer -t 5 ls -al。需要注意的是,該程序對輸入沒有做異常檢測,所以要確保程序輸入正確。

    Linux

    程序思路

    1. 獲取時間

      時間獲取函數使用gettimeofday,精度可以達到微秒

      struct timeval{
           long tv_sec;*//秒*
           long tv_usec;*//微秒*
      }
    2. 子進程創建

      1. fork()函數

        #include <sys/types.h>
        #include <unistd.h>
        pid_t fork(void);

        fork調用失敗則返回-1,調用成功則:

        fork函數會有兩種返回值,一是為0,一是為正整數。若為0,則說明當前進程為子進程;若為正整數,則該進程為父進程且該值為子進程pid。關於進程控制的詳細說明請參考:

      2. exec函數

        用fork創建子進程后執行的是和父進程相同的程序(但有可能執行不同的代碼分支),子進程往往要調用一種exec函數以執行另一個程序。當進程調用一種exec函數時,該進程的用戶空間代碼和數據完全被新程序替換,從新程序的啟動例程開始執行。調用exec並不創建新進程,所以調用exec前後該進程的id並未改變。
        其實有六種以exec開頭的函數,統稱exec函數:

        #include <unistd.h>
        int execl(const char *path, const char *arg, ...);
        int execlp(const char *file, const char *arg, ...);
        int execle(const char *path, const char *arg, ..., char *const envp[]);
        int execv(const char *path, char *const argv[]);
        int execvp(const char *file, char *const argv[]);
        int execve(const char *path, char *const argv[], char *const envp[]);

        這些函數如果調用成功則加載新的程序從啟動代碼開始執行,不再返回,如果調用出錯則返回-1,所以exec函數只有出錯的返回值而沒有成功的返回值。

      3. wait與waitpid

        一個進程在終止時會關閉所有文件描述符,釋放在用戶空間分配的內存,但它的PCB還保留着,內核在其中保存了一些信息:如果是正常終止則保存着退出狀態,如果是異常終止則保存着導致該進程終止的信號是哪個。這個進程的父進程可以調用wait或waitpid獲取這些信息,然後徹底清除掉這個進程。我們知道一個進程的退出狀態可以在Shell中用特殊變量$?查看,因為Shell是它的父進程,當它終止時Shell調用wait或waitpid得到它的退出狀態同時徹底清除掉這個進程。
        如果一個進程已經終止,但是它的父進程尚未調用wait或waitpid對它進行清理,這時的進程狀態稱為殭屍(Zombie)進程。任何進程在剛終止時都是殭屍進程,正常情況下,殭屍進程都立刻被父進程清理了。
        殭屍進程是不能用kill命令清除掉的,因為kill命令只是用來終止進程的,而殭屍進程已經終止了。

      #include <sys/types.h>
      #include <sys/wait.h>
      pid_t wait(int *status);
      pid_t waitpid(pid_t pid, int *status, int options);

      若調用成功則返回清理掉的子進程id,若調用出錯則返回-1。父進程調用wait或waitpid時可能會:

      • 阻塞(如果它的所有子進程都還在運行

      • 帶子進程的終止信息立即返回(如果一個子進程已終止,正等待父進程讀取其終止信息)
      • 出錯立即返回(如果它沒有任何子進程)

      這兩個函數的區別是:

      • 如果父進程的所有子進程都還在運行,調用wait將使父進程阻塞,而調用waitpid時如果在options參數中指定WNOHANG可以使父進程不阻塞而立即返回0
      • wait等待第一個終止的子進程,而waitpid可以通過pid參數指定等待哪一個子進程

    ​

    源代碼

    timer源代碼

    #include <math.h>
    #include <stdio.h>
    #include <stdlib.h>
    #include <sys/time.h>
    #include <unistd.h>
    #include <wait.h>
    #include <ctime>
    #include <iostream>
    #include <cstring>
    //程序假定輸入完全正確,沒有做異常處理
    //mytime [-t number] 程序
    using namespace std;
    //調用系統時間
    struct timeval time_start;
    struct timeval time_end;
    
    void printTime();
    
    void newProcess(const char *child_process, char *argv[], double duration);
    
    int main(int argc, char const *argv[])
    {
        double duration = 0;
        char **arg;
        int step = 2;
        if (argc > 3 && (strcmp((char *)"-t", argv[1]) == 0)) //如果指定了運行時間
        {
            step = 4;
            duration = atof(argv[2]); //沒有做異常處理
        }
    
        arg = new char *[argc - step + 1];
        for (int i = 0; i < argc - step; i++)
        {
            arg[i] = new char[100];
            strcpy(arg[i], argv[i + step]);
        }
        arg[argc - step] = NULL;
    
        newProcess(argv[step - 1], arg, duration);
        return 0;
    }
    
    void printTime()
    {
        //用以記錄進程運行的時間
        int time_use = 0;  // us
        int time_left = 0; // us
        int time_hour = 0, time_min = 0, time_sec = 0, time_ms = 0, time_us = 0;
        gettimeofday(&time_end, NULL);
    
        time_use = (time_end.tv_sec - time_start.tv_sec) * 1000000 + (time_end.tv_usec - time_start.tv_usec);
        time_hour = time_use / (60 * 60 * (int)pow(10, 6));
        time_left = time_use % (60 * 60 * (int)pow(10, 6));
        time_min = time_left / (60 * (int)pow(10, 6));
        time_left %= (60 * (int)pow(10, 6));
        time_sec = time_left / ((int)pow(10, 6));
        time_left %= ((int)pow(10, 6));
        time_ms = time_left / 1000;
        time_left %= 1000;
        time_us = time_left;
        printf("此程序運行的時間為:%d 小時, %d 分鐘, %d 秒, %d 毫秒, %d 微秒\n", time_hour, time_min, time_sec, time_ms, time_us);
    }
    
    void newProcess(const char* child_process, char **argv, double duration)
    {
        pid_t pid = fork();
        if (pid < 0) //出錯
        {
            printf("創建子進程失敗!");
            exit(1);
        }
        if (pid == 0) //子進程
        {
            execvp(child_process, argv);
        }
        else
        {
            if (abs(duration - 0) < 1e-6)
            {
                gettimeofday(&time_start, NULL);
                wait(NULL); //等待子進程結束
                printTime();
            }
            else
            {
                gettimeofday(&time_start, NULL);
                // printf("sleep: %lf\n", duration);
                waitpid(pid, NULL, WNOHANG);
                usleep(duration * 1000000); // sec to usec
                int kill_ret_val = kill(pid, SIGKILL);
                if (kill_ret_val == -1) // return -1, fail
                {
                    printf("kill failed.\n");
                    perror("kill");
                }
                else if (kill_ret_val == 0) // return 0, success
                {
                    printf("process %d has been killed\n", pid);
                }
                printTime();
            }
        }
    }

    測試源代碼

    #include <iostream>
    #include <ctime>
    #include <unistd.h>
    using namespace std;
    int main(int argc, char const *argv[])
    {
        for(int n = 0; n < argc; n++)
        {
            printf("arg[%d]:%s\n",n, argv[n]);
        }
        sleep(5);
        return 0;
    }

    測試

    1. 自行編寫程序測試

    2. 系統程序測試

    3. 將timer加入環境變量

      這裏僅進行了臨時變量修改。

    Windows

    在Windows下進行父子進程的創建和管理在api調用上相較Linux有一定難度,但實際上在使用管理上比Linux容易的多。

    CreateProcess

    #include <Windows.h>
    BOOL CreateProcessA(
      LPCSTR                lpApplicationName,
      LPSTR                 lpCommandLine,
      LPSECURITY_ATTRIBUTES lpProcessAttributes,
      LPSECURITY_ATTRIBUTES lpThreadAttributes,
      BOOL                  bInheritHandles,
      DWORD                 dwCreationFlags,
      LPVOID                lpEnvironment,
      LPCSTR                lpCurrentDirectory,
      LPSTARTUPINFOA        lpStartupInfo,
      LPPROCESS_INFORMATION lpProcessInformation
    );

    源代碼實現

    timer程序

    // 進程管理.cpp : 此文件包含 "main" 函數。程序執行將在此處開始並結束。
    //
    
    #include <iostream>
    #include <wchar.h>
    #include <Windows.h>
    #include <tchar.h>
    using namespace std;
    
    
    void printTime(SYSTEMTIME* start, SYSTEMTIME* end);
    void newProcess(TCHAR* cWinDir, double duration);
    
    int _tmain(int argc, TCHAR *argv[])
    {
        TCHAR* cWinDir = new TCHAR[MAX_PATH];
        memset(cWinDir, sizeof(TCHAR) * MAX_PATH, 0);
    
        printf("argc:   %d\n", argc);
    
        int step = 1;
        double duration = 0;
        if (argc > 1)
        {
            if (argv[1][0] == TCHAR('-') && argv[1][1] == TCHAR('t') && argv[1][2] == TCHAR('\0'))
            {
                step = 3;
                duration = atof((char*)argv[2]);
            }
        }
        //printf("printf content start: %ls\n", argv[1]);
        int j = 0;
        for (int i = 0, h = 0; i < argc - step; i++)
        {
            wcscpy_s(cWinDir + j, MAX_PATH - j, argv[i + step]);
            for (h = 0; argv[i + step][h] != TCHAR('\0'); h++);
            j += h;
            cWinDir[j++] = ' ';
            //printf("%d : %d\n", i, j);
            //printf("printf content start: %ls\n", cWinDir);
        }
        cWinDir[j - 2] = TCHAR('\0');
        //printf("printf content start: %ls\n", cWinDir);
    
        newProcess(cWinDir,duration);
    
        return 0;
    }
    
    
    void printTime(SYSTEMTIME* start, SYSTEMTIME* end)
    {
        int hours = end->wHour - start->wHour;
        int minutes = end->wMinute - start->wMinute;
        int seconds = end->wSecond - start->wSecond;
        int ms = end->wMilliseconds - start->wMilliseconds;
        if (ms < 0)
        {
            ms += 1000;
            seconds -= 1;
        }
        if (seconds < 0)
        {
            seconds += 60;
            minutes -= 1;
        }
        if (minutes < 0)
        {
            minutes += 60;
            hours -= 1;
        }
        //由於僅考慮在一天之內,不考慮小時會變成負數的情況
        printf("runtime: %02dhours %02dminutes %02dseconds %02dmilliseconds\n", hours, minutes, seconds, ms);
    }
    
    void newProcess(TCHAR* cWinDir, double duration)
    {
        PROCESS_INFORMATION pi;
        STARTUPINFO si;
        ZeroMemory(&si, sizeof(si));
        si.cb = sizeof(si);
        ZeroMemory(&pi, sizeof(pi));
        
    
        SYSTEMTIME start_time, end_time;
        memset(&start_time, sizeof(SYSTEMTIME), 0);
        memset(&end_time, sizeof(SYSTEMTIME), 0);
        GetSystemTime(&start_time);
    
            //建議大家不要單獨傳入lpApplicationName,而是將程序名放入cWinDir中
            //這樣會自動搜索PATH
        if (CreateProcess(
            NULL,       //lpApplicationName.若為空,則lpCommandLine必須指定可執行程序
                        //若路徑中存在空格,必須使用引號框定
            cWinDir,    //lpCommandLine
                        //若lpApplicationName為空,lpCommandLine長度不超過MAX_PATH
            NULL,       //指向一個SECURITY_ATTRIBUTES結構體,這個結構體決定是否返回的句柄可以被子進程繼承,進程安全性
            NULL,       //  如果lpProcessAttributes參數為空(NULL),那麼句柄不能被繼承。<同上>,線程安全性
            false,      //  指示新進程是否從調用進程處繼承了句柄。句柄可繼承性
            0,          //  指定附加的、用來控制優先類和進程的創建的標識符(優先級)
                        //  CREATE_NEW_CONSOLE  新控制台打開子進程
                        //  CREATE_SUSPENDED    子進程創建后掛起,直到調用ResumeThread函數
            NULL,       //  指向一個新進程的環境塊。如果此參數為空,新進程使用調用進程的環境。指向環境字符串
            NULL,       //  指定子進程的工作路徑
            &si,        //  決定新進程的主窗體如何显示的STARTUPINFO結構體
            &pi         //  接收新進程的識別信息的PROCESS_INFORMATION結構體。進程線程以及句柄
        ))
        {
        }
        else
        {
            printf("CreateProcess failed (%d).\n", GetLastError());
            return;
        }
    
    
        //wait untill the child process exits
        if (abs(duration - 0) < 1e-6)
            WaitForSingleObject(pi.hProcess, INFINITE);//這裏指定運行時間,單位毫秒
        else
            WaitForSingleObject(pi.hProcess, duration * 1000);
    
        GetSystemTime(&end_time);
    
        printTime(&start_time, &end_time);
    
        CloseHandle(pi.hProcess);
        CloseHandle(pi.hThread);
    }

    測試程序

    #include <iostream>
    #include <Windows.h>
    using namespace std;
    int main(int argc, char* argv[])
    {
        for (int n = 0; n < argc; n++)
        {
            printf("arg[%d]:%s\n", n, argv[n]);
        }
        Sleep(5*1000);
        return 0;
    }

    測試

    1. 自行編寫程序測試

    2. 系統程序測試

    3. 添加至環境變量

    參考資料

    Windows

    Linux

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象
  • java中hashmap容量的初始化

    HashMap使用HashMap(int initialCapacity)對集合進行初始化。

    在默認的情況下,HashMap的容量是16。但是如果用戶通過構造函數指定了一個数字作為容量,那麼Hash會選擇大於該数字的第一個2的冪作為容量。比如如果指定了3,則容量是4;如果指定了7,則容量是8;如果指定了9,則容量是16。

    為什麼要設置HashMap的初始化容量

    在《阿里巴巴Java開發手冊》中,有一條開發建議是建議我們設置HashMap的初始化容量。

    下面我們通過具體的代碼來了解下為什麼會這麼建議。

    我們先來寫一段代碼在JDK1.7的環境下運行,來分別測試下,在不指定初始化容量和指定初始化容量的情況下性能情況的不同。

    public static void main(String[] args) {
        int aHundredMillion = 10000000;
    
        // 未初始化容量
        Map<Integer, Integer> map = new HashMap<>();
        long s1 = System.currentTimeMillis();
        for (int i = 0; i < aHundredMillion; i++) {
            map.put(i, i);
        }
        long s2 = System.currentTimeMillis();
        System.out.println("未初始化容量,耗時: " + (s2 - s1)); // 14322
    
        // 初始化容量為50000000
        Map<Integer, Integer> map1 = new HashMap<>(aHundredMillion / 2);
        long s3 = System.currentTimeMillis();
        for (int i = 0; i < aHundredMillion; i++) {
            map1.put(i, i);
        }
        long s4 = System.currentTimeMillis();
        System.out.println("初始化容量5000000,耗時: " + (s4 - s3)); // 11819
    
        // 初始化容量為100000000
        Map<Integer, Integer> map2 = new HashMap<>(aHundredMillion);
        long s5 = System.currentTimeMillis();
        for (int i = 0; i < aHundredMillion; i++) {
            map2.put(i, i);
        }
        long s6 = System.currentTimeMillis();
        System.out.println("初始化容量為10000000,耗時: " + (s6 - s5)); // 7978
    }

    從以上的代碼不難理解,我們創建了3個HashMap,分別使用默認的容量(16)、使用元素個數的一半(5千萬)作為初始容量和使用元素個數(一億)作為初始容量進行初始化,然後分別向其中put一億個KV。

    從上面的打印結果中可以得到一個初步的結論:在已知HashMap中將要存放的KV個數的時候,設置一個合理的初始化容量可以有效地提高性能。下面我們來簡單分析一下原因。

    我們知道,HashMap是有擴容機制的。所謂的擴容機制,指的是當達到擴容條件的時候,HashMap就會自動進行擴容。而HashMap的擴容條件就是當HashMap中的元素個數(Size)超過臨界值(Threshold)的情況下就會自動擴容。

    threshold = loadFactor * capacity

    在元素個數超過臨界值的情況下,隨着元素的不斷增加,HashMap就會發生擴容,而HashMap中的擴容機制決定了每次擴容都需要重建hash表,這一操作需要消耗大量資源,是非常影響性能的。因此,如果我們沒有設置初始的容量大小,HashMap就可能會不斷髮生擴容,也就使得程序的性能降低了。

    另外,在上面的代碼中我們會發現,同樣是設置了初始化容量,設置的數值不同也會影響性能,那麼當我們已知HashMap中即將存放的KV個數的時候,容量的設置就成了一個問題。

    HashMap中容量的初始化

    開頭提到,在默認的情況下,當我們設置HashMap的初始化容量時,實際上HashMap會採用第一個大於該數值的2的冪作為初始化容量。

    Map<String, String> map = new HashMap<>(1);
    map.put("huangq", "yanggb");
    
    Class<?> mapType = map.getClass();
    Method capacity = mapType.getDeclaredMethod("capacity");
    capacity.setAccessible(true);
    System.out.println("capacity : " + capacity.invoke(map)); // 2

    當初始化的容量設置成1的時候,通過反射取出來的capacity卻是2。在JDK1.8中,如果我們傳入的初始化容量為1,實際上設置的結果也是1。上面的代碼打印的結果為2的原因,是代碼中給map塞入值的操作導致了擴容,容量從1擴容到了2。事實上,在JDK1.7和JDK1.8中,HashMap初始化容量(capacity)的時機不同。在JDK1.8中,調用HashMap的構造函數定義HashMap的時候,就會進行容量的設定。而在JDK1.7中,要等到第一次put操作時才進行這一操作。

    因此,當我們通過HashMap(int initialCapacity)設置初始容量的時候,HashMap並不一定會直接採用我們傳入的數值,而是經過計算,得到一個新值,目的是提高hash的效率。比如1->1、3->4、7->8和9->16。

    HashMap中初始容量的合理值

    通過上面的分析我們可以知道,當我們使用HashMap(int initialCapacity)來初始化容量的時候,JDK會默認幫我們計算一個相對合理的值當做初始容量。那麼,是不是我們只需要把已知的HashMap中即將存放的元素個數直接傳給initialCapacity就可以了呢?

    initialCapacity = (需要存儲的元素個數 / 負載因子) + 1

    這裏的負載因子就是loaderFactor,默認值為0.75。

    initialCapacity = expectedSize / 0.75F + 1.0F

    上面這個公式是《阿里巴巴Java開發手冊》中的一個建議,在Guava中也是提供了相同的算法,更甚之,這個算法實際上是JDK8中putAll()方法的實現。這是公式的得出是因為,當HashMap內部維護的哈希表的容量達到75%時(默認情況下),就會觸發rehash(重建hash表)操作。而rehash的過程是比較耗費時間的。所以初始化容量要設置成expectedSize/0.75 + 1的話,可以有效地減少衝突,也可以減小誤差。

    總結

    當我們想要在代碼中創建一個HashMap的時候,如果我們已知這個Map中即將存放的元素個數,給HashMap設置初始容量可以在一定程度上提升效率。

    但是,JDK並不會直接拿用戶傳進來的数字當做默認容量,而是會進行一番運算,最終得到一個2的冪。而為了最大程度地避免擴容帶來的性能消耗,通常是建議可以把默認容量的数字設置成expectedSize / 0.75F + 1.0F。

    在日常開發中,可以使用Guava提供的一個方法來創建一個HashMap,計算的過程Guava會幫我們完成。

    Map<String, String> map = Maps.newHashMapWithExpectedSize(10);

    最後要說的一點是,這種算法實際上是一種使用內存換取性能的做法,在真正的應用場景中要考慮到內存的影響。


    “當你認真喜歡一個人的時候,你的全世界都是她。”

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • 如何教會女友遞歸算法?

    如何教會女友遞歸算法?

    一到周末就開始放蕩自我,這不帶着女朋友去萬達電影院看電影(其實是由於整天呆在家敲代碼硬是

    被女朋友強行拖拽去看電影,作為一個有理想的程序員,我想各位應該都能體諒我),一到電影院,

    女朋友說要買爆米花和可樂,我當時二話沒說,臣本布衣躬耕於南陽,壤中羞澀,所以單買了爆米

    花,買完都不帶回頭看老闆的那種,飲料喝多了不好,出門的時候我帶了白開水,還得虧我長得銷

    魂,乍一看就能看出是個社會精神小伙,女朋友也沒多說什麼,只是對我微了微笑(我估計是被我的

    顏值以及獨到的見解所折服),剛坐下沒多久,女朋友突然問我,咱們現在坐在第幾排啊?電影院里

    面太黑了,看不清,沒法數,這個時候,如果是你現在你怎麼辦?別忘了你我是程序員,這個可難不

    倒我,遞歸就開始排上用場了。於是我就問前面一排的人他是第幾排,你想只要在他的数字上加一,

    就知道自己在哪一排了。但是,前面的人也看不清啊,所以他也問他前面的人。就這樣一排一排往前

    問,直到問到第一排的人,說我在第一排,然後再這樣一排一排再把数字傳回來。直到你前面的人告

    訴你他在哪一排,於是你就知道答案了。這就是一個非常標準的遞歸求解問題的分解過程,去的過程

    叫“遞”,回來的過程叫“歸”。基本上,所有的遞歸問題都可以用遞推公式來表示。我們用遞推公式將

    它表示出來就是這樣的

    f ( n ) = f (n – 1) + 1 其中,f ( 1 ) = 1

    f(n)表示你想知道自己在哪一排,f(n-1)表示前面一排所在的排數,f(1)=1表示第一排的人知道自己在

    第一排。有了這個遞推公式,我們就可以很輕鬆地將它改為遞歸代碼,如下:

    int f(int n) {
      if (n == 1) return 1;
      return f(n-1) + 1;
    }

    女朋友不懂遞歸,於是我給她講遞歸需要滿足的三個條件:

    1.一個問題的解可以分解為幾個子問題的解

    何為子問題?子問題就是數據規模更小的問題。就好比,在電影院,你要知道,“自己在哪一排”的問

    題,可以分解為“前一排的人在哪一排”這樣一個子問題。

    2.這個問題與分解之後的子問題,除了數據規模不同,求解思路完全一樣

    你求解“自己在哪一排”的思路,和前面一排人求解“自己在哪一排”的思路,是一模一樣的。

    3.存在遞歸終止條件

    把問題分解為子問題,把子問題再分解為子子問題,一層一層分解下去,不能存在無限循環,這就需

    要有終止條件。就好比,第一排的人不需要再繼續詢問任何人,就知道自己在哪一排,也就是

    f(1)=1,這就是遞歸的終止條件。

    如何教女友敲遞歸代碼?

    剛剛鋪墊了這麼多,現在我們來看,如何來教女友敲遞歸代碼?個人覺得,寫遞歸代碼最關鍵的是寫

    出遞推公式,找到終止條件,剩下將遞推公式轉化為代碼就很簡單了。

    你先記住這個理論。我舉一個例子,帶你一步一步實現一個遞歸代碼,幫你理解。

    假如這裡有n個台階,每次你可以跨1個台階或者2個台階,請問走這n個台階有多少種走法?如果有7個台階,你可以2,2,2,1這樣子上去,也可以1,2,1,1,2這樣子上去,總之走法有很多,那如何用編程求得總共有多少種走法呢?

    我們仔細想下,實際上,可以根據第一步的走法把所有走法分為兩類,第一類是第一步走了1個台

    階,另一類是第一步走了2個台階。所以n個台階的走法就等於先走1階后,n-1個台階的走法 加上先

    走2階后,n-2個台階的走法。用公式表示就是:

    f ( n ) = f (n – 1) + f ( n – 2 )

    有了遞推公式,遞歸代碼基本上就完成了一半。我們再來看下終止條件。當有一個台階時,我們不需

    要再繼續遞歸,就只有一種走法。所以f(1)=1。這個遞歸終止條件足夠嗎?我們可以用n=2,n=3這樣

    比較小的數試驗一下。

    n=2時,f(2)=f(1)+f(0)。如果遞歸終止條件只有一個f(1)=1,那f(2)就無法求解了。所以除了f(1)=1這一

    個遞歸終止條件外,還要有f(0)=1,表示走0個台階有一種走法,不過這樣子看起來就不符合正常的

    邏輯思維了。所以,我們可以把f(2)=2作為一種終止條件,表示走2個台階,有兩種走法,一步走完

    或者分兩步來走。

    所以,遞歸終止條件就是f(1)=1,f(2)=2。這個時候,你可以再拿n=3,n=4來驗證一下,這個終止條

    件是否足夠並且正確。

    我們把遞歸終止條件和剛剛得到的遞推公式放到一起就是這樣的:

    f(1) = 1;
    f(2) = 2;
    f(n) = f(n-1)+f(n-2)

    有了這個公式,我們轉化成遞歸代碼就簡單多了。最終的遞歸代碼是這樣的:

    int f(int n) {
      if (n == 1) return 1;
      if (n == 2) return 2;
      return f(n-1) + f(n-2);
    }

    我總結一下,寫遞歸代碼的關鍵就是找到如何將大問題分解為小問題的規律,並且基於此寫出遞推公式,然後再推敲終止條件,最後將遞推公式和終止條件翻譯成代碼。

    如果以後再遇到類似問題,A可以分解為若干子問題B、C、D情況,你可以假設子問題B、C、D已經

    解決,在此基礎上思考如何解決問題A。而且,你只需要思考問題A與子問題B、C、D兩層之間的關

    系即可,不需要一層一層往下思考子問題與子子問題,子子問題與子子子問題之間的關係。屏蔽掉遞

    歸細節,這樣子理解起來就簡單多了。

    因此,編寫遞歸代碼的關鍵是,只要遇到遞歸,我們就把它抽象成一個遞推公式,不用想一層層的調

    用關係,不要試圖用人腦去分解遞歸的每個步驟。

    如何教女友玩轉漢羅塔

    好了,講完了遞歸算法,再回到電影院,不說別的,我還真那麼做了,我真問了前面一排的人他是第

    幾排如果不清楚並讓他跟我一樣問他的上一排,顯然,沒循環到第三人,我差點被認為是神經病,差

    點沒被幾個社會精神小伙打si,座位事情暫時告一段落,話說這電影屬實夠無聊,於是我不知是趁熱

    打鐵,還是心血來潮,非要給女朋友玩一個漢羅塔遊戲,我這暴脾氣,剛實踐遞歸算法被懟,是時候

    挽回形象了,不秀一把遞歸算法我就不得勁。就是這個遊戲,至於遊戲規則,我覺得你體驗一兩把絕

    對比我說的更加記憶深刻,,別看4399覺得有點弱zhi,再怎麼說也承

    載着童年

    果然,女朋友是個哈皮,剛過第三關就撲街了,這個時候,頭冒五丈光芒的我身披金甲挺身而出(貌

    似有一點點小誇張,劇情需要嘛)一聲不吭地敲了幾行靚麗的代碼

    public class TestHanoi {
    
        public static void main(String[] args) {
            hanoi(5,'A','B','C');  //可以理解為5個圈或者第5關
        }
        
        /**
         * @param n     共有N個圈
         * @param A    開始的柱子
         * @param B 中間的柱子
         * @param C 目標的柱子
         * 無論有多少個圈,都認為只有兩個。上面的所有圈和最下面一個圈。
         */
        public static void hanoi(int n,char A,char B,char C) {
            //只有一個圈。
            if(n==1) {
                System.out.println("第1個盤子從"+A+"移到"+C);
            //無論有多少個圈,都認為只有兩個。上面的所有圈和最下面一個圈。
            }else {
                //移動上面所有的圈到中間位置
                hanoi(n-1,A,C,B);
                //移動下面的圈
                System.out.println("第"+n+"個圈從"+A+"移到"+C);
                //把上面的所有圈從中間位置移到目標位置
                hanoi(n-1,B,A,C);
            }
        }
    
    }

    只要main方法一致行,對着結果移動即可,就跟開了掛一樣的,其實漢羅塔問題核心關鍵是無論有多少個圈,都認為只有兩個。上面的所有圈和最下面一個圈。

    到這裏,教女友敲遞歸算法代碼,你學會了嗎?

    哦豁,明天還是一個晴天~老天賜給宜春一個女朋友吧~畢竟我們程序員長得又帥敲代碼又好看,是吧哥幾個~~

    如果本文對你有一點點幫助,那麼請點個讚唄,謝謝~

    最後,若有不足或者不正之處,歡迎指正批評,感激不盡!如果有疑問歡迎留言,絕對第一時間回復!

    歡迎各位關注我的公眾號,一起探討技術,嚮往技術,追求技術,說好了來了就是盆友喔…

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

  • [springboot 開發單體web shop] 7. 多種形式提供商品列表

    [springboot 開發單體web shop] 7. 多種形式提供商品列表

    上文回顧

    我們實現了仿jd的輪播廣告以及商品分類的功能,並且講解了不同的注入方式,本節我們將繼續實現我們的電商主業務,商品信息的展示。

    需求分析

    首先,在我們開始本節編碼之前,我們先來分析一下都有哪些地方會對商品進行展示,打開jd首頁,鼠標下拉可以看到如下:

    可以看到,在大類型下查詢了部分商品在首頁進行展示(可以是最新的,也可以是網站推薦等等),然後點擊任何一個分類,可以看到如下:

    我們一般進到電商網站之後,最常用的一個功能就是搜索, 結果如下:

    選擇任意一個商品點擊,都可以進入到詳情頁面,這個是單個商品的信息展示。
    綜上,我們可以知道,要實現一個電商平台的商品展示,最基本的包含:

    • 首頁推薦/最新上架商品
    • 分類查詢商品
    • 關鍵詞搜索商品
    • 商品詳情展示
    • …

    接下來,我們就可以開始商品相關的業務開發了。

    首頁商品列表|IndexProductList

    開發梳理

    我們首先來實現在首頁展示的推薦商品列表,來看一下都需要展示哪些信息,以及如何進行展示。

    • 商品主鍵(product_id)
    • 展示圖片(image_url)
    • 商品名稱(product_name)
    • 商品價格(product_price)
    • 分類說明(description)
    • 分類名稱(category_name)
    • 分類主鍵(category_id)
    • 其他…

    編碼實現

    根據一級分類查詢

    遵循開發順序,自下而上,如果基礎mapper解決不了,那麼優先編寫SQL mapper,因為我們需要在同一張表中根據parent_id遞歸的實現數據查詢,當然我們這裏使用的是錶鏈接的方式實現。因此,common mapper無法滿足我們的需求,需要自定義mapper實現。

    Custom Mapper實現

    和根據一級分類查詢子分類一樣,在項目mscx-shop-mapper中添加一個自定義實現接口com.liferunner.custom.ProductCustomMapper,然後在resources\mapper\custom路徑下同步創建xml文件mapper/custom/ProductCustomMapper.xml,此時,因為我們在上節中已經配置了當前文件夾可以被容器掃描到,所以我們添加的新的mapper就會在啟動時被掃描加載,代碼如下:

    /**
     * ProductCustomMapper for : 自定義商品Mapper
     */
    public interface ProductCustomMapper {
    
        /***
         * 根據一級分類查詢商品
         *
         * @param paramMap 傳遞一級分類(map傳遞多參數)
         * @return java.util.List<com.liferunner.dto.IndexProductDTO>
         */
        List<IndexProductDTO> getIndexProductDtoList(@Param("paramMap") Map<String, Integer> paramMap);
    }
    <?xml version="1.0" encoding="UTF-8"?>
    <!DOCTYPE mapper PUBLIC "-//mybatis.org//DTD Mapper 3.0//EN" "http://mybatis.org/dtd/mybatis-3-mapper.dtd">
    <mapper namespace="com.liferunner.custom.ProductCustomMapper">
        <resultMap id="IndexProductDTO" type="com.liferunner.dto.IndexProductDTO">
            <id column="rootCategoryId" property="rootCategoryId"/>
            <result column="rootCategoryName" property="rootCategoryName"/>
            <result column="slogan" property="slogan"/>
            <result column="categoryImage" property="categoryImage"/>
            <result column="bgColor" property="bgColor"/>
            <collection property="productItemList" ofType="com.liferunner.dto.IndexProductItemDTO">
                <id column="productId" property="productId"/>
                <result column="productName" property="productName"/>
                <result column="productMainImageUrl" property="productMainImageUrl"/>
                <result column="productCreateTime" property="productCreateTime"/>
            </collection>
        </resultMap>
        <select id="getIndexProductDtoList" resultMap="IndexProductDTO" parameterType="Map">
            SELECT
            c.id as rootCategoryId,
            c.name as rootCategoryName,
            c.slogan as slogan,
            c.category_image as categoryImage,
            c.bg_color as bgColor,
            p.id as productId,
            p.product_name as productName,
            pi.url as productMainImageUrl,
            p.created_time as productCreateTime
            FROM category c
            LEFT JOIN products p
            ON c.id = p.root_category_id
            LEFT JOIN products_img pi
            ON p.id = pi.product_id
            WHERE c.type = 1
            AND p.root_category_id = #{paramMap.rootCategoryId}
            AND pi.is_main = 1
            LIMIT 0,10;
        </select>
    </mapper>

    Service實現

    在serviceproject 創建com.liferunner.service.IProductService接口以及其實現類com.liferunner.service.impl.ProductServiceImpl,添加查詢方法如下:

    public interface IProductService {
    
        /**
         * 根據一級分類id獲取首頁推薦的商品list
         *
         * @param rootCategoryId 一級分類id
         * @return 商品list
         */
        List<IndexProductDTO> getIndexProductDtoList(Integer rootCategoryId);
        ...
    }
    
    ---
        
    @Slf4j
    @Service
    @RequiredArgsConstructor(onConstructor = @__(@Autowired))
    public class ProductServiceImpl implements IProductService {
    
        // RequiredArgsConstructor 構造器注入
        private final ProductCustomMapper productCustomMapper;
    
        @Transactional(propagation = Propagation.SUPPORTS)
        @Override
        public List<IndexProductDTO> getIndexProductDtoList(Integer rootCategoryId) {
            log.info("====== ProductServiceImpl#getIndexProductDtoList(rootCategoryId) : {}=======", rootCategoryId);
            Map<String, Integer> map = new HashMap<>();
            map.put("rootCategoryId", rootCategoryId);
            val indexProductDtoList = this.productCustomMapper.getIndexProductDtoList(map);
            if (CollectionUtils.isEmpty(indexProductDtoList)) {
                log.warn("ProductServiceImpl#getIndexProductDtoList未查詢到任何商品信息");
            }
            log.info("查詢結果:{}", indexProductDtoList);
            return indexProductDtoList;
        }
    }

    Controller實現

    接着,在com.liferunner.api.controller.IndexController中實現對外暴露的查詢接口:

    @RestController
    @RequestMapping("/index")
    @Api(value = "首頁信息controller", tags = "首頁信息接口API")
    @Slf4j
    public class IndexController {
        ...
        @Autowired
        private IProductService productService;
    
        @GetMapping("/rootCategorys")
        @ApiOperation(value = "查詢一級分類", notes = "查詢一級分類")
        public JsonResponse findAllRootCategorys() {
            log.info("============查詢一級分類==============");
            val categoryResponseDTOS = this.categoryService.getAllRootCategorys();
            if (CollectionUtils.isEmpty(categoryResponseDTOS)) {
                log.info("============未查詢到任何分類==============");
                return JsonResponse.ok(Collections.EMPTY_LIST);
            }
            log.info("============一級分類查詢result:{}==============", categoryResponseDTOS);
            return JsonResponse.ok(categoryResponseDTOS);
        }
        ...
    }

    Test API

    編寫完成之後,我們需要對我們的代碼進行測試驗證,還是通過使用RestService插件來實現,當然,大家也可以通過Postman來測試,結果如下:

    商品列表|ProductList

    如開文之初我們看到的京東商品列表一樣,我們先分析一下在商品列表頁面都需要哪些元素信息?

    開發梳理

    商品列表的展示按照我們之前的分析,總共分為2大類:

    • 選擇商品分類之後,展示當前分類下所有商品
    • 輸入搜索關鍵詞后,展示當前搜索到相關的所有商品

    在這兩類中展示的商品列表數據,除了數據來源不同以外,其他元素基本都保持一致,那麼我們是否可以使用統一的接口來根據參數實現隔離呢? 理論上不存在問題,完全可以通過傳參判斷的方式進行數據回傳,但是,在我們實現一些可預見的功能需求時,一定要給自己的開發預留後路,也就是我們常說的可拓展性,基於此,我們會分開實現各自的接口,以便於後期的擴展。
    接着來分析在列表頁中我們需要展示的元素,首先因為需要分上述兩種情況,因此我們需要在我們API設計的時候分別處理,針對於
    1.分類的商品列表展示,需要傳入的參數有:

    • 分類id
    • 排序(在電商列表我們常見的幾種排序(銷量,價格等等))
    • 分頁相關(因為我們不可能把數據庫中所有的商品都取出來)
      • PageNumber(當前第幾頁)
      • PageSize(每頁显示多少條數據)

    2.關鍵詞查詢商品列表,需要傳入的參數有:

    • 關鍵詞
    • 排序(在電商列表我們常見的幾種排序(銷量,價格等等))
    • 分頁相關(因為我們不可能把數據庫中所有的商品都取出來)
      • PageNumber(當前第幾頁)
      • PageSize(每頁显示多少條數據)

    需要在頁面展示的信息有:

    • 商品id(用於跳轉商品詳情使用)
    • 商品名稱
    • 商品價格
    • 商品銷量
    • 商品圖片
    • 商品優惠
    • …

    編碼實現

    根據上面我們的分析,接下來開始我們的編碼:

    根據商品分類查詢

    根據我們的分析,肯定不會在一張表中把所有數據獲取全,因此我們需要進行多表聯查,故我們需要在自定義mapper中實現我們的功能查詢.

    ResponseDTO 實現

    根據我們前面分析的前端需要展示的信息,我們來定義一個用於展示這些信息的對象com.liferunner.dto.SearchProductDTO,代碼如下:

    @Data
    @NoArgsConstructor
    @AllArgsConstructor
    @Builder
    public class SearchProductDTO {
        private String productId;
        private String productName;
        private Integer sellCounts;
        private String imgUrl;
        private Integer priceDiscount;
        //商品優惠,我們直接計算之後返回優惠后價格
    }

    Custom Mapper 實現

    在com.liferunner.custom.ProductCustomMapper.java中新增一個方法接口:

        List<SearchProductDTO> searchProductListByCategoryId(@Param("paramMap") Map<String, Object> paramMap);

    同時,在mapper/custom/ProductCustomMapper.xml中實現我們的查詢方法:

    <select id="searchProductListByCategoryId" resultType="com.liferunner.dto.SearchProductDTO" parameterType="Map">
            SELECT
            p.id as productId,
            p.product_name as productName,
            p.sell_counts as sellCounts,
            pi.url as imgUrl,
            tp.priceDiscount
            FROM products p
            LEFT JOIN products_img pi
            ON p.id = pi.product_id
            LEFT JOIN
            (
            SELECT product_id, MIN(price_discount) as priceDiscount
            FROM products_spec
            GROUP BY product_id
            ) tp
            ON tp.product_id = p.id
            WHERE pi.is_main = 1
            AND p.category_id = #{paramMap.categoryId}
            ORDER BY
            <choose>
                <when test="paramMap.sortby != null and paramMap.sortby == 'sell'">
                    p.sell_counts DESC
                </when>
                <when test="paramMap.sortby != null and paramMap.sortby == 'price'">
                    tp.priceDiscount ASC
                </when>
                <otherwise>
                    p.created_time DESC
                </otherwise>
            </choose>
        </select>

    主要來說明一下這裏的<choose>模塊,以及為什麼不使用if標籤。
    在有的時候,我們並不希望所有的條件都同時生效,而只是想從多個選項中選擇一個,但是在使用IF標籤時,只要test中的表達式為 true,就會執行IF 標籤中的條件。MyBatis 提供了 choose 元素。IF標籤是與(and)的關係,而 choose 是或(or)的關係。
    它的選擇是按照順序自上而下,一旦有任何一個滿足條件,則選擇退出。

    Service 實現

    然後在servicecom.liferunner.service.IProductService中添加方法接口:

        /**
         * 根據商品分類查詢商品列表
         *
         * @param categoryId 分類id
         * @param sortby     排序方式
         * @param pageNumber 當前頁碼
         * @param pageSize   每頁展示多少條數據
         * @return 通用分頁結果視圖
         */
        CommonPagedResult searchProductList(Integer categoryId, String sortby, Integer pageNumber, Integer pageSize);

    在實現類com.liferunner.service.impl.ProductServiceImpl中,實現上述方法:

        // 方法重載
        @Override
        public CommonPagedResult searchProductList(Integer categoryId, String sortby, Integer pageNumber, Integer pageSize) {
            Map<String, Object> paramMap = new HashMap<>();
            paramMap.put("categoryId", categoryId);
            paramMap.put("sortby", sortby);
            // mybatis-pagehelper
            PageHelper.startPage(pageNumber, pageSize);
            val searchProductDTOS = this.productCustomMapper.searchProductListByCategoryId(paramMap);
            // 獲取mybatis插件中獲取到信息
            PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);
            // 封裝為返回到前端分頁組件可識別的視圖
            val commonPagedResult = CommonPagedResult.builder()
                    .pageNumber(pageNumber)
                    .rows(searchProductDTOS)
                    .totalPage(pageInfo.getPages())
                    .records(pageInfo.getTotal())
                    .build();
            return commonPagedResult;
        }

    在這裏,我們使用到了一個mybatis-pagehelper插件,會在下面的福利講解中分解。

    Controller 實現

    繼續在com.liferunner.api.controller.ProductController中添加對外暴露的接口API:

    @GetMapping("/searchByCategoryId")
        @ApiOperation(value = "查詢商品信息列表", notes = "根據商品分類查詢商品列表")
        public JsonResponse searchProductListByCategoryId(
            @ApiParam(name = "categoryId", value = "商品分類id", required = true, example = "0")
            @RequestParam Integer categoryId,
            @ApiParam(name = "sortby", value = "排序方式", required = false)
            @RequestParam String sortby,
            @ApiParam(name = "pageNumber", value = "當前頁碼", required = false, example = "1")
            @RequestParam Integer pageNumber,
            @ApiParam(name = "pageSize", value = "每頁展示記錄數", required = false, example = "10")
            @RequestParam Integer pageSize
        ) {
            if (null == categoryId || categoryId == 0) {
                return JsonResponse.errorMsg("分類id錯誤!");
            }
            if (null == pageNumber || 0 == pageNumber) {
                pageNumber = DEFAULT_PAGE_NUMBER;
            }
            if (null == pageSize || 0 == pageSize) {
                pageSize = DEFAULT_PAGE_SIZE;
            }
            log.info("============根據分類:{} 搜索列表==============", categoryId);
    
            val searchResult = this.productService.searchProductList(categoryId, sortby, pageNumber, pageSize);
            return JsonResponse.ok(searchResult);
        }

    因為我們的請求中,只會要求商品分類id是必填項,其餘的調用方都可以不提供,但是如果不提供的話,我們系統就需要給定一些默認的參數來保證我們的系統正常穩定的運行,因此,我定義了com.liferunner.api.controller.BaseController,用於存儲一些公共的配置信息。

    /**
     * BaseController for : controller 基類
     */
    @Controller
    public class BaseController {
        /**
         * 默認展示第1頁
         */
        public final Integer DEFAULT_PAGE_NUMBER = 1;
        /**
         * 默認每頁展示10條數據
         */
        public final Integer DEFAULT_PAGE_SIZE = 10;
    }

    Test API

    測試的參數分別是:categoryId : 51 ,sortby : price,pageNumber : 1,pageSize : 5

    可以看到,我們查詢到7條數據,總頁數totalPage為2,並且根據價格從小到大進行了排序,證明我們的編碼是正確的。接下來,通過相同的代碼邏輯,我們繼續實現根據搜索關鍵詞進行查詢。

    根據關鍵詞查詢

    Response DTO 實現

    使用上面實現的com.liferunner.dto.SearchProductDTO.

    Custom Mapper 實現

    在com.liferunner.custom.ProductCustomMapper中新增方法:

    List<SearchProductDTO> searchProductList(@Param("paramMap") Map<String, Object> paramMap);

    在mapper/custom/ProductCustomMapper.xml中添加查詢SQL:

    <select id="searchProductList" resultType="com.liferunner.dto.SearchProductDTO" parameterType="Map">
            SELECT
            p.id as productId,
            p.product_name as productName,
            p.sell_counts as sellCounts,
            pi.url as imgUrl,
            tp.priceDiscount
            FROM products p
            LEFT JOIN products_img pi
            ON p.id = pi.product_id
            LEFT JOIN
            (
            SELECT product_id, MIN(price_discount) as priceDiscount
            FROM products_spec
            GROUP BY product_id
            ) tp
            ON tp.product_id = p.id
            WHERE pi.is_main = 1
            <if test="paramMap.keyword != null and paramMap.keyword != ''">
                AND p.item_name LIKE "%${paramMap.keyword}%"
            </if>
            ORDER BY
            <choose>
                <when test="paramMap.sortby != null and paramMap.sortby == 'sell'">
                    p.sell_counts DESC
                </when>
                <when test="paramMap.sortby != null and paramMap.sortby == 'price'">
                    tp.priceDiscount ASC
                </when>
                <otherwise>
                    p.created_time DESC
                </otherwise>
            </choose>
        </select>

    Service 實現

    在com.liferunner.service.IProductService中新增查詢接口:

        /**
         * 查詢商品列表
         *
         * @param keyword    查詢關鍵詞
         * @param sortby     排序方式
         * @param pageNumber 當前頁碼
         * @param pageSize   每頁展示多少條數據
         * @return 通用分頁結果視圖
         */
        CommonPagedResult searchProductList(String keyword, String sortby, Integer pageNumber, Integer pageSize);

    在com.liferunner.service.impl.ProductServiceImpl實現上述接口方法:

        @Override
        public CommonPagedResult searchProductList(String keyword, String sortby, Integer pageNumber, Integer pageSize) {
            Map<String, Object> paramMap = new HashMap<>();
            paramMap.put("keyword", keyword);
            paramMap.put("sortby", sortby);
            // mybatis-pagehelper
            PageHelper.startPage(pageNumber, pageSize);
            val searchProductDTOS = this.productCustomMapper.searchProductList(paramMap);
            // 獲取mybatis插件中獲取到信息
            PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);
            // 封裝為返回到前端分頁組件可識別的視圖
            val commonPagedResult = CommonPagedResult.builder()
                    .pageNumber(pageNumber)
                    .rows(searchProductDTOS)
                    .totalPage(pageInfo.getPages())
                    .records(pageInfo.getTotal())
                    .build();
            return commonPagedResult;
        }

    上述方法和之前searchProductList(Integer categoryId, String sortby, Integer pageNumber, Integer pageSize)唯一的區別就是它是肯定搜索關鍵詞來進行數據查詢,使用重載的目的是為了我們後續不同類型的業務擴展而考慮的。

    Controller 實現

    在com.liferunner.api.controller.ProductController中添加關鍵詞搜索API:

        @GetMapping("/search")
        @ApiOperation(value = "查詢商品信息列表", notes = "查詢商品信息列表")
        public JsonResponse searchProductList(
            @ApiParam(name = "keyword", value = "搜索關鍵詞", required = true)
            @RequestParam String keyword,
            @ApiParam(name = "sortby", value = "排序方式", required = false)
            @RequestParam String sortby,
            @ApiParam(name = "pageNumber", value = "當前頁碼", required = false, example = "1")
            @RequestParam Integer pageNumber,
            @ApiParam(name = "pageSize", value = "每頁展示記錄數", required = false, example = "10")
            @RequestParam Integer pageSize
        ) {
            if (StringUtils.isBlank(keyword)) {
                return JsonResponse.errorMsg("搜索關鍵詞不能為空!");
            }
            if (null == pageNumber || 0 == pageNumber) {
                pageNumber = DEFAULT_PAGE_NUMBER;
            }
            if (null == pageSize || 0 == pageSize) {
                pageSize = DEFAULT_PAGE_SIZE;
            }
            log.info("============根據關鍵詞:{} 搜索列表==============", keyword);
    
            val searchResult = this.productService.searchProductList(keyword, sortby, pageNumber, pageSize);
            return JsonResponse.ok(searchResult);
        }

    Test API

    測試參數:keyword : 西鳳,sortby : sell,pageNumber : 1,pageSize : 10

    根據銷量排序正常,查詢關鍵詞正常,總條數32,每頁10條,總共3頁正常。

    福利講解

    在本節編碼實現中,我們使用到了一個通用的mybatis分頁插件mybatis-pagehelper,接下來,我們來了解一下這個插件的基本情況。

    mybatis-pagehelper

    如果各位小夥伴使用過:, 那麼對於這個就很容易理解了,它其實就是基於來實現的,當攔截到原始SQL之後,對SQL進行一次改造處理。
    我們來看看我們自己代碼中的實現,根據springboot編碼三部曲:

    1.添加依賴

            <!-- 引入mybatis-pagehelper 插件-->
            <dependency>
                <groupId>com.github.pagehelper</groupId>
                <artifactId>pagehelper-spring-boot-starter</artifactId>
                <version>1.2.12</version>
            </dependency>

    有同學就要問了,為什麼引入的這個依賴和我原來使用的不同?以前使用的是:

    <dependency>
        <groupId>com.github.pagehelper</groupId>
        <artifactId>pagehelper</artifactId>
        <version>5.1.10</version>
    </dependency>

    答案就在這裏:

    我們使用的是springboot進行的項目開發,既然使用的是springboot,那我們完全可以用到它的自動裝配特性,作者幫我們實現了這麼一個,我們只需要參考示例來編寫就ok了。

    2.改配置

    # mybatis 分頁組件配置
    pagehelper:
      helperDialect: mysql #插件支持12種數據庫,選擇類型
      supportMethodsArguments: true

    3.改代碼

    如下示例代碼:

        @Override
        public CommonPagedResult searchProductList(String keyword, String sortby, Integer pageNumber, Integer pageSize) {
            Map<String, Object> paramMap = new HashMap<>();
            paramMap.put("keyword", keyword);
            paramMap.put("sortby", sortby);
            // mybatis-pagehelper
            PageHelper.startPage(pageNumber, pageSize);
            val searchProductDTOS = this.productCustomMapper.searchProductList(paramMap);
            // 獲取mybatis插件中獲取到信息
            PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);
            // 封裝為返回到前端分頁組件可識別的視圖
            val commonPagedResult = CommonPagedResult.builder()
                    .pageNumber(pageNumber)
                    .rows(searchProductDTOS)
                    .totalPage(pageInfo.getPages())
                    .records(pageInfo.getTotal())
                    .build();
            return commonPagedResult;
        }

    在我們查詢數據庫之前,我們引入了一句PageHelper.startPage(pageNumber, pageSize);,告訴mybatis我們要對查詢進行分頁處理,這個時候插件會啟動一個攔截器com.github.pagehelper.PageInterceptor,針對所有的query進行攔截,添加自定義參數和添加查詢數據總數。(後續我們會打印sql來證明。)

    當查詢到結果之後,我們需要將我們查詢到的結果通知給插件,也就是PageInfo<?> pageInfo = new PageInfo<>(searchProductDTOS);(com.github.pagehelper.PageInfo是對插件針對分頁做的一個屬性包裝,具體可以查看)。

    至此,我們的插件使用就已經結束了。但是為什麼我們在後面又封裝了一個對象來對外進行返回,而不是使用查詢到的PageInfo呢?這是因為我們實際開發過程中,為了數據結構的一致性做的一次結構封裝,你也可不實現該步驟,都是對結果沒有任何影響的。

    SQL打印對比

    2019-11-21 12:04:21 INFO  ProductController:134 - ============根據關鍵詞:西鳳 搜索列表==============
    Creating a new SqlSession
    SqlSession [org.apache.ibatis.session.defaults.DefaultSqlSession@4ff449ba] was not registered for synchronization because synchronization is not active
    JDBC Connection [HikariProxyConnection@1980420239 wrapping com.mysql.cj.jdbc.ConnectionImpl@563b22b1] will not be managed by Spring
    ==>  Preparing: SELECT count(0) FROM products p LEFT JOIN products_img pi ON p.id = pi.product_id LEFT JOIN (SELECT product_id, MIN(price_discount) AS priceDiscount FROM products_spec GROUP BY product_id) tp ON tp.product_id = p.id WHERE pi.is_main = 1 AND p.product_name LIKE "%西鳳%" 
    ==> Parameters: 
    <==    Columns: count(0)
    <==        Row: 32
    <==      Total: 1
    ==>  Preparing: SELECT p.id as productId, p.product_name as productName, p.sell_counts as sellCounts, pi.url as imgUrl, tp.priceDiscount FROM product p LEFT JOIN products_img pi ON p.id = pi.product_id LEFT JOIN ( SELECT product_id, MIN(price_discount) as priceDiscount FROM products_spec GROUP BY product_id ) tp ON tp.product_id = p.id WHERE pi.is_main = 1 AND p.product_name LIKE "%西鳳%" ORDER BY p.sell_counts DESC LIMIT ? 
    ==> Parameters: 10(Integer)

    我們可以看到,我們的SQL中多了一個SELECT count(0),第二條SQL多了一個LIMIT參數,在代碼中,我們很明確的知道,我們並沒有显示的去搜索總數和查詢條數,可以確定它就是插件幫我們實現的。

    源碼下載

    下節預告

    下一節我們將繼續開發商品詳情展示以及商品評價業務,在過程中使用到的任何開發組件,我都會通過專門的一節來進行介紹的,兄弟們末慌!

    gogogo!

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • 五分鐘學會HTML5的WebSocket協議

    五分鐘學會HTML5的WebSocket協議

    1、背景

      很多網站為了實現推送技術,所用的技術都是Ajax輪詢。輪詢是在特定的的時間間隔由瀏覽器對服務器發出HTTP請求,然後由服務器返回最新的數據給客戶端的瀏覽器。這種傳統的模式帶來很明顯的缺點,即瀏覽器需要不斷的向服務器發出請求,然而HTTP請求可能包含較長的頭部,其中真正有效的數據可能只是很小的一部分,顯然這樣會浪費很多的帶寬等資源。HTML5新增的一些新協議WebSocket,可以提供在單個TCP連接上提供全雙工,雙向通信,能夠節省服務器資源和帶寬,並且能夠實時進行通信。

    2、WebSocket介紹

      傳統的http也是一種協議,WebSocket是一種協議,使用http服務器無法實現WebSocket,

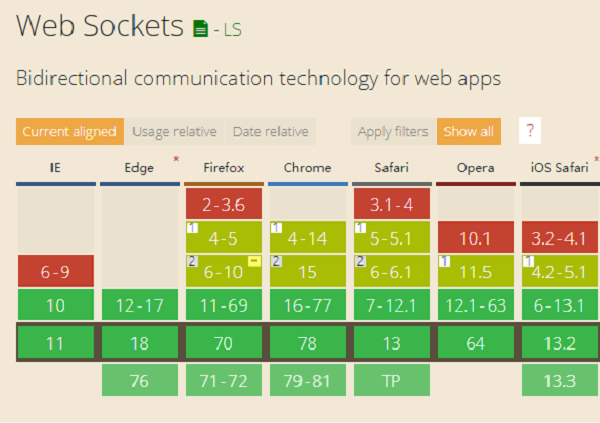
    2.1.瀏覽器支持情況

    基本主流瀏覽器都支持

    2.2.優點

    相對於http有如下好處:

    • 1.客戶端與服務器只建立一個TCP連接,可以使用更少的連接。
    • 2.WebSocket服務器端可以主動推送數據到客戶端,更靈活高效。
    • 3.更輕量級的協議頭,減少數據傳送量。

    對比輪訓機制

    3、WebSocket用法

      我們了解WebSocket是什麼,有哪些優點后,怎麼使用呢?

    3.1.WebSocket創建

    WebSocket使用了自定義協議,url模式與http略有不同,未加密的連接是ws://,加密的連接是wss://,WebSocket實例使用new WebSocket()方法來創建,

    var ws = new WebSocket(url, [protocol] );

    第一個參數 url, 指定連接的 URL。第二個參數 protocol 是可選的,指定了可接受的子協議。

    3.2.WebSocket屬性

    當創建ws對象后,readyState為ws實例狀態,共4種狀態

    • 0 表示連接尚未建立。

    • 1 表示連接已建立,可以進行通信。

    • 2 表示連接正在進行關閉。

    • 3 表示連接已經關閉或者連接不能打開。

    Tips:在發送報文之前要判斷狀態,斷開也應該有重連機制。

    3.3.WebSocket事件

    在創建ws實例對象后,會擁有以下幾個事件,根據不同狀態可在事件回調寫方法。

    • ws.onopen 連接建立時觸發

    • ws.onmessage 客戶端接收服務端數據時觸發

    • ws.onerror 通信發生錯誤時觸發

    • ws.onclose 連接關閉時觸發

    ws.onmessage = (res) => {
      console.log(res.data);
    };
    
    ws.onopen = () => {
      console.log('OPEN...');
    };
    
    ws.onclose=()=>{
     console.log('CLOSE...');
    }

    3.4.WebSocket方法

    • ws.send() 使用連接發送數據(只能發送純文本數據)

    • ws.close() 關閉連接

    4、Demo演示

      了解WebSocket的一些API之後,趁熱打鐵,做一個小案例跑一下。

    4.1.Node服務器端

    WebSocket協議與Node一起用非常好,原因有以下兩點:

    1.WebSocket客戶端基於事件編程與Node中自定義事件差不多。

    2.WebSocket實現客戶端與服務器端長連接,Node基本事件驅動的方式十分適合高併發連接

    創建一個webSocket.js如下:

    const WebSocketServer = require('ws').Server;
    const wss = new WebSocketServer({ port: 8080 });
    wss.on('connection', function (ws) {
        console.log('client connected');
        ws.on('message', function (message) {
            ws.send('我收到了' + message);
        });
    });

    打開windows命令窗口運行

    4.2.HTML客戶端

    新建一個index.html頁面

    <!DOCTYPE html>
    <html lang="en">
    <head>
        <meta charset="UTF-8">
        <title>webSocket小Demo</title>
    </head>
    <body>
        <div class="container">
            <div>
                <input type="text" id="msg">
                <button onclick="sendMsg()">發送報文</button>
            </div>
        </div>
        <script>
            const ws = new WebSocket('ws://localhost:8080');
            ws.onmessage = (res) => {
                console.log(res);
            };
            ws.onopen = () => {
                console.log('OPEN...');
            };
            ws.onclose = () => {
                console.log('CLOSE...');
            }
            function sendMsg() {
                let msg = document.getElementById('msg').value;
                ws.send(msg);
            }
        </script>
    </body>

    打開瀏覽器依次輸入字符1,2,3,每次輸入完點擊發送報體,可見在ws.onmessage事件中res.data中返回來我們發的報文

    5、問題與總結

      以上只是簡單的介紹了下WebSocket的API與簡單用法,在處理高併發,長連接這些需求上,例如聊天室,可能WebSocket的http請求更加合適高效。

       但在使用WebSocket過程中發現容易斷開連接等問題,所以在每次發送報文前要判斷是否斷開,當多次發送報文時,由於服務器端返回數據量不同,返回客戶端前後順序也不同,所以需要在客戶端收到上一個報文返回數據后再發送下一個報文,為了避免回調嵌套過多,通過Promise ,async ,await等同步方式解決。關於WebSocket就寫這麼多,如有不足,歡迎多多指正!

    參考資料:
    《JavaScript高級教程》
    《深入檢出NodeJs》

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

  • 【python測試開發棧】帶你徹底搞明白python3編碼原理

    【python測試開發棧】帶你徹底搞明白python3編碼原理

    在之前的文章中,我們介紹過編碼格式的發展史:[文章傳送門-todo]。今天我們通過幾個例子,來徹底搞清楚python3中的編碼格式原理,這樣你之後寫python腳本時碰到編碼問題,才能有章可循。

    我們先搞清楚幾個概念:

    • 系統默認編碼:指python解釋器默認的編碼格式,在python文件頭部沒有聲明其他編碼格式時,python3默認的編碼格式是utf-8。
    • 本地默認編碼:操作系統默認的編碼,常見的Windows的默認編碼是gbk,Linux的默認編碼是UTF-8。
    • python文件頭部聲明編碼格式:修改的是文件的默認編碼格式,只是會影響python解釋器讀取python文件時的編碼格式,並不會改變系統默認編碼和本地默認編碼。

    通過python自帶的庫,可以查看系統默認編碼和本地默認編碼

    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> import sys
    >>> sys.getdefaultencoding()
    'utf-8'
    >>> import locale
    >>> locale.getdefaultlocale()
    ('zh_CN', 'cp936')
    >>>

    注意,因為我在windows系統的電腦上 進行測試,所以系統默認編碼返回“cp936”, 這是代碼頁(是字符編碼集的別名),而936對應的就是gbk。如果你在linux或者mac上執行上面的代碼,應該會返回utf-8編碼。

    其實總結來看,容易出現亂碼的場景,基本都與讀寫程序有關,比如:讀取/寫入某個文件,或者從網絡流中讀取數據等,因為這個過程中涉及到了編碼 和解碼的過程,只要編碼和解碼的編碼格式對應不上,就容易出現亂碼。下面我們舉兩個具體的例子,來驗證下python的編碼原理,幫助你理解這個過程。注意:下面的例子都是在pycharm中寫的。

    01默認的編碼格式

    我們新建一個encode_demo.py的文件,其文件默認的編碼格式是UTF-8(可以從pycharm右下角看到編碼格式),代碼如下:

    """
        @author: asus
        @time: 2019/11/21
        @function: 驗證編碼格式
    """
    import sys, locale
    
    
    def write_str_default_encode():
        s = "我是一個str"
        print(s)
        print(type(s))
        print(sys.getdefaultencoding())
        print(locale.getdefaultlocale())
    
        with open("utf_file", "w", encoding="utf-8") as f:
            f.write(s)
        with open("gbk_file", "w", encoding="gbk") as f:
            f.write(s)
        with open("jis_file", "w", encoding="shift-jis") as f:
            f.write(s)
    
    
    if __name__ == '__main__':
        write_str_default_encode()
    

    我們先來猜測下結果,因為我們沒有聲明編碼格式,所以python解釋器默認用UTF-8去解碼文件,因為文件默認編碼格式就是UTF-8,所以字符串s可以正常打印。同時以UTF-8編碼格式寫文件不會出現亂碼,而以gbk和shift-jis(日文編碼)寫文件會出現亂碼(這裏說明一點,我是用pycharm直接打開生成的文件查看的,編輯器默認編碼是UTF-8,如果在windows上用記事本打開則其默認編碼跟隨系統是GBK,gbk_file和utf_file均不會出現亂碼,只有jis_file是亂碼),我們運行看下結果:

    # 運行結果
    我是一個str
    <class 'str'>
    utf-8
    ('zh_CN', 'cp936')
    
    # 寫文件utf_file、gbk_file、jis_file文件內容分別是:
    我是一個str
    ����һ��str
    �䐥�꘢str

    和我們猜測的結果一致,下面我們做個改變,在文件頭部聲明個編碼格式,再來看看效果。

    02 python頭文件聲明編碼格式

    因為上面文件encode_demo.py的格式是UTF-8,那麼我們就將其變為gbk編碼。同樣的我們先來推測下結果,在pycharm中,在python文件頭部聲明編碼為gbk后(頭部加上 # coding=gbk ),文件的編碼格式變成gbk,同時python解釋器會用gbk去解碼encode_demo.py文件,所以運行結果應該和用UTF-8編碼時一樣。運行結果如下:

    # 運行結果
    我是一個str
    <class 'str'>
    utf-8
    ('zh_CN', 'cp936')
    
    # 寫文件utf_file、gbk_file、jis_file文件內容分別是:
    我是一個str
    ����һ��str
    �䐥�꘢str

    結果確實是一樣的,證明我們推論是正確的。接下來我們再做個嘗試,假如我們將(# coding=gbk)去掉(需要注意,在pycharm中將 # coding=gbk去掉,並不會改變文件的編碼格式,也就是說encode_demo.py還是gbk編碼),我們再運行一次看結果:

      File "D:/codespace/python/pythonObject/pythonSample/basic/encodeDemo/encode_demo.py", line 4
    SyntaxError: Non-UTF-8 code starting with '\xd1' in file D:/codespace/python/pythonObject/pythonSample/basic/encodeDemo/encode_demo.py on line 5, but no encoding declared; see http://python.org/dev/peps/pep-0263/ for details
    

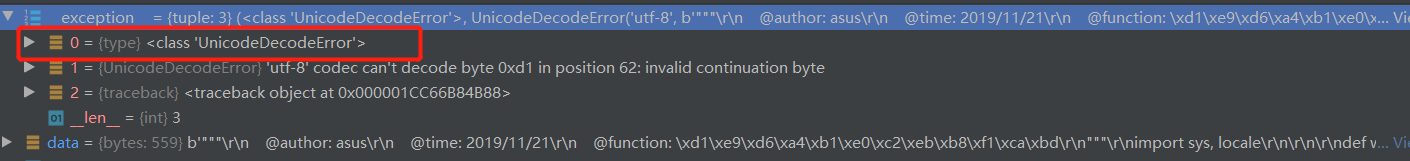
    運行直接報錯了,我們加個斷點,看看具體的異常信息:

    看錯誤提示是UnicodeDecodeError,python解釋器在對encode_demo.py文件解碼時,使用默認的UTF-8編碼,但是文件本身是gbk編碼,所以當碰到有中文沒辦法識別時,就拋出DecodeError。

    03 敲黑板,划重點

    python3中的str和bytes

    python3的重要特性之一就是對字符串和二進制流做了嚴格的區分,我們聲明的字符串都是str類型,不過Str和bytes是可以相互轉換的:

    def str_transfor_bytes():
        s = '我是一個測試Str'
        print(type(s))
        # str 轉bytes
        b = s.encode()
        print(b)
        print(type(b))
        # bytes轉str
        c = b.decode('utf-8')
        print(c)
        print(type(c))
    
    
    if __name__ == '__main__':
        str_transfor_bytes()

    需要注意一點:在調用encode()和decode()方法時,如果不傳參數,則會使用python解釋器默認的編碼格式UTF-8(如果不在python頭文件聲明編碼格式)。但是如果傳參的話,encode和decode使用的編碼格式要能對應上。

    python3默認編碼是UTF-8?還是Unicode?

    經常在很多文章里看到,python3的默認編碼格式是Unicode,但是我在本文中卻一直在說python3的默認編碼格式是UTF-8,那麼哪種說法是正確的呢?其實兩種說法都對,主要得搞清楚Unicode和UTF-8的區別(之前文章有提到):

    • Unicode是一個字符集,說白了就是把各種編碼的映射關係全都整合起來,不過它是不可變長的,全部都以兩個字節或四個字節來表示,佔用的內存空間比較大。
    • UTF-8是Unicode的一種實現方式,主要對 Unicode 碼的數據進行轉換,方便存儲和網絡傳輸 。它是可變長編碼,比如對於英文字母,它使用一個字節就可以表示。

    在python3內存中使用的字符串全都是Unicode碼,當python解釋器解析python文件時,默認使用UTF-8編碼。

    open()方法默認使用本地編碼

    在上面的例子中,我們往磁盤寫入文件時,都指定了編碼格式。如果不指定編碼格式,那麼默認將使用操作系統本地默認的編碼格式,比如:Linux默認是UTF-8,windows默認是GBK。其實這也好理解,因為和磁盤交互,肯定要考慮操作系統的編碼格式。這有區別於encode()和decode()使用的是python解釋器的默認編碼格式,千萬別搞混淆了。

    總結

    不知道你看完上面的例子后,是否已經徹底理解了python3的編碼原理。不過所有的編碼問題,都逃不過“編碼”和“解碼”兩個過程,當你碰到編碼問題時,先確定源文件使用的編碼,再確定目標文件需要的編碼格式,只要能匹配,一般就可以解決編碼的問題。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

  • 小白學 Python 爬蟲(2):前置準備(一)基本類庫的安裝

    小白學 Python 爬蟲(2):前置準備(一)基本類庫的安裝

    人生苦短,我用 Python

    前文傳送門:

    本篇內容較長,各位同學可以先收藏后再看~~

    在開始講爬蟲之前,還是先把環境搞搞好,工欲善其事必先利其器嘛~~~

    本篇文章主要介紹 Python 爬蟲所使用到的請求庫和解析庫,請求庫用來請求目標內容,解析庫用來解析請求回來的內容。

    開發環境

    首先介紹小編本地的開發環境:

    • Python3.7.4
    • win10

    差不多就這些,最基礎的環境,其他環境需要我們一個一個安裝,現在開始。

    請求庫

    雖然 Python 為我們內置了 HTTP 請求庫 urllib ,使用姿勢並不是很優雅,但是很多第三方的提供的 HTTP 庫確實更加的簡潔優雅,我們下面開始。

    Requests

    Requests 類庫是一個第三方提供的用於發送 HTTP 同步請求的類庫,相比較 Python 自帶的 urllib 類庫更加的方便和簡潔。

    Python 為我們提供了包管理工具 pip ,使用 pip 安裝將會非常的方便,安裝命令如下:

    pip install requests

    驗證:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> import requests

    首先在 CMD 命令行中輸入 python ,進入 python 的命令行模式,然後輸入 import requests 如果沒有任何錯誤提示,說明我們已經成功安裝 Requests 類庫。

    Selenium

    Selenium 現在更多的是用來做自動化測試工具,相關的書籍也不少,同時,我們也可以使用它來做爬蟲工具,畢竟是自動化測試么,利用它我們可以讓瀏覽器執行我們想要的動作,比如點擊某個按鈕、滾動滑輪之類的操作,這對我們模擬真實用戶操作是非常方便的。

    安裝命令如下:

    pip install selenium

    驗證:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> import selenium

    這樣沒報錯我們就安裝完成,但是你以為這樣就算好了么?圖樣圖森破啊。

    ChromeDriver

    我們還需要瀏覽器的支持來配合 selenium 的工作,開發人員嘛,常用的瀏覽器莫非那麼幾種:Chrome、Firefox,那位說 IE 的同學,你給我站起來,小心我跳起來打你膝蓋,還有說 360 瀏覽器的,你們可讓我省省心吧。

    接下來,安裝 Chrome 瀏覽器就不用講了吧。。。。

    再接下來,我們開始安裝 ChromeDriver ,安裝了 ChromeDriver 后,我們才能通過剛才安裝的 selenium 來驅動 Chrome 來完成各種騷操作。

    首先,我們需要查看自己的 Chrome 瀏覽器的版本,在 Chrome 瀏覽器右上角的三個點鐘,點擊 幫助 -> 關於,如下圖:

    將這個版本找個小本本記下來,小編這裏的版本為: 版本 78.0.3904.97(正式版本) (64 位)

    接下來我們需要去 ChromeDriver 的官網查看當前 Chrome 對應的驅動。

    官網地址:

    因某些原因,訪問時需某些手段,訪問不了的就看小編為大家準備的版本對應表格吧。。。

    ChromeDriver Version Chrome Version
    78.0.3904.11 78
    77.0.3865.40 77
    77.0.3865.10 77
    76.0.3809.126 76
    76.0.3809.68 76
    76.0.3809.25 76
    76.0.3809.12 76
    75.0.3770.90 75
    75.0.3770.8 75
    74.0.3729.6 74
    73.0.3683.68 73
    72.0.3626.69 72
    2.46 71-73
    2.45 70-72
    2.44 69-71
    2.43 69-71
    2.42 68-70
    2.41 67-69
    2.40 66-68
    2.39 66-68
    2.38 65-67
    2.37 64-66
    2.36 63-65
    2.35 62-64

    順便小編找到了國內對應的下載的鏡像站,由淘寶提供,如下:

    雖然和小編本地的小版本對不上,但是看樣子只要大版本符合應該沒啥問題,so,去鏡像站下載對應的版本即可,小編這裏下載的版本是:78.0.3904.70 ,ChromeDriver 78版本的最後一個小版本。

    下載完成后,將可執行文件 chromedriver.exe 移動至 Python 安裝目錄的 Scripts 目錄下。如果使用默認安裝未修改過安裝目錄的話目錄是:%homepath%\AppData\Local\Programs\Python\Python37\Scripts ,如果有過修改,那就自力更生吧。。。

    將 chromedriver.exe 添加后結果如下圖:

    驗證:

    還是在 CMD 命令行中,輸入以下內容:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> from selenium import webdriver
    >>> browser = webdriver.Chrome()

    如果打開一個空白的 Chrome 頁面說明安裝成功。

    GeckoDriver

    上面我們通過安裝 Chrome 的驅動完成了 Selenium 與 Chrome 的對接,想要完成 Selenium 與 FireFox 的對接則需要安裝另一個驅動 GeckoDriver 。

    FireFox 的安裝小編這裏就不介紹了,大家最好去官網下載安裝,路徑如下:

    FireFox 官網地址:

    GeckoDriver 的下載需要去 Github (全球最大的同性交友網站),下載路徑小編已經找好了,可以選擇最新的 releases 版本進行下載。

    下載地址:

    選擇對應自己的環境,小編這裏選擇 win-64 ,版本為 v0.26.0 進行下載。

    具體配置方式和上面一樣,將可執行的 .exe 文件放入 %homepath%\AppData\Local\Programs\Python\Python37\Scripts 目錄下即可。

    驗證:

    還是在 CMD 命令行中,輸入以下內容:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> from selenium import webdriver
    >>> browser = webdriver.Firefox()

    應該是可以正常打開一個空白的 FireFox 頁面的,結果如下:

    注意: GeckoDriver 指出一點,當前的版本在 win 下使用有已知 bug ,需要安裝微軟的一個插件才能解決,原文如下:

    You must still have the installed on your system for the binary to run. This is a known bug which we weren’t able fix for this release.

    插件下載地址:

    請各位同學選擇自己對應的系統版本進行下載安裝。

    Aiohttp

    上面我們介紹了同步的 Http 請求庫 Requests ,而 Aiohttp 則是一個提供異步 Http 請求的類庫。

    那麼,問題來了,什麼是同步請求?什麼是異步請求呢?

    • 同步:阻塞式,簡單理解就是當發出一個請求以後,程序會一直等待這個請求響應,直到響應以後,才繼續做下一步。
    • 異步:非阻塞式,還是上面的例子,當發出一個請求以後,程序並不會阻塞在這裏,等待請求響應,而是可以去做其他事情。

    從資源消耗和效率上來說,同步請求是肯定比不過異步請求的,這也是為什麼異步請求會比同步請求擁有更大的吞吐量。在抓取數據時使用異步請求,可以大大提升抓取的效率。

    如果還想了解跟多有關 aiohttp 的內容,可以訪問官方文檔: 。

    aiohttp 安裝如下:

    pip install aiohttp

    aiohttp 還推薦我們安裝另外兩個庫,一個是字符編碼檢測庫 cchardet ,另一個是加速DNS的解析庫 aiodns 。

    安裝 cchardet 庫:

    pip install cchardet

    安裝 aiodns 庫:

    pip install aiodns

    aiohttp 十分貼心的為我們準備了整合的安裝命令,無需一個一個鍵入命令,如下:

    pip install aiohttp[speedups]

    驗證:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> import aiohttp

    沒報錯就安裝成功。

    解析庫

    lxml

    lxml 是 Python 的一個解析庫,支持 HTML 和 XML 的解析,支持 XPath 的解析方式,而且解析效率非常高。

    什麼是 XPath ?

    XPath即為XML路徑語言(XML Path Language),它是一種用來確定XML文檔中某部分位置的語言。
    XPath基於XML的樹狀結構,提供在數據結構樹中找尋節點的能力。起初XPath的提出的初衷是將其作為一個通用的、介於XPointer與XSL間的語法模型。

    以上內容來源《百度百科》

    好吧,小編說人話,就是可以從 XML 文檔或者 HTML 文檔中快速的定位到所需要的位置的路徑語言。

    還沒看懂?emmmmmmmmmmm,我們可以使用 XPath 快速的取出 XML 或者 HTML 文檔中想要的值。用法的話我們放到後面再聊。

    安裝 lxml 庫:

    pip install lxml

    驗證:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> import lxml

    沒報錯就安裝成功。

    Beautiful Soup

    Beautiful Soup 同樣也是一個 Python 的 HTML 或 XML 的解析庫 。它擁有強大的解析能力,我們可以使用它更方便的從 HTML 文檔中提取數據。

    首先,放一下 Beautiful Soup 的官方網址,有各種問題都可以在官網查看文檔,各位同學養成一個好習慣,有問題找官方文檔,雖然是英文的,使用 Chrome 自帶的翻譯功能還是勉強能看的。

    官方網站:

    安裝方式依然使用 pip 進行安裝:

    pip install beautifulsoup4

    Beautiful Soup 的 HTML 和 XML 解析器是依賴於 lxml 庫的,所以在此之前請確保已經成功安裝好了 lxml 庫 。

    驗證:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> from bs4 import BeautifulSoup

    沒報錯就安裝成功。

    pyquery

    pyquery 同樣也是一個網頁解析庫,只不過和前面兩個有區別的是它提供了類似 jQuery 的語法來解析 HTML 文檔,前端有經驗的同學應該會非常喜歡這款解析庫。

    首先還是放一下 pyquery 的官方文檔地址。

    官方文檔:

    安裝:

    pip install pyquery

    驗證:

    C:\Users\inwsy>python
    Python 3.7.4 (tags/v3.7.4:e09359112e, Jul  8 2019, 20:34:20) [MSC v.1916 64 bit (AMD64)] on win32
    Type "help", "copyright", "credits" or "license" for more information.
    >>> import pyquery

    沒報錯就安裝成功。

    本篇的內容就先到這裏結束了。請各位同學在自己的電腦上將上面介紹的內容都安裝一遍,以便後續學習使用。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

  • [ASP.NET Core 3框架揭秘] 文件系統[3]:物理文件系統

    [ASP.NET Core 3框架揭秘] 文件系統[3]:物理文件系統

    ASP.NET Core應用中使用得最多的還是具體的物理文件,比如配置文件、View文件以及作為Web資源的靜態文件。物理文件系統由定義在NuGet包“Microsoft.Extensions.FileProviders.Physical”中的PhysicalFileProvider來構建。我們知道System.IO命名空間下定義了一整套針操作物理目錄和文件的API,實際上PhysicalFileProvider最終也是通過調用這些API來完成相關的IO操作。

    public class PhysicalFileProvider : IFileProvider, IDisposable
    {   
        public PhysicalFileProvider(string root);   
         
        public IFileInfo GetFileInfo(string subpath);  
        public IDirectoryContents GetDirectoryContents(string subpath); 
        public IChangeToken Watch(string filter);
    
        public void Dispose();   
    }

    一、PhysicalFileInfo

    一個PhysicalFileProvider對象總是映射到某個具體的物理目錄上,被映射的目錄所在的路徑通過構造函數的參數root來提供,該目錄將作為PhysicalFileProvider的根目錄。GetFileInfo方法返回的IFileInfo對象代表指定路徑對應的文件,這是一個類型為PhysicalFileInfo的對象。一個物理文件可以通過一個System.IO.FileInfo對象來表示,一個PhysicalFileInfo對象實際上就是對該對象的封裝,定義在PhysicalFileInfo的所有屬性都來源於這個FileInfo對象。對於創建讀取文件輸出流的CreateReadStream方法來說,它返回的是一個根據物理文件絕對路徑創建的FileStream對象。

    public class PhysicalFileInfo : IFileInfo
    {
        ...
        public PhysicalFileInfo(FileInfo info);    
    }

    對於PhysicalFileProvider的GetFileInfo方法來說,即使我們指定的路徑指向一個具體的物理文件,它並不總是會返回一個PhysicalFileInfo對象。PhysicalFileProvider會將一些場景視為“目標文件不存在”,並讓GetFileInfo方法返回一個NotFoundFileInfo對象。具體來說,PhysicalFileProvider的GetFileInfo方法在如下的場景中會返回一個NotFoundFileInfo對象:

    • 確實沒有一個物理文件與指定的路徑相匹配。
    • 如果指定的是一個絕對路徑(比如“c:\foobar”),即Path.IsPathRooted方法返回True。
    • 如果指定的路徑指向一個隱藏文件。

    顧名思義,具有如下定義的NotFoundFileInfo類型表示一個“不存在”的文件。NotFoundFileInfo對象的Exists屬性總是返回False,而其他的屬性則變得沒有任何意義。當我們調用它的CreateReadStream試圖讀取一個根本不存在的文件內容時,會拋出一個FileNotFoundException類型的異常。

    public class NotFoundFileInfo : IFileInfo
    {
        public bool Exists => false;   
        public long Length => throw new NotImplementedException();   
        public string PhysicalPath => null;  
        public string Name { get; }   
        public DateTimeOffset LastModified => DateTimeOffset.MinValue;
        public bool IsDirectory => false; 
    
        public NotFoundFileInfo(string name) => this.Name = name;
        public Stream CreateReadStream() => throw new FileNotFoundException($"The file {Name} does not exist.");
    }

    二、PhysicalDirectoryInfo

    PhysicalFileProvider利用一個PhysicalFileInfo對象來描述某個具體的物理文件,而一個物理目錄則通過一個PhysicalDirectoryInfo的對象來描述。既然PhysicalFileInfo是對一個FileInfo對象的封裝,那麼我們應該想得到PhysicalDirectoryInfo對象封裝的就是表示目錄的DirectoryInfo對象。如下面的代碼片段所示,我們需要在創建一個PhysicalDirectoryInfo對象時提供這個DirectoryInfo對象,PhysicalDirectoryInfo實現的所有屬性的返回值都來源於這個DirectoryInfo對象。由於CreateReadStream方法的目的總是讀取文件的內容,所以PhysicalDirectoryInfo類型的這個方法會拋出一個InvalidOperationException類型的異常。

    public class PhysicalDirectoryInfo : IFileInfo
    {   
        ...
        public PhysicalDirectoryInfo(DirectoryInfo info);
    }

    三、PhysicalDirectoryContents

    當我們調用PhysicalFileProvider的GetDirectoryContents方法時,如果指定的路徑指向一個具體的目錄,那麼該方法會返回一個類型為PhysicalDirectoryContents的對象。PhysicalDirectoryContents是一個IFileInfo對象的集合,該集合中包括所有描述子目錄的PhysicalDirectoryInfo對象和描述文件的PhysicalFileInfo對象。PhysicalDirectoryContents的Exists屬性取決於指定的目錄是否存在。

    public class PhysicalDirectoryContents : IDirectoryContents
    {
        public bool Exists { get; }
        public PhysicalDirectoryContents(string directory);
        public IEnumerator<IFileInfo> GetEnumerator();
        IEnumerator IEnumerable.GetEnumerator();
    }

    四、NotFoundDirectoryContents

    如果指定的路徑並不指向一個存在的目錄,或者指定的是一個絕對路徑,GetDirectoryContents方法都會返回一個Exsits為False的NotFoundDirectoryContents對象。如下所示的代碼片段展示了NotFoundDirectoryContents類型的定義,如果我們需要使用到這麼一個類型,可以直接利用靜態屬性Singleton得到對應的單例對象。

    public class NotFoundDirectoryContents : IDirectoryContents
    {    
        public static NotFoundDirectoryContents Singleton { get; }  = new NotFoundDirectoryContents();
        public bool Exists => false;
        public IEnumerator<IFileInfo> GetEnumerator()  => Enumerable.Empty<IFileInfo>().GetEnumerator();
        IEnumerator IEnumerable.GetEnumerator() => GetEnumerator();
    }

    五、PhysicalFilesWatcher

    我們接着來談談PhysicalFileProvider的Watch方法。當我們調用該方法的時候,PhysicalFileProvider會通過解析我們提供的Globbing Pattern表達式來確定我們期望監控的文件或者目錄,並最終利用FileSystemWatcher對象來對這些文件實施監控。這些文件或者目錄的變化(創建、修改、重命名和刪除等)都會實時地反映到Watch方法返回的IChangeToken上。

    PhysicalFileProvider的Watch方法中指定的Globbing Pattern表達式必須是針對當前根目錄的相對路徑,我們可以使用“/”或者“./”前綴,也可以不採用任何前綴。一旦我們使用了絕對路徑(比如“c:\test\*.txt”)或者“../”前綴(比如“../test/*.txt”),不論解析出來的文件是否存在於PhysicalFileProvider的根目錄下,這些文件都不會被監控。除此之外,如果我們沒有指定Globbing Pattern表達式,PhysicalFileProvider也不會有任何的文件會被監控。

    PhysicalFileProvider針對物理文件系統變化的監控是通過如下這個PhysicalFilesWatcher對象實現的,其Watch方法內部會直接調用PhysicalFileProvider的CreateFileChangeToken方法,並返回得到的IChangeToken對象。這是一個公共類型,如果我們具有監控物理文件系統變化的需要,可以直接使用這個類型。

    public class PhysicalFilesWatcher: IDisposable
    {
        public PhysicalFilesWatcher(string root, FileSystemWatcher fileSystemWatcher, bool pollForChanges);
        public IChangeToken CreateFileChangeToken(string filter);
        public void Dispose();
    }

    從PhysicalFilesWatcher構造函數的定義我們不難看出,它最終是利用一個FileSystemWatcher對象(對應於fileSystemWatcher參數)來完成針對指定根目錄下(對應於root參數)所有子目錄和文件的監控。FileSystemWatcher的CreateFileChangeToken方法返回的IChangeToken對象會幫助我們感知到子目錄或者文件的添加、刪除、修改和重命名,但是它會忽略隱藏的目錄和文件。最後需要提醒的是,當我們不再需要對指定目錄實施監控的時候,記得調用PhysicalFileProvider的Dispose方法,該方法會負責將FileSystemWatcher對象關閉。

    六、小結

    我們藉助下圖所示的UML來對由PhysicalFileProvider構建物理文件系統的整體設計做一個簡單的總結。首先,該文件系統使用PhysicalDirectoryInfo和PhysicalFileInfo對類型來描述目錄和文件,它們分別是對DirectoryInfo和FileInfo(System.IO.FileInfo)對象的封裝。

    PhysicalFileProvider的GetDirectoryContents方法返回一個PhysicalDirectoryContents 對象(如果指定的目錄存在),組成該對象的分別是根據其所有子目錄和文件創建的PhysicalDirectoryInfo和PhysicalFileInfo對象。當我們調用PhysicalFileProvider的GetFileInfo方法時,如果指定的文件存在,返回的是描述該文件的PhysicalFileInfo對象。至於PhysicalFileProvider的Watch方法,它最終利用了FileSystemWatcher來監控指定文件或者目錄的變化。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象
  • 面向對象和面向過程詳解

    1.前言

    其實一直對面向過程和面向對象的概念和區別沒有很深入的理解,在自己不斷想完善自己的知識體系中,今天借這個時間,寫一篇博客。來深入的了解面向過程與面向對象!好記性不如爛筆頭!!  

    2.面向對象與面向過程的區別

    面向過程就是分析出解決問題所需要的步驟,然後用函數把這些步驟一步一步實現,使用的時候一個一個依次調用就可以了;面向對象是把構成問題事務分解成各個對象,建立對象的目的不是為了完成一個步驟,而是為了描敘某個事物在整個解決問題的步驟中的行為。

    舉一個下五子棋通俗例子吧 哈哈哈 我感覺這兒例子很容易讓人理解

    面向過程的設計思路就是首先分析問題的步驟:

    1、開始遊戲,

    2、黑子先走,

    3、繪製畫面,

    4、判斷輸贏,

    5、輪到白子,

    6、繪製畫面,

    7、判斷輸贏,

    8、返回步驟2,

    9、輸出最後結果。

    把上面每個步驟用分別的函數來實現,問題就解決了。

    而面向對象的設計則是從另外的思路來解決問題。整個五子棋可以分為

    1、黑白雙方,這兩方的行為是一模一樣的,

    2、棋盤系統,負責繪製畫面,

    3、規則系統,負責判定諸如犯規、輸贏等。第一類對象(玩家對象)負責接受用戶輸入,並告知第二類對象(棋盤對象)棋子布局的變化,

    棋盤對象接收到了棋子的i變化就要負責在屏幕上面显示出這種變化,同時利用第三類對象(規則系統)來對棋局進行判定。

    可以明顯地看出,面向對象是以功能來劃分問題,而不是步驟。同樣是繪製棋局,這樣的行為在面向過程的設計中分散在了總多步驟中,很可能出現不同的繪製版本,因為通常設計人員會考慮到實際情況進行各種各樣的簡化。而面向對象的設計中,繪圖只可能在棋盤對象中出現,從而保證了繪圖的統一。

    功能上的統一保證了面向對象設計的可擴展性。比如要加入悔棋的功能,如果要改動面向過程的設計,那麼從輸入到判斷到显示這一連串的步驟都要改動,甚至步驟之間的循序都要進行大規模調整。如果是面向對象的話,只用改動棋盤對象就行了,棋盤系統保存了黑白雙方的棋譜,簡單回溯就可以了,而显示和規則判斷則不用顧及,同時整個對對象功能的調用順序都沒有變化,改動只是局部的。

    再比如我要把這個五子棋遊戲改為圍棋遊戲,如果你是面向過程設計,那麼五子棋的規則就分佈在了你的程序的每一個角落,要改動還不如重寫。但是如果你當初就是面向對象的設計,那麼你只用改動規則對象就可以了,五子棋和圍棋的區別不就是規則嗎?(當然棋盤大小好像也不一樣,但是你會覺得這是一個難題嗎?直接在棋盤對象中進行一番小改動就可以了。)而下棋的大致步驟從面向對象的角度來看沒有任何變化。

    當然,要達到改動只是局部的需要設計的人有足夠的經驗,使用對象不能保證你的程序就是面向對象,初學者或者很蹩腳的程序員很可能以面向對象之虛而行面向過程之實,這樣設計出來的所謂面向對象的程序很難有良好的可移植性和可擴展性

    三、面向過程與面向對象的優缺點
    很多資料上全都是一群很難理解的理論知識,整的我頭都大了,後來發現了一個比較好的文章,寫的真是太棒了,通俗易懂,想要不明白都難!

    用面向過程的方法寫出來的程序是一份蛋炒飯,而用面向對象寫出來的程序是一份蓋澆飯。所謂蓋澆飯,北京叫蓋飯,東北叫燴飯,廣東叫碟頭飯,就是在一碗白米飯上面澆上一份蓋菜,你喜歡什麼菜,你就澆上什麼菜。我覺得這個比喻還是比較貼切的。

    蛋炒飯製作是把米飯和雞蛋混在一起炒勻。蓋澆飯呢,則是把米飯和蓋菜分別做好,你如果要一份紅燒肉蓋飯呢,就給你澆一份紅燒肉;如果要一份青椒土豆蓋澆飯,就給澆一份青椒土豆絲。

    蛋炒飯的好處就是入味均勻,吃起來香。如果恰巧你不愛吃雞蛋,只愛吃青菜的話,那麼唯一的辦法就是全部倒掉,重新做一份青菜炒飯了。蓋澆飯就沒這麼多麻煩,你只需要把上面的蓋菜撥掉,更換一份蓋菜就可以了。蓋澆飯的缺點是入味不均,可能沒有蛋炒飯那麼香。

    到底是蛋炒飯好還是蓋澆飯好呢?其實這類問題都很難回答,非要比個上下高低的話,就必須設定一個場景,否則只能說是各有所長。如果大家都不是美食家,沒那麼多講究,那麼從飯館角度來講的話,做蓋澆飯顯然比蛋炒飯更有優勢,他可以組合出來任意多的組合,而且不會浪費。

    蓋澆飯的好處就是”菜”“飯”分離,從而提高了製作蓋澆飯的靈活性。飯不滿意就換飯,菜不滿意換菜。用軟件工程的專業術語就是”可維護性“比較好,”飯” 和”菜”的耦合度比較低。蛋炒飯將”蛋”“飯”攪和在一起,想換”蛋”“飯”中任何一種都很困難,耦合度很高,以至於”可維護性”比較差。軟件工程追求的目標之一就是可維護性,可維護性主要表現在3個方面:可理解性、可測試性和可修改性。面向對象的好處之一就是顯著的改善了軟件系統的可維護性。
    看了這篇文章,簡單的總結一下!

    面向過程

    優點:性能比面向對象高,因為類調用時需要實例化,開銷比較大,比較消耗資源;比如嵌入式開發、 Linux/Unix等一般採用面向過程開發,性能是最重要的因素。
    缺點:沒有面向對象易維護、易復用、易擴展
    面向對象

    優點:易維護、易復用、易擴展,由於面向對象有封裝、繼承、多態性的特性,可以設計出低耦合的系統,使系統 更加靈活、更加易於維護

    缺點:性能比面向過程低

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • 堡壘機的核心武器:WebSSH錄像實現

    堡壘機的核心武器:WebSSH錄像實現

    WebSSH終端錄像的實現終於來了

    前邊寫了兩篇文章和深入介紹了終端錄製工具Asciinema,我們已經可以實現在終端下對操作過程的錄製,那麼在WebSSH中的操作該如何記錄並提供後續的回放審計呢?

    一種方式是文章最後介紹的自動錄製審計日誌的方法,在主機上添加個腳本,每次連接自動進行錄製,但這樣不僅要在每台遠程主機添加腳本,會很繁瑣,而且錄製的腳本文件都是放在遠程主機上的,後續播放也很麻煩

    那該如何更好處理呢?下文介紹一種優雅的方式來實現,核心思想是不通過錄製命令進行錄製,而在Webssh交互執行的過程中直接生成可播放的錄像文件

    設計思路

    通過上邊兩篇文章的閱讀,我們已經知道了Asciinema錄像文件主要由兩部分組成:header頭和IO流數據

    header頭位於文件的第一行,定義了這個錄像的版本、寬高、開始時間、環境變量等參數,我們可以在websocket連接創建時將這些參數按照需要的格式寫入到文件

    header頭數據如下,只有開頭一行,是一個字典形式

    {"version": 2, "width": 213, "height": 55, "timestamp": 1574155029.1815443, "env": {"SHELL": "/bin/bash", "TERM": "xterm-256color"}, "title": "ops-coffee"}

    整個錄像文件除了第一行的header頭部分,剩下的就都是輸入輸出的IO流數據,從websocket連接建立開始,隨着操作的進行,IO流數據是不斷增加的,直到整個websocket長連接的結束,那就需要在整個WebSSH交互的過程中不斷的往錄像文件追加輸入輸出的內容

    IO流數據如下,每一行一條,列表形式,分別表示操作時間,輸入或輸出(這裏我們為了方便就寫固定字符串輸出),IO數據

    [0.2341010570526123, "o", "Last login: Tue Nov 19 17:11:30 2019 from 192.168.105.91\r\r\n"]

    似乎很完美,按照上邊的思路錄像文件就應該沒有問題了,但還有一些細節需要處理

    首先是需要歷史連接列表,在這個列表裡可以看到什麼時間,哪個用戶連接了哪台主機,當然也需要提供回放功能,新建一張表來記錄這些信息

    class Record(models.Model):
        create_time = models.DateTimeField(auto_now_add=True, verbose_name='創建時間')
    
        host = models.ForeignKey(Host, on_delete=models.CASCADE, verbose_name='主機')
        user = models.ForeignKey(User, on_delete=models.CASCADE, verbose_name='用戶')
    
        filename = models.CharField(max_length=128, verbose_name='錄像文件名稱')
    
        def __str__(self):
            return self.host

    其次還需要考慮的一個問題是header和後續IO數據流要寫入同一個文件,這就需要在整個websocket的連接過程中有一個固定的文件名可被讀取,這裏我使用了主機+用戶+當前時間作為文件名,同一用戶在同一時間不能多次連接同一主機,這樣可保證文件名不重複,同時避免操作寫入錯誤的錄像文件,文件名在websocket建立時初始化

    def __init__(self, host, user, websocket):
        self.host = host
        self.user = user
    
        self.time = time.time()
        self.filename = '%s.%s.%d.cast' % (host, user, self.time)

    IO流數據會持續不斷的寫入文件,這裏以一個獨立的方法來處理寫入

    def record(self, type, data):
        RECORD_DIR = settings.BASE_DIR + '/static/record/'
        if not os.path.isdir(RECORD_DIR):
            os.makedirs(RECORD_DIR)
    
        if type == 'header':
            Record.objects.create(
                host=Host.objects.get(id=self.host),
                user=self.user,
                filename=self.filename
            )
    
            with open(RECORD_DIR + self.filename, 'w') as f:
                f.write(json.dumps(data) + '\n')
        else:
            iodata = [time.time() - self.time, 'o', data]
            with open(RECORD_DIR + self.filename, 'a', buffering=1) as f:
                f.write((json.dumps(iodata) + '\n'))

    record接收兩個參數type和data,type標識本次寫入的是header頭還是IO流,data則是具體的數據

    header只需要執行一次寫入,所以將其放在ssh的connect方法中,只在ssh連接建立時執行一次,在執行header寫入時同時往數據庫插入新的歷史記錄數據

    調用record方法寫入header

    def connect(self, host, port, username, authtype, password=None, pkey=None,
                term='xterm-256color', cols=80, rows=24):
        ...
    
        # 構建錄像文件header
        self.record('header', {
            "version": 2,
            "width": cols,
            "height": rows,
            "timestamp": self.time,
            "env": {
                "SHELL": "/bin/bash",
                "TERM": term
            },
            "title": "ops-coffee"
        })

    IO流數據則需要與返回給前端的數據保持一致,這樣就能保證前端显示什麼錄像就播放什麼了,所以所有需要返回前端數據的地方都同時寫入錄像文件即可

    調用record方法寫入io流數據

    def connect(self, host, port, username, authtype, password=None, pkey=None,
                term='xterm-256color', cols=80, rows=24):
        ...
    
        # 連接建立一次,之後交互數據不會再進入該方法
        for i in range(2):
            recv = self.ssh_channel.recv(65535).decode('utf-8', 'ignore')
            message = json.dumps({'flag': 'success', 'message': recv})
            self.websocket.send(message)
    
            self.record('iodata', recv)
    
    ...
    
    def _ssh_to_ws(self):
        try:
            with self.lock:
                while not self.ssh_channel.exit_status_ready():
                    data = self.ssh_channel.recv(1024).decode('utf-8', 'ignore')
                    if len(data) != 0:
                        message = {'flag': 'success', 'message': data}
                        self.websocket.send(json.dumps(message))
    
                        self.record('iodata', data)
                    else:
                        break
        except Exception as e:
            message = {'flag': 'error', 'message': str(e)}
            self.websocket.send(json.dumps(message))
            self.record('iodata', str(e))
            
            self.close()

    由於命令執行與返回都是多線程的操作,這就會導致在寫入文件時出現文件亂序影響播放的問題,典型的操作有vim、top等,通過加鎖self.lock可以順利解決

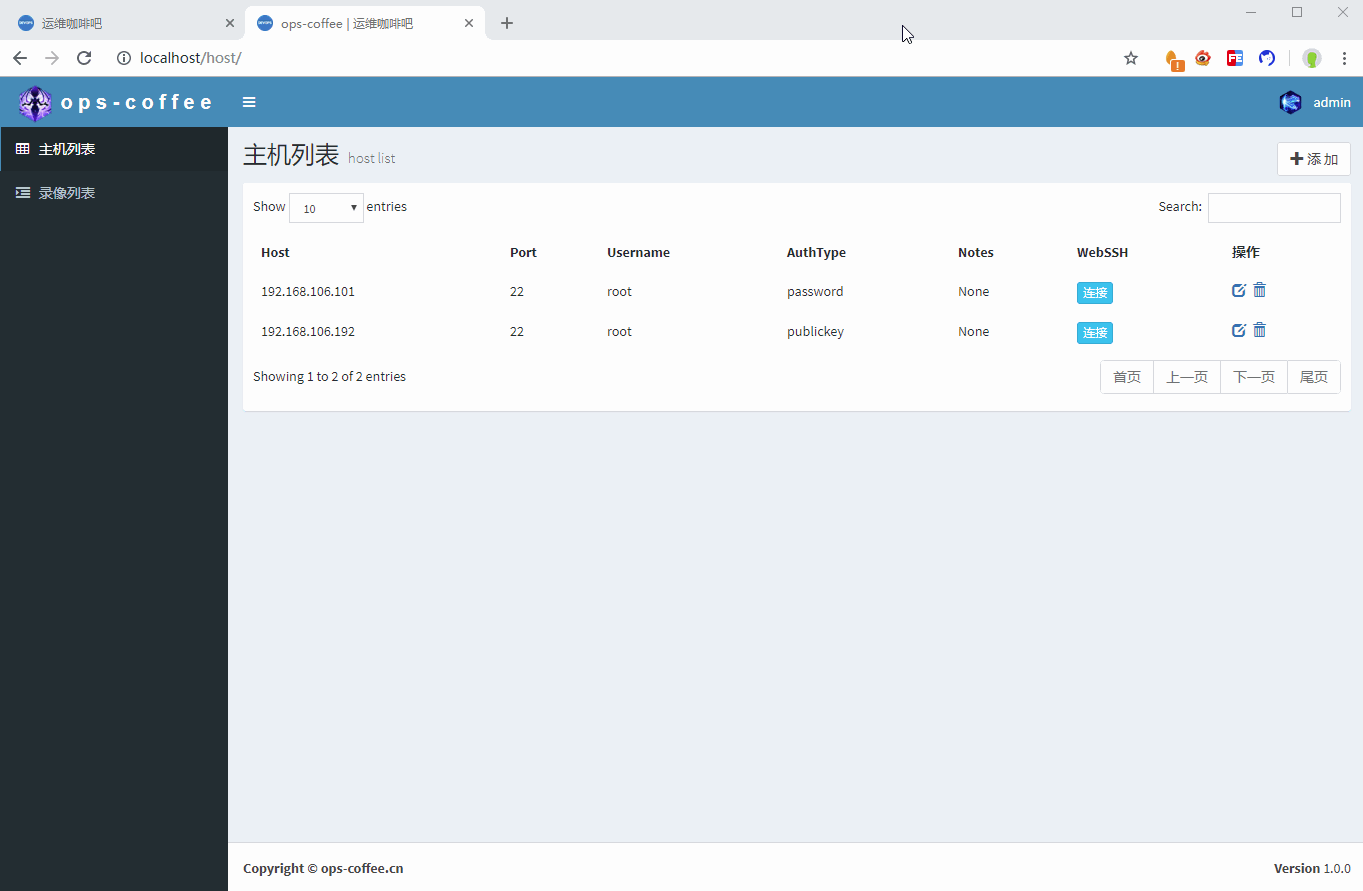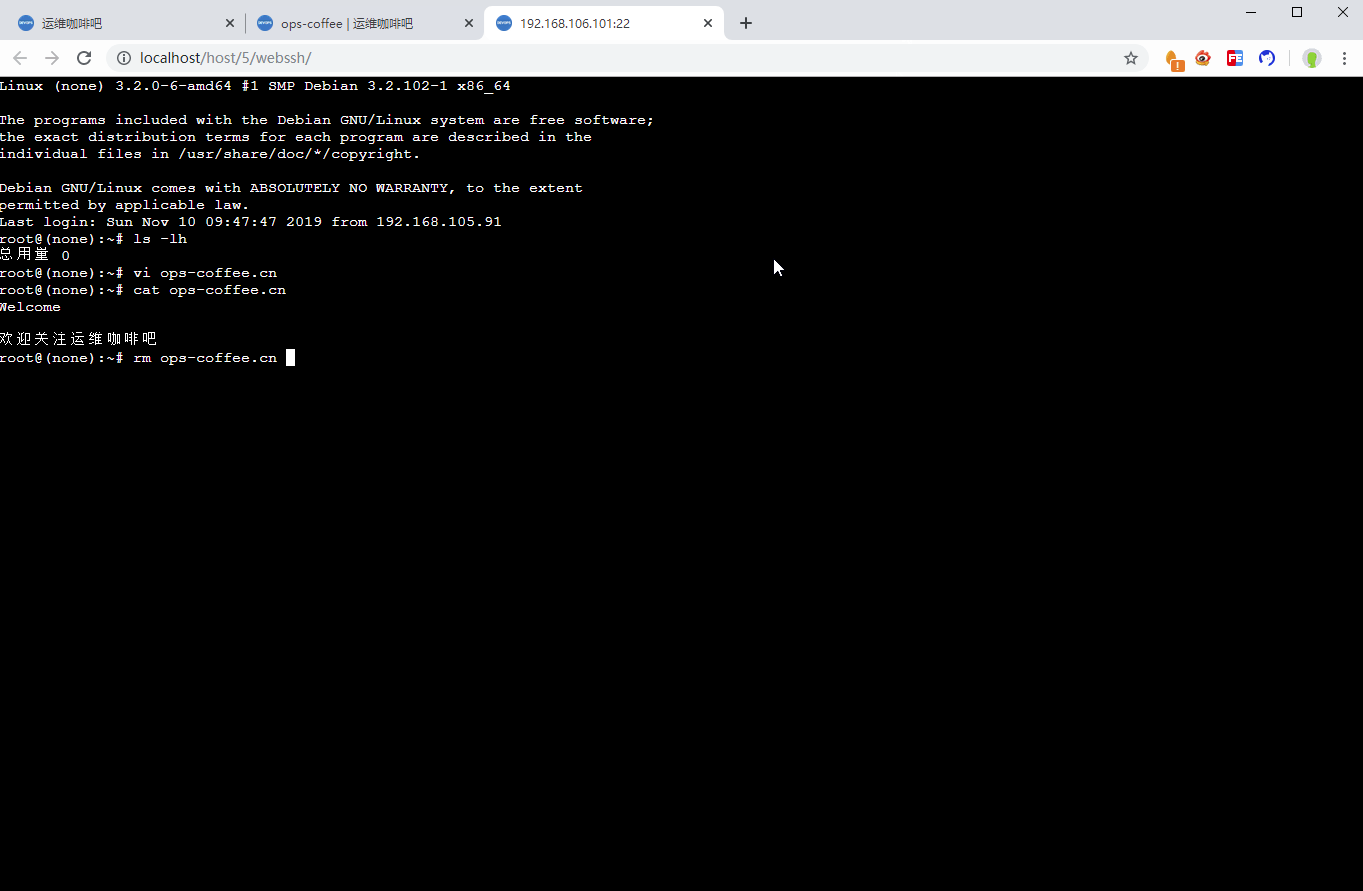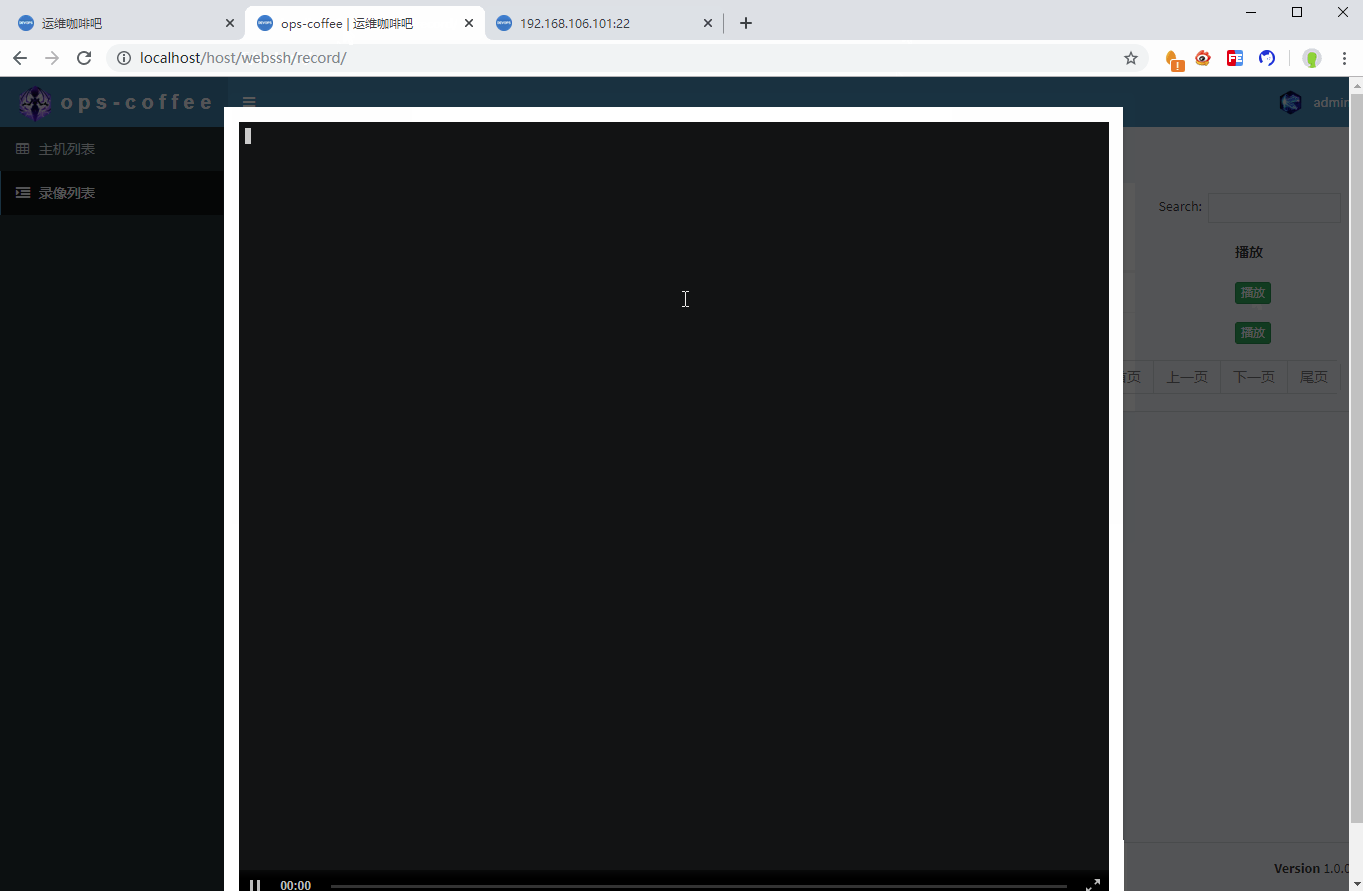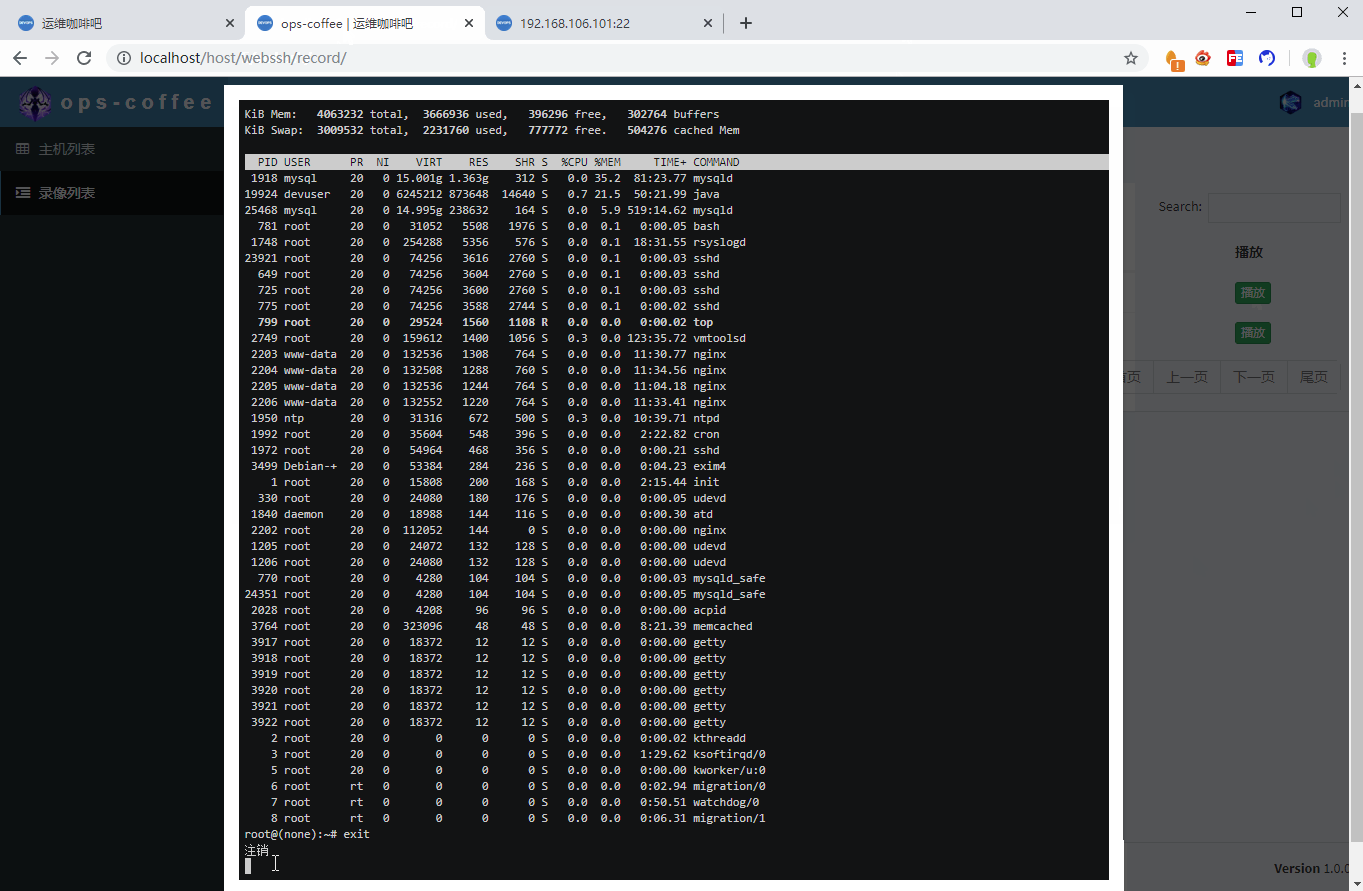
    最後歷史記錄頁面,當用戶點擊播放按鈕時,調用js彈出播放窗口

    <div class="modal fade" id="modalForm">
      <div class="modal-dialog modal-lg">
        <div class="modal-content">
          <div class="modal-body" id="play">
          </div>
        </div>
      </div>
    </div>
    
    // 播放錄像
    function play(host,user,time,file) {
      $('#play').html(
        '<asciinema-player id="play" title="WebSSH Record" author="ops-coffee.cn" author-url="https://ops-coffee.cn" author-img-url="/static/img/logo.png" src="/static/record/'+file+'" speed="3" '+
        'idle-time-limit="2" poster="data:text/plain,\x1b[1;32m'+time+
        '\x1b[1;0m用戶\x1b[1;32m'+user+
        '\x1b[1;0m連接主機\x1b[1;32m'+host+
        '\x1b[1;0m的錄像記錄"></asciinema-player>'
      )
    
      $('#modalForm').modal('show');
    }

    asciinema-player標籤的詳細參數介紹可以看這篇文章

    演示與總結

    在寫入文件的方案中,考慮了實時寫入和一次性寫入,實時寫入就像上邊這樣,所有的操作都會實時寫入錄像文件,好處是錄像不丟失,且能在操作的過程中進行實時的播放,缺點也很明顯,就是會頻繁的寫文件,造成IO開銷

    一次性寫入可以在用戶操作的過程中將錄像數據寫入內存,在websocket關閉時一次性異步寫入到文件中,這種方案在最終寫入文件時可能因為種種原因而失敗,從而導致錄像丟失,還有個缺點是當你WebSSH操作時間過長時,會導致內存的持續增加

    兩種方案一種是對磁盤的消耗另一種是對內存的消耗,各有利弊,當然你也可以考慮批量寫入,例如每分鐘寫一次文件,一分鐘之內的保存在內存中,平衡內存和磁盤的消耗,期待你的實現

    相關文章推薦閱讀:

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象
    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益