部落格

  • 這篇文章,我們來談一談Spring中的屬性注入

    這篇文章,我們來談一談Spring中的屬性注入

    本系列文章:

    讀源碼,我們可以從第一行讀起

    你知道Spring是怎麼解析配置類的嗎?

    配置類為什麼要添加@Configuration註解?

    談談Spring中的對象跟Bean,你知道Spring怎麼創建對象的嗎?

    推薦閱讀:

    Spring官網閱讀 | 總結篇

    Spring雜談

    本系列文章將會帶你一行行的將Spring的源碼吃透,推薦閱讀的文章是閱讀源碼的基礎!

    前言

    在前面的文章中已經知道了Spring是如何將一個對象創建出來的,那麼緊接着,Spring就需要將這個對象變成一個真正的Bean了,這個過程主要分為兩步

    1. 屬性注入
    2. 初始化

    在這兩個過程中,Bean的後置處理器會穿插執行,其中有些後置處理器是為了幫助完成屬性注入或者初始化的,而有些後置處理器是Spring提供給程序員進行擴展的,當然,這二者並不衝突。整個Spring創建對象並將對象變成Bean的過程就是我們經常提到了Spring中Bean的生命周期。當然,本系列源碼分析的文章不會再對生命周期的概念做過多闡述了,如果大家有這方面的需求的話可以參考我之前的文章,或者關注我的公眾號:程序員DMZ

    Spring官網閱讀(九)Spring中Bean的生命周期(上)

    Spring官網閱讀(十)Spring中Bean的生命周期(下)

    源碼分析

    閑話不再多說,我們正式進入源碼分析階段,本文重點要分析的方法就是org.springframework.beans.factory.support.AbstractAutowireCapableBeanFactory#doCreateBean,其源碼如下:

    doCreateBean

    	protected Object doCreateBean(final String beanName, final RootBeanDefinition mbd, final @Nullable Object[] args)
    			throws BeanCreationException {
    
    		// 創建對象的過程在上篇文章中我們已經介紹過了,這裏不再贅述
    		BeanWrapper instanceWrapper = null;
    		if (mbd.isSingleton()) {
    			instanceWrapper = this.factoryBeanInstanceCache.remove(beanName);
    		}
    		if (instanceWrapper == null) {
    			instanceWrapper = createBeanInstance(beanName, mbd, args);
    		}
            
            // 獲取到創建的這個對象
    		final Object bean = instanceWrapper.getWrappedInstance();
    		Class<?> beanType = instanceWrapper.getWrappedClass();
    		if (beanType != NullBean.class) {
    			mbd.resolvedTargetType = beanType;
    		}
    
    		// Allow post-processors to modify the merged bean definition.
            // 按照官方的註釋來說,這個地方是Spring提供的一個擴展點,對程序員而言,我們可以通過一個實現了MergedBeanDefinitionPostProcessor的後置處理器來修改bd中的屬性,從而影響到後續的Bean的生命周期
            // 不過官方自己實現的後置處理器並沒有去修改bd,而是調用了applyMergedBeanDefinitionPostProcessors方法
            // 這個方法名直譯過來就是-應用合併后的bd,也就是說它這裏只是對bd做了進一步的使用而沒有真正的修改
    		synchronized (mbd.postProcessingLock) {
               // bd只允許被處理一次
    			if (!mbd.postProcessed) {
    				try {
                        // 應用合併后的bd
    					applyMergedBeanDefinitionPostProcessors(mbd, beanType, beanName);
    				}
    				catch (Throwable ex) {
    					throw new BeanCreationException(mbd.getResourceDescription(), beanName,
    							"Post-processing of merged bean definition failed", ex);
    				}
                    // 標註這個bd已經被MergedBeanDefinitionPostProcessor的後置處理器處理過
                    // 那麼在第二次創建Bean的時候,不會再次調用applyMergedBeanDefinitionPostProcessors
    				mbd.postProcessed = true;
    			}
    		}
    
    		// 這裡是用來出來循環依賴的,關於循環以來,在介紹完正常的Bean的創建后,單獨用一篇文章說明
            // 這裏不做過多解釋
    		boolean earlySingletonExposure = (mbd.isSingleton() && this.allowCircularReferences &&
    				isSingletonCurrentlyInCreation(beanName));
    		if (earlySingletonExposure) {
    			if (logger.isTraceEnabled()) {
    				logger.trace("Eagerly caching bean '" + beanName +
    						"' to allow for resolving potential circular references");
    			}
    			addSingletonFactory(beanName, () -> getEarlyBeanReference(beanName, mbd, bean));
    		}
    
    
    		Object exposedObject = bean;
    		try {
                // 我們這篇文章重點要分析的就是populateBean方法,在這個方法中完成了屬性注入
    			populateBean(beanName, mbd, instanceWrapper);
                // 初始化
    			exposedObject = initializeBean(beanName, exposedObject, mbd);
    		}
    		catch (Throwable ex) {
    			// 省略異常代碼
    		}
    
    		// 後續代碼不在本文探討範圍內了,暫不考慮
    
    		return exposedObject;
    	}
    

    applyMergedBeanDefinitionPostProcessors

    源碼如下:

    // 可以看到這個方法的代碼還是很簡單的,就是調用了MergedBeanDefinitionPostProcessor的postProcessMergedBeanDefinition方法
    protected void applyMergedBeanDefinitionPostProcessors(RootBeanDefinition mbd, Class<?> beanType, String beanName) {
        for (BeanPostProcessor bp : getBeanPostProcessors()) {
            if (bp instanceof MergedBeanDefinitionPostProcessor) {
                MergedBeanDefinitionPostProcessor bdp = (MergedBeanDefinitionPostProcessor) bp;
                bdp.postProcessMergedBeanDefinition(mbd, beanType, beanName);
            }
        }
    }
    

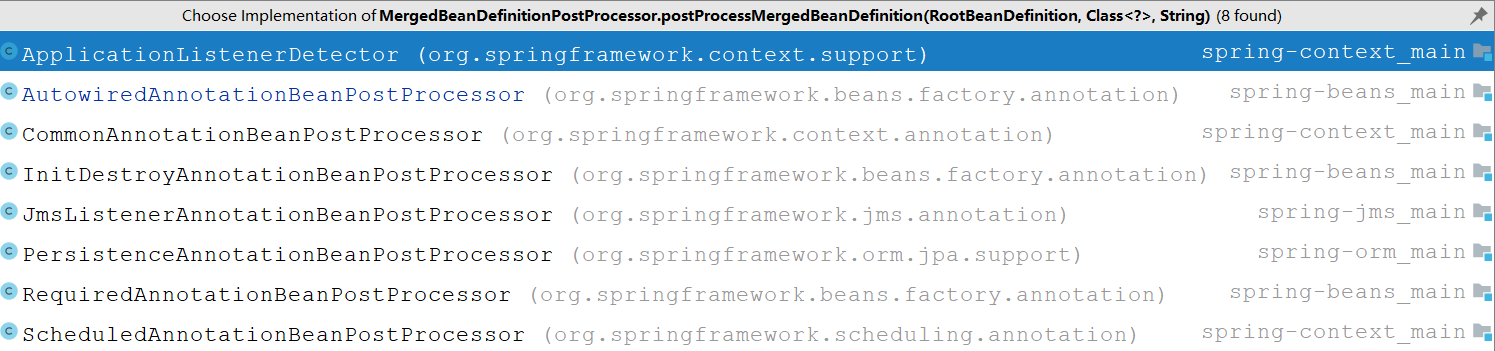
    這個時候我們就要思考一個問題,容器中現在有哪些後置處理器是MergedBeanDefinitionPostProcessor呢?

    查看這個方法的實現類我們會發現總共就這麼幾個類實現了MergedBeanDefinitionPostProcessor接口。實際上除了ApplicationListenerDetector之外,其餘的後置處理器的邏輯都差不多。我們在這裏我們主要就分析兩個後置處理

    1. ApplicationListenerDetector
    2. AutowiredAnnotationBeanPostProcessor

    ApplicationListenerDetector

    首先,我們來ApplicationListenerDetector,這個類在之前的文章中也多次提到過了,它的作用是用來處理嵌套Bean的情況,主要是保證能將嵌套在Bean標籤中的ApplicationListener也能添加到容器的監聽器集合中去。我們先通過一個例子來感受下這個後置處理器的作用吧

    配置文件:

    <?xml version="1.0" encoding="UTF-8"?>
    <beans xmlns="http://www.springframework.org/schema/beans"
    	   xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
    	   xsi:schemaLocation="http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd">
    
    	<bean class="com.dmz.source.populate.service.DmzService" id="dmzService">
    		<constructor-arg name="orderService">
    			<bean class="com.dmz.source.populate.service.OrderService"/>
    		</constructor-arg>
    	</bean>
    </beans>
    

    示例代碼:

    // 事件
    public class DmzEvent extends ApplicationEvent {
    	public DmzEvent(Object source) {
    		super(source);
    	}
    }
    
    public class DmzService {
    
    	OrderService orderService;
    
    	public DmzService(OrderService orderService) {
    		this.orderService = orderService;
    	}
    }
    // 實現ApplicationListener接口
    public class OrderService implements ApplicationListener<DmzEvent> {
    	@Override
    	public void onApplicationEvent(DmzEvent event) {
    		System.out.println(event.getSource());
    	}
    }
    
    public class Main {
    	public static void main(String[] args) {
    		ClassPathXmlApplicationContext cc = new ClassPathXmlApplicationContext("application-populate.xml");
    		cc.publishEvent(new DmzEvent("my name is dmz"));
    	}
    }
    
    // 程序運行結果,控制台打印:my name is dmz
    

    說明OrderService已經被添加到了容器的監聽器集合中。但是請注意,在這種情況下,如果要使OrderService能夠執行監聽的邏輯,必須要滿足下面這兩個條件

    • 外部的Bean要是單例的,對於我們的例子而言就是dmzService
    • 內嵌的Bean也必須是單例的,在上面的例子中也就是orderService必須是單例

    另外需要注意的是,這種嵌套的Bean比較特殊,它雖然由Spring創建,但是確不存在於容器中,就是說我們不能將其作為依賴注入到別的Bean中。

    AutowiredAnnotationBeanPostProcessor

    對應源碼如下:

    public void postProcessMergedBeanDefinition(RootBeanDefinition beanDefinition, Class<?> beanType, String beanName) {
        // 找到注入的元數據,第一次是構建,後續可以直接從緩存中拿
        // 註解元數據其實就是當前這個類中的所有需要進行注入的“點”的集合,
        // 注入點(InjectedElement)包含兩種,字段/方法
        // 對應的就是AutowiredFieldElement/AutowiredMethodElement
        InjectionMetadata metadata = findAutowiringMetadata(beanName, beanType, null);
        // 排除掉被外部管理的注入點
        metadata.checkConfigMembers(beanDefinition);
    }
    

    上面代碼的核心邏輯就是

    • 找到所有的注入點,其實就是被@Autowired註解修飾的方法以及字段,同時靜態的方法以及字段也會被排除
    • 排除掉被外部管理的注入點,在後續的源碼分析中我們再細說

    findAutowiringMetadata

    // 這個方法的核心邏輯就是先從緩存中獲取已經解析好的注入點信息,很明顯,在原型情況下才會使用緩存
    // 創建注入點的核心邏輯在buildAutowiringMetadata方法中
    private InjectionMetadata findAutowiringMetadata(String beanName, Class<?> clazz, @Nullable PropertyValues pvs) {
        String cacheKey = (StringUtils.hasLength(beanName) ? beanName : clazz.getName());
        InjectionMetadata metadata = this.injectionMetadataCache.get(cacheKey);
        // 可能我們會修改bd中的class屬性,那麼InjectionMetadata中的注入點信息也需要刷新
        if (InjectionMetadata.needsRefresh(metadata, clazz)) {
            synchronized (this.injectionMetadataCache) {
                metadata = this.injectionMetadataCache.get(cacheKey);
                if (InjectionMetadata.needsRefresh(metadata, clazz)) {
                    if (metadata != null) {
                        metadata.clear(pvs);
                    }
                    // 這裏真正創建注入點
                    metadata = buildAutowiringMetadata(clazz);
                    this.injectionMetadataCache.put(cacheKey, metadata);
                }
            }
        }
        return metadata;
    }
    

    buildAutowiringMetadata

    // 我們應用中使用@Autowired註解標註在字段上或者setter方法能夠完成屬性注入
    // 就是因為這個方法將@Autowired註解標註的方法以及字段封裝成InjectionMetadata
    // 在後續階段會調用InjectionMetadata的inject方法進行注入
    private InjectionMetadata buildAutowiringMetadata(final Class<?> clazz) {
        List<InjectionMetadata.InjectedElement> elements = new ArrayList<>();
        Class<?> targetClass = clazz;
    
        do {
            final List<InjectionMetadata.InjectedElement> currElements = new ArrayList<>();
    		// 處理所有的被@AutoWired/@Value註解標註的字段
            ReflectionUtils.doWithLocalFields(targetClass, field -> {
                AnnotationAttributes ann = findAutowiredAnnotation(field);
                if (ann != null) {
                    // 靜態字段會直接跳過
                    if (Modifier.isStatic(field.getModifiers())) {
                        // 省略日誌打印
                        return;
                    }
                    // 得到@AutoWired註解中的required屬性
                    boolean required = determineRequiredStatus(ann);
                    currElements.add(new AutowiredFieldElement(field, required));
                }
            });
    		// 處理所有的被@AutoWired註解標註的方法,相對於字段而言,這裏需要對橋接方法進行特殊處理
            ReflectionUtils.doWithLocalMethods(targetClass, method -> {
                // 只處理一種特殊的橋接場景,其餘的橋接方法都會被忽略
                Method bridgedMethod = BridgeMethodResolver.findBridgedMethod(method);
                if (!BridgeMethodResolver.isVisibilityBridgeMethodPair(method, bridgedMethod)) {
                    return;
                }
                AnnotationAttributes ann = findAutowiredAnnotation(bridgedMethod);
                // 處理方法時需要注意,當父類中的方法被子類重寫時,如果子父類中的方法都加了@Autowired
                // 那麼此時父類方法不能被處理,即不能被封裝成一個AutowiredMethodElement
                if (ann != null && method.equals(ClassUtils.getMostSpecificMethod(method, clazz))) {
                    if (Modifier.isStatic(method.getModifiers())) {
                        // 省略日誌打印
                        return;
                    }
                    if (method.getParameterCount() == 0) {
                        // 當方法的參數數量為0時,雖然不需要進行注入,但是還是會把這個方法作為注入點使用
                        // 這個方法最終還是會被調用
                        if (logger.isInfoEnabled()) {
                            logger.info("Autowired annotation should only be used on methods with parameters: " +
                                        method);
                        }
                    }
                    boolean required = determineRequiredStatus(ann);
                    // PropertyDescriptor: 屬性描述符
                    // 就是通過解析getter/setter方法,例如void getA()會解析得到一個屬性名稱為a
                    // readMethod為getA的PropertyDescriptor,
                    // 在《Spring官網閱讀(十四)Spring中的BeanWrapper及類型轉換》文中已經做過解釋
                    // 這裏不再贅述,這裏之所以來這麼一次查找是因為當XML中對這個屬性進行了配置后,
                    // 那麼就不會進行自動注入了,XML中显示指定的屬性優先級高於註解
                    PropertyDescriptor pd = BeanUtils.findPropertyForMethod(bridgedMethod, clazz);		   // 構造一個對應的AutowiredMethodElement,後續這個方法會被執行
                    // 方法的參數會被自動注入,這裏不限於setter方法
                    currElements.add(new AutowiredMethodElement(method, required, pd));
                }
            });
    		// 會處理父類中字段上及方法上的@AutoWired註解,並且父類的優先級比子類高
            elements.addAll(0, currElements);
            targetClass = targetClass.getSuperclass();
        }
        while (targetClass != null && targetClass != Object.class);
    
        return new InjectionMetadata(clazz, elements);
    }
    
    難點代碼分析

    上面的代碼整體來說應該很簡單,就如我們之前所說的,處理帶有@Autowired註解的字段及方法,同時會過濾掉所有的靜態字段及方法。上面複雜的地方在於對橋接方法的處理,可能大部分人都沒辦法理解這幾行代碼:

    // 第一行
    Method bridgedMethod = BridgeMethodResolver.findBridgedMethod(method);
    
    // 第二行
    if (!BridgeMethodResolver.isVisibilityBridgeMethodPair(method, bridgedMethod)) {
        return;
    }
    
    // 第三行
    if (ann != null && method.equals(ClassUtils.getMostSpecificMethod(method, clazz))) {
    
    }
    

    要理解這些代碼,首先你得知道什麼是橋接,為此我已經寫好了一篇文章:

    Spring雜談 | 從橋接方法到JVM方法調用

    除了在上面的文章中提到的橋接方法外,還有一種特殊的情況

    // A類跟B類在同一個包下,A不是public的
    class A {
    	public void test(){
    
    	}
    }
    
    // 在B中會生成一個跟A中的方法描述符(參數+返回值)一模一樣的橋接方法
    // 這個橋接方法實際上就是調用父類中的方法
    // 具體可以參考:https://bugs.java.com/bugdatabase/view_bug.do?bug_id=63424113
    public class B extends A {
    }
    

    在理解了什麼是橋接之後,那麼上邊的第一行代碼你應該就能看懂了,就以上面的代碼為例,B中會生成一個橋接方法,對應的被橋接的方法就是A中的test方法。

    接着,我們看看第二行代碼

    public static boolean isVisibilityBridgeMethodPair(Method bridgeMethod, Method bridgedMethod) {
        // 說明這個方法本身就不是橋接方法,直接返回true
        if (bridgeMethod == bridgedMethod) {
            return true;
        }
        // 說明是橋接方法,並且方法描述符一致
        // 當且僅當是上面例子中描述的這種橋接的時候這個判斷才會滿足
        // 正常來說橋接方法跟被橋接方法的返回值+參數類型肯定不一致
        // 所以這個判斷會過濾掉其餘的所有類型的橋接方法
        // 只會保留本文提及這種特殊情況下產生的橋接方法
        return (bridgeMethod.getReturnType().equals(bridgedMethod.getReturnType()) &&
                Arrays.equals(bridgeMethod.getParameterTypes(), bridgedMethod.getParameterTypes()));
    }
    

    最後,再來看看第三行代碼,核心就是這句 method.equals(ClassUtils.getMostSpecificMethod(method, clazz)。這句代碼的主要目的就是為了處理下面這種情況

    @Component
    public class D extends C {
    
    	@Autowired
    	@Override
    	public void setDmzService(DmzService dmzService) {
    		dmzService.init();
    		this.dmzService = dmzService;
    	}
    }
    
    // C不是Spring中的組件
    public class C {
    	DmzService dmzService;
        @Autowired
    	public void setDmzService(DmzService dmzService) {
    		this.dmzService = dmzService;
    	}
    }


    這種情況下,在處理D中的@Autowired註解時,雖然我們要處理父類中的@Autowired註解,但是因為子類中的方法已經複寫了父類中的方法,所以此時應該要跳過父類中的這個被複寫的方法,這就是第三行代碼的作用。

    小結

    到這裏我們主要分析了applyMergedBeanDefinitionPostProcessors這段代碼的作用,它的執行時機是在創建對象之後,屬性注入之前。按照官方的定義來說,到這裏我們仍然可以使用這個方法來修改bd的定義,那麼相對於通過BeanFactoryPostProcessor的方式修改bd,applyMergedBeanDefinitionPostProcessors這個方法影響的範圍更小,BeanFactoryPostProcessor影響的是整個Bean的生命周期,而applyMergedBeanDefinitionPostProcessors只會影響屬性注入之後的生命周期。

    其次,我們分析了Spring中內置的MergedBeanDefinitionPostProcessor,選取了其中兩個特殊的後置處理器進行分析,其中ApplicationListenerDetector主要處理內嵌的事件監聽器,而AutowiredAnnotationBeanPostProcessor主要用於處理@Autowired註解,實際上我們會發現,到這裏還只是完成了@Autowired註解的解析,還沒有真正開始進行注入,真正注入的邏輯在後面我們要分析的populateBean方法中,在這個方法中會使用解析好的注入元信息完成真正的屬性注入,那麼接下來我們就開始分析populateBean這個方法的源碼。

    populateBean

    循環依賴的代碼我們暫且跳過,後續出一篇專門文章解讀循環依賴,我們直接看看populateBean到底做了什麼。

    protected void populateBean(String beanName, RootBeanDefinition mbd, @Nullable BeanWrapper bw) {
    
        // 處理空實例
        if (bw == null) {
            // 如果創建的對象為空,但是在XML中又配置了需要注入的屬性的話,那麼直接報錯
            if (mbd.hasPropertyValues()) {
                throw new BeanCreationException(
                    mbd.getResourceDescription(), beanName, "Cannot apply property values to null instance");
            }
            else {
                // 空對象,不進行屬性注入
                return;
            }
        }
    
        // 滿足兩個條件,不是合成類 && 存在InstantiationAwareBeanPostProcessor
        // 其中InstantiationAwareBeanPostProcessor主要作用就是作為Bean的實例化前後的鈎子
        // 外加完成屬性注入,對於三個方法就是
        // postProcessBeforeInstantiation  創建對象前調用
        // postProcessAfterInstantiation   對象創建完成,@AutoWired註解解析后調用   
        // postProcessPropertyValues(已過期,被postProcessProperties替代) 進行屬性注入
        // 下面這段代碼的主要作用就是我們可以提供一個InstantiationAwareBeanPostProcessor
        // 提供的這個後置處理如果實現了postProcessAfterInstantiation方法並且返回false
        // 那麼可以跳過Spring默認的屬性注入,但是這也意味着我們要自己去實現屬性注入的邏輯
        // 所以一般情況下,我們也不會這麼去擴展
        if (!mbd.isSynthetic() && hasInstantiationAwareBeanPostProcessors()) {
            for (BeanPostProcessor bp : getBeanPostProcessors()) {
                if (bp instanceof InstantiationAwareBeanPostProcessor) {
                    InstantiationAwareBeanPostProcessor ibp = (InstantiationAwareBeanPostProcessor) bp;
                    if (!ibp.postProcessAfterInstantiation(bw.getWrappedInstance(), beanName)) {
                        return;
                    }
                }
            }
        }
    	
        // 這裏其實就是判斷XML是否提供了屬性相關配置
        PropertyValues pvs = (mbd.hasPropertyValues() ? mbd.getPropertyValues() : null);
    	
        // 確認注入模型
        int resolvedAutowireMode = mbd.getResolvedAutowireMode();
        
        // 主要處理byName跟byType兩種注入模型,byConstructor這種注入模型在創建對象的時候已經處理過了
        // 這裏都是對自動注入進行處理,byName跟byType兩種注入模型均是依賴setter方法
        // byName,根據setter方法的名字來查找對應的依賴,例如setA,那麼就是去容器中查找名字為a的Bean
        // byType,根據setter方法的參數類型來查找對應的依賴,例如setXx(A a),就是去容器中查詢類型為A的bean
        if (resolvedAutowireMode == AUTOWIRE_BY_NAME || resolvedAutowireMode == AUTOWIRE_BY_TYPE) {
            MutablePropertyValues newPvs = new MutablePropertyValues(pvs);
            if (resolvedAutowireMode == AUTOWIRE_BY_NAME) {
                autowireByName(beanName, mbd, bw, newPvs);
            }
            if (resolvedAutowireMode == AUTOWIRE_BY_TYPE) {
                autowireByType(beanName, mbd, bw, newPvs);
            }
            // pvs是XML定義的屬性
            // 自動注入后,bean實際用到的屬性就應該要替換成自動注入后的屬性
            pvs = newPvs;
        }
    	// 檢查是否有InstantiationAwareBeanPostProcessor
        // 前面說過了,這個後置處理器就是來完成屬性注入的
        boolean hasInstAwareBpps = hasInstantiationAwareBeanPostProcessors();
        
        //  是否需要依賴檢查,默認是不會進行依賴檢查的
        boolean needsDepCheck = (mbd.getDependencyCheck() != AbstractBeanDefinition.DEPENDENCY_CHECK_NONE);
    	
        // 下面這段代碼有點麻煩了,因為涉及到版本問題
        // 其核心代碼就是調用了postProcessProperties完成了屬性注入
       
        PropertyDescriptor[] filteredPds = null;
        
        // 存在InstantiationAwareBeanPostProcessor,我們需要調用這類後置處理器的方法進行注入
    		if (hasInstAwareBpps) {
    			if (pvs == null) {
    				pvs = mbd.getPropertyValues();
    			}
    			for (BeanPostProcessor bp : getBeanPostProcessors()) {
    				if (bp instanceof InstantiationAwareBeanPostProcessor) {
    					InstantiationAwareBeanPostProcessor ibp = (InstantiationAwareBeanPostProcessor) bp;
                        // 這句就是核心
    					PropertyValues pvsToUse = ibp.postProcessProperties(pvs, bw.getWrappedInstance(), beanName);
    					if (pvsToUse == null) {
    						if (filteredPds == null) {
                                // 得到需要進行依賴檢查的屬性的集合
    							filteredPds = filterPropertyDescriptorsForDependencyCheck(bw, mbd.allowCaching);
    						}
                            //  這個方法已經過時了,放到這裏就是為了兼容老版本
    						pvsToUse = ibp.postProcessPropertyValues(pvs, filteredPds, bw.getWrappedInstance(), beanName);
    						if (pvsToUse == null) {
    							return;
    						}
    					}
    					pvs = pvsToUse;
    				}
    			}
    		}
        // 需要進行依賴檢查
    		if (needsDepCheck) {
    			if (filteredPds == null) {
                    // 得到需要進行依賴檢查的屬性的集合
    				filteredPds = filterPropertyDescriptorsForDependencyCheck(bw, mbd.allowCaching);
    			}
                // 對需要進行依賴檢查的屬性進行依賴檢查
    			checkDependencies(beanName, mbd, filteredPds, pvs);
    		}
        // 將XML中的配置屬性應用到Bean上
    		if (pvs != null) {
    			applyPropertyValues(beanName, mbd, bw, pvs);
    		}
    }
    

    上面這段代碼主要可以拆分為三個部分

    1. 處理自動注入
    2. 處理屬性注入(主要指處理@Autowired註解),最重要
    3. 處理依賴檢查

    處理自動注入

    autowireByName

    對應源碼如下:

    protected void autowireByName(
        String beanName, AbstractBeanDefinition mbd, BeanWrapper bw, MutablePropertyValues pvs) {
        // 得到符合下麵條件的屬性名稱
        // 1.有setter方法
        // 2.需要進行依賴檢查
        // 3.不包含在XML配置中
        // 4.不是簡單類型(基本數據類型,枚舉,日期等)
        // 這裏可以看到XML配置優先級高於自動注入的優先級
        // 不進行依賴檢查的屬性,也不會進行屬性注入
        String[] propertyNames = unsatisfiedNonSimpleProperties(mbd, bw);
        for (String propertyName : propertyNames) {
            if (containsBean(propertyName)) {
                Object bean = getBean(propertyName);
                // 將自動注入的屬性添加到pvs中去
                pvs.add(propertyName, bean);
                // 註冊bean之間的依賴關係
                registerDependentBean(propertyName, beanName);
                // 忽略日誌
            }
            // 忽略日誌
        }
    }
    

    看到了嗎?代碼就是這麼的簡單,不是要通過名稱注入嗎?直接通過beanName調用getBean,完事兒

    autowireByType

    	protected void autowireByType(
    			String beanName, AbstractBeanDefinition mbd, BeanWrapper bw, MutablePropertyValues pvs) {
    		// 這個類型轉換器,主要是在處理@Value時需要使用
    		TypeConverter converter = getCustomTypeConverter();
    		if (converter == null) {
    			converter = bw;
    		}
    
    		Set<String> autowiredBeanNames = new LinkedHashSet<>(4);
    		// 得到符合下麵條件的屬性名稱
    		// 1.有setter方法
    		// 2.需要進行依賴檢查
    		// 3.不包含在XML配置中
    		// 4.不是簡單類型(基本數據類型,枚舉,日期等)
    		// 這裏可以看到XML配置優先級高於自動注入的優先級
    		String[] propertyNames = unsatisfiedNonSimpleProperties(mbd, bw);
    		for (String propertyName : propertyNames) {
    			try {
    				PropertyDescriptor pd = bw.getPropertyDescriptor(propertyName);
    				if (Object.class != pd.getPropertyType()) {
    					// 這裏獲取到的就是setter方法的參數,因為我們需要按照類型進行注入嘛
    					MethodParameter methodParam = BeanUtils.getWriteMethodParameter(pd);
    					
                        // 如果是PriorityOrdered在進行類型匹配時不會去匹配factoryBean
    					// 如果不是PriorityOrdered,那麼在查找對應類型的依賴的時候會會去匹factoryBean
    				 	// 這就是Spring的一種設計理念,實現了PriorityOrdered接口的Bean被認為是一種
                        // 最高優先級的Bean,這一類的Bean在進行為了完成裝配而去檢查類型時,
                        // 不去檢查factoryBean
                        // 具體可以參考PriorityOrdered接口上的註釋文檔
    					boolean eager = !(bw.getWrappedInstance() instanceof PriorityOrdered);
    					// 將參數封裝成為一個依賴描述符
    					// 依賴描述符會通過:依賴所在的類,字段名/方法名,依賴的具體類型等來描述這個依賴
    					DependencyDescriptor desc = new AutowireByTypeDependencyDescriptor(methodParam, eager);
    					// 解析依賴,這裡會處理@Value註解
                        // 另外,通過指定的類型到容器中查找對應的bean
    					Object autowiredArgument = resolveDependency(desc, beanName, autowiredBeanNames, converter);
    					if (autowiredArgument != null) {
    						// 將查找出來的依賴屬性添加到pvs中,後面會將這個pvs應用到bean上
    						pvs.add(propertyName, autowiredArgument);
    					}
    					// 註冊bean直接的依賴關係
    					for (String autowiredBeanName : autowiredBeanNames) {
    						registerDependentBean(autowiredBeanName, beanName);
    						if (logger.isDebugEnabled()) {
    							logger.debug("Autowiring by type from bean name '" + beanName + "' via property '" +
    									propertyName + "' to bean named '" + autowiredBeanName + "'");
    						}
    					}
    					autowiredBeanNames.clear();
    				}
    			}
    			catch (BeansException ex) {
    				throw new UnsatisfiedDependencyException(mbd.getResourceDescription(), beanName, propertyName, ex);
    			}
    		}
    	}
    
    
    resolveDependency

    這個方法在Spring雜談 | 什麼是ObjectFactory?什麼是ObjectProvider?已經做過分析了,本文不再贅述。

    可以看到,真正做事的方法是doResolveDependency

    @Override
    public Object resolveDependency(DependencyDescriptor descriptor, String requestingBeanName, Set<String> autowiredBeanNames, @Nullable TypeConverter typeConverter) throws BeansException {
    	// descriptor代表當前需要注入的那個字段,或者方法的參數,也就是注入點
        // ParameterNameDiscovery用於解析方法參數名稱
        descriptor.initParameterNameDiscovery(getParameterNameDiscoverer());
        // 1. Optional<T>
        if (Optional.class == descriptor.getDependencyType()) {
            return createOptionalDependency(descriptor, requestingBeanName);
        // 2. ObjectFactory<T>、ObjectProvider<T>
        } else if (ObjectFactory.class == descriptor.getDependencyType() ||
                 ObjectProvider.class == descriptor.getDependencyType()) {
            return new DependencyObjectProvider(descriptor, requestingBeanName);
        // 3. javax.inject.Provider<T>
        } else if (javaxInjectProviderClass == descriptor.getDependencyType()) {
            return new Jsr330Factory().createDependencyProvider(descriptor, requestingBeanName);
        } else {
            // 4. @Lazy
            Object result = getAutowireCandidateResolver().getLazyResolutionProxyIfNecessary(
                descriptor, requestingBeanName);
            // 5. 正常情況
            if (result == null) {
                result = doResolveDependency(descriptor, requestingBeanName, autowiredBeanNames, typeConverter);
            }
            return result;
        }
    }
    
    doResolveDependency
    	public Object doResolveDependency(DependencyDescriptor descriptor, @Nullable String beanName,
    			@Nullable Set<String> autowiredBeanNames, @Nullable TypeConverter typeConverter) throws BeansException {
    
    		InjectionPoint previousInjectionPoint = ConstructorResolver.setCurrentInjectionPoint(descriptor);
    		try {
    			Object shortcut = descriptor.resolveShortcut(this);
    			if (shortcut != null) {
    				return shortcut;
    			}
    			// 依賴的具體類型
    			Class<?> type = descriptor.getDependencyType();
    			// 處理@Value註解,這裏得到的時候@Value中的值
    			Object value = getAutowireCandidateResolver().getSuggestedValue(descriptor);
    			if (value != null) {
    				if (value instanceof String) {
    					// 解析@Value中的佔位符
    					String strVal = resolveEmbeddedValue((String) value);
    					// 獲取到對應的bd
    					BeanDefinition bd = (beanName != null && containsBean(beanName) ? getMergedBeanDefinition(beanName) : null);
    					// 處理EL表達式
    					value = evaluateBeanDefinitionString(strVal, bd);
    				}
    				// 通過解析el表達式可能還需要進行類型轉換
    				TypeConverter converter = (typeConverter != null ? typeConverter : getTypeConverter());
    				return (descriptor.getField() != null ?
    						converter.convertIfNecessary(value, type, descriptor.getField()) :
    						converter.convertIfNecessary(value, type, descriptor.getMethodParameter()));
    			}
    			
                // 對map,collection,數組類型的依賴進行處理
    			// 最終會根據集合中的元素類型,調用findAutowireCandidates方法
    			Object multipleBeans = resolveMultipleBeans(descriptor, beanName, autowiredBeanNames, typeConverter);
    			if (multipleBeans != null) {
    				return multipleBeans;
    			}
    			
                // 根據指定類型可能會找到多個bean
                // 這裏返回的既有可能是對象,也有可能是對象的類型
                // 這是因為到這裏還不能明確的確定當前bean到底依賴的是哪一個bean
                // 所以如果只會返回這個依賴的類型以及對應名稱,最後還需要調用getBean(beanName)
                // 去創建這個Bean
    			Map<String, Object> matchingBeans = findAutowireCandidates(beanName, type, descriptor);
    			// 一個都沒找到,直接拋出異常
    			if (matchingBeans.isEmpty()) {
    				if (isRequired(descriptor)) {
    					raiseNoMatchingBeanFound(type, descriptor.getResolvableType(), descriptor);
    				}
    				return null;
    			}
    
    			String autowiredBeanName;
    			Object instanceCandidate;
    			// 通過類型找到了多個
    			if (matchingBeans.size() > 1) {
    				// 根據是否是主Bean
    				// 是否是最高優先級的Bean
    				// 是否是名稱匹配的Bean
    				// 來確定具體的需要注入的Bean的名稱
                    // 到這裏可以知道,Spring在查找依賴的時候遵循先類型再名稱的原則(沒有@Qualifier註解情況下)
    				autowiredBeanName = determineAutowireCandidate(matchingBeans, descriptor);
    				if (autowiredBeanName == null) {
    					// 無法推斷出具體的名稱
    					// 如果依賴是必須的,直接拋出異常
    					// 如果依賴不是必須的,但是這個依賴類型不是集合或者數組,那麼也拋出異常
    					if (isRequired(descriptor) || !indicatesMultipleBeans(type)) {
    						return descriptor.resolveNotUnique(type, matchingBeans);
    					}
    					// 依賴不是必須的,但是依賴類型是集合或者數組,那麼返回一個null
    					else {
    						return null;
    					}
    				}
    				instanceCandidate = matchingBeans.get(autowiredBeanName);
    			}
    			else {
    				// 直接找到了一個對應的Bean
    				Map.Entry<String, Object> entry = matchingBeans.entrySet().iterator().next();
    				autowiredBeanName = entry.getKey();
    				instanceCandidate = entry.getValue();
    			}
    			if (autowiredBeanNames != null) {
    				autowiredBeanNames.add(autowiredBeanName);
    			}
                
                // 前面已經說過了,這裏可能返回的是Bean的類型,所以需要進一步調用getBean
    			if (instanceCandidate instanceof Class) {
    				instanceCandidate = descriptor.resolveCandidate(autowiredBeanName, type, this);
    			}
                
                // 做一些檢查,如果依賴是必須的,查找出來的依賴是一個null,那麼報錯
                // 查詢處理的依賴類型不符合,也報錯
    			Object result = instanceCandidate;
    			if (result instanceof NullBean) {
    				if (isRequired(descriptor)) {
    					raiseNoMatchingBeanFound(type, descriptor.getResolvableType(), descriptor);
    				}
    				result = null;
    			}
    			if (!ClassUtils.isAssignableValue(type, result)) {
    				throw new BeanNotOfRequiredTypeException(autowiredBeanName, type, instanceCandidate.getClass());
    			}
    			return result;
    		}
    		finally {
    			ConstructorResolver.setCurrentInjectionPoint(previousInjectionPoint);
    		}
    	}
    
    findAutowireCandidates
    protected Map<String, Object> findAutowireCandidates(
        @Nullable String beanName, Class<?> requiredType, DependencyDescriptor descriptor) {
    	
        // 簡單來說,這裏就是到容器中查詢requiredType類型的所有bean的名稱的集合
        // 這裡會根據descriptor.isEager()來決定是否要匹配factoryBean類型的Bean
        // 如果isEager()為true,那麼會匹配factoryBean,反之,不會
        String[] candidateNames = BeanFactoryUtils.beanNamesForTypeIncludingAncestors(
            this, requiredType, true, descriptor.isEager());
       
        Map<String, Object> result = new LinkedHashMap<>(candidateNames.length);
       
        // 第一步會到resolvableDependencies這個集合中查詢是否已經存在了解析好的依賴
        // 像我們之所以能夠直接在Bean中注入applicationContext對象
        // 就是因為Spring之前就將這個對象放入了resolvableDependencies集合中
        for (Class<?> autowiringType : this.resolvableDependencies.keySet()) {
            if (autowiringType.isAssignableFrom(requiredType)) {
                Object autowiringValue = this.resolvableDependencies.get(autowiringType);
                
                // 如果resolvableDependencies放入的是一個ObjectFactory類型的依賴
                // 那麼在這裡會生成一個代理對象
                // 例如,我們可以在controller中直接注入request對象
                // 就是因為,容器啟動時就在resolvableDependencies放入了一個鍵值對
                // 其中key為:Request.class,value為:ObjectFactory
                // 在實際注入時放入的是一個代理對象
                autowiringValue = AutowireUtils.resolveAutowiringValue(autowiringValue, requiredType);
                if (requiredType.isInstance(autowiringValue)) {
                    // 這裏放入的key不是Bean的名稱
                    // value是實際依賴的對象
                    result.put(ObjectUtils.identityToString(autowiringValue), autowiringValue);
                    break;
                }
            }
        }
        
        // 接下來開始對之前查找出來的類型匹配的所有BeanName進行處理
        for (String candidate : candidateNames) {
            // 不是自引用,什麼是自引用?
            // 1.候選的Bean的名稱跟需要進行注入的Bean名稱相同,意味着,自己注入自己
            // 2.或者候選的Bean對應的factoryBean的名稱跟需要注入的Bean名稱相同,
            // 也就是說A依賴了B但是B的創建又需要依賴A
            // 要符合注入的條件
            if (!isSelfReference(beanName, candidate) && isAutowireCandidate(candidate, descriptor)) {
                // 調用addCandidateEntry,加入到返回集合中,後文有對這個方法的分析
                addCandidateEntry(result, candidate, descriptor, requiredType);
            }
        }
        
        // 排除自引用的情況下,沒有找到一個合適的依賴
        if (result.isEmpty() && !indicatesMultipleBeans(requiredType)) {
            // 1.先走fallback邏輯,Spring提供的一個擴展吧,感覺沒什麼卵用
            // 默認情況下fallback的依賴描述符就是自身
            DependencyDescriptor fallbackDescriptor = descriptor.forFallbackMatch();
            for (String candidate : candidateNames) {
                if (!isSelfReference(beanName, candidate) && isAutowireCandidate(candidate, fallbackDescriptor)) {
                    addCandidateEntry(result, candidate, descriptor, requiredType);
                }
            }
            // fallback還是失敗
            if (result.isEmpty()) {
                // 處理自引用
                // 從這裏可以看出,自引用的優先級是很低的,只有在容器中真正的只有這個Bean能作為
                // 候選者的時候,才會去處理,否則自引用是被排除掉的
                for (String candidate : candidateNames) {
                    if (isSelfReference(beanName, candidate) &&
                        // 不是一個集合或者
                        // 是一個集合,但是beanName跟candidate的factoryBeanName相同
                        (!(descriptor instanceof MultiElementDescriptor) || !beanName.equals(candidate)) &&
                        isAutowireCandidate(candidate, fallbackDescriptor)) {
                        addCandidateEntry(result, candidate, descriptor, requiredType);
                    }
                }
            }
        }
        return result;
    }
    
    
    // candidates:就是findAutowireCandidates方法要返回的候選集合
    // candidateName:當前的這個候選Bean的名稱
    // descriptor:依賴描述符
    // requiredType:依賴的類型
    private void addCandidateEntry(Map<String, Object> candidates, String candidateName,
                                   DependencyDescriptor descriptor, Class<?> requiredType) {
    	
        // 如果依賴是一個集合,或者容器中已經包含這個單例了
        // 那麼直接調用getBean方法創建或者獲取這個Bean
        if (descriptor instanceof MultiElementDescriptor || containsSingleton(candidateName)) {
            Object beanInstance = descriptor.resolveCandidate(candidateName, requiredType, this);
            candidates.put(candidateName, (beanInstance instanceof NullBean ? null : beanInstance));
        }
        // 如果依賴的類型不是一個集合,這個時候還不能確定到底要使用哪個依賴,
        // 所以不能將這些Bean創建出來,所以這個時候,放入candidates是Bean的名稱以及類型
        else {
            candidates.put(candidateName, getType(candidateName));
        }
    }
    

    處理屬性注入(@Autowired)

    postProcessProperties

    // 在applyMergedBeanDefinitionPostProcessors方法執行的時候,
    // 已經解析過了@Autowired註解(buildAutowiringMetadata方法)
    public PropertyValues postProcessProperties(PropertyValues pvs, Object bean, String beanName) {
        // 這裏獲取到的是解析過的緩存好的注入元數據
        InjectionMetadata metadata = findAutowiringMetadata(beanName, bean.getClass(), pvs);
        try {
            // 直接調用inject方法
            // 存在兩種InjectionMetadata
            // 1.AutowiredFieldElement
            // 2.AutowiredMethodElement
            // 分別對應字段的屬性注入以及方法的屬性注入
            metadata.inject(bean, beanName, pvs);
        }
        catch (BeanCreationException ex) {
            throw ex;
        }
        catch (Throwable ex) {
            throw new BeanCreationException(beanName, "Injection of autowired dependencies failed", ex);
        }
        return pvs;
    }
    
    字段的屬性注入
    // 最終反射調用filed.set方法
    protected void inject(Object bean, @Nullable String beanName, @Nullable PropertyValues pvs) throws Throwable {
        Field field = (Field) this.member;
        Object value;
        if (this.cached) {
            // 第一次注入的時候肯定沒有緩存
            // 這裏也是對原型情況的處理
            value = resolvedCachedArgument(beanName, this.cachedFieldValue);
        } else {
            DependencyDescriptor desc = new DependencyDescriptor(field, this.required);
            desc.setContainingClass(bean.getClass());
            Set<String> autowiredBeanNames = new LinkedHashSet<>(1);
            Assert.state(beanFactory != null, "No BeanFactory available");
            TypeConverter typeConverter = beanFactory.getTypeConverter();
            try {
                // 這裏可以看到,對@Autowired註解在字段上的處理
                // 跟byType下自動注入的處理是一樣的,就是調用resolveDependency方法
                value = beanFactory.resolveDependency(desc, beanName, autowiredBeanNames, typeConverter);
            } catch (BeansException ex) {
                throw new UnsatisfiedDependencyException(null, beanName, new InjectionPoint(field), ex);
            }
            synchronized (this) {
                // 沒有緩存過的話,這裏需要進行緩存
                if (!this.cached) {
                    if (value != null || this.required) {
                        this.cachedFieldValue = desc;
                        // 註冊Bean之間的依賴關係
                        registerDependentBeans(beanName, autowiredBeanNames);
                        // 如果這個類型的依賴只存在一個的話,我們就能確定這個Bean的名稱
                        // 那麼直接將這個名稱緩存到ShortcutDependencyDescriptor中
                        // 第二次進行注入的時候就可以直接調用getBean(beanName)得到這個依賴了
                        // 實際上正常也只有一個,多個就報錯了
                        // 另外這裡會過濾掉@Vlaue得到的依賴
                        if (autowiredBeanNames.size() == 1) {
                            String autowiredBeanName = autowiredBeanNames.iterator().next();
                            // 通過resolvableDependencies這個集合找的依賴不滿足containsBean條件
                            // 不會進行緩存,因為緩存實際還是要調用getBean,而resolvableDependencies
                            // 是沒法通過getBean獲取的
                            if (beanFactory.containsBean(autowiredBeanName) &&
                                beanFactory.isTypeMatch(autowiredBeanName, field.getType())) {							 // 依賴描述符封裝成ShortcutDependencyDescriptor進行緩存
                                this.cachedFieldValue = new ShortcutDependencyDescriptor(
                                    desc, autowiredBeanName, field.getType());
                            }
                        }
                    } else {
                        this.cachedFieldValue = null;
                    }
                    this.cached = true;
                }
            }
        }
        if (value != null) {
            // 反射調用Field.set方法
            ReflectionUtils.makeAccessible(field);
            field.set(bean, value);
        }
    }
    
    方法的屬性注入
    // 代碼看着很長,實際上邏輯跟字段注入基本一樣
    protected void inject(Object bean, @Nullable String beanName, @Nullable PropertyValues pvs) throws Throwable {
        // 判斷XML中是否配置了這個屬性,如果配置了直接跳過
        // 換而言之,XML配置的屬性優先級高於@Autowired註解
        if (checkPropertySkipping(pvs)) {
            return;
        }
        Method method = (Method) this.member;
        Object[] arguments;
        if (this.cached) {
            arguments = resolveCachedArguments(beanName);
        } else {
            // 通過方法參數類型構造依賴描述符
            // 邏輯基本一樣的,最終也是調用beanFactory.resolveDependency方法
            Class<?>[] paramTypes = method.getParameterTypes();
            arguments = new Object[paramTypes.length];
            DependencyDescriptor[] descriptors = new DependencyDescriptor[paramTypes.length];
            Set<String> autowiredBeans = new LinkedHashSet<>(paramTypes.length);
            Assert.state(beanFactory != null, "No BeanFactory available");
            TypeConverter typeConverter = beanFactory.getTypeConverter();
            
            // 遍歷方法的每個參數
            for (int i = 0; i < arguments.length; i++) {
                MethodParameter methodParam = new MethodParameter(method, i);
                DependencyDescriptor currDesc = new DependencyDescriptor(methodParam, this.required);
                currDesc.setContainingClass(bean.getClass());
                descriptors[i] = currDesc;
                try {
                    // 還是要調用這個方法
                    Object arg = beanFactory.resolveDependency(currDesc, beanName, autowiredBeans, typeConverter);
                    if (arg == null && !this.required) {
                        arguments = null;
                        break;
                    }
                    arguments[i] = arg;
                } catch (BeansException ex) {
                    throw new UnsatisfiedDependencyException(null, beanName, new InjectionPoint(methodParam), ex);
                }
            }
            synchronized (this) {
                if (!this.cached) {
                    if (arguments != null) {
                        Object[] cachedMethodArguments = new Object[paramTypes.length];
                        System.arraycopy(descriptors, 0, cachedMethodArguments, 0, arguments.length);  
                        // 註冊bean之間的依賴關係
                        registerDependentBeans(beanName, autowiredBeans);
                        
                        // 跟字段注入差不多,存在@Value註解,不進行緩存
                        if (autowiredBeans.size() == paramTypes.length) {
                            Iterator<String> it = autowiredBeans.iterator();
                            for (int i = 0; i < paramTypes.length; i++) {
                                String autowiredBeanName = it.next();
                                if (beanFactory.containsBean(autowiredBeanName) &&
                                    beanFactory.isTypeMatch(autowiredBeanName, paramTypes[i])) {
                                    cachedMethodArguments[i] = new ShortcutDependencyDescriptor(
                                        descriptors[i], autowiredBeanName, paramTypes[i]);
                                }
                            }
                        }
                        this.cachedMethodArguments = cachedMethodArguments;
                    } else {
                        this.cachedMethodArguments = null;
                    }
                    this.cached = true;
                }
            }
        }
        if (arguments != null) {
            try {
                // 反射調用方法
                // 像我們的setter方法就是在這裏調用的
                ReflectionUtils.makeAccessible(method);
                method.invoke(bean, arguments);
            } catch (InvocationTargetException ex) {
                throw ex.getTargetException();
            }
        }
    }
    

    處理依賴檢查

    protected void checkDependencies(
        String beanName, AbstractBeanDefinition mbd, PropertyDescriptor[] pds, PropertyValues pvs)
        throws UnsatisfiedDependencyException {
    
        int dependencyCheck = mbd.getDependencyCheck();
        for (PropertyDescriptor pd : pds) {
            
            // 有set方法但是在pvs中沒有對應屬性,那麼需要判斷這個屬性是否要進行依賴檢查
            // 如果需要進行依賴檢查的話,就需要報錯了
            // pvs中保存的是自動注入以及XML配置的屬性
            if (pd.getWriteMethod() != null && !pvs.contains(pd.getName())) {
               
                // 是否是基本屬性,枚舉/日期等也包括在內
                boolean isSimple = BeanUtils.isSimpleProperty(pd.getPropertyType());
               	
                // 如果DEPENDENCY_CHECK_ALL,對任意屬性都開啟了依賴檢查,報錯
                // DEPENDENCY_CHECK_SIMPLE,對基本屬性開啟了依賴檢查並且是基本屬性,報錯
                // DEPENDENCY_CHECK_OBJECTS,對非基本屬性開啟了依賴檢查並且不是非基本屬性,報錯
                boolean unsatisfied = (dependencyCheck == AbstractBeanDefinition.DEPENDENCY_CHECK_ALL) ||
                    (isSimple && dependencyCheck == AbstractBeanDefinition.DEPENDENCY_CHECK_SIMPLE) ||
                    (!isSimple && dependencyCheck == AbstractBeanDefinition.DEPENDENCY_CHECK_OBJECTS);
                
                if (unsatisfied) {
                    throw new UnsatisfiedDependencyException(mbd.getResourceDescription(), beanName, pd.getName(),
                                                             "Set this property value or disable dependency checking for this bean.");
                }
            }
        }
    }
    

    將解析出來的屬性應用到Bean上

    到這一步解析出來的屬性主要有三個來源

    1. XML中配置的
    2. 通過byName的方式自動注入的
    3. 通過byType的方式自動注入的

    但是在應用到Bean前還需要做一步類型轉換,這一部分代碼實際上跟我們之前在Spring官網閱讀(十四)Spring中的BeanWrapper及類型轉換介紹的差不多,而且因為XML跟自動注入的方式都不常見,正常@Autowired的方式進行注入的話,這個方法沒有什麼用,所以本文就不再贅述。

    總結

    本文我們主要分析了Spring在屬性注入過程中的相關代碼,整個屬性注入可以分為兩個部分

    1. @Autowired/@Vale的方式完成屬性注入
    2. 自動注入(byType/byName)

    完成屬性注入的核心方法其實就是doResolveDependency。doResolveDependency這個方法的邏輯簡單來說分為兩步:

    1. 通過依賴類型查詢到所有的類型匹配的bean的名稱
    2. 如果找到了多個的話,再根據依賴的名稱匹配對應的Bean的名稱
    3. 調用getBean得到這個需要被注入的Bean
    4. 最後反射調用字段的set方法完成屬性注入

    從上面也可以知道,其實整個屬性注入的邏輯是很簡單的。

    如果本文對你有幫助的話,記得點個贊吧!也歡迎關注我的公眾號,微信搜索:程序員DMZ,或者掃描下方二維碼,跟着我一起認認真真學Java,踏踏實實做一個coder。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※台北網頁設計公司全省服務真心推薦

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※推薦評價好的iphone維修中心
  • 為什麼用抓包工具看HTTPS包是明文的

    為什麼用抓包工具看HTTPS包是明文的

    測試或者開發調試的過程中,經常會進行抓包分析,並且裝上抓包工具的證書就能抓取 HTTPS 的數據包並显示。由此就產生了一個疑問,為什麼抓包工具裝上證書後就能抓到 HTTPS 的包並显示呢?不是說 HTTPS 是加密傳輸的嗎?

    今天這篇文章就來探究下上面這個問題,要解釋清楚這個問題,我會通過解答以下兩個問題來講述:

    1. HTTPS 到底是什麼?
    2. 抓包工具抓包的原理?

    HTTPS 到底是什麼

    HTTP 作為一種被廣泛使用的傳輸協議,也存在一些的缺點:

    1. 無狀態(可以通過 Cookie 或 Session 解決);
    2. 明文傳輸;
    3. 不安全;

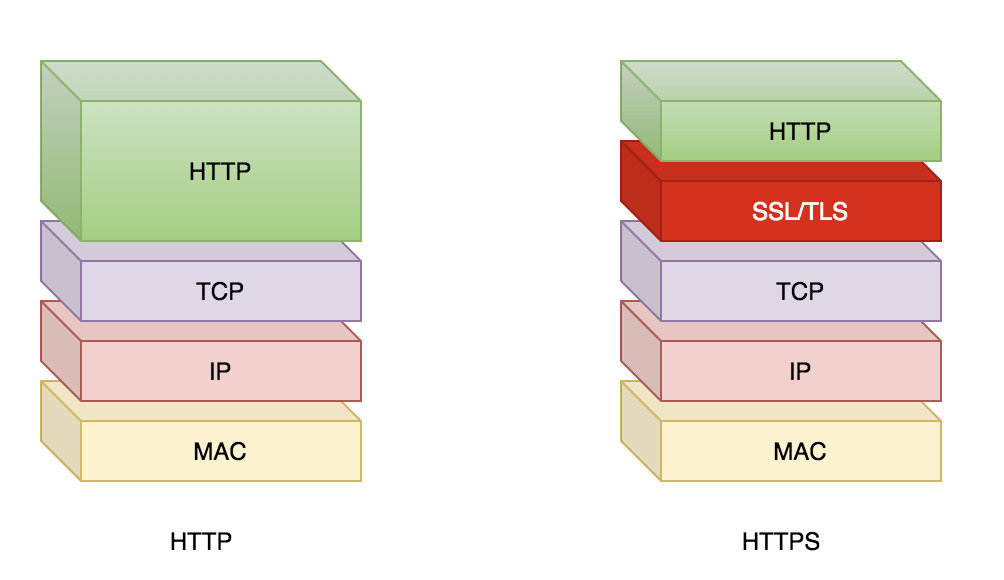
    為了解決 “明文” 和 “不安全” 兩個問題,就產生了 HTTPS。HTTPS 不是一種單獨的協議,它是由 HTTP + SSL/TLS 組成。

    HTTP與HTTPS

    所以要理解 HTTPS 就只需在 HTTP 的基礎上理解 SSL/TLS (TLS 是 SSL 的後續版本,現在一般使用 TLS),下面就來了解下 TLS 是什麼。

    TLS

    「傳輸層安全性協議」(英語:「T」ransport 「L」ayer 「S」ecurity,縮寫:「TLS」)及其前身「安全套接層」(英語:「S」ecure 「S」ockets 「L」ayer,縮寫:「SSL」)是一種「安全協議」,目的是為互聯網通信提供安全及「數據完整性」保障。

    TLS 由記錄協議、握手協議、警報協議、變更密碼規範協議、擴展協議等幾個子協議組成,綜合使用了對稱加密、非對稱加密、身份認證等許多密碼學前沿技術。

    • 「記錄協議」 規定
      TLS 收發數據的基本單位為:記錄。類似
      TCP 里的
      segment,所有其它子協議都需要通過記錄協議發出。
    • 「警報協議」 的職責是向對方發出警報信息,類似於
      HTTP 里的狀態碼。
    • 「握手協議」 是
      TLS 里最複雜的子協議,瀏覽器和服務器在握手過程中會協商
      TLS 版本號、隨機數、密碼套件等信息,然後交換證書和密鑰參數,最終雙方協商得到會話密鑰,用於後續的混合加密系統。
    • 「變更密碼規範協議」 用於告知對方,後續的數據都將使用加密傳輸。

    TLS 的握手過程:

    TLS握手過程

    握手過程抓包显示:

    TLS抓包
    TLS所傳輸的數據

    交換密鑰的過程為:

    1. 客戶端發起一個請求給服務器;
    2. 服務器生成一對非對稱的公鑰(
      pubkey)和私鑰(
      privatekey),然後把公鑰附加到一個
      CA数字證書 上返回給客戶端;
    3. 客戶端校驗該證書是否合法(通過瀏覽器內置的廠商根證書等手段校驗),然後從證書中提取出公鑰(
      pubkey);
    4. 客戶端生成一個隨機數(
      key),然後使用公鑰(
      pubkey)對這個隨機數進行加密后發送給服務器;
    5. 服務器利用私鑰(
      privatekey)對收到的隨機數密文進行解密得到
      key ;
    6. 後續客戶端和服務器傳輸數據使用該
      key 進行加密后再傳輸;

    抓包工具抓包的原理

    先來看看抓 HTTP 包的原理

    HTTP抓包過程

    1. 首先抓包工具會提供出代理服務,客戶端需要連接該代理;
    2. 客戶端發出
      HTTP 請求時,會經過抓包工具的代理,抓包工具將請求的原文進行展示;
    3. 抓包工具使用該原文將請求發送給服務器;
    4. 服務器返回結果給抓包工具,抓包工具將返回結果進行展示;
    5. 抓包工具將服務器返回的結果原樣返回給客戶端;

    抓包工具就相當於個透明的中間人,數據經過的時候它一隻手接到數據,然後另一隻手把數據傳出去。

    再來看看 HTTPS 的抓包

    HTTPS抓包過程

    這個時候抓包工具對客戶端來說相當於服務器,對服務器來說相當於客戶端。在這個傳輸過程中,客戶端會以為它就是目標服務器,服務器也會以為它就是請求發起的客戶端。

    1. 客戶端連接抓包工具提供的代理服務;
    2. 客戶端需要安裝抓包工具的根證書;
    3. 客戶端發出
      HTTPS 請求,抓包工具模擬服務器與客戶端進行
      TLS 握手交換密鑰等流程;
    4. 抓包工具發送一個
      HTTPS 請求給客戶端請求的目標服務器,並與目標服務器進行
      TLS 握手交換密鑰等流程;
    5. 客戶端使用與抓包工具協定好的密鑰加密數據后發送給抓包工具;
    6. 抓包工具使用與客戶端協定好的密鑰解密數據,並將結果進行展示;
    7. 抓包工具將解密后的客戶端數據,使用與服務器協定好的密鑰進行加密后發送給目標服務器;
    8. 服務器解密數據后,做對應的邏輯處理,然後將返回結果使用與抓包工具協定好的密鑰進行加密發送給抓包工具;
    9. 抓包工具將服務器返回的結果,用與服務器協定好的密鑰解密,並將結果進行展示;
    10. 抓包工具將解密后的服務器返回數據,使用與客戶端協定好的密鑰進行加密后發送給客戶端;
    11. 客戶端解密數據;

    總結

    • HTTPS 不是單獨的一個協議,它是
      HTTP +
      SSL/TLS 的組合;
    • TLS 是傳輸層安全性協議,它會對傳輸的
      HTTP 數據進行加密,使用非對稱加密和對稱加密的混合方式;
    • 抓包工具的原理就是“偽裝“,對客戶端偽裝成服務器,對服務器偽裝成客戶端;
    • 使用抓包工具抓
      HTTPS 包必須要將抓包工具的證書安裝到客戶端本地,並設置信任;
    • HTTPS 數據只是在傳輸時進行了加密,而抓包工具是接收到數據后再重新加密轉發,所以抓包工具抓到的
      HTTPS 包可以直接看到明文;

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※台北網頁設計公司這麼多該如何選擇?

    ※智慧手機時代的來臨,RWD網頁設計為架站首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※回頭車貨運收費標準

  • 【離散優化】覆蓋問題

    覆蓋問題

    我們知道設施選址問題有兩類基礎問題,分別是中值問題和覆蓋問題,下面要介紹的就是覆蓋問題。

    什麼是覆蓋問題?

    覆蓋問題是以所期望的服務範圍滿足大多數或者所有用戶需求為前提,確定設施的位置。覆蓋模型的思想是離服務設施較近的用戶越多,則服務越好。

    覆蓋問題的分類

    覆蓋問題主要分為兩類:

    • 集合覆蓋問題(Location Set Covering Problem,LSCP)
    • 最大覆蓋問題(Maximum Covering Location Problem,MCLP)

    覆蓋模型常用於哪些場景?

    由於 P-中值模型常以總距離或者總時間作為測度指標,使得其並不適用於一些特殊的場景,比如消防中心和救護車等應急設施的區位選址問題,而覆蓋模型則比較適用於這些場景。

    如何定義覆蓋?

    如果需求點 \(i\) 到備選設施點 \(j\) 的距離或者時間小於臨界值 \(D_c\),那麼稱需求點 \(i\) 被候選設施點 \(j\) 覆蓋。、

    下面介紹兩類覆蓋問題的數學模型表達

    集合覆蓋問題 (Location Set Covering Problem,LSCP)

    目標函數:

    \[\min \sum_{j \in J}x_j \]

    約束:

    \[\sum_{j \in N_i} x_j \geqslant 1 \quad \forall i \in I \tag{c-1} \]

    \[x_j \in \{0, 1\} \quad \forall j \in J \tag{c-2} \]

    其中,

    • \(N_i = \{j:a_{ij}=1\}\) 是覆蓋需求點 \(i\) 的候選設施點的集合,變量 \(a_{ij}\) 用來判斷需求點 \(i\) 是否被候選設施點 \(j\) 覆蓋,若是,則 \(a_{ij}=1\),否則 \(a_{ij}=0\)
    • 目標函數旨在尋求設施總量最小
    • 約束 \(c-1\) 保證每個需求點至少被一個設施服務範圍所覆蓋
    • 約束 \(c-2\) 是決策變量的取值範圍

    在某些場景中,集合覆蓋問題有以下兩個缺點:

    • 為了保證所有需求點均被覆蓋而引入過多的設施,以至於超出預算
    • 模型無法區分需求點的需求強度

    現實生活中,常常由於預算或者資源的約束,有限的設施不能保證空間中所有需求點都被覆蓋,此時,優先考慮需求強度大的需求點是十分必要的,下面要介紹的最大覆蓋模型就是為了解決這個問題而被提出。

    最大覆蓋問題(Maximum Covering Location Problem,MCLP)

    目標函數

    \[\max \sum_{i \in N_i} \omega_iz_i \]

    約束

    \[z_i \leqslant \sum_{j \in N_i}x_j \quad \forall i \in I \tag{c-1} \]

    \[\sum_{j\in J}x_j = p \tag{c-2} \]

    \[x_j \in \{0,1\} \quad \forall j \in J \tag{c-3} \]

    \[z_i = \{0, 1\} \quad \forall i \in I \tag{c-4} \]

    其中,

    • \(\omega_i\) 為需求點 \(i\) 的需求強度

    • \(z_i\) 用來判斷需求點 \(i\) 是否被覆蓋,若覆蓋,則為 1,否則為 0

    • 目標函數旨在尋求有限設施(\(p\) 個)覆蓋的需求最多

    • 約束 \(c-1\) 要求除非在備選設施點中已定位一個設施可以覆蓋需求點 \(i\),否則需求點 \(i\) 將不被記作被覆蓋

    • 約束 \(c-2\) 限制設施的總數為 \(p\)

    • 約束 \(c-3, c-4\) 是決策變量的取值範圍

    更多種類的選址問題

    以上介紹的覆蓋問題的基礎模型框架,然而具體問題一般是較為複雜的設施選址問題,這就需要我們對基礎模型設置不同的條件從而進行擴展,比如:

    • 用於環境污染防治的鄰避型設施選址問題
    • 用於不同服務等級的層次型設置選址問題
    • 用於商業競爭的競爭型設施選址問題
    • 選址問題也開始考慮動態、不確定性等因素

    總結

    總結以上兩類問題,我們可以發現最大覆蓋模型和集合覆蓋模型的主要區別在於對設施數量和需求強度的關注不同,前者一般適用於建設經費充足或者設施成本相同的情況,後者則適用於有設施成本約束的選址決策。

    參考文獻

    本文內容主要從論文《設施選址問題中的基礎模型與求解方法比較》總結而來。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • 記一次uboot升級過程的兩個坑

    記一次uboot升級過程的兩個坑

    背景

    之前做過一次uboot的升級,當時留下了一些記錄,本文摘錄其中比較有意思的兩個問題。

    啟動失敗問題

    問題簡述

    uboot代碼中用到了一個庫,考慮到庫本身跟uboot版本沒什麼關係,就直接把舊的庫文件拷貝過來使用。結果編譯鏈接是沒問題,啟動卻會卡住。

    消失的打印

    為了明確卡住的位置,就去修改了庫的源碼,添加一些打印(此時還是在舊版本uboot下編譯的),結果發現卡住的位置或隨着添加打印的變化而變化,且有些打印語句,添加后未打印出來。

    我決定先從這些神秘消失的打印入手。

    分析下uboot中的printf實現,最底層就是寫寄存器,是一個同步的函數,也沒什麼可疑的地方。

    為了確認打印不出來的時候,到底有沒有調用到printf,我決定給printf增加一個計數器,在gd結構體中,增加一個printf_count字段,初始化為0,每次打印時執行printf_count++並打印出值。

    設計這個試驗,本意是確認未打印出來時是否確實也調用到了printf,但卻有了別的發現,實驗結果中printf_count值會異常變化,不是按打印順序遞增,而是會突變成很大的異常值。

    printf_count是gd結構體的成員,那就是gd的問題了。進一步將uboot全局結構體gd的地址打印出來。確認了原因是gd結構體的指針變化了。

    這也可以解釋部分打印消失的現象,原因是我們在gd中有另一個字段,用於控制打印等級。當gd被改動了,printf就可能解析出錯,誤以為打印等級為0而提前返回。

    gd的實現

    那麼好端端的,gd為什麼會被改了呢?這就要先看看gd到底是怎麼實現的了。

    uboot中維護了一個全局的結構體gd。在代碼中加入

    DECLARE_GLOBAL_DATA_PTR;
    

    即可使用gd指針訪問這個全局結構體,許多地方都會藉助gd來保存傳遞信息。

    進一步看看這個宏的定義

    舊版本uboot:
    #define DECLARE_GLOBAL_DATA_PTR        register volatile gd_t *gd asm ("r8")
    
    新版本uboot:
    #define DECLARE_GLOBAL_DATA_PTR        register volatile gd_t *gd asm ("r9")
    

    居然不一樣,一個是將gd的值放到r8寄存器,一個是放在r9寄存器。

    那麼就可以猜測到,庫是在舊版本uboot中編譯出來的,可能使用了r9,那麼放到新版本uboot中去,就會破壞r9寄存器中保存的gd值,導致一系列依賴gd的代碼不能正常工作。

    驗證改動

    為了求證,將庫反彙編出來,發現確實避開了r8寄存器,但使用了r9寄存器。

    說明uboot在指定gd寄存器的同時,還有某種方法讓其他代碼不使用這個寄存器。

    那是不是把舊uboot中的這個r8改成r9,重新編譯庫就可以了呢?試一下,還是不行。

    那麼禁止其他代碼使用r8寄存器肯定就是通過別的方式實現的了。簡單粗暴地在舊版本uboot下搜索r8,去掉.c .h等類型后,很容易發現了

    ./arch/arm/cpu/armv7/config.mk:24:PLATFORM_RELFLAGS += -fno-common -ffixed-r8 -msoft-floa
    

    將-ffixed-r8修改為-ffixed-r9,重新編譯出庫,這回就可以正常工作了,打印正常,啟動正常。反彙編出來也可以看到,新編譯出來的庫用了r8沒有用r9。

    當然更好的改法,是直接在新版本的uboot中編譯,這是最可靠的。

    追本溯源

    話說回來,為什麼兩個版本的uboot,會使用不同的寄存器呢?難道有什麼坑?

    這就得去翻一下git記錄了。

    commit fe1378a961e508b31b1f29a2bb08ba1dac063155
    Author: Jeroen Hofstee <jeroen@myspectrum.nl>
    Date:   Sat Sep 21 14:04:41 2013 +0200
    
        ARM: use r9 for gd
        
        To be more EABI compliant and as a preparation for building
        with clang, use the platform-specific r9 register for gd
        instead of r8.
        
        note: The FIQ is not updated since it is not used in u-boot,
        and under discussion for the time being.
        
        The following checkpatch warning is ignored:
        WARNING: Use of volatile is usually wrong: see
        Documentation/volatile-considered-harmful.txt
        
        Signed-off-by: Jeroen Hofstee <jeroen@myspectrum.nl>
        cc: Albert ARIBAUD <albert.u.boot@aribaud.net>
    

    從git記錄中,也可以確認完整地將r8切換到r9,都需要做哪些修改

    diff --git a/arch/arm/config.mk b/arch/arm/config.mk
    index 16c2e3d1e0..d0cf43ff41 100644
    --- a/arch/arm/config.mk
    +++ b/arch/arm/config.mk
    @@ -17,7 +17,7 @@ endif
     
     LDFLAGS_FINAL += --gc-sections
     PLATFORM_RELFLAGS += -ffunction-sections -fdata-sections \
    -                     -fno-common -ffixed-r8 -msoft-float
    +                     -fno-common -ffixed-r9 -msoft-float
     
     # Support generic board on ARM
     __HAVE_ARCH_GENERIC_BOARD := y
    diff --git a/arch/arm/cpu/armv7/lowlevel_init.S b/arch/arm/cpu/armv7/lowlevel_init.S
    index 82b2b86520..69e3053a42 100644
    --- a/arch/arm/cpu/armv7/lowlevel_init.S
    +++ b/arch/arm/cpu/armv7/lowlevel_init.S
    @@ -22,11 +22,11 @@ ENTRY(lowlevel_init)
            ldr     sp, =CONFIG_SYS_INIT_SP_ADDR
            bic     sp, sp, #7 /* 8-byte alignment for ABI compliance */
     #ifdef CONFIG_SPL_BUILD
    -       ldr     r8, =gdata
    +       ldr     r9, =gdata
     #else
            sub     sp, #GD_SIZE
            bic     sp, sp, #7
    -       mov     r8, sp
    +       mov     r9, sp
     #endif
            /*
             * Save the old lr(passed in ip) and the current lr to stack
    diff --git a/arch/arm/include/asm/global_data.h b/arch/arm/include/asm/global_data.h
    index 79a9597419..e126436093 100644
    --- a/arch/arm/include/asm/global_data.h
    +++ b/arch/arm/include/asm/global_data.h
    @@ -47,6 +47,6 @@ struct arch_global_data {
     
     #include <asm-generic/global_data.h>
     
    -#define DECLARE_GLOBAL_DATA_PTR     register volatile gd_t *gd asm ("r8")
    +#define DECLARE_GLOBAL_DATA_PTR     register volatile gd_t *gd asm ("r9")
     
     #endif /* __ASM_GBL_DATA_H */
    diff --git a/arch/arm/lib/crt0.S b/arch/arm/lib/crt0.S
    index 960d12e732..ac54b9359a 100644
    --- a/arch/arm/lib/crt0.S
    +++ b/arch/arm/lib/crt0.S
    @@ -69,7 +69,7 @@ ENTRY(_main)
            bic     sp, sp, #7      /* 8-byte alignment for ABI compliance */
            sub     sp, #GD_SIZE    /* allocate one GD above SP */
            bic     sp, sp, #7      /* 8-byte alignment for ABI compliance */
    -       mov     r8, sp          /* GD is above SP */
    +       mov     r9, sp          /* GD is above SP */
            mov     r0, #0
            bl      board_init_f
     
    @@ -81,15 +81,15 @@ ENTRY(_main)
      * 'here' but relocated.
      */
     
    -       ldr     sp, [r8, #GD_START_ADDR_SP]     /* sp = gd->start_addr_sp */
    +       ldr     sp, [r9, #GD_START_ADDR_SP]     /* sp = gd->start_addr_sp */
            bic     sp, sp, #7      /* 8-byte alignment for ABI compliance */
    -       ldr     r8, [r8, #GD_BD]                /* r8 = gd->bd */
    -       sub     r8, r8, #GD_SIZE                /* new GD is below bd */
    +       ldr     r9, [r9, #GD_BD]                /* r9 = gd->bd */
    +       sub     r9, r9, #GD_SIZE                /* new GD is below bd */
     
            adr     lr, here
    -       ldr     r0, [r8, #GD_RELOC_OFF]         /* r0 = gd->reloc_off */
    +       ldr     r0, [r9, #GD_RELOC_OFF]         /* r0 = gd->reloc_off */
            add     lr, lr, r0
    -       ldr     r0, [r8, #GD_RELOCADDR]         /* r0 = gd->relocaddr */
    +       ldr     r0, [r9, #GD_RELOCADDR]         /* r0 = gd->relocaddr */
            b       relocate_code
     here:
     
    @@ -111,8 +111,8 @@ clbss_l:cmp r0, r1                  /* while not at end of BSS */
            bl red_led_on
     
            /* call board_init_r(gd_t *id, ulong dest_addr) */
    -       mov     r0, r8                  /* gd_t */
    -       ldr     r1, [r8, #GD_RELOCADDR] /* dest_addr */
    +       mov     r0, r9                  /* gd_t */
    +       ldr     r1, [r9, #GD_RELOCADDR] /* dest_addr */
            /* call board_init_r */
            ldr     pc, =board_init_r       /* this is auto-relocated! */
    

    啟動慢問題

    問題簡述

    填了幾個坑之後,新的uboot可以啟動到內核了,但發現啟動速度非常慢,內核啟動速度慢了接近10倍!明明是同一個內核,為什麼差異這麼大。

    排查寄存器

    初步排查了下設備樹配置,以及uboot跳轉內核前的一些關鍵寄存器,確實在兩個版本的uboot中有所不同,但具體去看這些不同,發現都不會影響速度,將一些驅動對齊之後寄存器差異基本就消失了。

    差異的分界

    那再細看,kernel的速度有差異,uboot呢?在哪個時間點之後,速度開始產生差異?

    嘗試在兩個版本的uboot中插入一些操作,對比時間戳,發現兩個uboot在某個節點之後的速度確實有區別。

    進一步排查,原來是在打開cache操作之後,舊uboot的速度就會比新uboot快。嘗試將舊uboot的cache關掉,則二者基本一致。嘗試將舊uboot操作cache的代碼,移植到新uboot,未發生改變。

    此時可確認新uboot的開cache有問題。但覺得這個跟kernel啟動慢沒關係。因為uboot進入kernel之前都會關cache,由kernel自己去重新打開。

    也就是不管是用哪份uboot,也不管uboot中是否開了cache,對kernel階段都應該沒有影響才對。

    於是記錄下來uboot的這個問題,待後續修復。先繼續找kernel啟動慢的原因。(注:現在看來當時的做法是有問題的,這裏的異常這麼明顯,應該設法追蹤下去找出原因才對)

    鎖定uboot

    uboot的嫌疑非常大,但還不能完全確認,因為uboot之前還有一級spl。是否會是spl的問題呢?

    嘗試改用新spl+舊uboot,啟動速度正常。而新spl+新uboot的啟動速度則很慢,其他因素都不變,說明問題確實出在uboot階段。

    多做or少做

    當時到這一步就卡住了,直接比較兩份uboot的代碼不太現實,差異太大了。

    後來我就給自己提了個問題,到底新uboot是多做了某件事情,還是少做了某件事情?

    換個說法,目前已知

    spl --> 舊uboot --> kernel(速度快)
    spl --> 新uboot --> kernel(速度快)
    

    但到底是以下的情況A還是情況B呢?

    A: spl(速度慢) --> 舊uboot(做了某個會提升速度的操作) --> kernel(速度快)
       spl(速度慢) --> 新uboot(少做了某個會提升速度的操作) --> kernel(速度慢)
    
    B: spl(速度快) --> 舊uboot(沒做特殊操作) --> kernel(速度快)
       spl(速度快) --> 新uboot(多做了某個會限制速度的操作) --> kernel(速度慢)
    

    為了驗證,我決定讓spl直接啟動內核,看看內核到底是快是慢。

    支持過程碰到了一些小問題

    1.spl沒有能力加載這麼大的kernel

    解決:此時不需要kernel能完全啟動,只需要能加載啟動一段,足以體現出啟動速度是否正常即可,於是裁剪出一個非常小kernel來輔助實驗。

    2.kernel需要dtb

    解決:內核有一個CONFIG_BUILD_ARM_APPENDED_DTB_IMAGE選項。選上重新編譯。編譯后再用dd將kernel和dtb拼接到一起,作為新的kernel。這樣,spl就只需要加載一個文件並跳轉過去即可。

    試驗結果,spl啟動的kernel和使用新uboot啟動的kernel速度一致,均比舊uboot啟動的kernel慢。

    說明,舊uboot中做了某個關鍵操作,而新uboot沒做。

    找出關鍵操作

    那接下來的任務就是,找出舊uboot中的這個關鍵操作了。

    怎麼找呢?有了上一步的成果,我們可以使用以下方法來排查

    1. spl加載kernel和舊uboot

    2. spl跳轉到舊uboot,此時kernel其實已經在dram中準備好了,隨時可以啟動

    3. 在舊uboot的啟動流程各個階段,嘗試直接跳轉到kernel,觀察啟動速度

    4. 如果在舊uboot的A點跳轉kernel啟動慢,B點跳轉啟動快,則說明關鍵操作位於AB點之間。

    方法有了,很快就鎖定到start.S,進一步在start.S中揪出了這段代碼

    #if defined(CONFIG_ARM_A7)
    @set SMP bit
        mrc     p15, 0, r0, c1, c0, 1
        orr        r0, r0, #(1<<6)
        mcr        p15, 0, r0, c1, c0, 1
    #endif
    

    新uboot的start.S中沒有這段代碼,嘗試在新uboot的start.S中添加此操作,速度立馬恢復正常了。

    再全局搜索下,原來這個新版本uboot中,套路是在board_init中進行此項設置的,而這個平台從舊版本移植過來,就沒有設置 SMP bit, 補上即可。

    SMP bit是什麼

    SMP 是指對稱多處理器,看起來這個 bit 會影響多核的 cache一致性,此處沒有再深入研究。

    但可以知道,對於單處理器的情況,也需要設置這個bit才能正常使用cache。

    貼下arm的圖和描述:

    [6]	SMP	
    
    Signals if the Cortex-A9 processor is taking part in coherency or not.
    
    In uniprocessor configurations, if this bit is set, then Inner Cacheable Shared is treated as Cacheable. The reset value is zero.
    

    搜下kernel的代碼,發現也是有地方調用了的。不過這個芯片是單核的,根本就沒配置CONFIG_SMP。

    #ifdef CONFIG_SMP
    	ALT_SMP(mrc	p15, 0, r0, c1, c0, 1)
    	ALT_UP(mov	r0, #(1 << 6))		@ fake it for UP
    	tst	r0, #(1 << 6)			@ SMP/nAMP mode enabled?
    	orreq	r0, r0, #(1 << 6)		@ Enable SMP/nAMP mode
    	orreq	r0, r0, r10			@ Enable CPU-specific SMP bits
    	mcreq	p15, 0, r0, c1, c0, 1
    #endif
    

    總結

    整理出來一方面是記錄這兩個bug,另一方面也是想記錄下當時的一些操作。

    畢竟同樣的bug可能以後都不會碰到了,但解bug的方法和思路卻是可以積累復用的。

    blog: https://www.cnblogs.com/zqb-all/p/13172546.html
    公眾號:https://sourl.cn/shT3kz

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計最專業,超強功能平台可客製化

  • Python 為什麼不支持 i++ 自增語法,不提供 ++ 操作符?

    Python 為什麼不支持 i++ 自增語法,不提供 ++ 操作符?

    在 C/C++/Java 等等語言中,整型變量的自增或自減操作是標配,它們又可分為前綴操作(++i 和 –i)與後綴操作(i++ 和 i–),彼此存在着一些細微差別,各有不同的用途。

    這些語言的使用者在接觸 Python 時,可能會疑惑為什麼它不提供 ++ 或 — 的操作呢?在我前不久發的《Python的十萬個為什麼?》里,就有不少同學在調查問卷中表示了對此話題感興趣。

    Python 中雖然可能出現 ++i 這種前綴形式的寫法,但是它並沒有“++”自增操作符,此處只是兩個“+”(正數符號)的疊加而已,至於後綴形式的“++”,則完全不支持(SyntaxError: invalid syntax)。

    本期“Python為什麼 ”欄目,我們將會從兩個主要的角度來回答:Python 為什麼不支持 i++ 自增語法? (PS:此處自增指代“自增和自減”,下同)

    首先,Python 當然可以實現自增效果,即寫成i += 1 或者 i = i + 1 ,這在其它語言中也是通用的。

    雖然 Python 在底層用了不同的魔術方法(__add__() 和 __iadd__() )來完成計算,但表面上的效果完全相同。

    所以,我們的問題可以轉化成:為什麼上面的兩種寫法會勝過 i++,成為 Python 的最終選擇呢?

    1、Python 的整數是不可變類型

    當我們定義i = 1000 時,不同語言會作出不同的處理:

    • C 之類的語言(寫法 int i = 1000)會申請一塊內存空間,並給它“綁定”一個固定的名稱 i,同時寫入一個可變的值 1000。在這裏,i 的地址以及類型是固定的,而值是可變的(在一定的表示範圍內)
    • Python(寫法i = 1000)也會申請一塊內存空間,但是它會“綁定”給数字 1000,即這個 1000 的地址以及類型是固定的(immutable),至於 i,只是一個名稱標籤貼在 1000 上,自身沒有固定的地址和類型

    所以當我們令 i “自增”時(i = i + 1),它們的處理是不同的:

    • C 之類的語言先找到 i 的地址上存的數值,然後令它加 1,操作后新的數值就取代了舊的數值
    • Python 的操作過程是把 i 指向的数字加 1,然後把結果綁定到新申請的一塊內存空間,再把名稱標籤 i “貼”到新的数字上。新舊数字可以同時存在,不是取代關係

    打一個不太恰當的比方:C 中的 i 就像一個宿主,数字 1000 寄生在它上面;而 Python 中的 1000 像個宿主,名稱 i 寄生在它上面。C 中的 i 與 Python 中的 1000,它們則寄生在底層的內存空間上……

    還可以這樣理解:C 中的變量 i 是一等公民,数字 1000 是它的一個可變的屬性;Python 中的数字 1000 是一等公民,名稱 i 是它的一個可變的屬性。

    有了以上的鋪墊,我們再來看看 i++,不難發現:

    • C 之類的語言,i++ 可以表示 i 的数字屬性的增加,它不會開闢新的內存空間,也不會產生新的一等公民
    • Python 之類的語言,i++ 如果是對其名稱屬性的操作,那樣就沒有意義了(總不能按字母表順序,把 i 變成 j 吧);如果理解成對数字本體的操作,那麼情況就會變得複雜:它會產生新的一等公民 1001,因此需要給它分配一個內存地址,此時若佔用 1000 的地址,則涉及舊對象的回收,那原有對於 1000 的引用關係都會受到影響,所以只能開闢新的內存空間給 1001

    Python 若支持 i++,其操作過程要比 C 的 i++ 複雜,而且其含義也不再是“令数字增加1”(自增),而是“創建一個新的数字”(新增), 這樣的話,“自增操作符”(increment operator)就名不副實了。

    Python 在理論上可以實現 i++ 操作,但它就必須重新定義“自增操作符”,還會令有其它語言經驗的人產生誤解,不如就讓大家直接寫成i += 1 或者 i = i + 1 好了。

    2、Python 有可迭代對象

    C/C++ 等語言設計出 i++,最主要的目的是為了方便使用三段式的 for 結構:

    for(int i = 0; i < 100; i++){
        // 執行 xxx
    }
    

    這種程序關心的是数字本身的自增過程,数字做加法與程序體的執行相關聯。

    Python 中沒有這種 for 結構的寫法,它提供了更為優雅的方式:

    for i in range(100):
        # 執行 xxx
    
    my_list = ["你好", "我是Python貓", "歡迎關注"]
    for info in my_list:
        print(info)
    

    這裏體現了不同的思維方式,它關心的是在一個數值範圍內的迭代遍歷,並不關心也不需要人為對数字做加法。

    Python 中的可迭代對象/迭代器/生成器提供了非常良好的迭代/遍歷用法,能夠做到對 i++ 的完全替代。

    例如,上例中實現了對列表內值的遍歷,Python 還可以用 enumerate() 實現對下標與具體值的同時遍歷:

    my_list = ["你好", "我是Python貓", "歡迎關注"]
    for i, info in enumerate(my_list):
        print(i, info)
    
    # 打印結果:
    0 你好
    1 我是Python貓
    2 歡迎關注
    

    再例如對於字典的遍歷,Python 提供了 keys()、values()、items() 等遍歷方法,非常好用:

    my_dict = {'a': '1', 'b': '2', 'c': '3'}
    for key in my_dict.keys():
        print(key)
    
    for key, value in my_dict.items():
        print(key, value)
    

    有了這樣的利器,哪裡還有 i++ 的用武之地呢?

    不僅如此,Python 中基本上很少使用i += 1 或者 i = i + 1 ,由於存在着隨處可見的可迭代對象,開發者們很容易實現對一個數值區間的操作,也就很少有對於某個數值作累加的訴求了。

    所以,回到我們開頭的問題,其實這兩種“自增”寫法並沒有勝出 i++ 多少,只因為它們是通用型操作,又不需要引入新的操作符,所以 Python 才延續了一種基礎性的支持。真正的贏家其實是各種各樣的可迭代對象!

    稍微小結下:Python 不支持自增操作符,一方面是因為它的整數是不可變類型的一等公民,自增操作(++)若要支持,則會帶來歧義;另一方面主要因為它有更合適的實現,即可迭代對象,對遍歷操作有很好的支持。

    如果你覺得本文分析得不錯,那你應該會喜歡這些文章:

    1、Python為什麼使用縮進來劃分代碼塊?

    2、Python 的縮進是不是反人類的設計?

    3、Python 為什麼不用分號作語句終止符?

    4、Python 為什麼沒有 main 函數?為什麼我不推薦寫 main 函數?

    5、Python 為什麼推薦蛇形命名法?

    寫在最後:本文屬於“Python為什麼”系列(Python貓出品),該系列主要關注 Python 的語法、設計和發展等話題,以一個個“為什麼”式的問題為切入點,試着展現 Python 的迷人魅力。部分話題會推出視頻版,請在 B 站收看,觀看地址:視頻地址

    公眾號【Python貓】, 本號連載優質的系列文章,有Python為什麼系列、喵星哲學貓系列、Python進階系列、好書推薦系列、技術寫作、優質英文推薦與翻譯等等,歡迎關注哦。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※教你寫出一流的銷售文案?

  • 手把手教你學Numpy,搞定數據處理——收官篇

    手把手教你學Numpy,搞定數據處理——收官篇

    本文始發於個人公眾號:TechFlow,原創不易,求個關注

    今天是Numpy專題第6篇文章,我們一起來看看Numpy庫當中剩餘的部分。

    數組的持久化

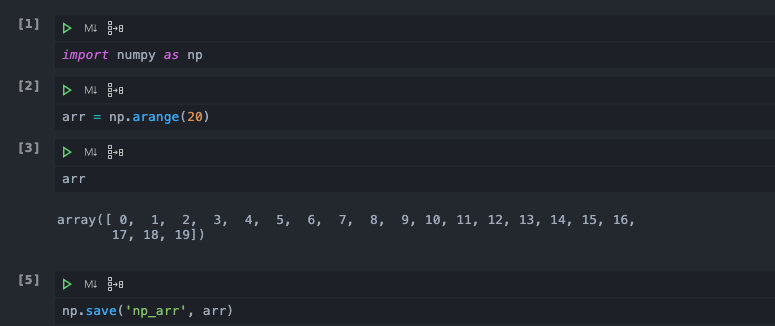
    在我們做機器學習模型的研究或者是學習的時候,在完成了訓練之後,有時候會希望能夠將相應的參數保存下來。否則的話,如果是在Notebook當中,當Notebook關閉的時候,這些值就丟失了。一般的解決方案是將我們需要的值或者是數組“持久化”,通常的做法是存儲在磁盤上。

    Python當中讀寫文件稍稍有些麻煩,我們還需要創建文件句柄,然後一行行寫入,寫入完成之後需要關閉句柄。即使是用with語句,也依然不夠簡便。針對這個問題,numpy當中自帶了寫入文件的api,我們直接調用即可。

    通過numpy當中save的文件是二進制格式的,所以我們是無法讀取其中內容的,即使強行打開也會是亂碼。

    以二進制的形式存儲數據避免了數據類型轉化的過程,尤其是numpy底層的數據是以C++實現的,如果使用Python的文件接口的話,勢必要先轉化成Python的格式,這會帶來大量開銷。既然可以存儲,自然也可以讀取,我們可以調用numpy的load函數將numpy文件讀取進來。

    要注意我們保存的時候沒有添加文件後綴,numpy會自動為我們添加後綴,但是讀取的時候必須要指定文件的全名,否則會numpy無法找到,會引發報錯。

    不僅如此,numpy還支持我們同時保存多個數組進入一個文件當中。

    我們使用savez來完成,在這個api當中我們傳入了a=arr,b=arr,其實是以類似字典的形式傳入的。在文件當中,numpy會將變量名和數組的值映射起來。這樣我們在讀入的時候,就可以通過變量名訪問到對應的值了。

    如果要存儲的數據非常大的話,我們還可以對數據進行壓縮,我們只需要更換savez成savez_compressed即可。

    線性代數

    Numpy除了科學計算之外,另外一大強大的功能就是支持矩陣運算,這也是它廣為流行並且在機器學習當中大受歡迎的原因之一。我們在之前的線性代數的文章當中曾經提到過Numpy這方面的一些應用,我們今天再在這篇文章當中匯總一些常用的線性代數的接口。

    點乘

    說起來矩陣點乘應該是最常用的線代api了,比如在神經網絡當中,如果拋開激活函數的話,一層神經元對於當前數據的影響,其實等價於特徵矩陣點乘了一個係數矩陣。再比如在邏輯回歸當中,我們計算樣本的加權和的時候,也是通過矩陣點乘來實現的。

    在Andrew的深度學習課上,他曾經做過這樣的實現,對於兩個巨大的矩陣進行矩陣相乘的運算。一次是通過Python的循環來實現,一次是通過Numpy的dot函數實現,兩者的時間開銷相差了足足上百倍。這當中的效率差距和Python語言的特性以及併發能力有關,所以在機器學習領域當中,我們總是將樣本向量化或者矩陣化,通過點乘來計算加權求和,或者是係數相乘。

    在Numpy當中我們採用dot函數來計算兩個矩陣的點積,既可以寫成a.dot(b),也可以寫成np.dot(a, b)。一般來說我更加喜歡前者,因為寫起來更加方便清晰。如果你喜歡後者也問題不大,這個只是個人喜好。

    注意不要寫成*,這個符號代表兩個矩陣元素兩兩相乘,而不是進行點積運算。它等價於np當中的multiply函數。

    轉置與逆矩陣

    轉置我們曾經在之前的文章當中提到過,可以通過.T或者是np.transpose來完成。

    Numpy中還提供了求解逆矩陣的操作,這個函數在numpy的linalg路徑下,這個路徑下實現了許多常用的線性代數函數。根據線性代數當中的知識,只有滿秩的方陣才有逆矩陣。我們可以通過numpy.linalg.det先來計算行列式來判斷,否則如果直接調用的話,對於沒有逆矩陣的矩陣會報錯。

    在這個例子當中,由於矩陣b的行列式為0,說明它並不是滿秩的,所以我們求它的逆矩陣會報錯。

    除了這些函數之外,linalg當中還封裝了其他一些常用的函數。比如進行qr分解的qr函數,進行奇異值分解的svd函數,求解線性方程組的solve函數等。相比之下,這些函數的使用頻率相對不高,所以就不展開一一介紹了,我們可以用到的時候再去詳細研究。

    隨機

    Numpy當中另外一個常用的領域就是隨機數,我們經常使用Numpy來生成各種各樣的隨機數。這一塊在Numpy當中其實也有很多的api以及很複雜的用法,同樣,我們不過多深入,挑其中比較重要也是經常使用的和大家分享一下。

    隨機數的所有函數都在numpy.random這個路徑下,我們為了簡化,就不寫完整的路徑了,大家記住就好。

    randn

    這個函數我們經常在代碼當中看到,尤其是我們造數據的時候。它代表的是根據輸入的shape生成一批均值為0,標準差為1的正態分佈的隨機數。

    要注意的是,我們傳入的shape不是一個元組,而是每一維的大小,這一點和其他地方的用法不太一樣,需要注意一下。除了正態分佈的randn之外,還有均勻分佈的uniform和Gamma分佈的gamma,卡方分佈的chisquare。

    normal

    normal其實也是生成正態分佈的樣本值,但不同的是,它支持我們指定樣本的均值和標準差。如果我們想要生成多個樣本,還可以在size參數當中傳入指定的shape。

    randint

    顧名思義,這個函數是用來生成隨機整數的。它接受傳入隨機數的上下界,最少也要傳入一個上界(默認下界是0)。

    如果想要生成多個int,我們可以在size參數傳入一個shape,它會返回一個對應大小的數組,這一點和uniform用法一樣。

    shuffle

    shuffle的功能是對一個數組進行亂序,返回亂序之後的結果。一般用在機器學習當中,如果存在樣本聚集的情況,我們一般會使用shuffle進行亂序,避免模型受到樣本分佈的影響。

    shuffle是一個inplace的方法,它會在原本值上進行改動,而不會返回一個新值。

    choice

    這也是一個非常常用的api,它可以在數據當中抽取指定條數據。

    但是它只支持一維的數組,一般用在批量訓練的時候,我們通過choice採樣出樣本的下標,再通過數組索引去找到這些樣本的值。比如這樣:

    總結

    今天我們一起研究了Numpy中數據持久化、線性代數、隨機數相關api的使用方法,由於篇幅的限制,我們只是選擇了其中比較常用,或者是比較重要的用法,還存在一些較為冷門的api和用法,大家感興趣的可以自行研究一下,一般來說文章當中提到的用法已經足夠了。

    今天這篇是Numpy專題的最後一篇了,如果你堅持看完本專題所有的文章,那麼相信你對於Numpy包一定有了一個深入的理解和認識了,給自己鼓鼓掌吧。之後周四會開啟Pandas專題,敬請期待哦。

    如果喜歡本文,可以的話,請點個關注,給我一點鼓勵,也方便獲取更多文章。

    本文使用 mdnice 排版

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※別再煩惱如何寫文案,掌握八大原則!

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

  • JAVA設計模式 2【創建型】原型模式的理解與使用、理解淺克隆和深克隆

    JAVA設計模式 2【創建型】原型模式的理解與使用、理解淺克隆和深克隆

    在本節中,我們將學習和使用原型模式;這一節學習的原型模式也是創建型 模式的其中之一。再次複習一下:創建型 模式就是描述如何去更好的創建一個對象。

    我們都知道,在JAVA 語言中。使用new 關鍵字創建一個新對象。將新的對象放到堆內存 裏面。當然,這個內存肯定是有大小限制的,況且,JAVA 不同於C語言等。 有內存管理機制,就是我們常說的垃圾回收器GC,才可以保證內存不被溢出。

    說這些其實就是為了表示:為啥要用單例模式,能節省內存的時候,能用一個對象解決重複的事情,絕對不會創建多個。

    概述

    原型模式描述的如何快速創建重複的對象,並且減少new 關鍵字的使用。

    • 抽象原型類
    • 具體原型類
    • 訪問類

    容我來一個一個解釋:

    抽象原型類 也就是我們具體要實現的某個類,這個類在JAVA 裏面是有具體的接口的,其實是一個空接口,Cloneable

     * @author  unascribed
     * @see     java.lang.CloneNotSupportedException
     * @see     java.lang.Object#clone()
     * @since   JDK1.0
     */
    public interface Cloneable {
    }
    

    我們會發現,這個類沒有任何的方法,怎麼來實現它,不要慌。先接着走。

    具體原型類 也就是我們具體要克隆 的對象。比如我們重複的要創建100個學生Student 對象,那麼具體的學生對象就是具體原型類

    public class Student implements Cloneable {
    
        private int id;
    
        private String name;
    
        private int sex;
    }
    

    訪問類 我就不必多說了

    淺克隆和深克隆

    原型模式其實也分淺克隆和深克隆。如何理解這兩個概念呢?

    淺克隆

    protected native Object clone() throws CloneNotSupportedException;
    

    淺克隆,只需要具體原型類 實現Cloneable 接口,並且重寫父類Object類的clone() 方法,即可實現對象的淺克隆。

    Student student1 = new Student(1, "李四");
    Student student2 = student1.clone();
    
    System.out.println(student1);
    System.out.println(student2);
    
    System.out.println(student1 == student2);
    ---------------------
    學號:1,姓名:李四
    學號:1,姓名:李四
    false
    
    • 通過執行clone() 方法即可創建一個相同的,具有同樣屬性的對象。
    • 並且是新的對象,內存地址有所不同。

    我們來看看,對於引用類型的變量,淺克隆是否可以進行克隆;

    Teacher teacher = new Teacher(1, "張老師");
    
    Student student1 = new Student(1, "李四", teacher);
    Student student2 = student1.clone();
    
    System.out.println(student1);
    System.out.println(student2);
    
    System.out.println(student1 == student2);
    ------------
    學號:1,姓名:李四,老師=Teacher@1b6d3586
    學號:1,姓名:李四,老師=Teacher@1b6d3586
    false
    

    我們發現,引用類型並沒有被克隆,也就是說:

    特點

    • 淺克隆對於基本類型,可以進行完全的克隆,並且克隆的對象是一個新的對象
    • 但是對象裏面的引用,是無法被克隆的。

    深克隆(序列化)

    何謂序列化?

    我們創建的都是保存在內存裏面的,只要被虛擬機GC進行回收,那麼這個對象的任何屬性都是消失,我們能不能找一個方法,將內存中這種對象的屬性以及對象的狀態通過某種東西保存下來,比如保存到數據庫,下次從數據庫將這個對象還原到內存裏面。 這就是序列化。

    • 序列化 內存對象->序列字符
    • 反序列化 序列字符->內存對象

    請參考: https://baike.baidu.com/item/序列化/2890184

    JAVA 序列化

     * @see java.io.Externalizable
     * @since   JDK1.1
     */
    public interface Serializable {
    }
    

    JAVA 提供了一個空接口,其實這個接口和上面的Cloneable 一樣,都是一個空接口,其實這個空接口就是作為一種標識 你的對象實現了這個接口,JAVA 認為你的這個就可以被序列化 ,就是這麼簡單。

    Teacher teacher = new Teacher(1, "張老師");
    
    ByteArrayOutputStream outputStream = new ByteArrayOutputStream();
    ObjectOutputStream stream = new ObjectOutputStream(outputStream);
    
    stream.writeObject(teacher);
    System.out.println(Arrays.toString(outputStream.toByteArray()));
    ----------
    [-84, -19, 0, 5, 115, 114, 0, 7, 84, 101, 97,。。。。。。
    

    通過將對象序列化、其實也就是將內存中的對象轉化為二進制 字節數組

    反序列化

    Teacher teacher = new Teacher(1, "張老師");
    System.out.println(teacher);
    
    ByteArrayOutputStream outputStream = new ByteArrayOutputStream();
    ObjectOutputStream stream = new ObjectOutputStream(outputStream);
    
    stream.writeObject(teacher);
    System.out.println(Arrays.toString(outputStream.toByteArray()));
    
    ByteArrayInputStream byteArrayInputStream = new ByteArrayInputStream(outputStream.toByteArray());
    ObjectInputStream inputStream = new ObjectInputStream(byteArrayInputStream);
    
    Teacher teacher1 = (Teacher) inputStream.readObject();
    System.out.println(teacher1);
    ---------------
    id=1,name=張老師
    [-84, -19, 0, 5, 115, xxxxx,-127, -27, -72, -120]
    id=1,name=張老師
    

    通過序列化和反序列化,即可對象的深克隆

    小結

    這一節,在講述 原型模式的同時,將原有實現原型模式的clone() 淺克隆,延伸到深克隆這一概念。其實JAVA 的原型模式,實現起來較為簡單。但還是要按需要實現,Object 類提供的 clone 淺克隆 是沒辦法克隆對象的引用類型的。需要克隆引用類型,還是需要序列化 深克隆

    參考

    http://c.biancheng.net/view/1343.html
    https://www.liaoxuefeng.com/wiki/1252599548343744/1298366845681698

    代碼示例

    https://gitee.com/mrc1999/Dev-Examples

    歡迎關注

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

    ※FB行銷專家,教你從零開始的技巧

  • Java多線程之內存模型

    Java多線程之內存模型

    目錄

    • 多線程需要解決的問題
      • 線程之間的通信
      • 線程之間的同步
    • Java內存模型
      • 內存間的交互操作
      • 指令屏障
      • happens-before規則
    • 指令重排序
      • 從源程序到字節指令的重排序
      • as-if-serial語義
      • 程序順序規則
    • 順序一致性模型
      • 順序一致性模型特性
      • 順序一致性模型特性
      • 當程序未正確同步會發生什麼
    • 參考資料

    多線程需要解決的問題

    在多線程編程中,線程之間如何通信和同步是一個必須解決的問題:

    線程之間的通信:

    線程之間有兩種通信的方式:消息傳遞和共享內存

    • 共享內存:線程之間共享程序的公共狀態,通過讀——寫修改公共狀態進行隱式通信。如上面代碼中的num和Lock可以被理解為公共狀態
    • 消息傳遞:線程之間沒有公共狀態,必須通過發送消息來進行显示通信
      在java中,線程是通過共享內存來完成線程之間的通信

    線程之間的同步:

    同步指程序中永固空值不同線程間的操作發生的相對順序的機制

    • 共享內存:同步是显示進行的,程序員需要指定某個方法或者某段代碼需要在線程之間互斥執行。如上面代碼中的Lock加鎖和解鎖之間的代碼塊,或者被synchronized包圍的代碼塊
    • 消息傳遞:同步是隱式執行的,因為消息的發送必然發生在消息的接收之前,例如使用Objetc#notify(),喚醒的線程接收信號一定在發送喚醒信號的發送之後。

    Java內存模型

    在java中,所有的實例域,靜態域、數組都被存儲在堆空間當中,堆內存在線程之間共享。

    所有的局部變量,方法定義參數和異常處理器參數不會被線程共享,在每個線程棧中獨享,他們不會存在可見性和線程安全問題。

    從Java線程模型(JMM)的角度來看,線程之間的共享變量存儲在主內存當中,每個線程擁有一個私有的本地內存(工作內存)本地內存存儲了該線程讀——寫共享的變量的副本。
    JMM只是一個抽象的概念,在現實中並不存在,其中所有的存儲區域都在堆內存當中。JMM的模型圖如下圖所示:

    而java線程對於共享變量的操作都是對於本地內存(工作內存)中的副本的操作,並沒有對共享內存中原始的共享變量進行操作;

    以線程1和線程2為例,假設線程1修改了共享變量,那麼他們之間需要通信就需要兩個步驟:

    1. 線程1本地內存中修改過的共享變量的副本同步到共享內存中去
    2. 線程2從共享內存中讀取被線程1更新過的共享變量
      這樣才能完成線程1的修改對線程2的可見。

    內存間的交互操作

    為了完成這一線程之間的通信,JMM為內存間的交互操作定義了8個原子操作,如下錶:

    操作 作用域 說明
    lock(鎖定) 共享內存中的變量 把一個變量標識為一條線程獨佔的狀態
    unlock(解鎖) 共享內存中的變量 把一個處於鎖定的變量釋放出來,釋放后其他線程可以進行訪問
    read(讀取) 共享內存中的變量 把一個變量的值從共享內存傳輸到線程的工作內存。供隨後的load操作使用
    load(載入) 工作內存 把read操作從共享內存中得到的變量值放入工作內存的變量副本當中
    use(使用) 工作內存 把工作內存中的一個變量值傳遞給執行引擎
    assign(賦值) 工作內存 把一個從執行引擎接受到的值賦值給工作內存的變量
    store(存儲) 作用於工作內存 把一個工作內存中的變量傳遞給共享內存,供後續的write使用
    write(寫入) 共享內存中的變量 把store操作從工作內存中得到的變量的值放入主內存

    JMM規定JVM四線時必須保證上述8個原子操作是不可再分割的,同時必須滿足以下的規則:

    1. 不允許read和load、store和write操作之一單獨出現,即不允許只從共享內存讀取但工作內存不接受,或者工作捏村發起回寫但是共享內存不接收
    2. 不允許一個線程捨棄assign操作,即當一個線程修改了變量后必須寫回工作內存和共享內存
    3. 不允許一個線程將未修改的變量值寫回共享內存
    4. 變量只能從共享內存中誕生,不允許線程直接使用未初始化的變量
    5. 一個變量同一時刻只能由一個線程對其執行lock操作,但是一個變量可以被同一個線程重複執行多次lock,但是需要相同次數的unlock
    6. 如果對一個變量執行lock操作,那麼會清空工作內存中此變量的值,在執行引擎使用這個變量之前需要重新執行load和assign
    7. 不允許unlock一個沒有被鎖定的變量,也不允許unlock一個其他線程lock的變量
    8. 對一個變量unlock之前必須把此變量同步回主存當中。

    對long和double的特殊操作
    在一些32位的處理器上,如果要求對64位的long和double的寫具有原子性,會有較大的開銷,為了照固這種情況,
    java語言規範鼓勵但不要求虛擬機對64位的long和double型變量的寫操作具有原子性,當JVM在這種處理器上運行時,
    可能會把64位的long和double拆分成兩次32位的寫

    指令屏障

    為了保證內存的可見性,JMM的編譯器會禁止特定類型的編譯器重新排序;對於處理器的重新排序,
    JMM會要求編譯器在生成指令序列時插入特定類型的的內存屏障指令,通過內存屏障指令巾紙特定類型的處理器重新排序

    JMM規定了四種內存屏障,具體如下:

    屏障類型 指令示例 說明
    LoadLoad Barriers Load1;LoadLoad;Load2 確保Load1的數據先於Load2以及所有後續裝在指令的裝載
    StoreStore Barries Store1;StoreStore;Store2 確保Store1數據對於其他處理器可見(刷新到內存)先於Store2及後續存儲指令的存儲
    LoadStore Barriers Load1;LoadStore;Store2 確保Load1的裝載先於Store2及後續所有的存儲指令
    StoreLoad Barrier Store1;StoreLoad;Load2 確保Store1的存儲指令先於Load1以及後續所所有的加載指令

    StoreLoad是一個“萬能”的內存屏障,他同時具有其他三個內存屏障的效果,現代的處理器大都支持該屏障(其他的內存屏障不一定支持),
    但是執行這個內存屏障的開銷很昂貴,因為需要將處理器緩衝區所有的數據刷回內存中。

    happens-before規則

    在JSR-133種內存模型種引入了happens-before規則來闡述操作之間的內存可見性。在JVM種如果一個操作的結果過需要對另一個操作可見,
    那麼兩個操作之間必然要存在happens-bsfore關係:

    • 程序順序規則:一個線程中的個每個操作,happens-before於該線程的後續所有操作
    • 監視器鎖規則:對於一個鎖的解鎖,happens-before於隨後對於這個鎖的加鎖
    • volatitle變量規則:對於一個volatile的寫,happens-before於認意後續對這個volatile域的讀
    • 線程啟動原則:對線程的start()操作先行發生於線程內的任何操作
    • 線程終止原則:線程中的所有操作先行發生於檢測到線程終止,可以通過Thread.join()、Thread.isAlive()的返回值檢測線程是否已經終止
    • 線程終端原則:對線程的interrupt()的調用先行發生於線程的代碼中檢測到中斷事件的發生,可以通過Thread.interrupted()方法檢測是否發生中斷
    • 對象終結原則:一個對象的初始化完成(構造方法執行結束)先行發生於它的finalize()方法的開始。
    • 傳遞性:如果A happens-before B B happends-beforeC,那麼A happends-before C

    指令重排序

    從源程序到字節指令的重排序

    眾所周知,JVM執行的是字節碼,Java源代碼需要先編譯成字節碼程序才能在Java虛擬機中運行,但是考慮下面的程序;

    int a = 1;
    int b = 1;
    

    在這段代碼中,a和b沒有任何的相互依賴關係,因此完全可以先對b初始化賦值,再對a變量初始化賦值;

    事實上,為了提高性能,編譯器和處理器通常會對指令做重新排序。重排序分為3種:

    1. 編譯器優化的重排序。編譯器在不改變單線程的程序語義的前提下,可以安排字語句的執行順序。編譯器的對象是語句,不是字節碼,
      但是反應的結果就是編譯后的字節碼和寫的語句順序不一致。
    2. 執行級并行的重排序。現代處理器採用了并行技術,來將多條指令重疊執行。如果不存在數據依賴性,處理器可以改變語句對應機器指令的執行順序。
    3. 內存系統的重排序,由於處理器使用了緩存和讀/寫緩衝區,這使得加載和存儲操作看上去可能是在亂序執行。

    數據依賴性:如果兩個操作訪問同一個變量,且兩個操作有一個是寫操作,則這兩個操作存在數據依賴性,改變這兩個操作的執行順序,就會改變執行結果。

    儘管指令重排序會提高代碼的執行效率,但是卻為多線程編程帶來了問題,多線程操作共享變量需要一定程度上遵循代碼的編寫順序,
    也需要將修改的共享數據存儲到共享內存中,不按照代碼順序執行可能會導致多線程程序出現內存可見性的問題,那又如何實現呢?

    as-if-serial語義

    as-if-serial語義:不論程序怎樣進行重排序,(單線程)程序的執行結果不能被改變。編譯器、runtime和處理器都必須支持as-if-serial語義。

    程序順序規則

    假設存在以下happens-before程序規則:

        1) A happens-before B
        2) B happens-before C
        3) A happens-before C
    

    儘管這裏存在A happens-before B這一關係,但是JMM並不要求A一定要在B之前執行,僅僅要求A的執行結果對B可見。
    即JMM僅要求前一個操作的結果對於后一個操作可見,並且前一個操作按照順序排在後一個操作之前。
    但是若前一個操作放在後一個操作之後執行並不影響執行結果,則JMM認為這並不違法,JMM允許這種重排序。

    順序一致性模型

    在一個線程中寫一個變量,在另一個線程中同時讀取這個變量,讀和寫沒有通過排序來同步來排序,就會引發數據競爭。

    數據競爭的核心原因是程序未正確同步。如果一個多線程程序是正確同步的,這個程序將是一個沒有數據競爭的程序。

    順序一致性模型只是一個參考模型。

    順序一致性模型特性

    • 一個線程中所有的操作必須按照程序的順序來執行。
    • 不管線程是否同步,所有的線程都只能看到一個單一的執行順序。

    在順序一致性模型中每個曹祖都必須原子執行且立刻對所有線程可見。

    當程序未正確同步會發生什麼

    當線程未正確同步時,JMM只提供最小的安全性,當讀取到一個值時,這個值要麼是之前寫入的值,要麼是默認值。
    JMM保證線程的操作不會無中生有。為了保證這一特點,JMM在分配對象時,首先會對內存空間清0,然後才在上面分配對象。

    未同步的程序在JMM種執行時,整體上是無序的,執行結果也無法預知。位同步程序子兩個模型中執行特點有如下幾個差異:

    • 順序一致性模型保證單線程內的操作會按照程序的順序執行,而JMM不保證單線程內的操作會按照程序的順序執行
    • 順序一致性模型保證所有線程只能看到一致的操作執行順序,而JMM不保證所有線程能看到一致的操作執行順序
    • JMM不保證對64位的long和double型變量具有寫操作的原子性,而順序一致性模型保證對所有的內存的讀/寫操作都具有原子性

    參考資料

    java併發編程的藝術-方騰飛,魏鵬,程曉明著

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

    ※教你寫出一流的銷售文案?

    ※網頁設計最專業,超強功能平台可客製化

    【其他文章推薦】

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

    ※教你寫出一流的銷售文案?

    ※網頁設計最專業,超強功能平台可客製化

  • 【Mongodb】 可複製集搭建

    【Mongodb】 可複製集搭建

    可複製集 replica set

    概念圖

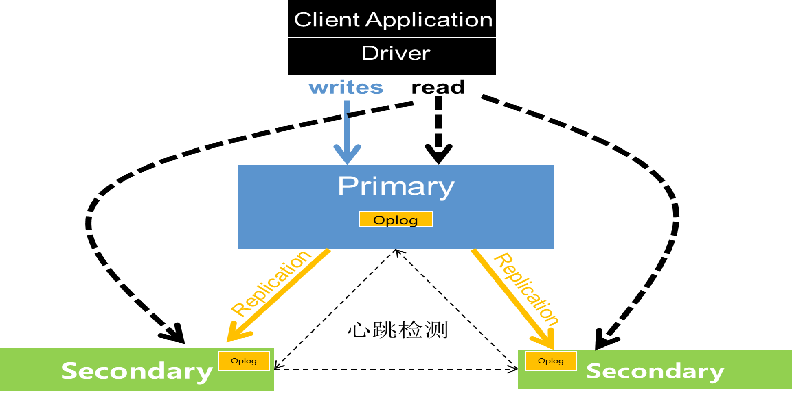
    可複製集需要至少3個以上的mongodb節點,其中有一個主節點promary,其餘的為副本節點secondary

    可複製集有三個角色:

    • 主要成員(Primary):主要接收所有寫操作。就是主節點。
    • 副本成員(Secondary):從主節點通過複製操作以維護相同的數據集,即備份數據,不可寫操作,但可以讀操作(但需要配置)。是默認的一種從節點類型。
    • 仲裁者(Arbiter):不保留任何數據的副本,只具有投票選舉作用。當然也可以將仲裁服務器維護為副本集的一部分,即副本成員同時也可以是仲裁者。也是一種從節點類型。

    關於仲裁者:
    如果主節點+副本節點是偶數推薦添加仲裁者,如果主節點+ 副本節點是奇數可以不添加仲裁者。仲裁者將永遠是仲裁者,而主要人員可能會退出並成為次要人員,而次要人員可能成為選舉期間的主要人員。

    為什麼要用可複製集?它有什麼重要性?

    1. 避免數據丟失,保障數據安全,提高系統安全性;
      (最少3節點,最大50節點)
    2. 自動化災備機制,主節點宕機后通過選舉產生新主機;提高系統健壯性;
      (7個選舉節點上限)
    3. 讀寫分離,負載均衡,提高系統性能;

    搭建

    準備三個mongodb節點

    正準備三個mongodb節點,我們先搭建一個主節點,2個副本節點的模式
    修改配置mongo.conf

    • 第一個
    systemLog:
      #MongoDB發送所有日誌輸出的目標指定為文件 
      destination: file
      #mongod或mongos應向其發送所有診斷日誌記錄信息的日誌文件的路徑 
      path: "/home/amber/mongodb/mongodb-001/log/mongod.log" 
      #當mongos或mongod實例重新啟動時,mongos或mongod會將新條目附加到現有日誌文件的末尾。 
      logAppend: true
    storage: 
      #mongod實例存儲其數據的目錄。storage.dbPath設置僅適用於mongod。 
      dbPath: "/home/amber/mongodb/mongodb-001/data/db" 
      journal:
        #啟用或禁用持久性日誌以確保數據文件保持有效和可恢復。 
        enabled: true
    processManagement:
      #啟用在後台運行mongos或mongod進程的守護進程模式。 
      fork: true 
      #指定用於保存mongos或mongod進程的進程ID的文件位置,其中mongos或mongod將寫入其PID 
      pidFilePath: "/home/amber/mongodb/mongodb-001/log/mongod.pid" 
    net:
      #服務實例綁定所有IP,有副作用,副本集初始化的時候,節點名字會自動設置為本地域名,而不是ip 
      #bindIpAll: true 
      #服務實例綁定的IP 
      bindIp: 0.0.0.0
      #bindIp 
      #綁定的端口 
      port: 27017
    replication: 
      #副本集的名稱 
      replSetName: myrs
    
    • 第二個第三個配置
      把上述文件中的mongodb-001換成mongodb-002``mongodb-003
      端口分別換成27018 27019

    然後分別在mongodb-00X的根目錄下執行啟動命令

    ./bin/mongod -f ./conf/mongod.conf
    

    檢查進程

    ps -ef|grep mongod
    

    設置主節點

    進入27017的那個mongod的客戶端,並且執行

    rs.initiate({
          _id: "myrs", //  需要和replSetName的名稱一致
          version: 1,
          members: [{ _id: 0, host : "192.168.xx.xx:27017" }]});
    

    或者

    rs.initiate({}) 
    

    執行結果

    提示:
    1)“ok”的值為1,說明創建成功。
    2)命令行提示符發生變化,變成了一個從節點角色,此時默認不能讀寫。稍等片刻,回車,變成主節  點。
    

    配置副本節點

    再27017的mongod客戶端,也就是主節點上執行192.168.xx.xx:27018是副本節點的ip和端口

    rs.add("192.168.xx.xx:27018")
    rs.add("192.168.xx.xx:27019")
    

    使用

    rs.status()
    

    就可以看到members會有三個節點了

    測試

    再主節點插入一條數據

    use article;
    db.comment.insert({name: "amber"})
    

    再從節點查看,結果

    這是因為需要再從節點再次進行

    rs.slaveok() // 確認當前節點是副本節點
    db.comment.find(); // 查看當前數據
    

    可以看到已經有數據了,這樣一主二從的可複製成功了

    如果關閉主節點,在從節點執行rs.status();
    可以看到原來的主節點的health變成了0

    27018變成了新的主節點

    主節點的選舉原則

    MongoDB在副本集中,主節點選舉的觸發條件:
    1) 主節點故障
    2) 主節點網絡不可達(默認心跳信息為10秒)
    3) 人工干預(rs.stepDown(600))

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※教你寫出一流的銷售文案?

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※回頭車貨運收費標準

    ※別再煩惱如何寫文案,掌握八大原則!

    ※超省錢租車方案

    ※產品缺大量曝光嗎?你需要的是一流包裝設計!

  • 【Spring註解驅動開發】使用InitializingBean和DisposableBean來管理bean的生命周期,你真的了解嗎?

    寫在前面

    在《【Spring註解驅動開發】如何使用@Bean註解指定初始化和銷毀的方法?看這一篇就夠了!!》一文中,我們講述了如何使用@Bean註解來指定bean初始化和銷毀的方法。具體的用法就是在@Bean註解中使用init-method屬性和destroy-method屬性來指定初始化方法和銷毀方法。除此之外,Spring中是否還提供了其他的方式來對bean實例進行初始化和銷毀呢?

    項目工程源碼已經提交到GitHub:https://github.com/sunshinelyz/spring-annotation

    InitializingBean接口

    1.InitializingBean接口概述

    Spring中提供了一個InitializingBean接口,InitializingBean接口為bean提供了屬性初始化后的處理方法,它只包括afterPropertiesSet方法,凡是繼承該接口的類,在bean的屬性初始化后都會執行該方法。InitializingBean接口的源碼如下所示。

    package org.springframework.beans.factory;
    public interface InitializingBean {
    	void afterPropertiesSet() throws Exception;
    }
    

    根據InitializingBean接口中提供的afterPropertiesSet()方法的名字可以推斷出:afterPropertiesSet()方法是在屬性賦好值之後調用的。那到底是不是這樣呢?我們來分析下afterPropertiesSet()方法的調用時機。

    2.何時調用InitializingBean接口?

    我們定位到Spring中的org.springframework.beans.factory.support.AbstractAutowireCapableBeanFactory類下的invokeInitMethods()方法中,來查看Spring加載bean的方法。

    題外話:不要問我為什麼會是這個invokeInitMethods()方法,如果你和我一樣對Spring的源碼非常熟悉的話,你也會知道是這個invokeInitMethods()方法,哈哈哈哈!所以,小夥伴們不要只顧着使用Spring,還是要多看看Spring的源碼啊!Spring框架中使用了大量優秀的設計模型,其代碼的編寫規範和嚴謹程度也是業界開源框架中數一數二的,非常值得閱讀。

    我們來到AbstractAutowireCapableBeanFactory類下的invokeInitMethods()方法,如下所示。

    protected void invokeInitMethods(String beanName, final Object bean, @Nullable RootBeanDefinition mbd)
        throws Throwable {
    	//判斷該bean是否實現了實現了InitializingBean接口,如果實現了InitializingBean接口,則調用bean的afterPropertiesSet方法
        boolean isInitializingBean = (bean instanceof InitializingBean);
        if (isInitializingBean && (mbd == null || !mbd.isExternallyManagedInitMethod("afterPropertiesSet"))) {
            if (logger.isTraceEnabled()) {
                logger.trace("Invoking afterPropertiesSet() on bean with name '" + beanName + "'");
            }
            if (System.getSecurityManager() != null) {
                try {
                    AccessController.doPrivileged((PrivilegedExceptionAction<Object>) () -> {
                        //調用afterPropertiesSet()方法
                        ((InitializingBean) bean).afterPropertiesSet();
                        return null;
                    }, getAccessControlContext());
                }
                catch (PrivilegedActionException pae) {
                    throw pae.getException();
                }
            }
            else {
                //調用afterPropertiesSet()方法
                ((InitializingBean) bean).afterPropertiesSet();
            }
        }
    
        if (mbd != null && bean.getClass() != NullBean.class) {
            String initMethodName = mbd.getInitMethodName();
            if (StringUtils.hasLength(initMethodName) &&
                !(isInitializingBean && "afterPropertiesSet".equals(initMethodName)) &&
                !mbd.isExternallyManagedInitMethod(initMethodName)) {
                //通過反射的方式調用init-method
                invokeCustomInitMethod(beanName, bean, mbd);
            }
        }
    }
    

    分析上述代碼后,我們可以初步得出如下信息:

    • Spring為bean提供了兩種初始化bean的方式,實現InitializingBean接口,實現afterPropertiesSet方法,或者在配置文件和@Bean註解中通過init-method指定,兩種方式可以同時使用。
    • 實現InitializingBean接口是直接調用afterPropertiesSet()方法,比通過反射調用init-method指定的方法效率相對來說要高點。但是init-method方式消除了對Spring的依賴。
    • 如果調用afterPropertiesSet方法時出錯,則不調用init-method指定的方法。

    也就是說Spring為bean提供了兩種初始化的方式,第一種實現InitializingBean接口,實現afterPropertiesSet方法,第二種配置文件或@Bean註解中通過init-method指定,兩種方式可以同時使用,同時使用先調用afterPropertiesSet方法,后執行init-method指定的方法。

    DisposableBean接口

    1.DisposableBean接口概述

    實現org.springframework.beans.factory.DisposableBean接口的bean在銷毀前,Spring將會調用DisposableBean接口的destroy()方法。我們先來看下DisposableBean接口的源碼,如下所示。

    package org.springframework.beans.factory;
    public interface DisposableBean {
    	void destroy() throws Exception;
    }
    

    可以看到,在DisposableBean接口中只定義了一個destroy()方法。

    在Bean生命周期結束前調用destory()方法做一些收尾工作,亦可以使用destory-method。前者與Spring耦合高,使用類型強轉.方法名(),效率高。後者耦合低,使用反射,效率相對低

    2.DisposableBean接口注意事項

    多例bean的生命周期不歸Spring容器來管理,這裏的DisposableBean中的方法是由Spring容器來調用的,所以如果一個多例實現了DisposableBean是沒有啥意義的,因為相應的方法根本不會被調用,當然在XML配置文件中指定了destroy方法,也是沒有意義的。所以,在多實例bean情況下,Spring不會自動調用bean的銷毀方法。

    單實例bean案例

    創建一個Animal的類實現InitializingBean和DisposableBean接口,代碼如下:

    package io.mykit.spring.plugins.register.bean;
    
    import org.springframework.beans.factory.DisposableBean;
    import org.springframework.beans.factory.InitializingBean;
    import org.springframework.stereotype.Component;
    /**
     * @author binghe
     * @version 1.0.0
     * @description 測試InitializingBean接口和DisposableBean接口
     */
    public class Animal implements InitializingBean, DisposableBean {
        public Animal(){
            System.out.println("執行了Animal類的無參數構造方法");
        }
    
        @Override
        public void afterPropertiesSet() throws Exception {
            System.out.println("執行了Animal類的初始化方法。。。。。");
    
        }
        @Override
        public void destroy() throws Exception {
            System.out.println("執行了Animal類的銷毀方法。。。。。");
    
        }
    }
    

    接下來,我們新建一個AnimalConfig類,並將Animal通過@Bean註解的方式註冊到Spring容器中,如下所示。

    package io.mykit.spring.plugins.register.config;
    
    import io.mykit.spring.plugins.register.bean.Animal;
    import org.springframework.context.annotation.Bean;
    import org.springframework.context.annotation.ComponentScan;
    import org.springframework.context.annotation.Configuration;
    /**
     * @author binghe
     * @version 1.0.0
     * @description AnimalConfig
     */
    @Configuration
    @ComponentScan("io.mykit.spring.plugins.register.bean")
    public class AnimalConfig {
        @Bean
        public Animal animal(){
            return new Animal();
        }
    }
    

    接下來,我們在BeanLifeCircleTest類中新增testBeanLifeCircle02()方法來進行測試,如下所示。

    @Test
    public void testBeanLifeCircle02(){
        //創建IOC容器
        AnnotationConfigApplicationContext context = new AnnotationConfigApplicationContext(AnimalConfig.class);
        System.out.println("IOC容器創建完成...");
        //關閉IOC容器
        context.close();
    }
    

    運行BeanLifeCircleTest類中的testBeanLifeCircle02()方法,輸出的結果信息如下所示。

    執行了Animal類的無參數構造方法
    執行了Animal類的初始化方法。。。。。
    IOC容器創建完成...
    執行了Animal類的銷毀方法。。。。。
    

    從輸出的結果信息可以看出:單實例bean下,IOC容器創建完成后,會自動調用bean的初始化方法;而在容器銷毀前,會自動調用bean的銷毀方法。

    多實例bean案例

    多實例bean的案例代碼基本與單實例bean的案例代碼相同,只不過在AnimalConfig類中,我們在animal()方法上添加了@Scope(“prototype”)註解,如下所示。

    package io.mykit.spring.plugins.register.config;
    import io.mykit.spring.plugins.register.bean.Animal;
    import org.springframework.context.annotation.Bean;
    import org.springframework.context.annotation.ComponentScan;
    import org.springframework.context.annotation.Configuration;
    import org.springframework.context.annotation.Scope;
    /**
     * @author binghe
     * @version 1.0.0
     * @description AnimalConfig
     */
    @Configuration
    @ComponentScan("io.mykit.spring.plugins.register.bean")
    public class AnimalConfig {
        @Bean
        @Scope("prototype")
        public Animal animal(){
            return new Animal();
        }
    }
    

    接下來,我們在BeanLifeCircleTest類中新增testBeanLifeCircle03()方法來進行測試,如下所示。

    @Test
    public void testBeanLifeCircle03(){
        //創建IOC容器
        AnnotationConfigApplicationContext ctx = new AnnotationConfigApplicationContext(AnimalConfig.class);
        System.out.println("IOC容器創建完成...");
        System.out.println("-------");
        //調用時創建對象
        Object bean = ctx.getBean("animal");
        System.out.println("-------");
        //調用時創建對象
        Object bean1 = ctx.getBean("animal");
        System.out.println("-------");
        //關閉IOC容器
        ctx.close();
    }
    

    運行BeanLifeCircleTest類中的testBeanLifeCircle03()方法,輸出的結果信息如下所示。

    IOC容器創建完成...
    -------
    執行了Animal類的無參數構造方法
    執行了Animal類的初始化方法。。。。。
    -------
    執行了Animal類的無參數構造方法
    執行了Animal類的初始化方法。。。。。
    -------
    

    從輸出的結果信息中可以看出:在多實例bean情況下,Spring不會自動調用bean的銷毀方法。

    好了,咱們今天就聊到這兒吧!別忘了給個在看和轉發,讓更多的人看到,一起學習一起進步!!

    項目工程源碼已經提交到GitHub:https://github.com/sunshinelyz/spring-annotation

    寫在最後

    如果覺得文章對你有點幫助,請微信搜索並關注「 冰河技術 」微信公眾號,跟冰河學習Spring註解驅動開發。公眾號回復“spring註解”關鍵字,領取Spring註解驅動開發核心知識圖,讓Spring註解驅動開發不再迷茫。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※超省錢租車方案

    ※別再煩惱如何寫文案,掌握八大原則!

    ※回頭車貨運收費標準

    ※教你寫出一流的銷售文案?

    ※FB行銷專家,教你從零開始的技巧