作者: admin

  • JVM原理速記複習Java虛擬機總結思維導圖面試必備

    JVM原理速記複習Java虛擬機總結思維導圖面試必備

    良心製作,右鍵另存為保存

    喜歡可以點個贊哦

    Java虛擬機

    一、運行時數據區域

    線程私有

    • 程序計數器

      • 記錄正在執行的虛擬機字節碼指令的地址(如果正在執行的是Native方法則為空),是唯一一個沒有規定OOM(OutOfMemoryError)的區域。
    • Java虛擬機棧

      • 每個Java方法在執行的同時會創建一個棧楨用於存儲局部變量表、操作數棧、動態鏈接、方法出口等信息。從方法調用直到執行完成的過程,對應着一個棧楨在Java虛擬機棧中入棧和出棧的過程。(局部變量包含基本數據類型、對象引用reference和returnAddress類型)
    • 本地方法棧

      • 本地方法棧與Java虛擬機棧類似,它們之間的區別只不過是本地方法棧為Native方法服務。

    線程公有

    • Java堆(GC區)(Java Head)

      • 幾乎所有的對象實例都在這裏分配內存,是垃圾收集器管理的主要區域。分為新生代和老年代。對於新生代又分為Eden空間、From Survivor空間、To Survivor空間。
    • JDK1.7 方法區(永久代)

      • 用於存放已被加載的類信息、常量、靜態變量、即時編譯器編譯后的代碼等數據。
        對這塊區域進行垃圾回收的主要目的是對常量池的回收和對類的卸載,但是一般難以實現。
        HotSpot虛擬機把它當做永久代來進行垃圾回收。但很難確定永久代的大小,因為它受到很多因素的影響,並且每次Full GC之後永久代的大小都會改變,所以經常拋出OOM異常。
        從JDK1.8開始,移除永久代,並把方法區移至元空間。
      • 運行時常量池

        • 是方法區的一部分
          Class文件中的常量池(編譯器生成的字面量和符號引用)會在類加載后被放入這個區域。
          允許動態生成,例如String類的intern()
    • JDK1.8 元空間

      • 原本存在方法區(永久代)的數據,一部分移到了Java堆裏面,一部分移到了本地內存裏面(即元空間)。元空間存儲類的元信息,靜態變量和常量池等放入堆中。
    • 直接內存

      • 在NIO中,會使用Native函數庫直接分配堆外內存。

    二、HotSpot虛擬機

    對象的創建

    • 當虛擬機遇到一條new指令時
    1. 檢查參數能否在常量池中找到符號引用,並檢查這個符號引用代表的類是否已經被加載、解析和初始過,沒有的話先執行相應的類加載過程。
    2. 在類加載檢查通過之後,接下來虛擬機將為新生對象分配內存。
    3. 內存分配完成之後,虛擬機需要將分配到的內存空間都初始化為零值(不包括對象頭)。
    4. 對對象頭進行必要的設置。
    5. 執行構造方法按照程序員的意願進行初始化。

    對象的內存布局

      1. 對象頭
        1. 第一部分用於存儲對象自身的運行時數據,如哈希碼、GC分代年齡、鎖狀態標識、線程持有的鎖、偏向線程ID、偏向實現戳等。
        1. 第二部分是類型指針,即對象指向它的類元數據的指針(如果使用直接對象指針訪問),虛擬機通過這個指針來確定這個對象是哪個類的實例。
        1. 如果對象是一個Java數組的話,還需要第三部分記錄數據長度的數據。
      1. 實例數據
      • 是對象真正存儲的有效信息,也就是在代碼中定義的各種類型的字段內容。
      1. 對齊填充
      • 不是必然存在的,僅僅起着佔位符的作用。
        HotSpot需要對象的大小必須是8字節的整數倍。

    對象的訪問定位

    • 句柄訪問

      • 在Java堆中劃分出一塊內存作為句柄池。
        Java棧上的對象引用reference中存儲的就是對象的句柄地址,而句柄中包含了到對象實例數據的指針和到對象類型數據的指針。
        對象實例數據在Java堆中,對象類型數據在方法區(永久代)中。
        優點:在對象被移動時只會改變句柄中的實例數據指針,而對象引用本身不需要修改。
    • 直接指針訪問(HotSpot使用)

      • Java棧上的對象引用reference中存儲的就是對象的直接地址。
        在堆中的對象實例數據就需要包含到對象類型數據的指針。
        優點:節省了一次指針定位的時間開銷,速度更快。

    三、垃圾收集

    概述

    • 垃圾收集主要是針對Java堆和方法區。
      程序計數器、Java虛擬機棧個本地方法棧三個區域屬於線程私有,線程或方法結束之後就會消失,因此不需要對這三個區域進行垃圾回收。

    判斷對象是否可以被回收

    • 第一次標記(緩刑)

      • 引用計數算法

        • 給對象添加一個引用計數器,當對象增加一個引用時引用計數值++,引用失效時引用計數值–,引用計數值為0時對象可以被回收。

    但是它難以解決對象之間的相互循環引用的情況,此時這個兩個對象引用計數值為1,但是永遠無法用到這兩個對象。

    - 可達性分析算法(Java使用)
    
        - 以一系列GC Roots的對象作為起始點,從這些節點開始向下搜索,搜索所走過的路徑稱為引用鏈,當一個對象到GC Roots沒有任何引用鏈相連是,則證明此對象不可用,可以被回收。

    GC Roots對象包括

    1. 虛擬機棧(棧楨中的本地變量表)中引用的對象。
    2. 方法區中共類靜態屬性引用的對象。
    3. 方法區中常量引用的對象。
    4. 本地方法棧中JNI(即一般說的Native方法)引用的對象。
    • 第二次標記

      • 當對象沒有覆蓋finalize()方法,或者finalize()方法已經被虛擬機調用過。
        如果對象在finalize方法中重新與引用鏈上的任何一個對象建立關聯則將不會被回收。
      • finalize()

        • 任何一個對象的finalize()方法都只會被系統調用一次。
          它的出現是一個妥協,運行代價高昂,不確定性大,無法保證各個對象的調用順序。
          finalize()能做的所有工作使用try-finally或者其他方式都可以做的更好,完全可以忘記在這個函數的存在。

    方法區的回收

    • 在方法區進行垃圾回收的性價比一般比較低。
      主要回收兩部分,廢棄常量和無用的類。

    滿足無用的類三個判斷條件才僅僅代表可以進行回收,不是必然關係,可以使用-Xnoclassgc參數控制。

    1. 該類的所有實例都已經被回收,也就是Java堆中不存在該類的任何實例。
    2. 加載該類的ClassLoader已經被回收。
    3. 該類對應的java.lang.Class對象沒有在任何地方被引用,無法在任何地方通過反射訪問到該類的方法。

    引用類型

      1. 強引用
      • 使用new一個新對象的方式來創建強引用。
        只要強引用還存在,被引用的對象則永遠不會被回收。
      1. 軟引用
      • 使用SoftReference類來實現軟引用。
        用來描述一些還有用但是並非必須的對象,被引用的對象在將要發生內存溢出異常之前會被回收。
      1. 弱引用
      • 使用WeakReference類來實現弱引用。
        強度比軟引用更弱一些,被引用的對象在下一次垃圾收集時會被回收。
      1. 虛引用
      • 使用PhantomReference類來實現虛引用。
        最弱的引用關係,不會對被引用的對象生存時間構成影響,也無法通過虛引用來取得一個對象實例。
        唯一目的就是能在這個對象被收集器回收時收到一個系統通知。

    垃圾收集算法

      1. 標記 – 清除
      • 首先標記出所有需要回收的對象,在標記完成后統一回收被標記的對象並取消標記。

    不足:

    1. 效率問題,標記和清除兩個過程的效率都不高。
    2. 空間問題,標記清除之後會產生大量不連續的內存碎片,沒有連續內存容納較大對象而不得不提前觸發另一次垃圾收集。
      1. 標記 – 整理
      • 和標記 – 清除算法一樣,但標記之後讓所有存活對象都向一段移動,然後直接清理掉端邊界以外的內存。
        解決了標記 – 清除算法的空間問題,但需要移動大量對象,還是存在效率問題。
      1. 複製
      • 將可用內存按容量劃分為大小相等的兩塊,每次只使用其中的一塊。當這一塊的內存用完了,就將還存活着的對象複製到另外一塊上面,然後再把已使用多的內存空間一次清理掉。
        代價是將內存縮小為原來的一般,太高了。

    現在商業虛擬機都採用這種算法用於新生代。
    因為新生代中的對象98%都是朝生暮死,所以將內存分為一塊較大的Eden空間和兩塊較小的Survivor空間,每次使用Eden和其中一塊Survivor空間。
    當回收時,如果另外一塊Survivor空間沒有足夠的空間存放存活下來的對象時,這些對象將直接通過分配擔保機制進入老年代。

      1. 分代收集
      • 一般把Java堆分為新生代和老年代。
        在新生代中使用複製算法,在老年代中使用標記 -清除 或者 標記 – 整理 算法來進行回收。

    HotSpot的算法實現

    • 枚舉根節點(GC Roots)

      • 目前主流Java虛擬機使用的都是準確式GC。
        GC停頓的時候,虛擬機可以通過OopMap數據結構(映射表)知道,在對象內的什麼偏移量上是什麼類型的數據,而且特定的位置記錄著棧和寄存器中哪些位置是引用。因此可以快速且準確的完成GC Roots枚舉。
    • 安全點

      • 為了節省GC的空間成本,並不會為每條指令都生成OopMap,只是在“特定的位置”記錄OopMap,這些位置稱為安全點。

    程序執行只有到達安全點時才能暫停,到達安全點有兩種方案。

    1. 搶斷式中斷(幾乎不使用)。GC時,先把所有線程中斷,如果有線程不在安全點,就恢復該線程,讓他跑到安全點。
    2. 主動式中斷(主要使用)。GC時,設置一個標誌,各個線程執行到安全點時輪詢這個標誌,發現標誌為直則掛起線程。

    但是當線程sleep或blocked時無法響應JVM的中斷請求走到安全點中斷掛起,所以引出安全區域。

    • 安全區域

      • 安全區域是指在一段代碼片段之中,引用關係不會發生變化,是擴展的安全點。

    線程進入安全區域時表示自己進入了安全區域,這個發生GC時,JVM就不需要管這個線程。
    線程離開安全區域時,檢查系統是否完成GC過程,沒有就等待可以離開安全區域的信號為止,否者繼續執行。

    垃圾收集器

    • 新生代

        1. serial收集器
        • 它是單線程收集器,只會使用一個線程進行垃圾收集工作,更重要的是它在進行垃圾收集時,必須暫停其他所有的工作線程。

    優點:對比其他單線程收集器簡單高效,對於單個CPU環境來說,沒有線程交互的開銷,因此擁有最高的單線程收集效率。

    它是Client場景下默認新生代收集器,因為在該場景下內存一般來說不會很大。

    - 2. parnew收集器
    
        - 它是Serial收集器的多線程版本,公用了相當多的代碼。

    在單CPU環境中絕對不會有比Serial收集器更好的效果,甚至在2個CPU環境中也不能百分之百超越。

    它是Server場景下默認的新生代收集器,主要因為除了Serial收集器,只用它能與CMS收集器配合使用。

    - 3. parallel scavenge收集器
    
        - “吞吐優先”收集器,與ParNew收集器差不多。

    但是其他收集器的目標是盡可能縮短垃圾收集時用戶線程停頓的時間,而它的目標是達到一個可控制的吞吐量。這裏的吞吐量指CPU用於運行用戶程序的時間佔總時間的比值。

    • 老年代

        1. serial old收集器
        • 是Serial收集器老年代版本。

    也是給Client場景下的虛擬機使用的。

    - 5. parallel old收集器
    
        - 是Parallel Scavenge收集器的老年代版本。

    在注重吞吐量已經CPU資源敏感的場合,都可以優先考慮Parallel Scavenge和Parallel Old收集器。

    - 6. cms收集器
    
        - Concurrent Mark Sweep收集器是一種以獲取最短回收停頓時間為目標的收集器。
        - 運作過程
    
            - 1. 初始標記(最短)。仍需要暫停用戶線程。只是標記一下GC Roots能直接關聯到的對象,速度很快
    1. 併發標記(耗時最長)。進行GC Roots Tracing(根搜索算法)的過程。
    2. 重新標記。修正併發標記期間因用戶程序繼續運作而導致標記產生變動的那一部分對象的標記記錄。比初始標記長但遠小於併發標記時間。
    3. 併發清除

    1 和4 兩個步驟並沒有帶上併發兩個字,即這兩個步驟仍要暫停用戶線程。

        - 優缺點
    
            - 併發收集、低停頓。
    1. CMS收集器對CPU資源非常敏感。雖然不會導致用戶線程停頓,但是佔用CPU資源會使應用程序變慢。
    2. 無法處理浮動垃圾。在併發清除階段新垃圾還會不斷的產生,所以GC時要控制“-XX:CMSinitiatingOccupancyFraction參數”預留足夠的內存空間給這些垃圾,當預留內存無法滿足程序需要時就會出現”Concurrent Mode Failure“失敗,臨時啟動Serial Old收集。
    3. 由於使用標記 – 清除算法,收集之後會產生大量空間碎片。
      1. g1收集器
      • Garbage First是一款面向服務端應用的垃圾收集器
      • 運作過程

          1. 初始標記
    1. 併發標記
    2. 最終標記
    3. 刪選標記

    五、類加載機制

    概述

    • 虛擬機把描述類的數據從Class問價加載到內存,並對數據進行校驗、轉換解析和初始化,最終形成可以被虛擬機直接使用的Java類型。
      Java應用程序的高度靈活性就是依賴運行期動態加載和動態連接實現的。

    類的生命周期

    • 加載 -> 連接(驗證 -> 準備 -> 解析) -> 初始化 -> 使用 – >卸載

    類初始化時機

    • 主動引用

      • 虛擬機規範中沒有強制約束何時進行加載,但是規定了有且只有五種情況必須對類進行初始化(加載、驗證、準備都會隨之發生)
    1. 遇到new、getstatic、putstatic、invokestatic這四條字節碼指令時沒有初始化。
    2. 反射調用時沒有初始化。
    3. 發現其父類沒有初始化則先觸發其父類的初始化。
    4. 包含psvm(mian()方法)的那個類。
    5. 動態語言支持時,REF_getStatic、REF_putStatic、REF_invokeStatic的方法句柄。
    • 被動引用

      • 除上面五種情況之外,所有引用類的方式都不會觸發初始化,稱為被動引用。
    1. 通過子類引用父類的靜態字段,不會導致子類的初始化。
    2. 通過數組定義來引用類,不會觸發此類的初始化。該過程會對數組類進行初始化,數組類是一個由虛擬機自動生成的、直接繼承Object的子類,其中包含數組的屬性和方法,用戶只能使用public的length和clone()。
    3. 常量在編譯階段會存入調用類的常量池中,本質上並沒有直接引用到定義常量的類,因此不會觸發定義常量的類的初始化。

    類加載過程

      1. 加載
        1. 通過類的全限定名來獲取定義此類的二進制字節流。
    1. 將這個字節流所代表的靜態存儲結構轉化為方法區的運行時數據結構。
    2. 在內存中生成一個代表這個類的java.lang.Class對象(HotSpot將其存放在方法區中),作為方法區這個類的各種數據的訪問入口。
      1. 驗證
      • 為了確保Class文件的字節類中包含的信息符合當前虛擬機的要求,並且不會危害虛擬機自身的安全。可以通過-Xverify:none關閉大部分類驗證。
    1. 文件格式驗證。確保輸入字節流能正確的解析並存儲於方法區,後面的3個驗證全部基於方法區的存儲結構進行,不會再操作字節流。
    2. 元數據驗證。對字節碼描述信息進行語義分析,確保其符合Java語法規範。(Java語法驗證)
    3. 字節碼驗證。最複雜,通過數據流和控制流分析,確定程序語義時合法的、符合邏輯的。可以通過參數關閉。(驗證指令跳轉範圍,類型轉換有效等)
    4. 符號引用驗證。將符號引用轉化為直接引用,發生在第三個階段——解析階段中發生。
      1. 準備
      • 類變量是被static修飾的變量,準備階段為類變量分配內存並設置零值(final直接設置初始值),使用的是方法區的內存。
      1. 解析
      • 將常量池內的符號引用替換為直接引用的過程。
        其中解析過程在某些情況下可以在初始化階段之後再開始,這是為了支持Java的動態綁定。
        解析動作主要針對類或接口、字段、類方法、接口方法、方法類型、方法句柄、和調用點限定符。
      1. 初始化
      • 初始化階段才真正執行類中定義的Java程序代碼,是執行類構造器 ()方法的過程。
        在準備階段,類變量已經給過零值,而在初始化階段,根據程序員通過程序制定的主觀計劃去初始化類變量和其他資源。

        • ()

          • 類構造器方法。是由編譯器自動收集類中的所有類變量的賦值動作和靜態語句塊中的的語句合併產生的。
    1. 不需要顯式調用父類構造器,JVM會保證在子類clinit執行之前,父類的clinit已經執行完成。
    2. 接口中不能使用靜態語句塊但仍可以有類變量的賦值操作。當沒有使用父接口中定義的變量時子接口的clinit不需要先執行父接口的clinit方法。接口的實現類也不會執行接口的clinit方法。
    3. 虛擬機會保證clinit在多線程環境中被正確的加鎖、同步。其他線性喚醒之後不會再進入clinit方法,同一個類加載器下,一個類型只會初始化一次。

       - <init>()
      
           - 對象構造器方法。Java對象被創建時才會進行實例化操作,對非靜態變量解析初始化。
    4. 會顯式的調用父類的init方法,對象實例化過程中對實例域的初始化操作全部在init方法中進行。

    類(加載) 器

    • 類與類加載器

      • 類加載器實現類的加載動作。
        類加載器和這個類本身一同確立這個類的唯一性,每個類加載器都有獨立的類命名空間。在同一個類加載器加載的情況下才會有兩個類相等。
        相等包括類的Class對象的equals()方法、isAssignableFrom()方法、isInstance()、instanceof關鍵字。
    • 類加載器分類

      • 啟動類加載器

        • 由C++語言實現,是虛擬機的一部分。負責將JAVA_HOME/lib目錄中,或者被-Xbootclasspath參數指定的路徑,但是文件名要能被虛擬機識別,名字不符合無法被啟動類加載器加載。啟動類加載器無法被Java程序直接引用。
      • 擴展類加載器

        • 由Java語言實現,負責加載JAVA_HOME/lib/ext目錄,或者被java.ext.dirs系統變量所指定的路徑中的所有類庫,開發者可以直接使用擴展類加載器。
      • 應用程序類加載器

        • 由於這個類加載器是ClassLoader中的getSystemClassLoader()方法的返回值,所以一般也稱他為系統類加載器。負責加載用戶類路徑(ClassPath)上所指定的類庫,一般情況下這個就是程序中默認的類加載器。
      • 自定義類加載器

        • 由用戶自己實現。
    1. 如果不想打破雙親委派模型,那麼只需要重寫findClass方法即可。
    2. 否則就重寫整個loadClass方法。
    • 雙親委派模型

      • 雙親委派模型要求除了頂層的啟動類加載器外,其餘的類加載器都應該有自己的父類加載器。父子不會以繼承的關係類實現,而是都是使用組合關係來服用父加載器的代碼。
        在java.lang.ClassLoader的loadClass()方法中實現。
      • 工作過程

        • 一個類加載器首先將類加載請求轉發到父類加載器,只有當父類加載器無法完成(它的搜索範圍中沒有找到所需要的類)時才嘗試自己加載
      • 好處

        • Java類隨着它的類加載器一起具備了一種帶有優先級的層次關係,從而使得基礎類庫得到同意。

    四、內存分配與回收策略

    Minor GC 和 Full GC

    • Minor GC

      • 發生在新生代的垃圾收集動作,因為新生代對象存活時間很短,因此Minor GC會頻繁執行,執行速度快。
      • 時機

        • Eden不足
    • Full GC

      • 發生在老年區的GC,出現Full GC時往往伴隨着Minor GC,比Minor GC慢10倍以上。
      • 時機

          1. 調用System.gc()
          • 只是建議虛擬機執行Full GC,但是虛擬機不一定真正去執行。
            不建議使用這種方式,而是讓虛擬機管理內存。
          1. 老年代空間不足
          • 常見場景就是大對象和長期存活對象進入老年代。
            盡量避免創建過大的對象以及數組,調大新生代大小,讓對象盡量咋新生代中被回收,不進入老年代。
          1. JDK1.7 之前方法區空間不足
          • 當系統中要加載的類、反射的類和常量較多時,永久代可能會被佔滿,在未配置CMS GC的情況下也會執行Full GC,如果空間仍然不夠則會拋出OOM異常。
            可採用增大方法區空間或轉為使用CMS GC。
          1. 空間分配擔保失敗
          • 發生Minor GC時分配擔保的兩個判斷失敗
          1. Concurrent Mode Failure
          • CMS GC 併發清理階段用戶線程還在執行,不斷有新的浮動垃圾產生,當預留空間不足時報Concurrent Mode Failure錯誤並觸發Full GC。

    內存分配策略

      1. 對象優先在Eden分配
      • 大多數情況下,對象在新生代Eden上分配,當Eden空間不夠時,發起Minor GC,當另外一個Survivor空間不足時則將存活對象通過分配擔保機制提前轉移到老年代。
      1. 大對象直接進入老年代
      • 配置參數-XX:PretenureSizeThreshold,大於此值得對象直接在老年代分配,避免在Eden和Survivor之間的大量內存複製。
      1. 長期存活對象進入老年代
      • 虛擬機為每個對象定義了一個Age計數器,對象在Eden出生並經過Minor GC存活轉移到另一個Survivor空間中時Age++,增加到默認16則轉移到老年代。
      1. 動態對象年齡綁定
      • 虛擬機並不是永遠要求對象的年齡必須到達MaxTenuringThreshold才能晉陞老年代,如果在Survivor中相同年齡所有對象大小總和大於Survivor空間的一半,則年齡大於或等於該年齡的對象直接進入老年代。
      1. 空間分配擔保
      • 在發生Minor GC之前,虛擬機先檢查老年代最大可用的連續空間是否大於新生代的所有對象,如果條件成立,那麼Minor GC可以認為是安全的。
        可以通過HandlePromotionFailure參數設置允許冒險,此時虛擬機將與歷代晉陞到老年區對象的平均大小比較,仍小於則要進行一次Full GC。
        在JDK1.6.24之後HandlePromotionFailure已無作用,即虛擬機默認為true。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

  • 痞子衡嵌入式:串行EEPROM接口事實標準及SPI EEPROM簡介

    痞子衡嵌入式:串行EEPROM接口事實標準及SPI EEPROM簡介

      大家好,我是痞子衡,是正經搞技術的痞子。今天痞子衡給大家介紹的是EEPROM接口標準及SPI EEPROM。

      痞子衡之前寫過一篇文章 ,介紹過并行NOR Flash基本概念。眾所周知,現如今嵌入式非易失性存儲器基本被NOR Flash一統江湖了,但在Flash技術發明之前,EEPROM才是非易失性存儲器的霸主。EEPROM的全稱是”電可擦除可編程只讀存儲器”,即Electrically Erasable Programmable Read-Only Memory,EEPROM技術的發明可是拯救過一大批嵌入式工程師的,畢竟在這之前非易失性存儲器技術的演進分別是ROM(只讀), PROM(只能寫一次), EPROM(紫外線可擦除),擦除方式都不太友好,直到EEPROM的出現才變得人性化。雖說現在Flash是主流,但在較低容量(2Mb以下)尤其是超低容量(1Kb以下)的市場,EEPROM仍然有其不可替代的應用場合。今天痞子衡就來好好聊一聊EEPROM:

    一、EEPROM背景簡介

      聊到EEPROM發展史,不得不提浮柵MOSFET,這是一項發明於1967年的技術,它是所有閃存的基礎。1970年,第一款成功的浮柵型器件-EPROM被發明。1979年,大名鼎鼎的SanDisk(閃迪)創始人Eli Harari,發明了世界上首個電可擦除的浮柵型器件即EEPROM。
      講到EEPROM必然要將它和與其相愛相殺的Flash一起對比。關於Flash大家都很熟悉,但其實Flash全稱應該叫Flash EEPROM,它屬於廣義的EEPROM。而本文主角EEPROM,指的是狹義的EEPROM,Flash和EEPROM最大的區別是:Flash按扇區操作,EEPROM按字節操作。Flash的特點是結構簡單,容量可以做得比較大且在大數據量下的操作速度更快,但缺點是操作過程麻煩,所以Flash適於當不需頻繁改寫的程序存儲器。而在有些應用中往往需要頻繁的改寫某些小量數據且需掉電非易失,傳統結構的EEPROM則非常適合。
      EEPROM不像NOR, NAND Flash技術演進得那麼複雜,因此實際上關於EEPROM並沒有成文的標準,即使最知名的电子行業標準之一JEDEC也沒有關於EEPROM的標準出台,不過各大廠商生產的EEPROM似乎都遵從某種約定的事實標準,這在後面介紹的EEPROM接口命令里顯得尤為明顯。

    二、Serial EEPROM原理

    2.1 Serial EEPROM分類

      從軟件驅動開發角度而言,Serial EEPROM可以從以下幾個方面進一步細分:

    地址碼長度:1byte / 2byte / 3byte
    通信接口類型:I2C / SPI / Microwire / UNIO Bus / Single-Wire

      本文的主要研究對象是SPI接口的EEPROM。

    2.2 SPI EEPROM內存模型

      EEPROM內存單元從大到小一般分為如下4層:Device、Sector、Page、Byte,其中Sector不是必有的,並且Page也只是個結構概念,跟NOR Flash里的Page/Sector意義不一樣,因為Byte就是EEPROM讀寫的最小單元(即可以任意地址隨機訪問),所以你可以把EEPROM當做一個非易失性的RAM。當然有些高端EEPROM中集成了Page/Sector操作命令,這隻是為了讓EEPROM操作效率更高而已。

    2.3 SPI EEPROM信號與封裝

      SPI EEPROM一般有8個腳,除去電源Vcc,地GND/Vss,以及SPI四根信號線(CS#, SCK, SI, SO)不言而喻之外,還有兩根特殊的控制信號,即WP#(寫保護)和HOLD#(掛起)。WP#信號主要是從硬件層面上對EEPROM內存進行保護,防止電路上的噪聲干擾篡改了EEPROM里的內容;而HOLD#則提供EEPROM寫操作暫停的功能,當該信號有效的時候,SI信號輸入將被忽略,因此主機可以做其他更高優先級的事情。

      SPI EEPROM雖然只有8pin,但是封裝種類還是比較齊全的,這其中最經典的當屬JEDEC定義的8-lead SOIC,此外還有TSSOP8, UDFN8, WLCSP8,下圖羅列了常見封裝:

    2.4 SPI EEPROM接口命令

    2.4.1 事實標準

      痞子衡在文章開頭的時候講過,SPI EEPROM並沒有什麼成文的接口命令標準,但是各大廠商生產的SPI EEPROM無一例外都支持下錶的6條命令,即READ(讀內存)、WRITE(寫內存)、WREN(寫使能)、WRDI(寫禁止)、RDSR(讀狀態寄存器)、WRSR(寫狀態寄存器),所以從軟件接口層面而言,這6條命令就是SPI EEPROM事實上的接口命令標準。

      除了6條標準命令外,SPI EEPROM內部還有一個8bit的狀態寄存器,用於反饋命令執行狀態,這8bit狀態寄存器的位定義也是存在如下錶所示的事實標準的:

      不考慮寫保護特性的話,bit0 – RDY#和bit1 – WEL是比較常用的,RDY#位主要用於標示所有涉及改變內存或狀態寄存器的命令的執行結果,WEL位則保存了上一次WREN和WRDI命令的執行結果。狀態寄存器中的其他兩處定義bit7 – WPEN, bit[3:2] – BP[1:0]則主要與寫保護特性有關,它們的具體作用如下:

    2.4.2 廠商個性化

      除了6條事實標準的命令外,有些廠商還實現了一些自定義的命令,這些命令並不一定通用,一般用於較大容量(3byte地址碼,512Kb以上)的EEPROM上。痞子衡找了一款非常經典的EEPROM,來自Microchip的25AA系列(25AA1024),讓我們看看它有啥個性化的命令。這顆EEPROM容量為1Mb,屬於大容量EEPROM,為了提高EEPROM操作效率,Microchip為這顆EEPROM增加了Page/Sector/Chip Erase命令,使得擦除操作效率變高了,如果沒有這些個性化擦除命令,那麼只能通過標準WRITE命令去手動實現擦除操作,既麻煩又低效。

    2.5 SPI EEPROM數據速率

      數據存取速率是個重要的技術指標,咱們來看看SPI EEPROM的讀寫時序,前面痞子衡在講EEPROM分類的時候提到過EEPROM地址碼有1byte/2byte/3byte之分,地址碼的區別主要體現了EEPROM讀寫時序上。對於讀時序,在SPI總線發完READ(0x03)命令后,緊接着要發送想要讀取的內存地址,地址碼不同,發送的地址字節數也不同。對於容量大於512Kb的EEPROM(即地址碼為3byte),顯然要發送3byte的地址,才能確定要讀的數據所在地址,然後才能進行讀數據操作。

      而對於容量小於等於512Kb的EEPROM,關於1byte和2byte地址碼區分,有一個特殊的設計,即對於512byte容量的EEPROM,按容量來說其屬於2byte地址碼範疇,READ命令后需要發送2byte地址,但實際上只需要發送1byte地址(A7-A0),而最高地址位A8放在了READ命令碼bit3里,這樣可以節省1個字節的地址碼。因此1Kb – 512Kb容量的EEPROM地址碼為2byte,512byte及以下容量的EEPROM地址碼為1byte,如下圖所示:

      從上面讀時序可以看出,READ命令碼和地址碼發完之後幾乎沒有等待周期,就可以直接讀取EEPROM中數據,因此EEPROM讀數據速率完全取決於SPI總線速率,所以我們只需要打開EEPROM數據手冊,看看它最高能支持多高的SPI總線速率即可(常見的有2MHz/5MHz/10MHz/20MHz)。
      對於寫時序,就稍微複雜一些了,這裏不考慮地址碼區別,以2byte地址為例。首先在發送WRITE命令之前需要發送一個WREN命令使能寫操作,因為默認EEPROM在執行完上一次寫操作後會恢複寫禁止狀態,在發送WRITE命令進行寫操作之前必須保證EEPROM處於寫使能狀態。

      確保EEPROM進入寫使能狀態后,開始發送WRITE命令,然後是地址碼,接着是要寫入的數據,痞子衡前面講過Page在EEPROM是個結構概念,但其實也跟WRITE命令有關,因為EEPROM既可以按byte去寫,也可以按Page去寫,如果需要存入連續的數據,顯然按Page去寫效率比按Byte寫入更高。這裏需要注意的是,WRITE命令後面跟的字節數不能超過要寫入的首地址所在Page剩餘的字節數。下圖示例的Page寫時序最大byte數為16/32,是因為示例EEPROM的page size即16/32 byte。

      當一次WRITE時序內要寫入的數據全部發送完成之後,底下便進入等待周期,與READ時序不同的是,WRITE時序有等待周期,因為EEPROM內部要將緩存在page buffer里的數據編程到真正的內存空間里,這需要時間。用戶只能通過不斷地發送如下RDSR命令去讀取狀態寄存器bit0 – RDY#來判斷WRITE等待周期是否結束。因此寫時序速率不僅僅取決於SPI總線速率,還取決於等待周期時長。

      如果想快捷地了解SPI EEPROM的性能,最簡單的就是打開SPI EEPROM手冊,看首頁的feature介紹,如下是25AA080的簡要feature:

    • Max. Clock 10 MHz
    • 1024 x 8-bit Organization
    • 16 Byte Page (‘C’ version devices)
    • 32 Byte Page (‘D’ version devices)
    • Self-Timed Erase and Write Cycles (5 ms max.)
    • Block Write Protection:
      - Protect none, 1/4, 1/2 or all of array
    • Built-In Write Protection:
      - Power-on/off data protection circuitry
      - Write enable latch
      - Write-protect pin
    • Sequential Read
    • High Reliability:
      - Endurance: > 1M erase/write cycles
      - Data retention: > 200 years

    三、SPI EEPROM產品

      最後痞子衡收集了可以售賣SPI EEPROM芯片的廠商及產品系列:

    廠商 芯片系列 官方網址
    Microchip
    Atmel
    25AA, 25LC
    AT25
    ST M95
    Onsemi CAT25
    Renesas R1EX25
    Rohm BR25A, BR25G, BR25H, BR25S
    Fudan Micro FM25

      至此,EEPROM接口標準及SPI EEPROM痞子衡便介紹完畢了,掌聲在哪裡~~~

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※南投搬家前需注意的眉眉角角,別等搬了再說!

  • 玩轉VSCode-完整構建VSCode開發調試環境

    玩轉VSCode-完整構建VSCode開發調試環境

    隨着VSCode的不斷完善和強大,是時候將部分開發遷移到VS Code中了。

    目前使用VS2019開發.NET Core應用,一直有一個想法,在VS Code中復刻VS的開發環境,同時遷移到VS Code。

    那麼現在就開始吧。

    首先,安裝最新版的VS Code:,安裝完成后可能會提示升級,升級即可,升級后的版本信息:

    版本: 1.40.1 (system setup)
    提交: 8795a9889db74563ddd43eb0a897a2384129a619
    日期: 2019-11-13T16:49:35.976Z
    Electron: 6.1.2
    Chrome: 76.0.3809.146
    Node.js: 12.4.0
    V8: 7.6.303.31-electron.0
    OS: Windows_NT x64 10.0.16299

    接下來的操作分為幾個步驟:

    1. 安裝各種強大VS Code插件

    2. 創建.NET Core解決方案和工程

    3. 調試運行

    好的,那我們開始吧。

    一、安裝各種強大的VS Code插件

    1. C# extension for Visual Studio Code

    這個插件最重要的功能:

    • Lightweight development tools for .
    • Great C# editing support, including Syntax Highlighting, IntelliSense, Go to Definition, Find All References, etc.
    • Debugging support for .NET Core (CoreCLR). NOTE: Mono debugging is not supported. Desktop CLR debugging has .
    • Support for project.json and csproj projects on Windows, macOS and Linux.

    2. C# Extensions

    這個插件最有用的功能是可以右鍵新建C#類和C#接口,同時支持各種code snippets,例如 ctor 、prop等,具體功能特性,可以查看插件的說明。

     3. Auto-Using for C#

    這個插件自動添加using引用。

    4. vscode-solution-explorer

    這個插件給VS Code增加了解決方案tab, 支持新建解決方案、新建工程、添加引用、Nuget包,這個插件非常有用

    Adds a Solution Explorer panel where you can find a Visual Studio Solution File Explorer.

    • Can load any .sln version

    • Supports csproj, vcxproj, fsproj and vbproj (from vs2017 and before)

    • Supports dotnet core projects

    • You can create, delete, rename or move project folders and files.

    • You can create, delete, rename or move solution, solution folders and projects.

    • You can add or remove packages and references when the project is of kind CPS (dotnet core).


    5. Code Runner(韓俊老師出品,必屬精品)

    Run code snippet or code file for multiple languages: C, C++, Java, JavaScript, PHP, Python, Perl, Perl 6, Ruby, Go, Lua, Groovy, PowerShell, BAT/CMD, BASH/SH, F# Script, F# (.NET Core), C# Script, C# (.NET Core), VBScript, TypeScript, CoffeeScript, Scala, Swift, Julia, Crystal, OCaml Script, R, AppleScript, Elixir, Visual Basic .NET, Clojure, Haxe, Objective-C, Rust, Racket, Scheme, AutoHotkey, AutoIt, Kotlin, Dart, Free Pascal, Haskell, Nim, D, Lisp, Kit, and custom command

    即選中一段代碼,直接run

    6. vscode-icons

    通過這個插件,給各個文件和文件夾一個你更熟悉的圖標

    7. Visual Studio IntelliCode

    VS代碼智能提示,根據上下文語境,自動推薦你下一步用到的代碼,後台基於AI的

    8. NuGet Package Manager

    Nuget包管理,快速查詢定位Nuget包,並安裝。不過嘗試了一下午自定義Nuget源,沒搞定,估計是URL不對

    9. Docker

    10. Kubernetes

    其他的還需要配置GitHub、TFS類似的源代碼管理,TFS搞了兩個插件,都不好使,後續搞定后再更新一次。


    二、創建.NET Core解決方案和工程

    此時,VS Code的環境基本配置差不多了,接下來有兩種模式,創建解決方案和工程。

    1. 通過vscode-solution-explorer

    解決方案有了,很熟悉的感覺。

    我們可以繼續創建工程:右鍵sln,Add new project:

    此時會彈出工程模板,此時我們選擇ASP.NET Core Web API工程

    選擇C#

    然後繼續輸入工程名稱:例如 TestWebApi

    熟悉的感覺來了。此時就可以開始coding了。

    以上是我們通過vscode-solution-explorer新建解決方案和工程。同時我們可以通過命令行來搞定。

    2. 通過Dotnet CLI命令行

    新建sln:

    dotnet "new" "sln" "-n" "EricTest" "-o" "e:\Work\ServiceDependency"

    新建ASP.NET Core WebAPI工程

    dotnet "new" "webapi" "-lang" "C#" "-n" "TestWebApi" "-o" "TestWebApi"

    將TestWebApi工程添加到解決方案EricTest

    dotnet "sln" "e:\Work\ServiceDependency\EricTest.sln" "add" "e:\Work\ServiceDependency\TestWebApi\TestWebApi.csproj"

    三、調試運行

    在Debug選項卡中新增調試配置,重點設置要調試的program

    保存后,啟動調試:


    程序中增加斷點,然後

    輸入URL:https://localhost:5001/WeatherForecast

     既可以調試了。


    以上是今天集中配置VS Code開發調試環境的總結,分享給大家。


    周國慶

    2019//11/16

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • Ansibile之playbook初識

    Ansibile之playbook初識

      一、playbook簡介

      ansiblie的任務配置文件被稱為playbook,俗稱“劇本”,每一個劇本(playbook)中都包含了一系列的任務,這每個任務在ansible中又被稱為“戲劇”(play),一個劇本中包含多齣戲劇。。

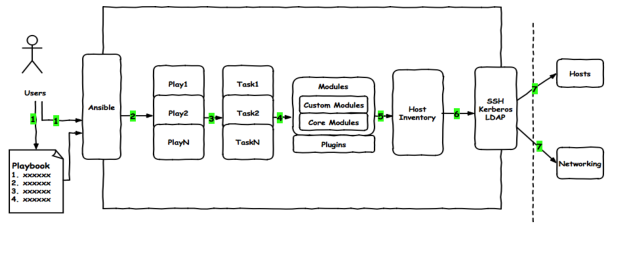
      前文我們了解了ansible有兩種執行方式ad-hoc和ansible-playbook,ad-hoc主要用於臨時命令的執行,而playbook我們可以理解為ad-hoc的集合,有點類似shell腳本,ad-hoc就相當於shell腳本里的某條任務語句,playbook就相當於整個shell腳本。playbook是由一個或多個“play”組成的列表,play的主要功能在於將預定義的一組主機,裝扮成事先通過ansible中的task定義好的角色。task實際是調用ansible的一個模塊,將多個play組織在一個playbook中,即可以讓他們聯合起來,按事先編排的機制執行預定義的動作。

     如以上圖示,用戶可以把多條任務(ad-hoc任務)寫到playbook中,用戶用ansible-playbook命令調用執行編排好的playbook,ansible會讀取playbook中的每一條play和task,並按照playbook中的順序從上至下依次執行,ansible會調用每個task中定義的模塊去依次執行相應的任務,並按照playbook中指定的主機去主機清單里匹配對應的主機,然後通過ssh認證,把編譯好的相應的任務文件發送到對應的主機或網絡設備上執行,最後返回執行的狀態。

      二、YAML簡介

      playbook採用yaml語言編寫,yaml是一個可讀性高的用來表達資料序列格式的語言,它參考了其他很多種語言,包括:XML、C語言、python、perl以及电子郵箱格式RFC2822等。Clark Evans在2001年首次發表了這種語言,另外Ingy döt Net與Oren Ben-Kiki也是這語言的共同設計者。YAML( YAML Ain’t Markup Language),即yaml不是標記語言。不過在開發這種語言時,yaml的意思其實是:”Yet Another Markup Language”(仍是一種標記語言)

      ymal特性

      1)YAML的可讀性好

      2)YAML和腳本語言的交互性好

      3)YAML使用實現語言的數據類型

      4)YAML有一個一致的信息模板

      5)YAML易於實現,可以基於流程處理,表達能力強,擴展性好

    更多的內容及規範請參考官方文檔

      三、playbook語法簡介

      1)需要以“—”(3個減號)開始,且需頂行首寫。另外還有選擇性的連續三個點號(…)用來表示文件的結尾。

      2)次行開始正常寫playbook的內容,建議次行寫該playbook的功能,當然不寫也是可以的。

      3)使用“#”號註釋代碼。

      4)縮進必須統一,不能空格tab混用。

      5)縮進的級別必須是一致的,同樣的縮進代表同樣級別,程序判別配置的級別是通過縮進結合換行來實現的。

      6)YAML文件內容和Linux系統大小寫判斷方式一直,區分大小寫(大小寫敏感),k/v的值均大小寫敏感。

      7)k/v的值可同行寫也可換行寫。同行使用“:”分隔,換行寫需要以“-”分隔。

      8)v可以是字符串,也可以另外一個列表,當然也可以是字典。

      9)一個完整的代碼塊功能最少需要有name:xxx(對任務的描述)。

      10)一個name只能包括一個task

      11)yaml文件擴展名通常為yml或yaml

    list:列表,其所有元素均使用“-”開頭

    示例:

    ---
    # A list of tasty fruits
    
    - apple
    - orange
    - strawberry
    - mango
    ~           

    dictionary:字典,通常由多個key與value構成

    示例:

    ---
    #An employee record
    name: example developer
    job: developer
    skill: elite  

    當然也可以將key:value放置於{}中進行表示,用“,”分隔多個key:value

    示例:

    ---
    #An employee record
    {name: example developer,job: developer, skill: elite}
    ~                                                         

      YAML的語法和其他高階語言類似,並且可以簡單表達清單、散列表、標量等數據結構。其結構(Structure)通過空格來展示,序列(Sequence)里的項用”-“來代表,Map里的鍵值對用”:”分隔。

    示例:

    ---
    name: John Smith
    age: 41
    gender: Male
    spouse:
      name: Jane Smith
      age: 37
      gender: Female
    children:
      - name: Jimmy Smith
        age: 17
        gender: Male
      - name: Jenny Smith
        age: 13
        gender: Female
    ~                    
    

      四、playbook核心元素

      1)hosts  :指定執行任務的遠程主機列表(主機清單定義的主機組或單個主機,支持前面的說的主機模式匹配)

      2)tasks  :任務集

      3)varniables  :內置變量或自定義變量在playbook中調用

      4)templates  :模板,可替換模板文件中的變量並實現一些簡單邏輯的文件

      5)handlers  和  notity結合使用,由特定條件出發的操作,滿足條件方才執行,否則不執行

      6)tags標籤  :給指定的任務貼上標籤,我們在執行playbook的時候可以根據標籤選擇性的挑選部分代碼執行,如 ansible-playbook -t tagsname useradd.yml  ,這條命令的意思就是在useradd.yml中挑選標籤名為tagsname的任務執行

       五、playbook基礎組件

      1)hosts:

        playbook中的每一個play的目的都是為了讓特定主機以某個指定的用戶身份執行任務。hosts用於指定要執行任務的主機,須事先定義在主機清單中。hosts指定主機的形式同樣支持像主機清單中定義的那樣,支持通配,支持主機模式匹配與或非,支持IP地址,當然也支持混合匹配與或非。

    示例:在websers組,但不再dbsers組,可以這樣定義hosts

    ---
    - hosts: websers:!dbsers
    

      2)remote_user:可用於host和task中,也可以通過指定其通過sudo的方式在遠程執行任務,其可用於play全局或某個任務;此外,甚至可以在sudo時使用用sudo_user指定sudo時切換的用戶,如下所示

    ---
    - hosts: websers:!dbsers
      remote_user: root
    
      tasks:
        - name: test connection
          ping:
          remote_user: qiuhom
          sudo: yes
          sudo_user: qiuping
    

      說明:默認sudo 為root,上例指定了sudo_user 為qiuping,上述任務同sudo -u qiuping ping xxxx(代表某主機)命令一樣的意思,當然在使用sudo 時 我們還需要在目標主機上對qiuhom授權,要讓qiuhom這個用戶具有代表qiuping的權限去執行ping命令。

      3)task列表和action:play的主體部分是task list,task list 中的各任務按次序逐個在hosts中指定的所有主機上執行,即在所有主機上完成第一個任務后,再開始第二個任務;task的目的是使用指定的參數執行模塊,而在模塊參數中可以使用變量,模塊執行時是冪等的,這意味着多次執行時是安全的,其結果均一致;每個task都應該有其name,用於playbook的執行結果輸出,建議其內容能清晰地描述任務步驟,如未提供name,則action的結果將用於輸出。

      tasks:任務列表,它有兩種格式如下

        (1)action: module arguments

        (2)module: arguments        ##建議使用

       注意:shell模塊和command模塊後面跟的是命令,而非key=value

    如果某項任務的狀態在運行後為changed時,可通過“notify”通知給相應的handlers;當然任務可以通過“tags”打標籤,可以在ansible-playbook命令上使用-t指定進行指定其標籤名調用。

    示例:

    [qiuhom@test ~]$cat test.yml 
    ---
    - hosts: websers:!dbsers
      remote_user: root
    
      tasks:
        - name: test connection
          ping:
          remote_user: qiuhom
          sudo: yes
          sudo_user: qiuping 
          tags: test
        - name: test command
          shell: /bin/ls /home/qiuhom/
    [qiuhom@test ~]$ansible-playbook -t test test.yml 
    

      說明:用-t 指定標籤名,表示只運行所指定標籤所在的任務,當然同名的標籤可以在多條任務中,一個任務也可以有多個標籤。

    如果命令或腳本的退出碼不為零,可用使用如下方式忽略或跳過繼續執行以下代碼

    ---
    - hosts: websers:!dbsers
      remote_user: root
    
      tasks:
        - name: run this command and ignore the result
          shell: /usr/sbin/ip addr show eth0 || /bin/true
        - name: run this command and ignore the result
          shell: /usr/sbin/ip addr show eth0
          ignore_errors: True
    

      說明:兩種方式都可以跳過出錯的命令而不打斷playbook,繼續執行以下的代碼,前者使用的短路或的特性,後者使用ignore_errors參數來控制

      六、playbook運行的方式

    ansible-playbook <filename.yml> ... [options]
    

    常用選項:

      -C , –check  : 只檢查可能會發生的改變,但不真正執行操作,相當於空跑一遍playbook,測試下是否和自己預想的結果一樣,但它不會真正的去遠端主機上執行。常用於測試寫的playbook語法是否有誤。

      –list-hosts  :列出playbook指定運行任務所匹配的主機

      –list-tags    :列出playbook中所有標籤名稱列表

      –list-tasks  :列出playbook中所有任務名稱及標籤名稱

      –limit 主機列表   :只針對指定主機列表中的主機執行當前playbook(指定主機列表必須是在playbook里定義的主機列表範圍內)

      -v,-vv,-vvv       :  显示執行playbook的過程,-v,显示較簡單,-vv显示較詳細,-vvv显示整個過程(非常詳細)

    [root@test ~]#cat test.yml 
    ---
    - hosts: websers
      remote_user: root
    
      tasks:
        - name: run this command 
          shell: hostname
          tags: hostname
          ignore_errors: True
        - name: show ip addr
          shell: /sbin/ip addr show
          tags: showip
    [root@test ~]#ansible-playbook test.yml --list-hosts
    
    playbook: test.yml
    
      play #1 (websers): websers    TAGS: []
        pattern: [u'websers']
        hosts (2):
          192.168.0.128
          192.168.0.218
    [root@test ~]#ansible-playbook test.yml --list-tags
    
    playbook: test.yml
    
      play #1 (websers): websers    TAGS: []
          TASK TAGS: [hostname, showip]
    [root@test ~]#ansible-playbook test.yml --list-tasks
    
    playbook: test.yml
    
      play #1 (websers): websers    TAGS: []
        tasks:
          run this command  TAGS: [hostname]
          show ip addr      TAGS: [showip]
    [root@test ~]#ansible-playbook test.yml --limit 192.168.0.218
    
    PLAY [websers] ********************************************************************************************************
    
    TASK [Gathering Facts] ************************************************************************************************
    ok: [192.168.0.218]
    
    TASK [run this command] ***********************************************************************************************
    changed: [192.168.0.218]
    
    TASK [show ip addr] ***************************************************************************************************
    changed: [192.168.0.218]
    
    PLAY RECAP ************************************************************************************************************
    192.168.0.218              : ok=3    changed=2    unreachable=0    failed=0   
    
    [root@test ~]#ansible-playbook test.yml --limit 192.168.0.218 -v
    Using /etc/ansible/ansible.cfg as config file
    
    PLAY [websers] ********************************************************************************************************
    
    TASK [Gathering Facts] ************************************************************************************************
    ok: [192.168.0.218]
    
    TASK [run this command] ***********************************************************************************************
    changed: [192.168.0.218] => {"changed": true, "cmd": "hostname", "delta": "0:00:00.002139", "end": "2019-11-16 23:11:02.996962", "rc": 0, "start": "2019-11-16 23:11:02.994823", "stderr": "", "stderr_lines": [], "stdout": "localhost.localdomain", "stdout_lines": ["localhost.localdomain"]}
    
    TASK [show ip addr] ***************************************************************************************************
    changed: [192.168.0.218] => {"changed": true, "cmd": "/sbin/ip addr show", "delta": "0:00:00.002604", "end": "2019-11-16 23:11:03.733004", "rc": 0, "start": "2019-11-16 23:11:03.730400", "stderr": "", "stderr_lines": [], "stdout": "1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN \n    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00\n    inet 127.0.0.1/8 scope host lo\n    inet6 ::1/128 scope host \n       valid_lft forever preferred_lft forever\n2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP qlen 1000\n    link/ether 00:0c:29:e8:f6:7b brd ff:ff:ff:ff:ff:ff\n    inet 192.168.0.218/24 brd 192.168.0.255 scope global eth0\n    inet6 fe80::20c:29ff:fee8:f67b/64 scope link \n       valid_lft forever preferred_lft forever\n3: pan0: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state DOWN \n    link/ether d2:7a:38:cf:27:60 brd ff:ff:ff:ff:ff:ff", "stdout_lines": ["1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN ", "    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00", "    inet 127.0.0.1/8 scope host lo", "    inet6 ::1/128 scope host ", "       valid_lft forever preferred_lft forever", "2: eth0: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc pfifo_fast state UP qlen 1000", "    link/ether 00:0c:29:e8:f6:7b brd ff:ff:ff:ff:ff:ff", "    inet 192.168.0.218/24 brd 192.168.0.255 scope global eth0", "    inet6 fe80::20c:29ff:fee8:f67b/64 scope link ", "       valid_lft forever preferred_lft forever", "3: pan0: <BROADCAST,MULTICAST> mtu 1500 qdisc noop state DOWN ", "    link/ether d2:7a:38:cf:27:60 brd ff:ff:ff:ff:ff:ff"]}
    
    PLAY RECAP ************************************************************************************************************
    192.168.0.218              : ok=3    changed=2    unreachable=0    failed=0   
    
    [root@test ~]#
    

      說明:–limit 所指定的主機必須是在playbook中所指定的主機範圍內。

       七、playbook vs shell scripts

      1)shell腳本如下:

    #!/bin/bash
    # 安裝Apache
    yum install --quiet -y httpd
    # 複製配置文件
    cp /tmp/httpd.conf /etc/httpd/conf/httpd.conf
    cp/tmp/vhosts.conf /etc/httpd/conf.d/
    # 啟動Apache,並設置開機啟動
    service httpd start
    chkconfig httpd on
    

      2)playbook

    ---
    - hosts: websers
      remote_user: root
    
      tasks:
        - name: create apache group
          group: name=apache gid=80 system=yes
        - name: create apache user
          user: name=apache uid=80 group=apache system=yes shell=/sbin/nologin home=/var/www/html 
        - name: install httpd
          yum: name=httpd
        - name: copy config file
          copy: src=/tmp/httpd.conf dest=/etc/httpd/conf/
        - name: copy config 2 file
          copy: src=/tmp/vhosts.conf dest=/etc/httpd/conf.d/
        - name: start httpd service
          service: name=httpd state=started enabled=yes     
    

      說明:兩者都是實現同樣的目的,很明顯playbook的優勢要比腳本的優勢多,playbook 可以針對很多台主機進行任務執行,而腳本只可以在某一台主機上執行;腳本重複執行沒有冪等性,很有可能帶來很多錯誤,而playbook卻不會有這樣的苦惱。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

  • 快速搭建Jenkins集群

    快速搭建Jenkins集群

    關於Jenkins集群

    在Jenkins上同時執行多個任務時,單機性能可能達到瓶頸,使用Jenkins集群可以有效的解決此問題,讓多台機器同時處理這些任務可以將壓力分散,對單機版Jenkins的單點故障的隱患也有分散作用,今天就來實戰快速搭建Jenkins集群,Jenkins版本是2.190.2;

    如何做到快速搭建集群

    通過Docker可以省去大部分準備工作,您只需在Linux電腦上安裝docker,在輔以少量命令和操作即可完成集群搭建;

    環境信息

    本次實戰的環境一共要用三台電腦,它們的設置都是一樣的,如下:

    1. 操作系統:CentOS Linux release 7.6.1810
    2. 防火牆關閉
    3. docker:1.13.1

    三台電腦的信息如下:
    | 主機名 | IP地址 | 作用 |
    |–|–|–|
    | master | 192.168.133.131 | Jenkins集群的master節點,提供web服務 |
    | agent1 | 192.168.133.132 | Jenkins集群的一號工作接節點,標籤是maven |
    | agent2 | 192.168.133.133 | Jenkins集群的二號工作接節點,標籤是gradle |

    建議agent2節點的內存大於4G,因為下一篇的實戰操作會用agent2編譯構建spring-framework,對內存的需求略大;

    準備工作

    1. 後面的所有操作都是root賬號;
    2. 在每台電腦上創建文件夾/usr/local/jenkins

      創建Jenkins的master

    3. 登錄master機器,執行以下命令:
    docker run \
      -u root \
      -idt \
      --name master \
      -p 8080:8080 \
      -p 50000:50000 \
      -v /usr/local/jenkins:/var/jenkins_home \
      -v /var/run/docker.sock:/var/run/docker.sock \
      jenkinsci/blueocean:1.19.0
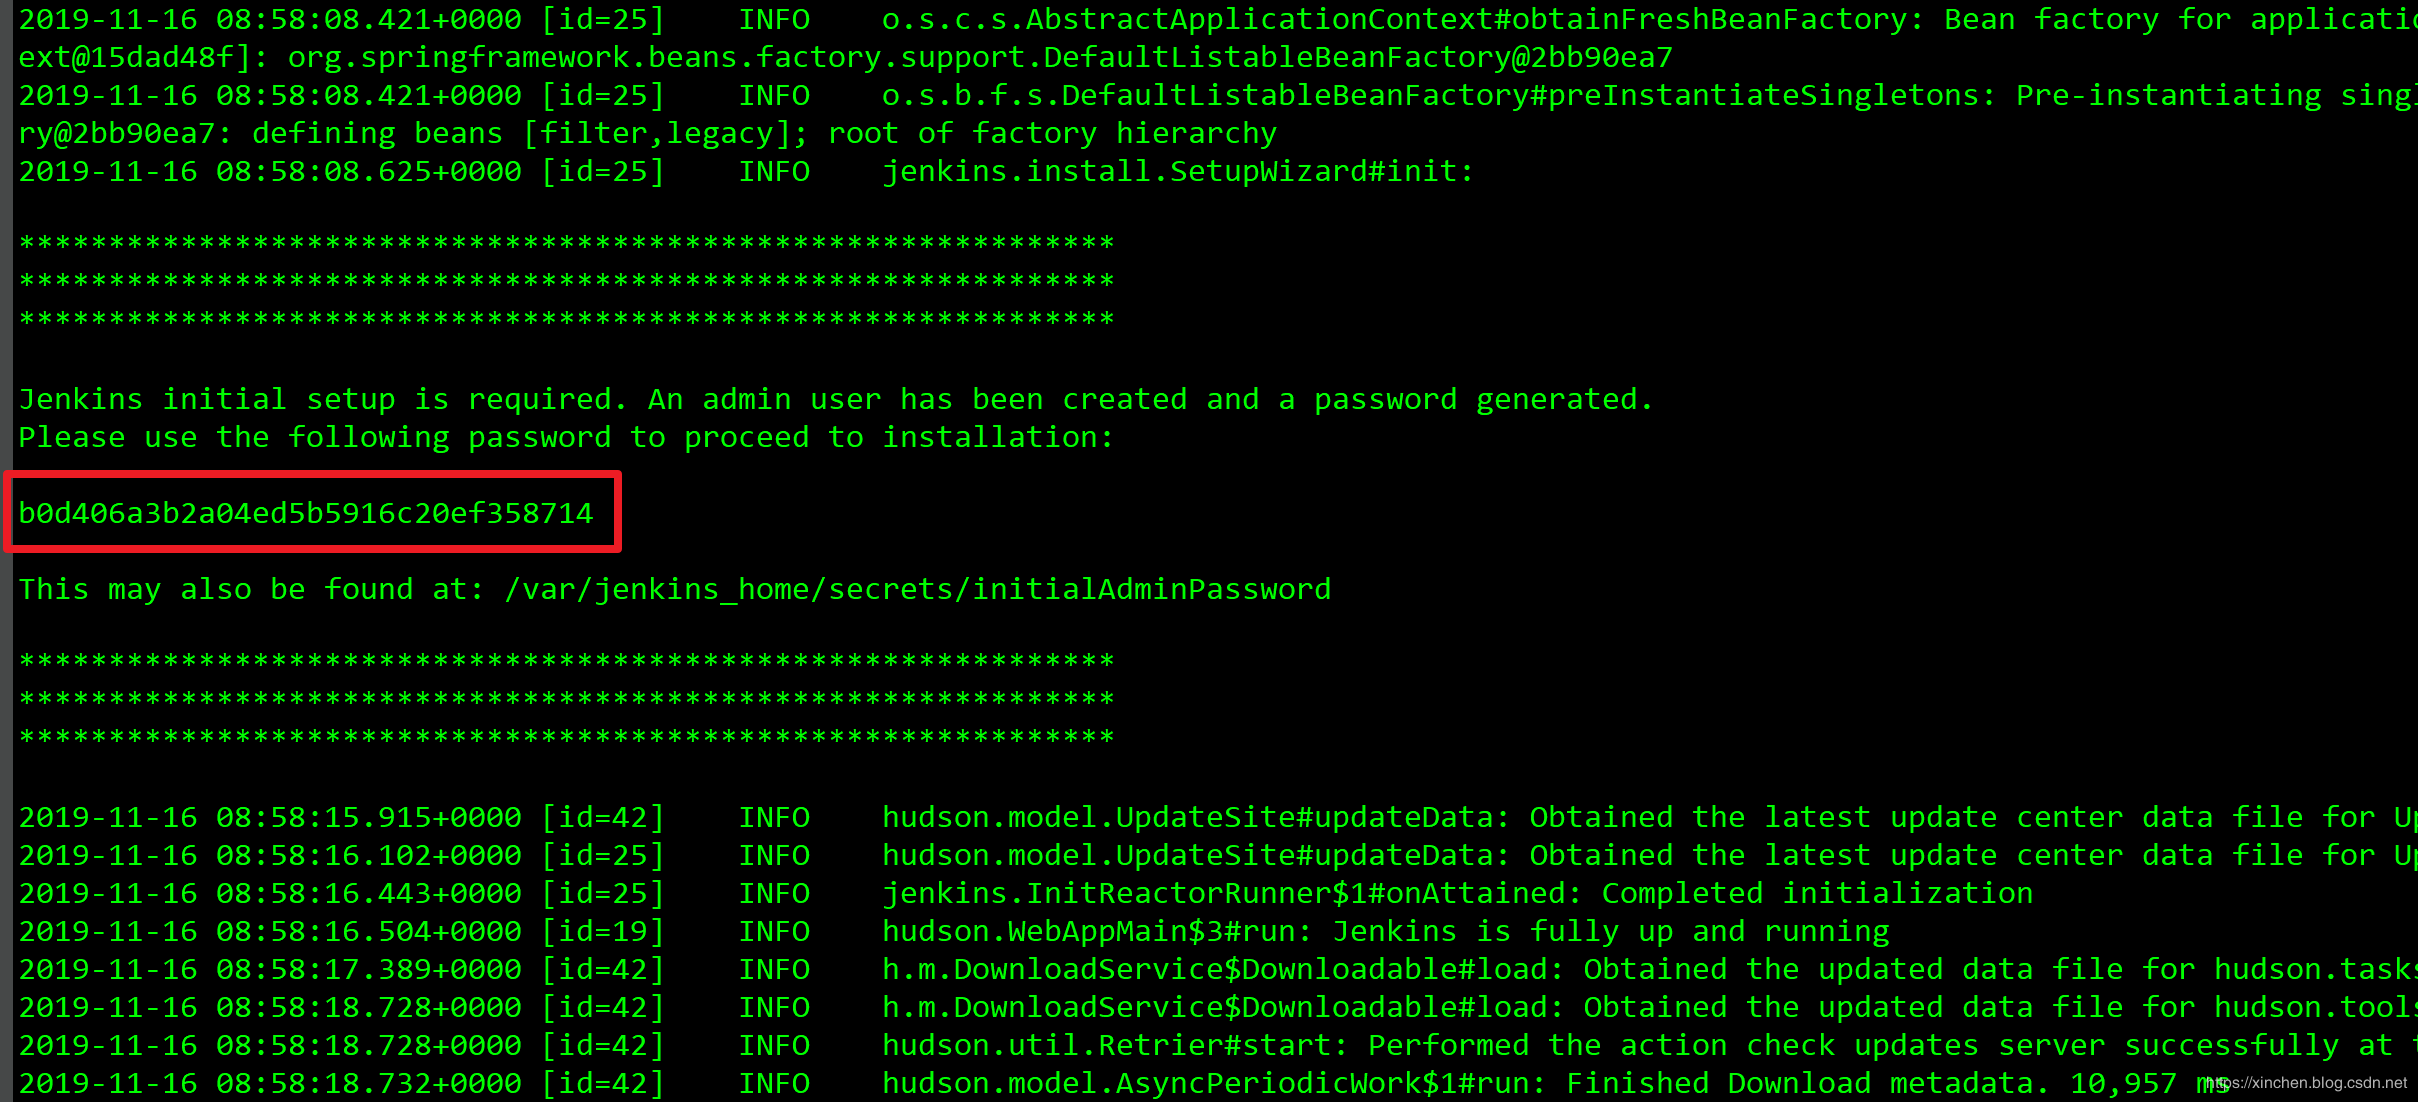
    1. 執行docker logs master,會在控制台显示jenkins的登錄秘鑰,如下圖紅框所示:
    2. 瀏覽器輸入地址: ,显示Jenkins登錄頁面,如下圖所示,在紅框位置輸入剛才複製的登錄秘鑰即可登錄:
    3. 選擇安裝推薦的插件:
    4. 靜候插件在線安裝完成:
    5. 接下來是創建管理員和使用實例url的操作,這裏就不多說了,您按實際情況自行斟酌;

      至此,Jenkins的master已經搭建好,接下來將agent1和agent2作為工作節點加入集群;

      加入agent1

    6. 在Jenkins網頁上新增節點,操作如下圖,先進入節點管理頁面:
    7. 如下圖,新增一個節點,名為agent1:
    8. 接下來的節點詳情信息如下圖,注意四個紅框中的內容要和圖中保持一致:
    9. 保存成功後會显示機器列表,如下圖,圖標上的紅叉表示機器不在線(此時agent1還沒有接入),點擊紅框:
    10. 如下圖所示,紅框中的命令就是agent1的啟動命令,執行該命令的機器會以agent1的身份加入集群:
    11. 注意上圖紅框中的agent.jar是個名為agent.jar的文件的下載鏈接,將此文件下載到agent1電腦的/usr/local/jenkins目錄下;
    12. ssh登錄agent1電腦,執行以下命令,即可將agent1加入Jenkins集群:
    docker run \
      -u root \
      -idt \
      --name agent \
      -v /usr/local/jenkins:/usr/local/jenkins \
      bolingcavalry/openjdk-with-sshpass:8u232 \
      java -jar /usr/local/jenkins/agent.jar \
      -jnlpUrl http://192.168.133.131:8080/computer/agent1/slave-agent.jnlp \
      -secret 44c3e8d1531754b8655b53294bbde6dd99b3aaa91a250092d0d3425534ae1058 \
      -workDir "/usr/local/jenkins"

    上述命令中的後半部分,即java -jar ……就是前面圖片紅框中的agent1啟動命令,唯一要改變的是將agent.jar改成絕對路徑/usr/local/jenkins/agent.jar

    1. 上述命令的鏡像是bolingcavalry/openjdk-with-sshpass:8u232,其Dockerfile內容如下,可見非常簡單,就是OpenJDK鏡像裏面安裝了sshpass,這樣的容器可以在執行ssh命令時帶上遠程機器的密碼,而不用等待用戶輸入密碼,這樣便於shell腳本執行ssh命令:
    FROM openjdk:8u232
    
    ARG DEBIAN_FRONTEND=noninteractive
    RUN apt-get update && apt-get install --assume-yes sshpass
    1. 去Jenkins的網頁上查看節點列表,如下圖,可見agent1已經成功加入:

      加入agent2

      agent2加入集群的方式和agent1大部分是一樣的,只有以下兩點要注意:

    2. 在Jenkins頁面上創建節點,名稱是agent2
    3. agent2的標籤是gradle,如下圖紅框所示:
    4. 此時agent2也加入成功:

      至此,Jenkins集群搭建完成,這兩個節點帶有不同的標籤,下一篇文章中,我們在這個集群環境創建pipeline任務,並通過標籤被分配到不同的節點上,實現多節點并行執行;

      歡迎關注公眾號:程序員欣宸

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想要讓你的商品成為最夯、最多人討論的話題?網頁設計公司讓你強力曝光

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

  • 數據結構之隊列and棧總結分析

    一、前言:

      數據結構中隊列和棧也是常見的兩個數據結構,隊列和棧在實際使用場景上也是相輔相成的,下面簡單總結一下,如有不對之處,多多指點交流,謝謝。

    二、隊列簡介

      隊列顧名思義就是排隊的意思,根據我們的實際生活不難理解,排隊就是有先後順序,先到先得,其實在程序數據結構中的隊列其效果也是一樣,及先進先出。

         隊列大概有如下一些特性:

         1、操作靈活,在初始化時不需要指定其長度,其長度自動增加(默認長度為32)

            注:在實際使用中,如果事先能夠預估其長度,那麼在初始化時指定長度,可以提高效率

            2、泛型的引入,隊列在定義時可以指定數據類型避免裝箱拆箱操作

         3、存儲數據滿足先進先出原則


       c#中有關隊列的幾個常用方法:

      • Count:Count屬性返回隊列中元素個數。
      • Enqueue:Enqueue()方法在隊列一端添加一個元素。
      • Dequeue:Dequeue()方法在隊列的頭部讀取和刪除元素。如果在調用Dequeue()方法時,隊列中不再有元素,就拋出一個InvalidOperationException類型的異常。
      • Peek:Peek()方法從隊列的頭部讀取一個元素,但不刪除它。
      • TrimExcess:TrimExcess()方法重新設置隊列的容量。Dequeue()方法從隊列中刪除元素,但它不會重新設置隊列的容量。要從隊列的頭部去除空元素,應使用TrimExcess()方法。
      • Clear:Clear()方法從隊列中移除所有的元素。
      • ToArray:ToArray()複製隊列到一個新的數組中。

      下面通過隊列來實例模擬消息隊列的實現流程:


    using System;
    using System.Collections;
    using System.Collections.Generic;
    
    namespace dataStructureQueueTest
    {
        class Program
        {
            static void Main(string[] args)
            {
                Console.WriteLine("通過Queue來模擬消息隊列的實現");
                QueueTest queueTest = new QueueTest();
    
                while (true)
                {
                    Console.WriteLine("請輸入你操作的類型:1:代表生成一條消息,2:代表消費一條消息");
                    string type = Console.ReadLine();
                    if (type == "1")
                    {
                        Console.WriteLine("請輸入具體消息:");
                        string inforValue = Console.ReadLine();
                        queueTest.InformationProducer(inforValue);
                    }
                    else if (type == "2")
                    {
                        //// 在消費消息的時候,模擬一下,消費成功與消費失敗下次繼續消費的場景
    
                        object inforValue = queueTest.InformationConsumerGet();
                        if (inforValue == null)
                        {
                            Console.WriteLine("當前無可消息可消費");
                        }
                        else
                        {
                            Console.WriteLine("獲取到的消息為:" + inforValue);
    
                            Console.WriteLine("請輸入消息消費結果:1:成功消費消息,2:消息消費失敗");
                            string consumerState = Console.ReadLine();
    
                            ///// 備註:該操作方式線程不安全,在多線程不要直接使用
                            if (consumerState == "1")
                            {
                                queueTest.InformationConsumerDel();
                            }
                        }
                    }
                    else
                    {
                        Console.WriteLine("操作有誤,請重新選擇");
                    }
                }
            }
        }
    
        /// <summary>
        /// 隊列練習
        /// </summary>
        public class QueueTest
        {
            /// <summary>
            /// 定義一個隊列
            /// </summary>
            public Queue<string> queue = new Queue<string>();
    
            /// <summary>
            /// 生成消息--入隊列
            /// </summary>
            /// <param name="inforValue"></param>
            public void InformationProducer(string inforValue)
            {
                queue.Enqueue(inforValue);
            }
    
            /// <summary>
            /// 消費消息---出隊列--只獲取數據,不刪除數據
            /// </summary>
            /// <returns></returns>
            public object InformationConsumerGet()
            {
                if (queue.Count > 0)
                {
                    return queue.Peek();
                }
    
                return null;
            }
    
            /// <summary>
            /// 消費消息---出隊列---獲取數據的同時刪除數據
            /// </summary>
            /// <returns></returns>
            public string InformationConsumerDel()
            {
                if (queue.Count > 0)
                {
                    return queue.Dequeue();
                }
    
                return null;
            }
        }
    }


    三、棧簡介

      棧和隊列在使用上很相似,只是棧的數據存儲滿足先進后出原則,棧有如下一些特性:

         1、操作靈活,在初始化時不需要指定其長度,其長度自動增加(默認長度為10)

            注:在實際使用中,如果事先能夠預估其長度,那麼在初始化時指定長度,可以提高效率

            2、泛型的引入,棧在定義時可以指定數據類型避免裝箱拆箱操作

         3、存儲數據滿足先進后出原則

        c#中有關棧的幾個常用方法:

    • Count:Count屬性返回棧中的元素個數。
    • Push:Push()方法在棧頂添加一個元素。
    • Pop:Pop()方法從棧頂刪除一個元素,並返回該元素。如果棧是空的,就拋出一個InvalidOperationException類型的異常。
    • Peek:Peek()方法返回棧頂的元素,但不刪除它。
    • Contains:Contains()方法確定某個元素是否在棧中,如果是,就返回true。

         下面通過一個棧來模擬瀏覽器的回退前進操作的實現


    using System;
    using System.Collections.Generic;
    
    namespace dataStructureStackTest
    {
        class Program
        {
            static void Main(string[] args)
            {
                //// 通過棧來模擬瀏覽器回退前進操作
                ////   1、定義兩個棧,分別記錄回退的地址集合,和前進地址集合
                ////   2、在操作具體的回退或者前進操作時
                ////      如果和前一次操作相同,那麼就取出對應隊列的一條數據存儲到另外一個隊列
                Console.WriteLine("本練習模擬瀏覽器的回退前進操作:");
    
                /// 假設瀏覽器已瀏覽了20個網站記錄
                StackTest stackTestBack = new StackTest(20);
                StackTest stackTestGo = new StackTest(20);
                for (int i = 0; i < 20; i++)
                {
                    stackTestBack.PushStack("網站" + (i + 1).ToString());
                }
    
                //// 記錄上一次操作
                string beforOpert = "";
                while (true)
                {
                    Console.WriteLine("");
                    Console.WriteLine("請輸入你操作的類型:1:回退,2:前進");
                    string type = Console.ReadLine();
    
                    if (type == "1")
                    {
                        //// 出棧
                        if (beforOpert == type)
                        {
                            stackTestGo.PushStack(stackTestBack.GetAndDelStack());
                        }
                        string wbeSit = stackTestBack.GetStack();
                        Console.WriteLine("回退到頁面:" + wbeSit);
                        beforOpert = type;
                    }
                    else if (type == "2")
                    {
                        //// 出棧
                        if (beforOpert == type)
                        {
                            stackTestBack.PushStack(stackTestGo.GetAndDelStack());
                        }
                        string wbeSit = stackTestGo.GetStack();
    
                        Console.WriteLine("回退到頁面:" + wbeSit);
                        beforOpert = type;
                    }
                    else
                    {
                        Console.WriteLine("請輸入正確的操作方式!!");
                    }
                }
            }
        }
    
        /// <summary>
        /// 隊列練習
        /// </summary>
        public class StackTest
        {
            /// <summary>
            /// 定義一個棧
            /// </summary>
            public Stack<string> stack;
    
            /// <summary>
            ///無參數構造函數,棧初始化為默認長度
            /// </summary>
            public StackTest()
            {
                stack = new Stack<string>();
            }
    
            /// <summary>
            ///有參數構造函數,棧初始化為指定長度
            ///如果在定義隊列時,如果知道需要存儲的數據長度,那麼最好預估一個長度,並初始化指定的長度
            /// </summary>
            public StackTest(int stackLen)
            {
                stack = stackLen > 0 ? new Stack<string>(stackLen) : new Stack<string>();
            }
    
            /// <summary>
            /// 入棧
            /// </summary>
            /// <param name="inforValue"></param>
            public void PushStack(string inforValue)
            {
                stack.Push(inforValue);
            }
    
            /// <summary>
            /// 出棧(但不刪除)
            /// </summary>
            /// <returns></returns>
            public string GetStack()
            {
                if (stack.Count > 0)
                {
                    return stack.Peek();
                }
    
                return null;
            }
    
            /// <summary>
            /// 出棧(並刪除)
            /// </summary>
            /// <returns></returns>
            public string GetAndDelStack()
            {
                if (stack.Count > 0)
                {
                    return stack.Pop();
                }
    
                return null;
            }
        }
    }


    四、使用場景總結

      根據隊列和棧的特點,下面簡單總結一下隊列和棧的一些實際使用場景

       隊列:

        1、異步記錄日誌,此處會涉及到單例模式的使用

        2、消息隊列

        3、業務排隊,比如12306車票購買排隊等候

        4、其他符合先進先出原則的業務操作

       棧:

        1、可回退的操作記錄,比如:瀏覽器的回退操作

        2、計算表達式匹配,比如:計算器表達式計算

        3、其他符合先進后出原則的業務操作


    附件:

    關於這一些練習的代碼,上傳到github,有興趣的可以看一下:


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

    ※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

    ※評比南投搬家公司費用收費行情懶人包大公開

  • 深入理解java繼承從“我爸是李剛”講起

    深入理解java繼承從“我爸是李剛”講起

    目錄

    前言
    本文主要多方面講解java繼承,旨在讓初學者通俗易懂,至於“我爸是李剛”,反正樓主也不知道誰爸是李剛。
    @

    1、繼承的概述

    1.1、繼承的由來

    至於由來簡單一句話:多個類中存在相同屬性和行為時,將這些內容抽取到單獨一個類中,那麼多個類無需再定義這些屬性和行為。

    繼承描述的是事物之間的所屬關係,這種關係是 is-a 的關係。

    1.2、繼承的定義

    繼承:就是子類繼承父類的屬性和行為,使得子類對象具有與父類相同的屬性、相同的行為。子類可以直接訪問父類中的非私有的屬性和行為。

    這裏再聲明一點,父類又稱為超類或者基類。而子類又稱為派生類這點很基礎!

    1.3、繼承的優點

    1. 提高代碼的復用性。
    2. 類與類之間產生關係,為多態做了完美的鋪墊(不理解沒關係,之後我會再寫一篇多態的文章)

    雖然繼承的優點很多但是Java只支持單繼承,不支持多繼承。

    1.4、繼承的格式

    通過 extends 關鍵字,可以聲明一個子類繼承另外一個父類,定義格式如下:

      class 父類 {
       ... 
       }
       class 子類 extends 父類 { 
       ... 
       } 

    2、關於繼承之後的成員變量

    當類之間產生了關係后,其中各類中的成員變量,產生了哪些影響呢? 關於繼承之後的成員變量要從兩方面下手,一是成員變量不重名方面,二是成員變量重名方面。

    2.1、成員變量不重名

    如果子類父類中出現不重名的成員變量,這時的訪問是沒有影響的。代碼如下:

      class liGang {
            // 父類中的成員變量。
           String name ="李剛";//------------------------------父類成員變量是name
        }
        class LiXiaoGang extends liGang {
            // 子類中的成員變量
            String name2 ="李小剛";//--------------------------子類成員變量是name2
            // 子類中的成員方法
            public void show() {
                // 訪問父類中的name,
                System.out.println("我爸是"+name);
                // 繼承而來,所以直接訪問。
                // 訪問子類中的name2
                System.out.println("我是"+name2);
            }
        }
    public class Demo {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang z = new LiXiaoGang();
                // 調用子類中的show方法
                z.show();
            }
        }
        //演示結果: 我爸是李剛   我是李小剛

    2.2、 成員變量重名

    如果子類父類中出現重名的成員變量,這時的訪問是有影響的。代碼如下:

    class liGang {
            // 父類中的成員變量。
           String name ="李剛";//------------------------------父類成員變量是name
        }
        class LiXiaoGang extends liGang {
            // 子類中的成員變量
            String name ="李小剛";//---------------------------子類成員變量也是name
            // 子類中的成員方法
            public void show() {
                // 訪問父類中的name,
                System.out.println("我爸是"+name);
                // 繼承而來,所以直接訪問。
                // 訪問子類中的name2
                System.out.println("我是"+name);
            }
        }
    public class Demo {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang z = new LiXiaoGang();
                // 調用子類中的show方法
                z.show();
            }
        }
        //演示結果: 我爸是李小剛   我是李小剛


    子父類中出現了同名的成員變量時,在子類中需要訪問父類中非私有成員變量時,需要使用 super 關鍵字,至於修飾父類成員變量,類似於之前學過的 this 。 使用格式 super.父類成員變量名

    this表示當前對象,super則表示父類對象,用法類似!

    class liGang {
            // 父類中的成員變量。
           String name ="李剛";
        }
        class LiXiaoGang extends liGang {
            // 子類中的成員變量
            String name ="李小剛";
            // 子類中的成員方法
            public void show() {
                // 訪問父類中的name,
                System.out.println("我爸是"+super.name);
                // 繼承而來,所以直接訪問。
                // 訪問子類中的name2
                System.out.println("我是"+this.name);  //當然this可省略
            }
        }
    public class Demo {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang z = new LiXiaoGang();
                // 調用子類中的show方法
                z.show();
            }
        }
        //演示結果: 我爸是李剛   我是李小剛

    2.3、關於繼承中成員變量值得思考的一個問題

    同學你有沒有想過這樣一個問題。如果父類中的成員變量
    非私有:子類中可以直接訪問。
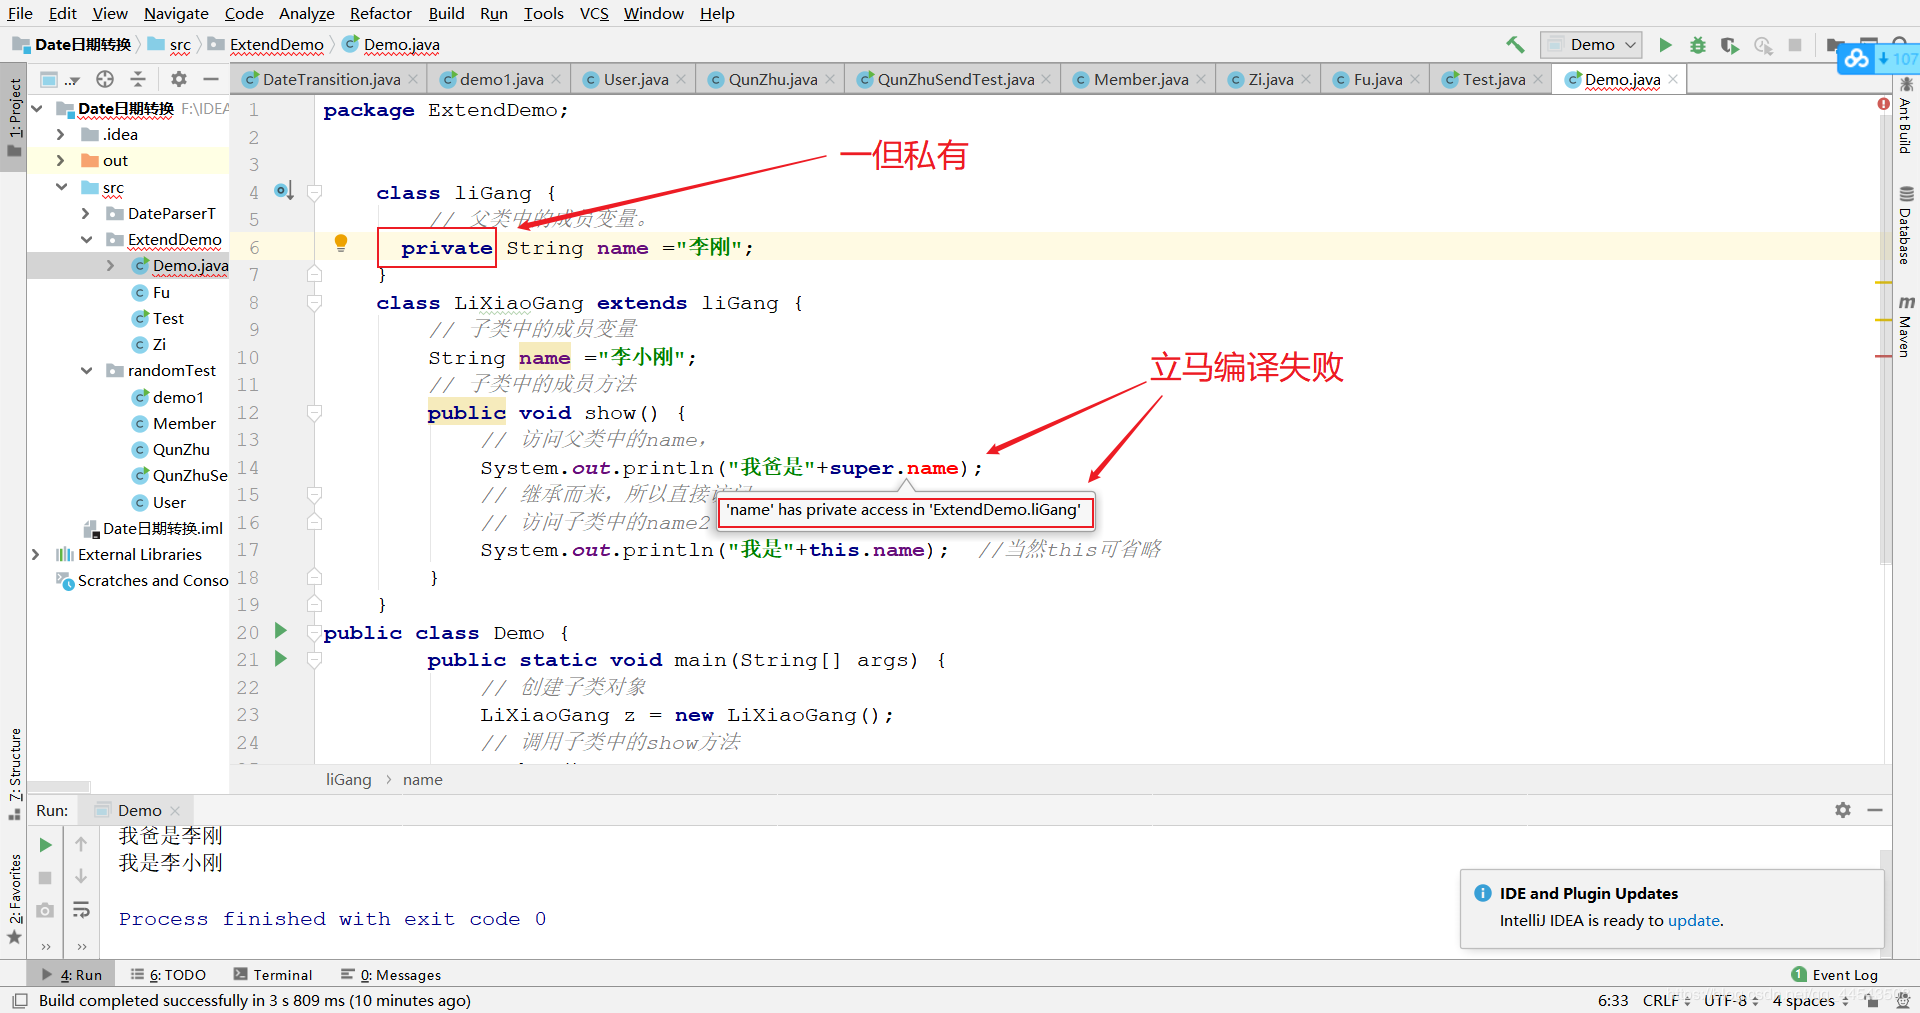
    私有:子類是不能直接訪問的。如下:

    當然,同學你要自己體驗體驗編譯報錯過程,看圖沒體驗感不得勁,~嘔,你這無處安放的魅力,無理的要求,我佛了,行吧~

      class liGang2 {
            // 父類中的成員變量。
            private String name ="李剛";
    
        }
        class LiXiaoGang2 extends liGang2 {
            // 子類中的成員變量
            String name ="李小剛";
            // 子類中的成員方法
            public void show() {
                // 訪問父類中的name,
                System.out.println("我爸是"+super.name);//------編譯失敗不能直接訪問父類私有屬性(成員變量)
                // 繼承而來,所以直接訪問。
                // 訪問子類中的name2
                System.out.println("我是"+this.name);  //當然this可省略
            }
        }
    public class PrivateVariable {
            public static void main(String[] args) {
                // 創建子類對象
                ExtendDemo.LiXiaoGang z = new ExtendDemo.LiXiaoGang();
                // 調用子類中的show方法
                z.show();
            }
        }

    通常開發中編碼時,我們遵循封裝的原則,使用private修飾成員變量,那麼如何訪問父類的私有成員變量呢?其實這個時候在父類中提供公共的getXxx方法和setXxx方法就可以了。代碼如下:

    class liGang {
            // 父類中的成員變量。
          private String name ="李剛";
    
            public String getName() {
                return name;
            }
    
            public void setName(String name) {
                this.name = name;
            }
        }
        class LiXiaoGang extends liGang {
            // 子類中的成員變量
            String name ="李小剛";
            // 子類中的成員方法
            public void show() {
                // 訪問父類中的name,
                System.out.println("我爸是"+super.getName());
                // 繼承而來,所以直接訪問。
                // 訪問子類中的name2
                System.out.println("我是"+this.name);  //當然this可省略
            }
        }
    public class Demo {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang z = new LiXiaoGang();
                // 調用子類中的show方法
                z.show();
            }
        }
        //演示結果: 我爸是李剛   我是李小剛

    分析如下:

    3、關於繼承之後的成員方法

    分析完了成員變量,現在我們一起來分析分析成員方法。
    想一想,當類之間產生了關係,其中各類中的成員方法,又產生了哪些影響呢? 同樣我們依舊從兩方面分析。
    #### 3.1、成員方法不重名
    如果子類父類中出現不重名的成員方法,這時的調用是沒有影響的。對象調用方法時,會先在子類中查找有沒有對 應的方法,若子類中存在就會執行子類中的方法,若子類中不存在就會執行父類中相應的方法。代碼如下:

     class liGang3 {
            // 父類中的成員方法。
           public void zhuangRen1(){//--------------------------父類方法名zhuangRen1
               System.out.println("我叫李剛,人不是我撞的,別抓我,我不認識李小剛");
           }
        }
        class LiXiaoGang3 extends liGang3 {
    
            // 子類中的成員方法
            public void zhuangRen() {//--------------------------子類方法名zhuangRen
                System.out.println("有本事你們告去,我爸是李剛");  
            }
        }
        public class MemberMethod {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang3 liXiaoGang = new LiXiaoGang3();
                // 調用子類中的show方法
                liXiaoGang.zhuangRen();
                liXiaoGang.zhuangRen1();
            }
        }
        
    打印結果:有本事你們告去,我爸是李剛
            我叫李剛,人不是我撞的,別抓我,我不認識李小剛
    

    #### 3.2、成員方法重名 【方法重寫】
    成員方法重名大體也可以分兩種情況:

    1、方法名相同返回值類型、參數列表卻不相同(優先在子類查找,沒找到就去父類)
    2、方法名、返回值類型、參數列表都相同,沒錯這就是重寫(Override)

    這裏主要講方法重寫 :子類中出現與父類一模一樣的方法時(返回值類型,方法名和參數列表都相同),會出現覆蓋效果,也稱為重寫或者複寫。聲明不變,重新實現。 代碼如下:

        class liGang3 {
            // 父類中的成員方法。
           public void zhuangRen(int a){
               System.out.println("我叫李剛,人不是我撞的,別抓我");
           }
        }
        class LiXiaoGang3 extends liGang3 {
    
            // 子類中的成員方法
            public void zhuangRen(int a) {
                System.out.println("有本事你們告去,我爸是李剛");
            }
        }
        public class MemberMethod {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang3 liXiaoGang = new LiXiaoGang3();
                // 調用子類中的zhuangRen方法
                liXiaoGang.zhuangRen(1);
    
            }
        }
        結果打印:有本事你們告去,我爸是李剛

    #### 3.3、繼承中重寫方法的意義
    子類可以根據需要,定義特定於自己的行為。既沿襲了父類的功能名稱,又根據子類的需要重新實現父類方法,從而進行擴展增強。比如李剛會開車,李小剛就牛了,在父類中進行擴展增強還會開車撞人,代碼如下:

     class liGang3 {
            // 父類中的成員方法。
           public void kaiChe(){
               System.out.println("我會開車");
           }
        }
        class LiXiaoGang3 extends liGang3 {
            // 子類中的成員方法
            public void kaiChe(){
                super.kaiChe();
                System.out.println("我還會撞人");
                System.out.println("我還能一撞撞倆婆娘");
            }
        }
        public class MemberMethod {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang3 liXiaoGang = new LiXiaoGang3();
                // 調用子類中的zhuangRen方法
                liXiaoGang.kaiChe();
    
    打印結果:   我會開車
               我還會撞人
               我還能一撞撞倆婆娘
            }
        }
    

    不知道同學們發現了沒有,以上代碼中在子類中使用了 super.kaiChe();super.父類成員方法,表示調用父類的成員方法。

    最後重寫必須注意這幾點:

    1、方法重寫時, 方法名與形參列表必須一致。
    2、子類方法覆蓋父類方法時,必須要保證子類權限 >= 父類權限。
    3、方法重寫時,子類的返回值類型必須要 <= 父類的返回值類型。
    4、方法重寫時,子類拋出的異常類型要 <= 父類拋出的異常類型。

    粗心的同學看黑板,look 這裏【注意:只有訪問權限是>=,返回值、異常類型都是<=】

    下面以修飾權限為例,如下:

    4、關於繼承之後的構造方法

    為了讓你更好的體會,首先我先編寫一個程序

       class liGang4 {
            // 父類的無參構造方法。
            public liGang4(){
                System.out.println("父類構造方法執行了。。。");
            }
        }
        class LiXiaoGang4 extends liGang4 {
            // 子類的無參構造方法。
           public LiXiaoGang4(){
               System.out.println("子類構造方法執行了====");
           }
        }
        public class ConstructionDemo {
            public static void main(String[] args) {
                // 創建子類對象
                LiXiaoGang4 z = new LiXiaoGang4();
    
            }
        }

    用一分鐘猜想一下結果是什麼,猜好了再看下面結果:

    父類構造方法執行了。。。
    子類構造方法執行了====

    好了,看了結果之後,你可能有疑惑。父類構造器方法怎麼執行了?我們先來分析分析,首先在main方法中實例化了子類對象,接着會去執行子類的默認構造器初始化,這個時候在構造方法中默認會在第一句代碼中添加super();沒錯,他就是開掛般的存在,不寫也存在的!有的調~讀四聲“跳”~皮的同學就會說,你說存在就存在啊,無憑無據 ~呀,你這個該死的靚仔~ 如下:

    構造方法的名字是與類名一致的,所以子類是無法繼承父類構造方法的。 構造方法的作用是初始化成員變量的。所以子類的初始化過程中,必須先執行父類的初始化動作。子類的構造方法中默認會在第一句代碼中添加super(),表示調用父類的構造方法,父類成員變量初始化后,才可以給子類使用。

    當然我已經強調很多遍了 super() 不寫也默認存在,而且只能是在第一句代碼中,不在第一句代碼中行不行,答案是當然不行,這樣會編譯失敗,如下:

    5、關於繼承的多態性支持的例子

    直接上代碼了喔

    class A{
        public String show(C obj) {
            return ("A and C");
        }
    
        public String show(A obj) {
            return ("A and A");
        }
    
    }
    class B extends A{
        public String show(B obj) {
            return ("B and B");
        }
    }
    class C extends B{
        public String show(A obj) {
            return ("A and B");
        }
    }
    public class Demo1 {
        public static void main(String[] args) {
            A a=new A();
            B b=new B();
            C c=new C();
            System.out.println("第一題 " + a.show(a));
            System.out.println("第二題 " + a.show(b));
            System.out.println("第三題 " + a.show(c));
        }
    }
    運行結果:
            第一題 A and A
            第二題 A and A
            第三題 A and C

    其實吧,第一題和第三題都好理解,第二題就有點意思了,會發現A類中沒有B類型這個參數,這個時候,你就應該知道子類繼承就是父類,換句話說就是子類天然就是父類,比如中國人肯定是人,但是人不一定是中國人(可能是火星人也可能是非洲人),所以父類做為參數類型,直接傳子類的參數進去是可以的,反過來,子類做為參數類型,傳父類的參數進去,就需要強制類型轉換。

    6、super與this的用法

    了解他們的用法之前必須明確一點的是父類空間優先於子類對象產生

    在每次創建子類對象時,先初始化父類空間,再創建其子類對象本身。目的在於子類對象中包含了其對應的父類空間,便可以包含其父類的成員,如果父類成員非private修飾,則子類可以隨意使用父類成員。代碼體現在子類的構 造方法調用時,一定先調用父類的構造方法。理解圖解如下:

    #### 5.1、 super和this的含義:

    super :代表父類的存儲空間標識(可以理解為父親的引用)。


    this :代表當前對象的引用(誰調用就代表誰)。

    #### 5.2、 super和this訪問成員

    this.成員變量 ‐‐ 本類的
    super.成員變量 ‐‐ 父類的
    this.成員方法名() ‐‐ 本類的
    super.成員方法名() ‐‐ 父類的

    #### 5.3、super和this訪問構造方法

    this(...) ‐‐ 本類的構造方法
    super(...) ‐‐ 父類的構造方法

    #### 5.4、super()和this()能不能同時使用?

    不能同時使用,this和super不能同時出現在一個構造函數裏面,因為this必然會調用其它的構造函數,其它的構造函數必然也會有super語句的存在,所以在同一個構造函數裏面有相同的語句,就失去了語句的意義,編譯器也不會通過。
    #### 5.5、總結一下super與this

    子類的每個構造方法中均有默認的super(),調用父類的空參構造。手動調用父類構造會覆蓋默認的super()。 super() 和 this() 都必須是在構造方法的第一行,所以不能同時出現。

    到這裏,java繼承你get到了咩,get到了請咩一聲,隨便隨手~點個讚唄~

    推薦閱讀本專欄的下一篇java文章

    歡迎各位關注我的公眾號,一起探討技術,嚮往技術,追求技術…

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※台北網頁設計公司這麼多,該如何挑選?? 網頁設計報價省錢懶人包"嚨底家"

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家費用,距離,噸數怎麼算?達人教你簡易估價知識!

  • 徹底搞懂 netty 線程模型

    徹底搞懂 netty 線程模型

    編者注:Netty是Java領域有名的開源網絡庫,特點是高性能和高擴展性,因此很多流行的框架都是基於它來構建的,比如我們熟知的Dubbo、Rocketmq、Hadoop等。本文就netty線程模型展開分析討論下 : )

    IO模型

    • BIO:同步阻塞IO模型;
    • NIO:基於IO多路復用技術的“非阻塞同步”IO模型。簡單來說,內核將可讀可寫事件通知應用,由應用主動發起讀寫操作;
    • AIO:非阻塞異步IO模型。簡單來說,內核將讀完成事件通知應用,讀操作由內核完成,應用只需操作數據即可;應用做異步寫操作時立即返回,內核會進行寫操作排隊並執行寫操作。

    NIO和AIO不同之處在於應用是否進行真正的讀寫操作。

    reactor和proactor模型

    • reactor:基於NIO技術,可讀可寫時通知應用;
    • proactor:基於AIO技術,讀完成時通知應用,寫操作應用通知內核。

    netty線程模型

    netty的線程模型是基於Reactor模型的。

    netty單線程模型

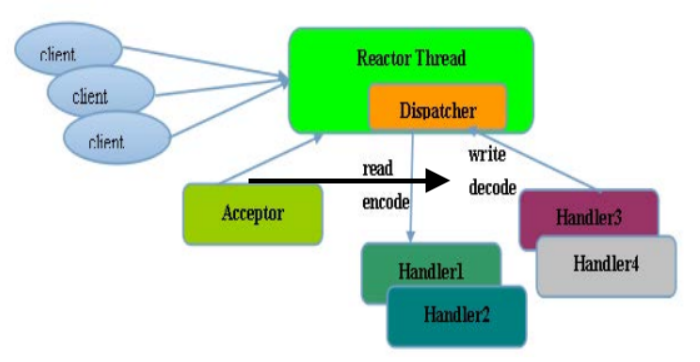
    Reactor 單線程模型,是指所有的 I/O 操作都在同一個 NIO 線程上面完成的,此時NIO線程職責包括:接收新建連接請求、讀寫操作等。

    在一些小容量應用場景下,可以使用單線程模型(注意,Redis的請求處理也是單線程模型,為什麼Redis的性能會如此之高呢?因為Redis的讀寫操作基本都是內存操作,並且Redis協議比較簡潔,序列化/反序列化耗費性能更低)。但是對於高負載、大併發的應用場景卻不合適,主要原因如下:

    • 一個NIO線程同時處理成百上千的連接,性能上無法支撐,即便NIO線程的CPU負荷達到100%,也無法滿足海量消息的編碼、解碼、讀取和發送。
    • 當NIO線程負載過重之後,處理速度將變慢,這會導致大量客戶端連接超時,超時之後往往會進行重發,這更加重了NIO線程的負載,最終會導致大量消息積壓和處理超時,成為系統的性能瓶頸。
    • 可靠性問題:一旦NIO線程意外跑飛,或者進入死循環,會導致整個系統通信模塊不可用,不能接收和處理外部消息,造成節點故障。

    Reactor多線程模型

    Rector 多線程模型與單線程模型最大的區別就是有一組 NIO 線程來處理連接讀寫操作,一個NIO線程處理Accept。一個NIO線程可以處理多個連接事件,一個連接的事件只能屬於一個NIO線程。

    在絕大多數場景下,Reactor 多線程模型可以滿足性能需求。但是,在個別特殊場景中,一個 NIO 線程負責監聽和處理所有的客戶端連接可能會存在性能問題。例如併發百萬客戶端連接,或者服務端需要對客戶端握手進行安全認證,但是認證本身非常損耗性能。在這類場景下,單獨一個 Acceptor 線程可能會存在性能不足的問題,為了解決性能問題,產生了第三種 Reactor 線程模型——主從Reactor 多線程模型。

    Reactor主從多線程模型

    主從 Reactor 線程模型的特點是:服務端用於接收客戶端連接的不再是一個單獨的 NIO 線程,而是一個獨立的 NIO 線程池。Acceptor 接收到客戶端 TCP連接請求並處理完成后(可能包含接入認證等),將新創建的 SocketChannel注 冊 到 I/O 線 程 池(sub reactor 線 程 池)的某個I/O線程上, 由它負責SocketChannel 的讀寫和編解碼工作。Acceptor 線程池僅僅用於客戶端的登錄、握手和安全認證,一旦鏈路建立成功,就將鏈路註冊到後端 subReactor 線程池的 I/O 線程上,由 I/O 線程負責後續的 I/O 操作。

    netty線程模型思考

    netty 的線程模型並不是一成不變的,它實際取決於用戶的啟動參數配置。通過設置不同的啟動參數,Netty 可以同時支持 Reactor 單線程模型、多線程模型。

    為了盡可能地提升性能,Netty 在很多地方進行了無鎖化的設計,例如在 I/O 線程內部進行串行操作,避免多線程競爭導致的性能下降問題。表面上看,串行化設計似乎 CPU 利用率不高,併發程度不夠。但是,通過調整 NIO 線程池的線程參數,可以同時啟動多個串行化的線程并行運行,這種局部無鎖化的串行線程設計相比一個隊列多個工作線程的模型性能更優。(小夥伴們後續多線程併發流程可參考該類實現方案)

    Netty 的 NioEventLoop 讀取到消息之後,直接調用 ChannelPipeline 的fireChannelRead (Object msg)。 只要用戶不主動切換線程, 一直都是由NioEventLoop 調用用戶的 ChannelHandler,期間不進行線程切換。這種串行化處理方式避免了多線程操作導致的鎖的競爭,從性能角度看是最優的。

    Netty擁有兩個NIO線程池,分別是bossGroup和workerGroup,前者處理新建連接請求,然後將新建立的連接輪詢交給workerGroup中的其中一個NioEventLoop來處理,後續該連接上的讀寫操作都是由同一個NioEventLoop來處理。注意,雖然bossGroup也能指定多個NioEventLoop(一個NioEventLoop對應一個線程),但是默認情況下只會有一個線程,因為一般情況下應用程序只會使用一個對外監聽端口。

    這裏試想一下,難道不能使用多線程來監聽同一個對外端口么,即多線程epoll_wait到同一個epoll實例上?

    epoll相關的主要兩個方法是epoll_wait和epoll_ctl,多線程同時操作同一個epoll實例,那麼首先需要確認epoll相關方法是否線程安全:簡單來說,epoll是通過鎖來保證線程安全的, epoll中粒度最小的自旋鎖ep->lock(spinlock)用來保護就緒的隊列, 互斥鎖ep->mtx用來保護epoll的重要數據結構紅黑樹。

    看到這裏,可能有的小夥伴想到了Nginx多進程針對監聽端口的處理策略,Nginx是通過accept_mutex機制來保證的。accept_mutex是nginx的(新建連接)負載均衡鎖,讓多個worker進程輪流處理與client的新連接。當某個worker進程的連接數達到worker_connections配置(單個worker進程的最大處理連接數)的最大連接數的7/8時,會大大減小獲取該worker獲取accept鎖的概率,以此實現各worker進程間的連接數的負載均衡。accept鎖默認打開,關閉它時nginx處理新建連接耗時會更短,但是worker進程之間可能連接不均衡,並且存在“驚群”問題。只有在使能accept_mutex並且當前系統不支持原子鎖時,才會用文件實現accept鎖。注意,accept_mutex加鎖失敗時不會阻塞當前線程,類似tryLock。

    現代linux中,多個socker同時監聽同一個端口也是可行的,nginx 1.9.1也支持這一行為。linux 3.9以上內核支持SO_REUSEPORT選項,允許多個socker bind/listen在同一端口上。這樣,多個進程可以各自申請socker監聽同一端口,當連接事件來臨時,內核做負載均衡,喚醒監聽的其中一個進程來處理,reuseport機制有效的解決了epoll驚群問題。

    再回到剛才提出的問題,java中多線程來監聽同一個對外端口,epoll方法是線程安全的,這樣就可以使用使用多線程監聽epoll_wait了么,當然是不建議這樣乾的,除了epoll的驚群問題之外,還有一個就是,一般開發中我們使用epoll設置的是LT模式(水平觸發方式,與之相對的是ET默認,前者只要連接事件未被處理就會在epoll_wait時始終觸發,後者只會在真正有事件來時在epoll_wait觸發一次),這樣的話,多線程epoll_wait時就會導致第一個線程epoll_wait之後還未處理完畢已發生的事件時,第二個線程也會epoll_wait返回,顯然這不是我們想要的,關於java nio的測試demo如下:

    public class NioDemo {
        private static AtomicBoolean flag = new AtomicBoolean(true);
        public static void main(String[] args) throws Exception {
            ServerSocketChannel serverChannel = ServerSocketChannel.open();
            serverChannel.socket().bind(new InetSocketAddress(8080));
            // non-block io
            serverChannel.configureBlocking(false);
            Selector selector = Selector.open();
            serverChannel.register(selector, SelectionKey.OP_ACCEPT);
    
            // 多線程執行
            Runnable task = () -> {
                try {
                    while (true) {
                        if (selector.select(0) == 0) {
                            System.out.println("selector.select loop... " + Thread.currentThread().getName());
                            Thread.sleep(1);
                            continue;
                        }
    
                        if (flag.compareAndSet(true, false)) {
                            System.out.println(Thread.currentThread().getName() + " over");
                            return;
                        }
    
                        Iterator<SelectionKey> iter = selector.selectedKeys().iterator();
                        while (iter.hasNext()) {
                            SelectionKey key = iter.next();
    
                            // accept event
                            if (key.isAcceptable()) {
                                handlerAccept(selector, key);
                            }
    
                            // socket event
                            if (key.isReadable()) {
                                handlerRead(key);
                            }
    
                            /**
                             * Selector不會自己從已選擇鍵集中移除SelectionKey實例,必須在處理完通道時手動移除。
                             * 下次該通道變成就緒時,Selector會再次將其放入已選擇鍵集中。
                             */
                            iter.remove();
                        }
                    }
                } catch (Exception e) {
                    e.printStackTrace();
                }
            };
    
            List<Thread> threadList = new ArrayList<>();
            for (int i = 0; i < 2; i++) {
                Thread thread = new Thread(task);
                threadList.add(thread);
                thread.start();
            }
            for (Thread thread : threadList) {
                thread.join();
            }
            System.out.println("main end");
        }
    
        static void handlerAccept(Selector selector, SelectionKey key) throws Exception {
            System.out.println("coming a new client... " + Thread.currentThread().getName());
            Thread.sleep(10000);
            SocketChannel channel = ((ServerSocketChannel) key.channel()).accept();
            channel.configureBlocking(false);
            channel.register(selector, SelectionKey.OP_READ, ByteBuffer.allocate(1024));
        }
    
        static void handlerRead(SelectionKey key) throws Exception {
            SocketChannel channel = (SocketChannel) key.channel();
            ByteBuffer buffer = (ByteBuffer) key.attachment();
            buffer.clear();
    
            int num = channel.read(buffer);
            if (num <= 0) {
                // error or fin
                System.out.println("close " + channel.getRemoteAddress());
                channel.close();
            } else {
                buffer.flip();
                String recv = Charset.forName("UTF-8").newDecoder().decode(buffer).toString();
                System.out.println("recv: " + recv);
    
                buffer = ByteBuffer.wrap(("server: " + recv).getBytes());
                channel.write(buffer);
            }
        }
    }

    netty線程模型實踐

    (1) 時間可控的簡單業務直接在 I/O 線程上處理

    時間可控的簡單業務直接在 I/O 線程上處理,如果業務非常簡單,執行時間非常短,不需要與外部網絡交互、訪問數據庫和磁盤,不需要等待其它資源,則建議直接在業務 ChannelHandler 中執行,不需要再啟業務的線程或者線程池。避免線程上下文切換,也不存在線程併發問題。

    (2) 複雜和時間不可控業務建議投遞到後端業務線程池統一處理

    複雜度較高或者時間不可控業務建議投遞到後端業務線程池統一處理,對於此類業務,不建議直接在業務 ChannelHandler 中啟動線程或者線程池處理,建議將不同的業務統一封裝成 Task,統一投遞到後端的業務線程池中進行處理。過多的業務ChannelHandler 會帶來開發效率和可維護性問題,不要把 Netty 當作業務容器,對於大多數複雜的業務產品,仍然需要集成或者開發自己的業務容器,做好和Netty 的架構分層。

    (3) 業務線程避免直接操作 ChannelHandler

    業務線程避免直接操作 ChannelHandler,對於 ChannelHandler,IO 線程和業務線程都可能會操作,因為業務通常是多線程模型,這樣就會存在多線程操作ChannelHandler。為了盡量避免多線程併發問題,建議按照 Netty 自身的做法,通過將操作封裝成獨立的 Task 由 NioEventLoop 統一執行,而不是業務線程直接操作,相關代碼如下所示:

    如果你確認併發訪問的數據或者併發操作是安全的,則無需多此一舉,這個需要根據具體的業務場景進行判斷,靈活處理。

    推薦閱讀

    歡迎小夥伴關注【TopCoder】閱讀更多精彩好文。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

    ※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!
    ※帶您來看台北網站建置,台北網頁設計,各種案例分享

  • 前端Leader你應該知道的NPM包管理機制

    前端Leader你應該知道的NPM包管理機制

    npm install 命令

    首先總結下npm 安裝一個模塊包的常用命令。

    /* 模塊依賴會寫入 dependencies 節點 */
    
    npm install moduleName
    
    npm install -save moduleName
    
    npm install -S moduleName 
    
    /* 模塊依賴會寫入 devDependencies 節點 */
    
    npm install -save-dev moduleName
    
    npm install -D moduleName
    
    /* 全局安裝模塊包 */
    
    npm install -g moduleName
    
    /* 安裝特定版本的包 */
    
    npm install 包名@版本號
    
    /* 通過地址安裝git倉庫 */
    
    npm install git+https://github.com/itwmike/axios.git
    
    npm install git+ssh://git@github.com:itwmike/axios.git
     
    /* 安裝特定分支或Tag的git倉庫 */
    
    npm install git+https://github.com/itwmike/axios.git#tag
    
    /* 通過用戶名安裝git倉庫 */ 
    
    npm install github:帳號/倉庫名 # npm install github:itwmike/axios
    
    npm install github:帳號/倉庫名


    npm 依賴包版本號

    npm 所有node包都使用語義化版本號,規則要求如下:  

    • 每個版本號都形如1.2.3,由三個部分組成,依次叫做“主版本號(major)”、“次版本號(minor)”和“修訂號(patch)” 。

    • 當新版本無法兼容基於前一版本的代碼時,則提高主版本號 。

    • 當新版本新增了功能與特性,但仍兼容前一版本的代碼時,則提高次版本號 。

    • 當新版本僅僅修正漏洞或者增強效率,仍然兼容前一版本代碼,則提高修訂號。

    默認使用 npm install -save 下載的都是最新版本,同時會在package.json 文件中登記一個最優版本號,如下形式:

    "dependencies": {
      "axios": "^0.19.0"
    },


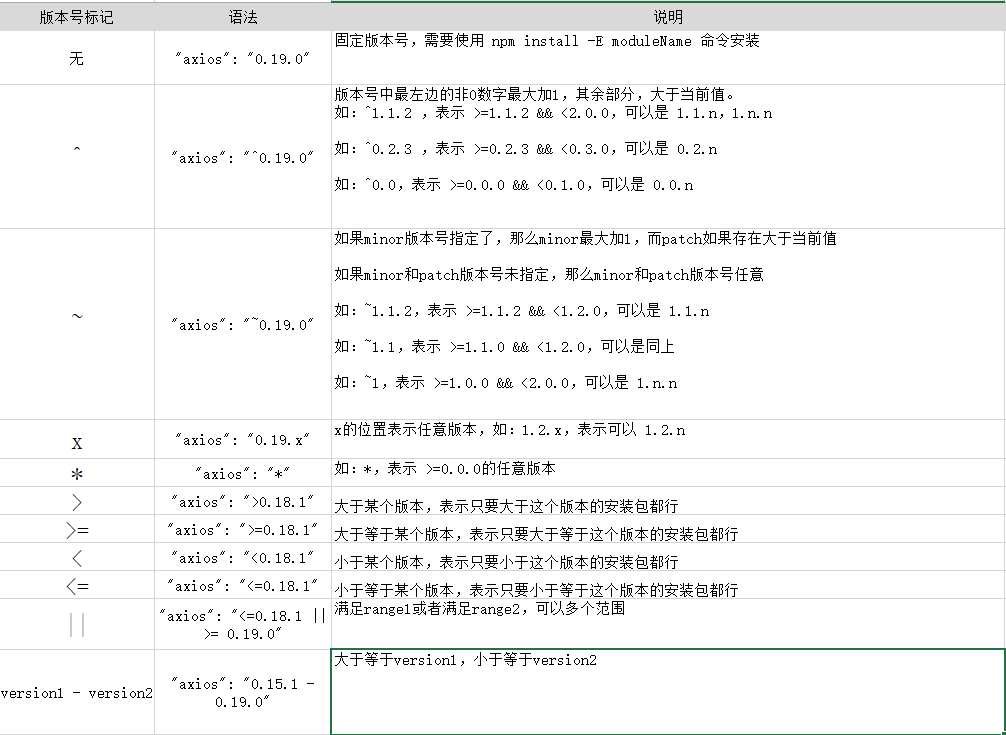
    最優版本號前面會多出一個“標記”,這個標記有啥意義?它的寫法又有哪些?


    npm install 都做了哪些事?

    拿到一個node項目時首要做法是運行 npm install 命令,這個命令將 package.json 文件中的依賴包自動解析並安裝,這也是項目能夠本地運行的前置條件。那如此簡單的一條命令,npm 背後又做了哪些不為人知的事呢?

    Number One

    自 npm 5.0后,項目中如果沒有 package-lock.json 文件的時候,npm 會自動幫我們生成。該文件的主要作用是記錄依賴包之間的具體版本號,對包版本有一個鎖定的意義,項目開發中應該將此文件上傳到git等版本控制工具(博主為此經歷了血淋淋的慘痛教育)。

    Number Two

    檢測本地包是否已經下載。如果本地 node_modules 下已經存在和 package-lock.json 中版本一致的包,則不會重新下載。

    Number Three

    下載依賴節點中對應的模板包。下載規則是:如果 package-lock.json 文件存在,則按照該文件中記錄的版本號下載對應的模塊包;如果文件不存在或文件中沒有該包的記錄,此時會按照版本號的標記(上面已講)規範下載並同時更新到 package-lock.json。

    了解了 package-lock.json 的作用后,筆者有個疑問:手動修改 package.json 中的包版本號后運行 npm install 命令會下載新包么?

    帶着這個疑問,筆者做了實驗,得出如下結論:

    • 如果新舊版本號差距較大,比如從 ^2.5.2 變為 2.6.0 ,那麼會下載最新包並且更新 package-lock.json 。

    • 如果新舊版本號差距較小,比如從 ^2.5.2 變為 2.5.4,那麼不會更新。

    總之是否更新要看特定情況,取決於 package.json中版本號的標記和 package-lock.json 是否一致。

    cnpm install 探索

    cnpm 是淘寶 npm 鏡像,在國內很受歡迎,雖然筆者並不喜歡使用。那 cnpm 和 npm 對包的管理是否一樣呢?

    • cnpm install 並不會生成 package-lock.json

    • cnpm install 並不受 package-lock.json 的約束,它會按照版本號標記規則下載依賴包


    由此可見,我們在項目中使用 cnpm 的時候一定要慎重,因為很可能團隊成員每個人使用的依賴包版本都不相同,造成打包后的結果也不同。

    如果團隊要使用 cnpm,請使用固定版本號的方式安裝依賴包如:cnpm install -E moduleName


    本文轉載自:

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦更多不同的設計風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

    ※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

    ※南投搬家前需注意的眉眉角角,別等搬了再說!

  • 微信作弊,為3款小遊戲引擎開掛增速,將給小遊戲帶來怎樣的利好?

    微信作弊,為3款小遊戲引擎開掛增速,將給小遊戲帶來怎樣的利好?

    11月14日小遊戲開發圈子,有一條重磅新聞:“微信小遊戲聯合遊戲引擎廠商,推出引擎插件功能,可為小遊戲提升0.5~2秒的啟動時間”。

    引擎插件是個什麼東西?

    昨天有不少人在問曉衡:“引擎插件到底是個什麼東西?”、“又要讓我學習新東西嗎?”、“引擎插件是怎麼加速的,不太明白?” …

    曉衡也在第一時間,將文檔通讀了一遍,並用自己的小遊戲工程做了測試,對微信小遊戲引擎插件算是有了一個簡單的認識,看下圖:

    普通模式,每一個使用遊戲引擎開發的小遊戲,都需要下載遊戲引擎代碼模塊。

    引擎插件模式,僅第一個遊戲需要下載引擎代碼,其它使用同類引擎的遊戲,可共享之前 A 遊戲下載過的遊戲引擎代碼,從而加速遊戲的啟動時間。

    從事小遊戲開發和運營的夥伴應該都很了解,H5、小遊戲注重啟動加載速度,它對新用戶的體驗和流失都至關重要。

    啟動概況分析

    估計有人會覺得引擎插件就加快了0.5~2秒有什麼用?眨個眼的時間而已。

    其實對使用 Cocos Creator 開發的休閑類的小遊戲來說,目前的微信小遊戲啟動速度已經很不錯了,首包含引擎的話,iOS 在4 ~ 6秒啟動,Android 大多可以在6~8秒左右打開首屏,並不像微信吹噓的1秒啟動,估計只有 引擎和資源全放子包的遊戲可以做到!

    下面我將自己個人開發的一款微信小遊戲,在微信公測的前後两天做了一個數據統計,想窺視一下啟動性能對留存的影響,下圖是曉衡的遊戲在8月7日 ~ 8月9日時的活躍情況:

    遊戲是在8月7日的晚上10:00點打開的微信公測,微信平台在24小時內持續導入5184的用戶,當天遊戲啟動8121次。不過圖片上的數據比較尷尬,公測一過就沒幾個玩家了,但它不是我們要講的重點,我們是用這個時間節點、用戶數量,來看微信小遊戲的啟動性能表現。

    iOS啟動概況

    Android啟動概況

    從圖中看,8月7日這天 iOS 的總啟動時間比 Android 快 3.88 秒,Android 的用戶流失比 iOS 要多 12.55%,這裏重點也不是說 iOS 和 Android 系統那個好,而是看遊戲的啟動時間對首屏打開留存的影響。

    這是另一個朋友的遊戲《周車勞盾》在9月14日微信公測4800+用戶,遊戲啟動7000+次,下面是它在9月13~9月15日的啟動概況:

    《周車勞盾》的 iOS 首屏打開留存率由於用戶數太少,不太好與 Android 對比,並且朋友說當時遊戲沒有做分包優化。在9月14日公測當天,由於新用戶多,iOS、Android 的啟動速度都不快,在 10 秒左右。從中也可以看出微信小遊戲用戶,以及微信導量用戶,以 Android 屬性為主。

    啟動流失分析

    下圖是曉衡的遊戲在8月8日公測時的 Android 手機用戶流失分佈情況,統計一共有 893 名流失用戶:

    從前面的啟動概況看到,小遊戲啟動進入首屏是在8.38s,我們以9秒為分界線,將上圖分成左右兩部分:

    • 右邊標註綠色線框,是已經進入遊戲后流失的人數,這部分的優化需要美術和策劃同學的幫助。
    • 左邊紅色線框中的用戶,是在遊戲啟動過程中流失掉的共計679人佔76%,而且前4秒流失的最多共543占 60%,如果不計算已經打開首屏的更是高達80%,因此前幾秒它才是我們關心的重點。

    曉衡根據平常使用微信的習慣,模擬分析一下前8秒的用戶是大概會是什麼情況走失的,需要注意的一個前題是,這些用戶都是微信導量進入的,絕大多是手滑不小心點到廣告,並不是目標用戶。

    • 第1秒:1秒流失用戶,手滑的機率最大,似乎經過專業訓練,眼、腦、手的速度都非常的快,遊戲是什麼都沒看清就閃人了;
    • 第2秒:2秒流失用戶,與1秒戶大概差不多,只是動作稍慢而已,此時遊戲圖標已經進入視覺系統,但估計比較模糊,瞬間閃人;
    • 第3秒:3秒流失用戶,不僅遊戲圖標已經從視覺系統進入大腦,遊戲名字估計也是能看清楚,但是沒有任何感覺,同樣是條件反射,快速點擊關閉;
    • 第4秒:4秒流失用戶,已經是把遊戲圖標、名字已經完全進入大腦神經迴路,給他反饋的信號是沒有愛,甚至是反感,迅速閃人了。第4秒很關鍵,因為用戶已經有了思考!
    • 第5~6秒:5~6秒流失用戶,認真看完遊戲圖標、名字,以及加載進度,經過大腦綜合反饋,這個遊戲不值得等待,88了!
    • 第7~8秒:7~8秒流失用戶,估計是盯到了遊戲的加載進度,在100%或某個数字上停止下一瞬間,實在是不耐煩了,什麼個鬼遊戲,半天進不去,走了!

    以上分析是曉衡的個人YY,僅供參考,這裏要說的是前 3 秒流失的用戶大多是條件反射,很難轉化。當用戶將遊戲圖標、遊戲名稱看清了后,大腦產生了思考,再離開的這對我們來說還有機會爭取,讓他們早點看到遊戲首屏,已經花了這5、6秒了,體驗一下再走!

    提升遊戲0.5 ~ 2秒的啟動速度是非常具有價值的,而且小遊戲絕大多數又是 Android 用戶,特別是對需要買量的遊戲來說,時間就是金錢,毫秒必爭。

    引擎插件帶來的好處

    下面我們再來看看,引擎插件具體在那些場景下會帶來比較明顯的性能提供,盡可能充分利用這個機制呢?

    微信公測

    對於個人開發者,使用微信公測功能免費送5000流量,一定要利用好這個機會。將首包資源做到盡量小巧,引擎裁剪、圖片壓縮一定要做足,同時盡量選擇使用量較多的引擎版本號(目前曉衡了解到的,使用較多 Cocos Creator 引擎版本號分佈在:2.0.8 ~ 2.0.10、2.1.3、2.2.0,不過還是要以微信或 Cocos 官方統計為準),這樣容易蹭上已經下載過的遊戲引擎,這對大多數遊戲來說都是適用的。

    中重度遊戲

    中重度遊戲,通常會依賴較多的引擎模塊,比如 RPG 遊戲中的:地圖、角色動畫,會使用TileMap、Spine、DragonBones、Animation 等模塊,還有一些遊戲會使用到物理引擎模塊、碰撞模塊等,完整引擎模塊高達 1.6M。

    隨着微信引擎插件的廣泛普及,以後構建遊戲完全時可以將引擎裁剪到最精簡狀態,大概在550K左右。甚至可以想像到,以後小遊戲平台完全不用上傳引擎代碼,構建時只用配置上使用的什麼引擎,引擎版本號即可。

    中重度遊戲利用引擎插件同樣可以快速進入首屏,首包僅保留炫麗的動效和初始界面,用分治的方式動態下載遊戲當前必要的內容,儘快讓用戶參与到遊戲中去。還有隨着 5G 的到來,中重度遊戲的遊戲資源下載劣勢也會得到改善,對小遊戲更是一件好事。

    遊戲矩陣

    單款小遊戲一般是很難有收益的,甚至是虧本買賣。微信平台,一個小遊戲可以支持10個遊戲的跳轉,目前絕大多數遊戲商廠,都會在小遊戲中集成其它遊戲的入口加大流量,優質的遊戲還會出售遊戲跳轉坑位,有的還價格不菲。個人開發者也意識到了遊戲間跳轉帶來的爆光機會,不少開發者會在微信公眾時,組織邀請好友建立鏈接。

    如果是自家開發的休閑小遊戲,利用引擎插件的啟動增速,再配合上自定義的啟動背景(頭條支持),讓玩家感受不出是在不同遊戲中切換,在矩陣中瞬間穿梭,這也將極大增加遊戲的曝光率,降低流失。

    小結

    劉潤老師說的好:“一切的商業價值,要看是否讓用戶獲益”。

    微信引擎插件不僅讓普通用戶能獲得更好的遊戲體驗,也能讓遊戲開發商能中從獲益。點開即玩的小遊戲,縮短了遊戲產品呈現在用戶手中的時間,極大優化了產品的傳遞價值。

    曉衡是一個搬運工,傳遞有價值的遊戲開發技術,如果覺得本文對你有用,感謝來看個再看或傳遞給朋友。感謝您的閱讀,願我們在前進的道路上“砥礪前行,共同成長!”

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

    ※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

    ※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!