月份: 2020 年 8 月

  • 微服務中如何設計一個權限授權服務

    微服務中如何設計一個權限授權服務

    基於角色的訪問控制  (RBAC) 

      是將系統訪問限製為授權用戶的一種方法,是圍繞角色和特權定義的與策略無關的訪問控制機制,RBAC的組件使執行用戶分配變得很簡單。

      在組織內部,將為各種職務創建角色。執行某些操作的權限已分配給特定角色。成員或職員(或其他系統用戶)被分配了特定角色,並且通過這些角色分配獲得執行特定系統功能所需的權限。由於未直接為用戶分配權限,而是僅通過其角色(一個或多個角色)獲取權限,因此,對單個用戶權限的管理就變成了簡單地為用戶帳戶分配適當角色的問題。這簡化了常見操作,例如添加用戶或更改用戶部門。

    RBAC定義了三個主要規則

      1、角色分配:僅當對象已選擇或分配了角色時,對象才能行使權限。

      2、角色授權:必須為主體授權主體的活動角色。使用上面的規則1,此規則可確保用戶只能承擔獲得其授權的角色。

      3、權限授權:僅當對象的活動角色被授權時,對象才能行使權限。使用規則1和2,此規則可確保用戶只能行使其被授權的權限。

    創建RBAC的模型

    菜單 

      public class SysMenu
        {
            /// <summary>
            ///     父級
            /// </summary>
            public int ParentId { get; set; } = 0;
    
            /// <summary>
            ///     菜單名稱
            /// </summary>
            [StringLength(20)]
            public string Name { get; set; }
    
            /// <summary>
            ///     菜單地址
            /// </summary>
            [StringLength(20)]
            [Required]
            public string Url { get; set; }
    
            /// <summary>
            ///     層級
            /// </summary>
            [Column(TypeName = "tinyint(4)")]
            public int Level { get; set; } = 1;
    
            /// <summary>
            ///     菜單權限(list<int /> json)
            /// </summary>
            [StringLength(100)]
            public string Operates { get; set; }
    
            /// <summary>
            ///     排序
            /// </summary>
            public int Sort { get; set; }
    
            /// <summary>
            /// 菜單圖標
            /// </summary>
            public string Icon { get; set; }        
        }

     功能

      public class SysOperate
        {
            /// <summary>
            ///     按鈕名稱
            /// </summary>
            [StringLength(20)]
            [Required]
            public string Name { get; set; }
    
            /// <summary>
            ///     備註
            /// </summary>
            [StringLength(int.MaxValue)]
            public string Remark { get; set; }
    
            /// <summary>
            /// 唯一標識
            /// </summary>
            [Required]
            public int Unique { get; set; }
        }

    角色

      public class SysRole 
        {
            /// <summary>
            ///     角色名稱
            /// </summary>
            [StringLength(20)]
            [Required]
            public string Name { get; set; }
    
            /// <summary>
            ///     備註
            /// </summary>
            [StringLength(int.MaxValue)]
            public string Remark { get; set; }
        }

    用戶

        public class SysUser
        {
            /// <summary>
            ///     角色id
            /// </summary>
            public int RoleId { get; set; }
    
            /// <summary>
            ///     用戶名
            /// </summary>
            [StringLength(32)]
            [Required]
            public string UserName { get; set; }
    
            /// <summary>
            ///     密碼
            /// </summary>
            [StringLength(500)]
            [Required]
            public string Password { get; set; }
        }

     微服務中讓它成為一個授權權限服務

      在日常工作中,總會有很多系統要做,每個系統都要一套完整的權限功能,有現成的直接拿來粘貼複製,沒有現成的又要浪費很多時間去設計實現它。 如果有這樣一個服務,我們可以節省很多不必要的粘貼複製操作,節省很多時間。

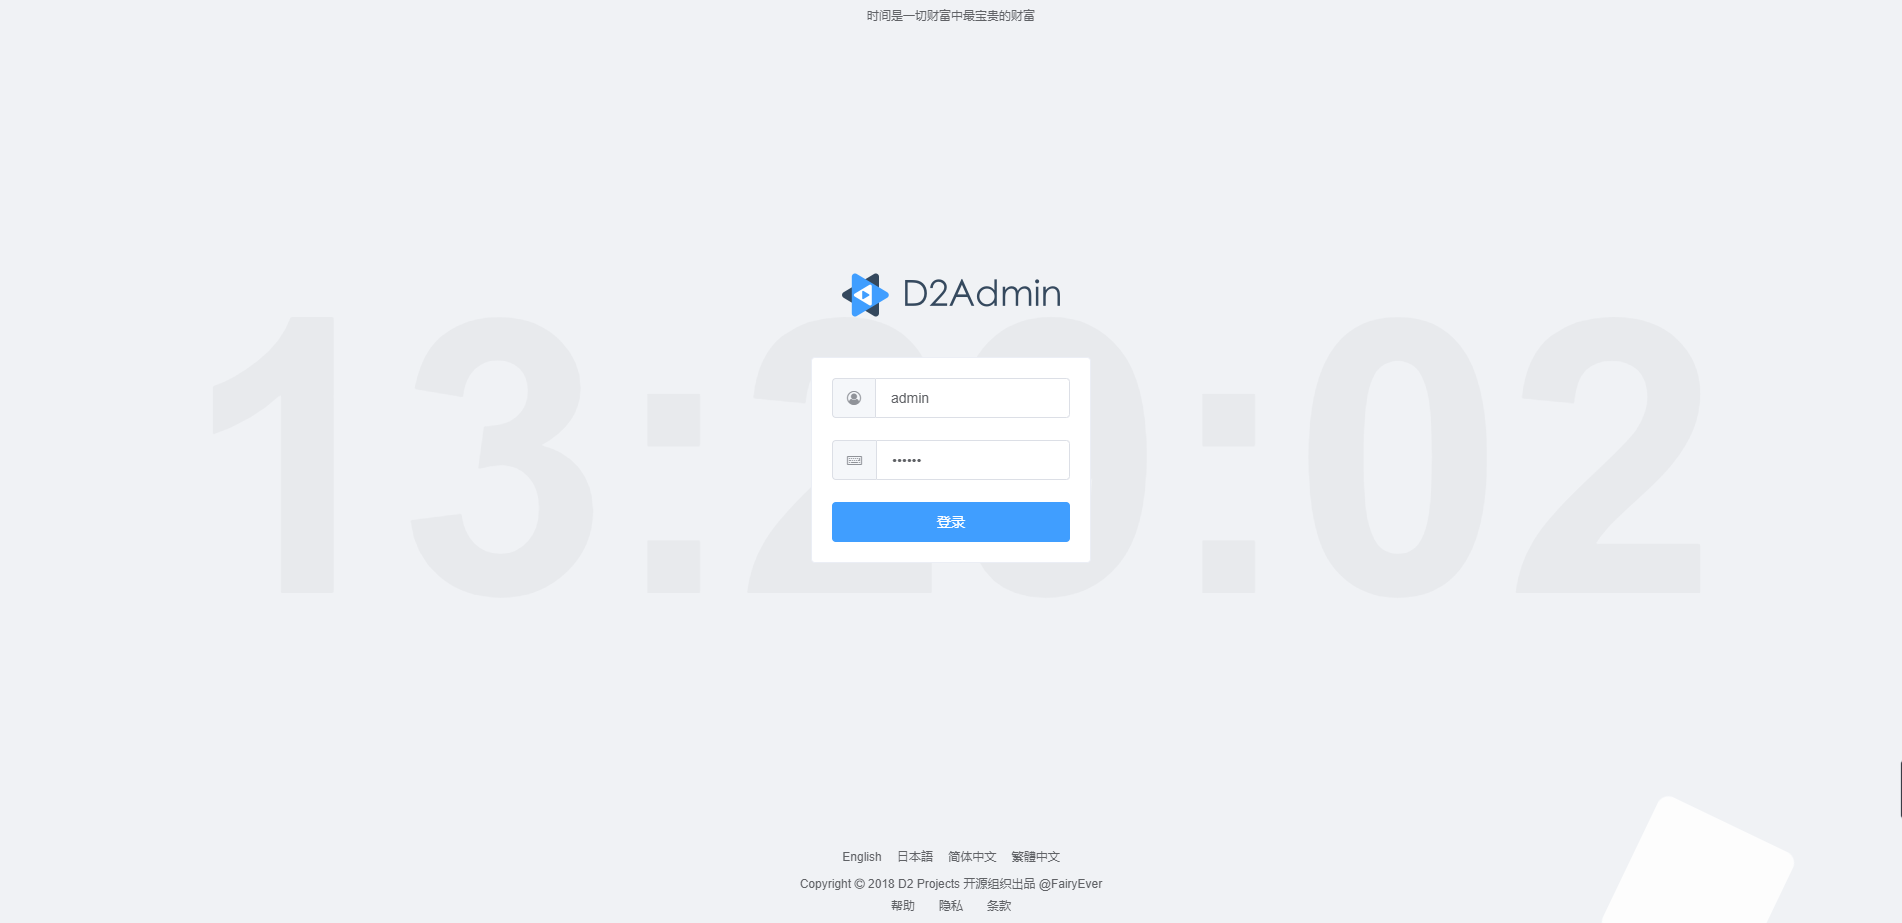
      於是 ketchup.zero 這樣一個服務就誕生了。它是基於ketchu微服務框架來實現的一個權限授權服務,基本可以滿足我們日常工作的的權限需求。

      服務的前端是基於vue的模板d2admin 開發的。

    ketchup.zero的功能

    登陸

    面板


     用戶配置角色


     菜單設置擁有那些權限


     權限/功能/按鈕 管理


     角色設置權限


    最後安利

    如果它對你有幫助,請給一波start

    服務 ketchup.zero 源碼地址:https://github.com/simple-gr/ketchup.zero

    微服務框架 ketchup 源碼地址:https://github.com/simple-gr/ketchup 

    ketchup 交流群:592407137


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • 前端業務代碼中的配置化

    前端業務代碼中的配置化

    業務代碼中的配置化

    工作中有許多邏輯冗雜、迭代頻繁的業務代碼,隨着迭代將越來越難以維護,一些場景適合通過配置化的方式來處理便於維護。

    一、什麼是業務代碼配置化?

    根據業務場景使用配置化的 Object|Array|Map 處理條件判斷邏輯,通常需要配置文件 CONFIG.js,若邏輯複雜需添加 getConfig 的處理函數 – tool.js

    • 本質上 if/else 邏輯是一種狀態匹配

    • 表驅動法,使用表數據,存儲對應的狀態處理

    • 可讀性好,減少了繁雜嵌套的 if-else,讀取配置,邏輯更清晰

    • 可維護性高,邏輯分支的增刪只是 CONFIG 的增刪

    二、如何在業務場景中進行代碼配置化?

    1. 簡單的狀態映射

    • 按需使用 Object|Map 配置
    單一條件
    • Object 形式:
    // CONFIG.JS
      export const STATUS = {
        STUDENT: 0,
        TEACHER: 1,
        MA_NONG: 2,
      };
      export const WORK_MAP = {
        STATUS.STUDENT: '學生',
        STATUS.TEACHER: '老師',
        STATUS.MA_NONG: '碼農',
      };
    
    // index.js
      this.setData({
        work: WORK_MAP[status],
      });
    
      axios.post(url, { status: STATUS.MA_NONG });
    
    • Map 形式:
    // CONFIG.JS
    export const WORK_MAP = new Map([
      [0, "學生"],
      [1, "老師"],
      [2, "碼農"],
    ]);
    // index.js
    this.setData({
      work: WORK_MAP.get(status),
    });
    
    多重條件
    const config = new Map([
      [
        (condition0, condition1, condition2) =>
          condition0 && condition1 && condition2,
        () => {
          console.log("map0");
        },
      ],
      [
        (condition0, condition1, condition2) =>
          condition0 || condition1 || condition2,
        () => {
          console.log("map1");
        },
      ],
    ]);
    config.forEach((action, _if) => _if(0, 1, 0) && action());
    

    2. 每個狀態有多種屬性

    • 多個屬性
    • 使用 Array 配置
    // CONFIG.JS
      export const CONFIG = [
        {
          status: STATUS.STUDENT,
          name: '學生',
          action: '談戀愛',
        },
        {
          status: STATUS.TEACHER,
          name: '老師',
          action: '教書',
        },
        {
          status: STATUS.MA_NONG,
          name: '碼農',
          action: '寫bug',
        },
      ];
    
    // index.js
      <!-- 根據狀態不同的行為 -->
      function action(status) {
        const { name, work } = CONFIG.find(i => i.status === status);
        console.log(`${name}在${action}`);
      }
    

    3. 每個狀態有多種屬性且參數定製化

    • 參數高度定製化,不同狀態需要適配接口不同的字段
    • 使用 Array 配置
    • 通過配置函數並傳參注入接口數據可滿足定製化需求
    // CONFIG.JS
      export const CONFIG = [
        {
          status: STATUS.STUDENT,
          name: '學生',
          action: () => {
            console.log('學生的工作是談戀愛');
          },
        },
        {
          status: STATUS.TEACHER,
          name: '老師',
          action: (info) => {
            alert(`老師${info.age}歲,每天${info.action}`);
          },
        },
        {
          status: STATUS.MA_NONG,
          name: '碼農',
          action: (info) => {
            toast(`碼農工作${info.workTime}年了,頭髮僅剩${info.hair}根了`);
          },
        },
      ];
    
    // index.js
      <!-- 根據接口狀態action -->
      function action(res) {
        const { action, info } = CONFIG.find(i => i.status === res.status);
        action && action(info); // 傳參定製化
      }
    

    三、實例

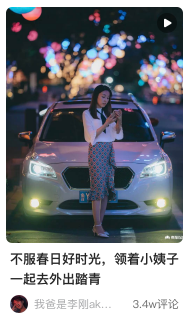
    大首頁瀑布流 item 樣式

    • 根據 list 接口下發的 item 的類型(type)&樣式(layout)字段取 item 中的封面、標題、標籤、頭像…,字段各不相同
    • 十幾種 item 類型,有的還有不同的 layout,item 數據下發方式不同
    • 公共組件,需要適配其他模塊的接口數據作展示

    index.xml

    • 數據驅動,減少模板中的判斷邏輯
    <view class="panel" bind:tap="goDetail">
      <!-- 封面 -->
      <image  wx:if="{{panel.cover}}" class="panel__cover" src="{{panel.cover.image}}">
          <view class="panel__tag {{panel.tagClass}}" wx:if="{{panel.tagClass}}">{{panel.tag}}</view>
      </image>
      <!-- 標題 -->
      <view class="panel__titl" wx:if="{{panel.title}}">{{panel.title}}</view>
      <!-- footer -->
      <view class="panel__footer" wx:if="{{panel.showFooter}}">
        <image class="panel__footer-icon" wx:if="{{panel.user.icon}}" src="{{panel.user.icon}}"></image>
        <text class="panel__footer-name" wx:if="{{panel.user.nickname}}">{{panel.user.nickname}}</text>
        <text class="panel__footer-comment" wx:if="{{panel.commentCount}}">{{panel.commentCount}}評論</text>
      </view>
    </view>
    

    CONFIG.js

    import { Layout, NewsType, Redirect } from 'src/constant';
    import { formatImage, formatUser } from './tool';
    
    /**
     * 配置項
     * @param {String} title 標題
     * @param {String} cover 封面
     * @param {String} tag 標籤
     * @param {Object} user 用戶信息
     * @param {Boolean} showFooter 是否显示footer
     * @param {Boolean} isAd 是否廣告
     * @param {Function} itemWrap 兼容接口數據函數,數據可能以ref_xxx下發,比如帖子:ref_post
     * ......
     */
    
    <!-- 默認配置項 -->
    export const DEFAULT = {
      title: ({ title = '' }) => title,
      cover: ({ image_list = [], article_images = [] }) =>
        formatImage(image_list[0]) || formatImage(article_images[0]),
      showFooter: true,
      user: ({ user, user_account, article_source_tx = '' }) =>
        user
          ? formatUser(user)
          : user_account
          ? formatUser(user_account)
          : {
              icon: '',
              nickname: article_source_tx,
            },
    };
    
    export const CONFIG = [
      {
        type: NewsType.NEWS,
        ...DEFAULT,
        tag: '資訊',
        tagClass: 'news',
      },
      {
        type: NewsType.VIDEO,
        ...DEFAULT,
        tag: '',
        tagClass: 'video',
        cover: ({ image_gif_list = [], image_list = [] }) => formatImage(image_gif_list[0] || image_list[0]),
        video: ({ video_url = '', tencent_vid = '', image_gif_list = [] }) => ({
          hasVideo: true,
          src: tencent_vid || video_url,
          video_url,
          tencent_vid,
          gifCover: formatImage(image_gif_list[0]),
        }),
      },
      {
        type: Redirect.EVAL_DETAIL,
        layouts: [
          {
            layout: Layout.EVALUATION,
            ...DEFAULT,
            tag: '口碑',
            tagClass: 'praise',
          },
          {
            layout: Layout.PRAISE_COMPONENT,
            ...DEFAULT,
            tag: '口碑',
            tagClass: 'praise',
            itemWrap: ({ ref_car_score = {} }) => ref_car_score,
            title: ({ chosen_topic = '' }) => chosen_topic,
            commentCount: ({ comment_count = null }) => comment_count,
            cover: ({ images = [], recommend_images = [] }) =>
              formatImage(images[0]) ||
              formatImage(getCoverFromRecommendImages(recommend_images)),
          },
          {
            layout: Layout.NORMAL,
            ...DEFAULT,
          },
        ],
      },
      ......
    ];
    

    tool.js

    import { CONFIG, DEFAULT, AD_CONFIG } from "./CONFIG";
    // 獲取瀑布流item數據
    export const getPanelData = (item) => {
      const getConfigByTypeAndLayout = () => {
        let config = CONFIG.find((i) => i.type == item.type);
        if (item.isAd) {
          config = AD_CONFIG;
        }
        if (config && config.layouts) {
          config = config.layouts.find(
            (i) => i.layout === item.layout_type || i.layout === item.display_style
          );
        }
        if (!config) {
          config = DEFAULT;
          console.log("no-config", item.type, item.layout_type, item);
        }
        return config;
      };
      const getPanelDataByConfig = (c) => {
        const panel = {};
        let _item = item;
        if (c.itemWrap) {
          _item = c.itemWrap(item);
        }
        Object.keys(c).forEach((key) => {
          if (typeof c[key] === "function") {
            panel[key] = c[key](_item);
          } else {
            panel[key] = c[key];
          }
        });
        return panel;
      };
      // 根據item的類型、樣式獲取配置
      const config = getConfigByTypeAndLayout(item);
      // 根據配置獲取瀑布流item信息
      return getPanelDataByConfig(config);
    };
    

    四、結語

    所以,業務代碼配置化很簡單,大家也都一直在用,只是如果在一些業務場景中都形成配置化的習慣或者共識,可能更好維護吧。

    鄙人拙見,大佬賜教~

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※別再煩惱如何寫文案,掌握八大原則!

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※超省錢租車方案

    ※教你寫出一流的銷售文案?

  • 在採用K8S之前您必須了解的5件事情

    在採用K8S之前您必須了解的5件事情

    作者簡介

    Christopher Tozzi,自2008年來以自由職業者的身份對Linux、虛擬化、容器、數據存儲及其相關主題進行報道。

    時至今日,Kubernetes已然成為風靡一時的容器編排調度工具,許多IT分析師均提出了企業應當在何時採用Kubernetes的深刻建議。然而,和所有其他的軟件平台一樣,Kubernetes並非是一個適用於所有人的靈丹妙藥。我更傾向於認為人們在有些時候過分誇大了Kubernetes的作用,以至於他們產生了一種錯覺:他們無法離開Kubernetes,而實際上,Kubernetes比他們真正的需求要複雜得多。

    為了分析人們真正的需求與Kubernetes的匹配程度,我分析了企業在採用Kubernetes編排之前必須考慮的5個事情。

    Kubernetes是什麼?

    如果您關注容器,您可能會知道Kubernetes是一個用於容器編排的開源工具,它可以自動執行諸如啟動容器、停止容器以及在同一個容器的不同實例之間的負載均衡等重要任務。

    簡而言之,Kubernetes的主要目的是最大限度地減少工程師必須手動執行的管理工作量,並通過簡化容器操作,幫助企業大規模運行複雜的容器化應用程序。

    決定是否採用Kubernetes的關鍵要素

    基於Kubernetes的設立初衷,如果您喜歡自動化,討厭手動執行重複性的任務,那麼Kubernetes無疑是您的極佳選擇。

    這是您決定是否採用Kubernetes的重要前提,但是,您不能僅根據這一“前提”就決定是否採用Kubernetes。在採用Kubernetes之前,您還需要考慮並權衡其他重要的因素。

    1、Kubernetes的基礎設施規模

    您的基礎設施規模是其中一個決定Kubernetes是否能夠很好地為您所用的關鍵要素。

    Kubernetes的設計初衷是協調分佈在真正龐大的環境中的容器,這往往意味着企業應當擁有數十台主機服務器。根據過往的實施經驗,如果基礎架構中的服務器少於50個,那麼您可能沒有足夠的資源來利用Kubernetes的全部優勢。

    這並不是指Kubernetes無法在較小規模的基礎設施上運行。實際上,如果您願意,您可以在單個主機上運行Kubernetes。然而,由於Kubernetes其中的一個研發目的是:通過在數量龐大的集群中分佈容器化應用程序提供高可用性,因此,如果您只有少量服務器,則無法享受到Kubernetes的某些價值。

    除此之外,考慮到設置和維護Kubernetes的複雜性,如果您的基礎設施規模較小,無法完全實現Kubernetes的高可用性承諾,那麼或許您不應投入過多時間和精力在Kubernetes上。

    對於較小的基礎架構,您可以使用較為簡單的容器編排工具,或者使用如AWS ECS等具有內置編排的基於雲的容器服務。

    2、Kubernetes操作系統環境

    Kubernetes主要是一種Linux技術。儘管Kubernetes可以用於管理託管Windows服務器上的容器化應用程序,這些應用程序作為Kubernetes服務器集群內的所謂工作節點運行。但託管Kubernetes核心服務的主要服務器或者說主節點必須是Linux。

    因此,如果您的商店以Windows為中心,那麼Kubernetes並非您的最佳選擇。但是您可以選擇Rancher輕鬆將Kubernetes的優勢引入Windows,並且極大程度降低使用的複雜性。

    3、安裝和設置Kubernetes

    在決定採用Kubernetes之前,您還需要評估您可以在此項目上投入的工作時間。

    普通的開放源代碼版本的Kubernetes缺少內置的應用程序,也並未提供一種可以適用於所有默認配置的安裝方式。在集群正常運行之前,您需要投入大量的時間從頭開始編寫及調整配置文件。因此,安裝和配置Kubernetes的過程或許是一個令人生畏的過程,您需要投入大量的時間和精力。

    部分Kubernetes發行版提供了交互式安裝程序腳本,可以幫助您自動執行大部分設置過程。如果您選擇Rancher等Kubernetes發行版,則有望在一两天內輕鬆完成配置及安裝。

    第三種選擇是使用諸如Google Kubernetes Engine等雲供應商解決方案,將Kubernetes作為託管服務在雲上運行。在這種情況下,您可以自行選擇安裝及設置。但值得注意的一點是,在確定如何配置Kubernetes環境時,您的選擇可能會受到限制。

    您必須意識到最為關鍵的一點:不要低估配置Kubernetes的難度。在您真的要全身心投入Kubernetes之前,請確保您所付出的努力是值得的。另一方面,如果您無法確定為企業在生產集群上安裝和部署Kubernetes的難度,您可以嘗試使用K3s等輕量級Kubernetes發行版來進行測試,預估後續需要付出多少努力來進行Kubernetes的配置和設置。

    4、Kubernetes和聲明式配置管理

    Kubernetes採用了所謂的聲明式配置管理方法,這就意味着,您需要自行編寫配置文件來設置Kubernetes應用程序應當如何運行,而Kubernetes將自動指出如何使應用程序符合規範。

    聲明式配置管理與命令式配置管理相反,在命令式配置管理中,您可以自行配置應用程序的每個組件,並讓其按照您所想要的方式運行。

    聲明式配置是Kubernetes在許多用戶實例中如此強大和可伸縮的其中一個原因。您可以設置一次配置,並且根據需要多次應用它。

    但是,如果您的配置需求不斷變化,或者在工作負載或環境中的不同部分之間變化,那麼您應當如何處理呢?在這種情況下,聲明式配置管理將成為一個障礙,您將發現自己需要不斷地調整先前認為是“一勞永逸”的配置文件。

    因此,在您選擇採用Kubernetes之前,您需要考慮應用程序的配置需求。只有當您所需要的配置相對通用且靜態時,Kubernetes才是一個不錯的選項。

    5、Kubernetes和多雲

    Rancher等部分Kubernetes發行版的主要功能之一,是單個Kubernetes部署可以編排多個集群,無論集群位於在不同的公有雲還是私有雲上。這一功能使Kubernetes成為協助控制多雲架構複雜性的優秀工具。

    在跨多雲部署容器化應用程序,並且Kubernetes的設置和配置工作很合理時,多雲上的Kubernetes是十分有意義的。

    在這一因素中,您需要留意的是,在考慮是否以及何時採用Kubernetes時,應考慮您當前的多雲戰略以及多雲擴展計劃。

    結 語

    Kubernetes是一個非常棒的工具,在正確設置的情況下,它可以產生巨大的價值。但是,它並沒有達到殺手級應用程序的狀態,因為它無法在所有用戶實例中交付價值。在您被巨大的宣傳攻勢攻陷,並確定您無法離開Kubernetes之前,請清醒地對自己的需求進行評估,明確Kubernetes是否能在真正意義上幫助您更加有效、更加可靠地運行應用程序。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※教你寫出一流的銷售文案?

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※回頭車貨運收費標準

    ※別再煩惱如何寫文案,掌握八大原則!

    ※超省錢租車方案

  • Spring和Springboot相關知識點整理

    Spring和Springboot相關知識點整理

    簡介

    本文主要整理一些Spring & SpringBoot應用時和相關原理的知識點,對於源碼不做沒有深入的講解。

    1. 思維導圖

    右鍵新窗口打開可以放大。

    說明

    • 使用@Configuration在java代碼中聲明一個bean——而不是使用xml——實際上很早就有了(至少在《Spring實戰(第3版)》出版時,也就是Spring3.0時),我一直以為是SpringBoot的新特性。

    2. Spring

    2.1 AOP術語

    • 通知Advice —— 切面要做什麼,何時執行。何時,包括方法調用前、方法調用后、方法成功調用后、方法調用拋異常后、環繞(Around)。環繞允許提供一些需要跨越方法調用前後的功能,如計算調用耗時。
    • 連接點Joinpoint —— 應用執行時能插入切面的點。實際上是一個邏輯概念,不體現在配置中。
    • 切點Pointcut —— 執行通知的具體的連接點。
    • 切面Aspect —— 通知+切點
    • 引入Introduction —— 允許為類添加新的方法或屬性。(個人理解即應用使用切面中的方法和屬性,就好像這些方法和屬性是原生的一樣。可以參考<aop:declare-parents>元素)
    • 織入Weaving —— 將切面應用到目標對象創建新的代理對象的過程,Spring使用的是運行時。編譯期和類加載時是其他的方式。

    2.2 Bean的生命周期

    雖然被稱為生命周期,實際上指的是bean在初始化、回收期間調用了哪些方法。如果只看《Spring實戰》,可以看到類似下面的圖(圖源:參考文獻[3])

    具體哪一步做了什麼?其實這些方法都是可選的,自定義的bean可以實現,也可以不實現,實現里寫什麼似乎都沒問題,參考文獻[3]中的測試代碼展示了這些方法在bean生命周期中的執行順序。
    但是對於Spring框架的bean,就有必要的用途了。這裏沒有深入研究,有興趣可以自行讀源碼。

    2.3 Cglib和JdkProxy

    2.3.1 與Spring的關係

    這是Spring AOP的兩種實現方式。根據官方文檔:

    1. 默認使用JdkProxy
    2. 對於被代理對象沒有實現任何接口,使用Cglib
    3. 可以強制指定使用Cglib。
      這樣就可以解釋為什麼有的bean實現了接口,有的沒有,但是在同一個工程中可以並存了。

    2.3.2 示例代碼

    本節代碼改寫自參考文獻[5]。

    //用戶管理接口
    public interface UserManager {
        //新增用戶抽象方法
        void addUser(String userName,String password);
        //刪除用戶抽象方法
        void delUser(String userName);
    }
    
    //用戶管理實現類,實現用戶管理接口
    public class UserManagerImpl implements UserManager{
        @Override
        public void addUser(String userName) {
            System.out.println("調用了新增的方法!");
            System.out.println("傳入參數為 userName: "+userName+" password: "+password);
        }
        @Override
        public void delUser(String userName) {
            System.out.println("調用了刪除的方法!");
            System.out.println("傳入參數為 userName: "+userName);
        }   
    }
    
    import java.lang.reflect.InvocationHandler;
    import java.lang.reflect.Method;
    import java.lang.reflect.Proxy;
    
    import com.lf.shejimoshi.proxy.entity.UserManager;
    import com.lf.shejimoshi.proxy.entity.UserManagerImpl;
    //JDK動態代理實現InvocationHandler接口
    public class JdkProxy implements InvocationHandler {
        private Object target ;//需要代理的目標對象
        
        @Override
        public Object invoke(Object proxy, Method method, Object[] args) throws Throwable {
            System.out.println("JDK動態代理,監聽開始!");
            Object result = method.invoke(target, args);
            System.out.println("JDK動態代理,監聽結束!");
            return result;
        }
        //定義獲取代理對象方法
        // 因為只是在main()里測試,聲明為private了 
        private Object getJDKProxy(Object targetObject){
            this.target = targetObject;
            return Proxy.newProxyInstance(targetObject.getClass().getClassLoader(), targetObject.getClass().getInterfaces(), this);
        }
        
        public static void main(String[] args) {
            JdkProxy jdkProxy = new JdkProxy();
            UserManager user = (UserManager) jdkProxy.getJDKProxy(new UserManagerImpl());//獲取代理對象
            user.addUser("admin");
        }   
    }
    
    import java.lang.reflect.Method;
    
    import com.lf.shejimoshi.proxy.entity.UserManager;
    import com.lf.shejimoshi.proxy.entity.UserManagerImpl;
    
    import net.sf.cglib.proxy.Enhancer;
    import net.sf.cglib.proxy.MethodInterceptor;
    import net.sf.cglib.proxy.MethodProxy;
    
    //Cglib動態代理,實現MethodInterceptor接口
    public class CglibProxy implements MethodInterceptor {
        private Object target;//需要代理的目標對象
        
        //重寫攔截方法
        @Override
        public Object intercept(Object obj, Method method, Object[] arr, MethodProxy proxy) throws Throwable {
            System.out.println("Cglib動態代理,監聽開始!");
            Object invoke = method.invoke(target, arr);//方法執行,參數:target 目標對象 arr參數數組
            System.out.println("Cglib動態代理,監聽結束!");
            return invoke;
        }
        //定義獲取代理對象方法
        public Object getCglibProxy(Object objectTarget){
            //為目標對象target賦值
            this.target = objectTarget;
            Enhancer enhancer = new Enhancer();
            //設置父類,因為Cglib是針對指定的類生成一個子類,所以需要指定父類
            enhancer.setSuperclass(objectTarget.getClass());
            enhancer.setCallback(this);// 設置回調 
            Object result = enhancer.create();//創建並返回代理對象
            return result;
        }
        
        public static void main(String[] args) {
            CglibProxy cglib = new CglibProxy();
            UserManager user =  (UserManager) cglib.getCglibProxy(new UserManagerImpl());
            user.delUser("admin");
        }
        
    }
    

    2.3.3 比較

    比較一下兩者的區別,這也是常見的面試問題。

    JdkProxy Cglib
    依賴 被代理對象實現了接口(所有接口的方法數總和必須>0[4]) 引入asm、cglib jar ;不能是final類和方法
    原理 反射,實現被代理對象接口的匿名內部類,通過InvocationHandler.invoke()包圍被代理對象的方法 引入asm、cglib jar,代理類實現MethodInterceptor,通過底層重寫字節碼來實現
    效率 創建快,運行慢(見下方說明2) 創建慢,運行快

    說明

    1. Cglib是如何修改字節碼,從代碼上是看不出來的。使用的是ASM技術,修改class文件,可以自行查閱。
    2. JDK1.8及以後,JdkProxy的運行速度已經比Cglib快了(之前則是慢於Cglib),測試代碼可見參考文獻[6]。

    2.3.4 關於org.apoalliance.intercept.MethodInterceptor

    我讀了一下之前所用的日誌攔截器源碼,發現其實現的是這節標題的接口:

    class CommonInterceptor implements MethodInterceptor {
          @Override
          public Object invoke(MethodInvocation invocation) throws Throwable {
                try {
                       // 攔截器內部邏輯
                      result = invoication.proceed();
                catch(Throwable e) {
                      // 異常處理
                }
                return result;
          }
    }
    

    聲明代理鏈

    @Configuration
    public class InterceptorConfig {
    
          @Bean
          public CommonInterceptor serviceInterceptor() {
                CommonInterceptor bean = new CommonInterceptor();
                return bean;
          }
    
          // 代理名稱後綴為servie的實現類
          @Bean
          public BeanNameAutoProxyCreator servieBeanNameAutoProxyCreator() {
                BeanNameAutoProxyCreator creator = new BeanNameAutoProxyCreator();
                creator.setName("*ServieImpl");
                creator.setInterceptorNames("serviceInterceptor");
                creator.setProxyTargetClass(true);
                return creator;
          }
    }
    

    查了一些資料,apoalliance包下只是aop的接口規範,不是具體的實現,不要把這裏的MethodInterceptor和cglib的MethodInterceptor搞混。

    2.4 構造方法注入和設值注入的區別

    注:設值注入指的是通過setter注入。
    之前看參考文獻[7],感覺很難懂,試着改換了一種說法:

    1. 如果只設置基本類型(int、long等)的值,建議設置默認值而不是通過任何一種注入完成
    2. 構造注入不支持大部分的依賴注入。構造注入僅在創建時執行,設值注入的值在後續也可以變化。
    3. 設值注入可以支持尚未完整的被依賴的對象,構造注入則不行。可以通過構造注入決定依賴關係,因此如果依賴關係不會發生變更也可以選擇依賴注入。

    2.5 ApplicationContext事件

    可以通過實現ApplicationEvent類和ApplicationListener接口,進行ApplicationContext的事件處理。這是標準的發送者-監聽者的模型,可以用來處理業務邏輯,將代碼解耦。
    但是,發送和接收實際上是同步的,如果有事務,會在同一個事務內,並不能作為異步處理機制[8]。
    示例代碼見參考文獻[9]。

    3. SpringBoot

    注:工作中我對SpringBoot是偏應用的,研究並不是很深入。

    3.1 如何快速搭建一個SpringBoot項目

    見參考文獻[10]。實際的過程是藉助Spring Initializer這個網絡應用程序來生成SpringBoot項目。

    3.2 SpringBoot的關鍵註解

    所謂核心註解,這裏指的是相對Spring本身新增的一些註解,來看看它們有什麼作用。
    恰好這裏提到的註解,都可以打在SpringBoot的啟動類(不限於啟動類),用下面的代碼片段來進行說明。

    3.2.1 代碼示例

    package com.example.demo;
    
    import org.mybatis.spring.annotation.MapperScan;
    import org.springframework.boot.SpringApplication;
    import org.springframework.boot.autoconfigure.SpringBootApplication;
    import org.springframework.context.annotation.Import;
    import org.springframework.context.annotation.PropertySource;
    
    @PropertySource(value = "classpath:application.properties")
    @MapperScan("com.example.demo.dal")
    @SpringBootApplication(scanBasePackages = {"com.example.demo"})
    @Import({DemoConfig1.class, DemoConfig2.class,})
    public class DemoApplication {
    	public static void main(String[] args) {
    		SpringApplication.run(DemoApplication.class, args);
    	}
    }
    

    3.2.2 @PropertySource

    從指定的文件讀取變量。示例代碼會從resource目錄下讀取application.properties變量的值。文件的格式如下,既可以用常量,也可以用變量替換,來對不同環境的值作區分。

    name=value
    env.name=$env.value
    

    如何使用這個值?在要使用的地方獲取即可。

    @PropertySource(value = "classpath:application.properties")
    class TestClass {
    	@Resource
    	private Environment environment;
    
          @Test
          public void test() {
                String value = environment.getProperty("name"));
          }
    }
    

    3.2.2.1 與@Value配合使用

    使用@Value可以把配置文件的值直接注入到成員變量中。

    @PropertySource("classpath:application.properties")
    public class PropertyConfig {
    
        @Value("${name}")
        private String value;
    
         ...
    }
    

    3.2.2.2 通過@Import引用

    3.2.1的示例代碼中,如果類上沒有@PropertySource,但DemoConfig1或DemoConfig2中有@PropertySource,通過@Import可以將它們加載的變量也讀出來。
    @Import的作用在下文會繼續介紹。

    3.2.2.3 .properties和.yml配置文件

    @PropertySource只能導入.properties配置文件里的內容,對於.yml是不支持的。看了一些文章,得出結論是yml文件是不需要註解就能導入,但是需要路徑。
    Springboot有兩種核心配置文件,application和bootstrap,都可以用properties或yml格式。區別在於bootstrap比application優先加載,並且不可覆蓋。

    3.2.3 @MapperScan

    這實際上是一個mybatis註解,作用是為指定路徑下的DAO接口,通過sqlmapping.xml文件,生成實現類。

    3.2.4 @SpringBootApplication

    @SpringBootApplication是由多個註解組合成的。源碼如下:

    @Target(ElementType.TYPE)
    @Retention(RetentionPolicy.RUNTIME)
    @Documented
    @Inherited
    @SpringBootConfiguration
    @EnableAutoConfiguration
    @ComponentScan(excludeFilters = { @Filter(type = FilterType.CUSTOM, classes = TypeExcludeFilter.class),
    		@Filter(type = FilterType.CUSTOM, classes = AutoConfigurationExcludeFilter.class) })
    public @interface SpringBootApplication {
          // 略
    }
    

    簡單介紹一下這些註解。

    3.2.4.1 元註解

    最上面四行都是元註解。回憶一下它們的作用[12]:

    • @Target 註解可以用在哪。TYPE表示類型,如類、接口、枚舉
    • @Retention 註解的保留時間期限。只有RUNTIME類型可以在運行時通過反射獲取其值
    • @Documented 該註解在生成javadoc文檔時是否保留
    • @Inherited 被註解的元素,是否具有繼承性,如子類可以繼承父類的註解而不必顯式的寫下來。

    3.2.4.2 @SpringBootConfiguration

    標註這是一個SpringBoot的配置類,和@Configuration功能是相通的,從源碼也可以看出它直接使用了@Configuration。

    3.2.4.3 @EnableAutoConfiguration

    這個註解是實現自動化配置的核心註解,定義如下

    @Target(ElementType.TYPE)
    @Retention(RetentionPolicy.RUNTIME)
    @Documented
    @Inherited
    @AutoConfigurationPackage
    @Import(AutoConfigurationImportSelector.class)
    public @interface EnableAutoConfiguration {
          // 略
    }
    

    藉助@Import引入的AutoConfigurationImportSelector,SpringBoot應用將所有符合條件的@Configuration配置都加載到當前SpringBoot創建並使用的IoC容器。具體的細節這裏不展開了。

    3.2.4.4 @ComponentScan

    掃描@Service、@Repository、@Component、@Controller等標註的類,創建bean。
    可以設置掃描範圍,決定類哪些生成bean,哪些類不生成。

    3.2.5 @Import

    將外部資源(bean、@Configuration配置類)導入到當前IOC容器中。
    使用@Import便可以實例化引用的jar中定義的bean了。

    3.3 Starter

    指的是在依賴中引用的各種starter包。starter可以看作是“依賴jar+配置”打包的結果,目的是降低開發者引入組件的成本,不用自己梳理依賴、編寫配置文件。
    starter遵循“約定大於配置”的原則,使用的組件的配置大部分都有默認值,不聲明也可以直接用。

    創建一個Spring boot的簡易步驟(完整的可以看參考文獻[14]):

    1. 創建maven項目
    2. 創建proterties類來保存配置信息
    3. 編寫業務功能類(包含會實例化為bean的類)
    4. 編寫Configuration類,定義bean
    5. 在resources 文件夾下新建目錄 META-INF,在目錄中新建 spring.factories 文件,並且在 spring.factories 中配置AutoConfiguration
    6. 打包

    3.4 war包

    3.4.1 和jar包的區別

    • jar 把類和相關的資源封裝
    • war 代表了一個可部署的Web應用程序

    3.4.2 SpringBoot項目打war包部署

    通用步驟如下,其中1可能需要移除內嵌tomcat,2有其他形式,因為我工作時都是拿線程腳本打包的,沒有實際操作過,下面步驟僅供參考。

    1. pom.xml修改為按war打包
    2. 修改main入口方法,繼承一個SpringBootServletInitializer類,並且覆蓋configure方法
    3. maven打包
    4. 複製到tomcat路徑下(tomcat需要預先配置),使用startup啟動

    3.5 Springboot面試題補充

    本節內容結合了參考文獻[16]進行補充,上面提到的知識不再重複。

    3.5.1 使用Springboot的兩種方式

    1. 繼承spring-boot-starter-parent項目
    <parent>
          <groupId>org.springframework.boot</groupId>
          <artifactId>spring-boot-starter-parent</artifactId>
          <version>1.5.6.RELEASE</version>
    </parent>
    
    1. 導入spring-boot-dependencies項目依賴
    <dependencyManagement>
          <dependencies>
                <dependency>
                    <groupId>org.springframework.boot</groupId>
                    <artifactId>spring-boot-dependencies</artifactId>
                    <version>1.5.6.RELEASE</version>
                    <type>pom</type>
                    <scope>import</scope>
                </dependency>
          </dependencies>
    </dependencyManagement>
    

    3.5.2 SpringBoot 需要獨立的容器運行嗎?

    可以不需要,內置了 Tomcat/Jetty等容器。
    如何使用Jetty?排除掉Tomcat依賴並引入Jetty,並更改一些application配置。兩種容器的比較和替換方式見參考文獻[17]。

    3.5.3 運行 SpringBoot 有哪幾種方式?

    1. 打包用命令或者放到容器中運行
    2. 用 Maven/ Gradle 插件運行
    3. 直接執行 main 方法運行

    3.5.4 SpringBoot啟動時運行特定代碼的方式

    Bean實現接口 ApplicationRunner或者CommandLineRunner即可。

    3.5.5 SpringBoot實現熱部署有哪幾種方式?

    主要有兩種

    • Spring Loaded —— 引用依賴(maven plugin)。對於註解和xml變動無法感知需要重啟
    • Spring-boot-devtools —— 引用依賴、更改配置(可選)、啟動idea的自動編譯。注意生產環境插件可能導致gc

    3.5.6 Spring Boot 可以兼容老 Spring 項目嗎,如何做?

    可以兼容,使用 @ImportResource 註解導入老 Spring 項目配置文件。

    參考文獻

    1.AOP -連接點和切點的區別
    2.Spring AOP術語:連接點和切點的區別。
    3.深究Spring中Bean的生命周期
    4.Spring AOP代理用的到底是CGLIB還是JDK動態代理
    5. Spring的兩種動態代理:Jdk和Cglib 的區別和實現
    6. Spring AOP中的JDK和CGLib動態代理哪個效率更高?
    7. 經典面試題-構造方法注入和設值注入有什麼區別?
    8. Spring的ApplicationEvent
    9. spring-第三篇之ApplicationContext的事件機制
    10. 使用IDEA搭建一個簡單的SpringBoot項目——詳細過程
    11. 淺析PropertySource 基本使用
    12. JAVA核心知識點–元註解詳解
    13. 簡單講講@SpringBootApplication
    14. Spring Boot Starters
    15. SpringBoot 打包成war
    16. 吐血整理 20 道 Spring Boot 面試題,我經常拿來面試別人!
    17. SpringBoot2使用Jetty容器(替換默認Tomcat)

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※超省錢租車方案

    ※別再煩惱如何寫文案,掌握八大原則!

    ※回頭車貨運收費標準

    ※教你寫出一流的銷售文案?

  • 抗議氣候變遷 奧斯卡影后珍芳達被捕

    摘錄自2019年10月12日中央通訊社美國報導

    奧斯卡影后珍芳達(Jane Fonda)12日在美國國會山莊外被逮捕,當時她參與氣候變遷抗議活動,並在現場發表談話要求當局採取行動保護環境,之後就被警方銬上手銬帶走。

    法新社報導,長期投身社會運動的珍芳達在臉書(Facebook)專頁張貼的影片顯示,她在國會大廈的階梯上抗議長達10分鐘後,便與其他數名人士一同遭到拘押。

    警方發言人發布聲明說:「美國國會警察局(US Capitol Police)今天逮捕16人,因為他們違法在國會山莊東側抗議。」但聲明並未指明是哪些人被捕。

    81歲的珍芳達穿著亮紅色大衣,反覆呼喊氣候變遷相關口號,而後她被警方銬上手銬,並在其他示威者的歡呼聲下被帶走。數個小時後珍芳達就被釋放。

    珍芳達近期告訴「洛杉磯時報」(Los Angeles Times),她將搬到華府4個月,並效法瑞典環保少女桑柏格(Greta Thunberg)的熱情,全心全力對抗全球暖化。

    珍芳達被捕前曾向現場一小群人發表談話,她痛斥氣候變遷這項「人為危機」,還說自己跟其他環保人士「每週五中午11時,無論晴天、雨天、下雪或暴風雪」,他們都會回到國會山莊展開一連串示威活動。

    「紐約時報」(New York Times)報導,珍芳達若因參與違法示威活動被定罪,將面臨最多250美元(約新台幣7660元)罰款,以及最高90天的刑期。

    珍芳達曾分別以1971年「柳巷芳草」(Klute)與1978年「歸返家園」(Coming Home)兩部作品,摘下奧斯卡影后殊榮。

    本站聲明:網站內容來源環境資訊中心https://e-info.org.tw/,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※帶您來了解什麼是 USB CONNECTOR  ?

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

    ※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※教你寫出一流的銷售文案?

  • 基於層級表達的高效網絡搜索方法 | ICLR 2018

    基於層級表達的高效網絡搜索方法 | ICLR 2018

    論文基於層級表達提出高效的進化算法來進行神經網絡結構搜索,通過層層堆疊來構建強大的卷積結構。論文的搜索方法簡單,從實驗結果看來,達到很不錯的準確率,值得學習
     
    來源:【曉飛的算法工程筆記】 公眾號

    論文: Hierarchical Representations for Efficient Architecture Search

    • 論文地址:https://arxiv.org/abs/1711.00436

    Introduction

      由於網絡的驗證需要耗費很長的時間,神經網絡結構搜索計算量非常巨大,很多研究通過降低搜索空間的複雜度來提高搜索的效率。論文通過加入分層網絡結構來約束搜索空間,在最初幾層僅使用卷積和池化等簡單操作,逐步到高層將底層的block進行組合搭建,最後將最高層的block堆疊成最終的網絡。由於搜索空間設計夠好,網絡的搜索方法僅用進化算法或隨機搜索足以。
      論文總結如下:

    • 提出對神經網絡結構的層級表達
    • 通過實驗證明搜索空間的設計十分重要,可以降低搜索方法的投入,甚至隨機搜索也可以
    • 提出可擴展的進化搜索方法,對比其它進化搜索方法有更好的結果

    Architecture Representations

    Flat Architecture Representation

      將神經網絡結構定義為單輸入、單輸出的計算圖,圖中每個節點代表特徵圖,每條有向邊為基本操作(卷積、池化等),所以網絡的表達$(G,o)$包含兩部分:

    1. 一個有效的操作集合$o={o_1,o_2,…}$
    2. 一個鄰接矩陣$G$,用以指定操作的神經網絡圖,$G_{ij}=k$為節點$i$和節點$j$間的操作為$o_k$

      將操作集$o$和鄰接矩陣$G$組合起來就得到網絡的結構

      每個節點$i$的特徵圖$x_i$由其前面的節點$j$通過公式2計算而得,$|G|$是圖中節點數量,$merge$將多個特徵圖合併成一個的操作,這裏直接使用depthwise concatentation,由於element-wise addition要求維度一致,比較不靈活,而且如果融合特徵後接的是$1\times 1$卷積,這就其實類似於做concatienation

    Hierarchical Architecture Representation

      層級結構表達的關鍵是找到不同的層級的模版,在構建高層模版時使用低層的模版作為積木(operation)進行構建

      對於$L$層的層級關係,$\ell$層包含$M_{\ell}$個模版,最高層$\ell=L$僅包含一個模版,對應完整的網絡,最低層$\ell=1$是元操作集,定義$o_m{(\ell)}$為$\ell$層的第$m$個模版,為低層模版$o{(\ell)}={o_1^{(\ell -1)},o_2^{(\ell -1)},…,o_1^{(\ell – 1)}}$根據公式3的組合。最終的層級結構表達為$({{G_m{(\ell)}}_{m=1}M}_{\ell=2}L,o{(1)})$,由每層的模版的網絡結構關係和最底層操作定義,如圖1

    Primitive Operations

      低層的原操作共六種($\ell=1$,$M_t=6$):

    • 1 × 1 convolution of C channels
    • 3 × 3 depthwise convolution
    • 3 × 3 separable convolution of C channels
    • 3 × 3 max-pooling
    • 3 × 3 average-pooling
    • identity

      使用時,所有元操作為stride=1,以及進行padded來保留分辨率,卷積后都接BN+ReLU,維度固定為$C$。另外每層都有$none$操作,代表節點$i$和節點$j$之間沒有連接

    Evolutionary Architecture Search

    Mutation

      分層基因的變異包含以下步驟:

    • 採樣一個非原始層$\ell\ge2$作為目標層
    • 在目標層採樣一個模版$m$作為目標模版
    • 在目標模版中採樣一個後繼節點$i$
    • 在目標模版中採樣一個前置節點$j$
    • 隨機替換當前操作$o_k^{(\ell -1)}$為其它操作$o_{k{‘}}{(\ell -1)}$

      對於當前層級只有兩層的,第一步直接將$\ell$設為2,變異可總結為公式4,$\ell$,$m$,$i$,$j$,$k^{‘}$從各自區域的均勻分佈中隨機抽樣得到,上面的突變足夠對模版產生3種修改:

    • 添加邊:$o_k^{(\ell -1)}=none$,$o_{k{‘}}{(\ell -1)}\ne none$
    • 修改存在的邊:$o_k^{(\ell -1)}\ne none$,$o_{k{‘}}{(\ell -1)}\ne none$,$o_k^{(\ell -1)}\ne o_{k{‘}}{(\ell -1)}$
    • 刪除存在的邊:$o_k^{(\ell -1)}\ne none$,$o_{k{‘}}{(\ell -1)}= none$

    Initialization

      基因指代完整的網絡,基因的種群初始化包含兩個步驟:

    1. 建立一個不重要的基因,每個模版都使用identity進行連接
    2. 對基因進行大批量的隨機變異來多樣化

      對比以前的研究使用常見的網絡進行基因初始化,這樣的初始化不僅能很好地覆蓋不常見的網絡的搜索空間,還能去除人工初始化帶來的傳統偏向

    Search Algorithms

      論文的進化算法基於錦標賽選擇(tournament selection),首先對初始化的種群網絡進行訓練和測試得到分數,然後從種群中隨機獲取5%的基因,表現最好的基因進行突變得到新網絡,在訓練和測試後放入種群中,重複進行上述選取與放回,種群數量不斷增大,最終取種群表現最好的基因
      論文也使用隨機搜索進行實驗,基因種群隨機生成,然後進行訓練和驗證,選取最好的模型,這種方法的主要好處在於能整個種群并行化計算,減少搜索時間

    Implementation

      論文使用異步分佈式進行實現,包含一個controller和多個worker,分別負責基因的進化和測試,兩者共享一個內存表格$\mathcal{M}$,記錄基因及其準確率(fitness),還有一個數據隊列$\mathcal{Q}$,包含待測試的基因

      當有worker空餘時,controller使用錦標賽選擇從$\mathcal{M}$中選擇一個基因進行突變,然後放到隊列$\mathcal{Q}$中等待測試

      worker從$\mathcal{Q}$中拿到待測試的基因,測試後放到$\mathcal{M}$中,訓練是從頭開始訓練的,沒有使用權值共享加速

    Experiments and Results

    Experimental Setup

      在實驗中,沒有對整體網絡進行搜索,而是使用提出的方法進行卷積單元(cell)的搜索,這樣能夠在小網絡上快速進行網絡測試然後遷移到較大的網絡。具體的各結構如圖2,每個cell後面接$2c$維度和$stride=2$的$3\times 3$分離卷積,用於升維和降低分辨率,最後一個cell後面接$c$維度和$stride=1$的$3\times 3$分離卷積

    Architecture Search on CIFAR-10

      200卡,初始種群為200,層級$L=3$,每層模版的操作分別為$M_1=6$,$M_2=6$和$M_3=1$,每層($\ell \ge2$)的節點圖分別為$|G{(2)}|=4$和$|G{(3)}|=5$,層2的模版跟一個跟模版輸入維度一樣$1\times 1$的卷積來降維。對於用於對比的不分層的搜索方法,則使用11個節點的計算圖。從圖3來看,論文提出的方法在收斂速度、準確率和參數量上都不錯

      為了進一步展示論文方法的效果,對圖3中間的結果的每輪增量進行了可視化。在P100 GPU上,每個網絡的測試需要花費1小時,進化共7000輪,200張卡共需要1.5天

    Architecture Evaluation on CIFAR-10 and ImageNet

    CONCLUSION

      論文基於層級表達提出高效的進化算法來進行神經網絡結構搜索,通過層層堆疊來構建強大的卷積結構。論文的搜索方法簡單,從實驗結果看來,200張卡共需要1.5天,達到很不錯的準確率,值得學習


    APPENDIX A


    如果本文對你有幫助,麻煩點個贊或在看唄~
    更多內容請關注 微信公眾號【曉飛的算法工程筆記】

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※為什麼 USB CONNECTOR 是電子產業重要的元件?

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※台北網頁設計公司全省服務真心推薦

    ※想知道最厲害的網頁設計公司"嚨底家"!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※推薦評價好的iphone維修中心

  • 深入理解React:事件機制原理

    深入理解React:事件機制原理

    目錄

    • 序言
    • DOM事件流
      • 事件捕獲階段、處於目標階段、事件冒泡階段
      • addEventListener 方法
    • React 事件概述
    • 事件註冊
      • document 上註冊
      • 回調函數存儲
    • 事件分發
    • 小結
    • 參考

    1.序言

    React 有一套自己的事件系統,其事件叫做合成事件。為什麼 React 要自定義一套事件系統?React 事件是如何註冊和觸發的?React 事件與原生 DOM 事件有什麼區別?帶着這些問題,讓我們一起來探究 React 事件機制的原理。為了便於理解,此篇分析將盡可能用圖解代替貼 React 源代碼進行解析。

    2.DOM事件流

    首先,在正式講解 React 事件之前,有必要了解一下 DOM 事件流,其包含三個流程:事件捕獲階段、處於目標階段和事件冒泡階段。

    W3C協會早在1988年就開始了DOM標準的制定,W3C DOM標準可以分為 DOM1、DOM2、DOM3 三個版本。

    從 DOM2 開始,DOM 的事件傳播分三個階段進行:事件捕獲階段、處於目標階段和事件冒泡階段。

    (1)事件捕獲階段、處於目標階段和事件冒泡階段

    示例代碼:

    <html>
        <body>
            <div id="outer">
    	    <p id="inner">Click me!</p>
    	</div>
        </body>
    </html>
    

    上述代碼,如果點擊 <p>元素,那麼 DOM 事件流如下圖:

    (1)事件捕獲階段:事件對象通過目標節點的祖先 Window 傳播到目標的父節點。

    (2)處於目標階段:事件對象到達事件目標節點。如果阻止事件冒泡,那麼該事件對象將在此階段完成后停止傳播。

    (3)事件冒泡階段:事件對象以相反的順序從目標節點的父項開始傳播,從目標節點的父項開始到 Window 結束。

    (2)addEventListener 方法

    DOM 的事件流中同時包含了事件捕獲階段和事件冒泡階段,而作為開發者,我們可以選擇事件處理函數在哪一個階段被調用。

    addEventListener() 方法用於為特定元素綁定一個事件處理函數。addEventListener 有三個參數:

    element.addEventListener(event, function, useCapture)
    

    另外,如果一個元素(element)針對同一個事件類型(event),多次綁定同一個事件處理函數(function),那麼重複的實例會被拋棄。當然如果第三個參數capture值不一致,此時就算重複定義,也不會被拋棄掉。

    3.React 事件概述

    React 根據W3C 規範來定義自己的事件系統,其事件被稱之為合成事件 (SyntheticEvent)。而其自定義事件系統的動機主要包含以下幾個方面:

    (1)抹平不同瀏覽器之間的兼容性差異。最主要的動機。

    (2)事件”合成”,即事件自定義。事件合成既可以處理兼容性問題,也可以用來自定義事件(例如 React 的 onChange 事件)。

    (3)提供一個抽象跨平台事件機制。類似 VirtualDOM 抽象了跨平台的渲染方式,合成事件(SyntheticEvent)提供一個抽象的跨平台事件機制。

    (4)可以做更多優化。例如利用事件委託機制,幾乎所有事件的觸發都代理到了 document,而不是 DOM 節點本身,簡化了 DOM 事件處理邏輯,減少了內存開銷。(React 自身模擬了一套事件冒泡的機制)

    (5)可以干預事件的分發。V16引入 Fiber 架構,React 可以通過干預事件的分發以優化用戶的交互體驗。

    注:「幾乎」所有事件都代理到了 document,說明有例外,比如audio、video標籤的一些媒體事件(如 onplay、onpause 等),是 document 所不具有,這些事件只能夠在這些標籤上進行事件進行代理,但依舊用統一的入口分發函數(dispatchEvent)進行綁定。

    4.事件註冊

    React 的事件註冊過程主要做了兩件事:document 上註冊、存儲事件回調。

    (1)document 上註冊

    在 React 組件掛載階段,根據組件內的聲明的事件類型(onclick、onchange 等),在 document 上註冊事件(使用addEventListener),並指定統一的回調函數 dispatchEvent。換句話說,document 上不管註冊的是什麼事件,都具有統一的回調函數 dispatchEvent。也正是因為這一事件委託機制,具有同樣的回調函數 dispatchEvent,所以對於同一種事件類型,不論在 document 上註冊了幾次,最終也只會保留一個有效實例,這能減少內存開銷。

    示例代碼:

    function TestComponent() {
      handleFatherClick=()=>{
    		// ...
      }
    
      handleChildClick=()=>{
    		// ...
      }
    
      return <div className="father" onClick={this.handleFatherClick}>
    	<div className="child" onClick={this.handleChildClick}>child </div>
      </div>
    }
    

    上述代碼中,事件類型都是onclick,由於 React 的事件委託機制,會指定統一的回調函數 dispatchEvent,所以最終只會在 document 上保留一個 click 事件,類似document.addEventListener('click', dispatchEvent),從這裏也可以看出 React 的事件是在 DOM 事件流的冒泡階段被觸發執行。

    (2)存儲事件回調

    React 為了在觸發事件時可以查找到對應的回調去執行,會把組件內的所有事件統一地存放到一個對象中(listenerBank)。而存儲方式如上圖,首先會根據事件類型分類存儲,例如 click 事件相關的統一存儲在一個對象中,回調函數的存儲採用鍵值對(key/value)的方式存儲在對象中,key 是組件的唯一標識 id,value 對應的就是事件的回調函數。

    React 的事件註冊的關鍵步驟如下圖:

    5.事件分發

    事件分發也就是事件觸發。React 的事件觸發只會發生在 DOM 事件流的冒泡階段,因為在 document 上註冊時就默認是在冒泡階段被觸發執行。

    其大致流程如下:

    1. 觸發事件,開始 DOM 事件流,先後經過三個階段:事件捕獲階段、處於目標階段和事件冒泡階段
    2. 當事件冒泡到 document 時,觸發統一的事件分發函數 ReactEventListener.dispatchEvent
    3. 根據原生事件對象(nativeEvent)找到當前節點(即事件觸發節點)對應的 ReactDOMComponent 對象
    4. 事件的合成
      1. 根據當前事件類型生成對應的合成對象
      2. 封裝原生事件對象和冒泡機制
      3. 查找當前元素以及它所有父級
      4. 在 listenerBank 中查找事件回調函數併合成到 events 中
    5. 批量執行合成事件(events)內的回調函數
    6. 如果沒有阻止冒泡,會將繼續進行 DOM 事件流的冒泡(從 document 到 window),否則結束事件觸發

    注:上圖中阻止冒泡是指調用stopImmediatePropagation 方法阻止冒泡,如果是調用stopPropagation阻止冒泡,document 上如果還註冊了同類型其他的事件,也將會被觸發執行,但會正常阻斷 window 上事件觸發。了解兩者之間的詳細區別

    示例代碼:

    class TestComponent extends React.Component {
    
      componentDidMount() {
        this.parent.addEventListener('click', (e) => {
          console.log('dom parent');
        })
        this.child.addEventListener('click', (e) => {
          console.log('dom child');
        })
        document.addEventListener('click', (e) => {
          console.log('document');
        })
        document.body.addEventListener('click', (e) => {
          console.log('body');
        })
        window.addEventListener('click', (e) => {
          console.log('window');
        })
      }
    
      childClick = (e) => {
        console.log('react child');
      }
    
      parentClick = (e) => {
        console.log('react parent');
      }
    
      render() {
        return (
          <div class='parent' onClick={this.parentClick} ref={ref => this.parent = ref}>
            <div class='child' onClick={this.childClick} ref={ref => this.child = ref}>
              Click me!
            </div>
          </div>)
      }
    }
    

    點擊 child div 時,其輸出如下:

    在 DOM 事件流的冒泡階段先後經歷的元素:child <div> -> parent <div> -> <body> -> <html> -> document -> window,因此上面的輸出符合預期。

    6.小結

    React 合成事件和原生 DOM 事件的主要區別:

    (1)React 組件上聲明的事件沒有綁定在 React 組件對應的原生 DOM 節點上。

    (2)React 利用事件委託機制,將幾乎所有事件的觸發代理(delegate)在 document 節點上,事件對象(event)是合成對象(SyntheticEvent),不是原生事件對象,但通過 nativeEvent 屬性訪問原生事件對象。

    (3)由於 React 的事件委託機制,React 組件對應的原生 DOM 節點上的事件觸發時機總是在 React 組件上的事件之前。

    7.參考

    javascript中DOM0,DOM2,DOM3級事件模型解析

    Event dispatch and DOM event flow

    EventTarget.addEventListener() – Web API 接口參考| MDN

    合成事件

    談談React事件機制和未來(react-events)

    React源碼解讀系列 – 事件機制

    一文吃透 react 事件機制原理

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
    【其他文章推薦】

    ※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

    ※台北網頁設計公司這麼多該如何選擇?

    ※智慧手機時代的來臨,RWD網頁設計為架站首選

    ※評比南投搬家公司費用收費行情懶人包大公開

    ※幫你省時又省力,新北清潔一流服務好口碑

    ※回頭車貨運收費標準

  • Lens —— 最炫酷的 Kubernetes 桌面客戶端

    Lens —— 最炫酷的 Kubernetes 桌面客戶端

    原文鏈接:https://fuckcloudnative.io/posts/lens/

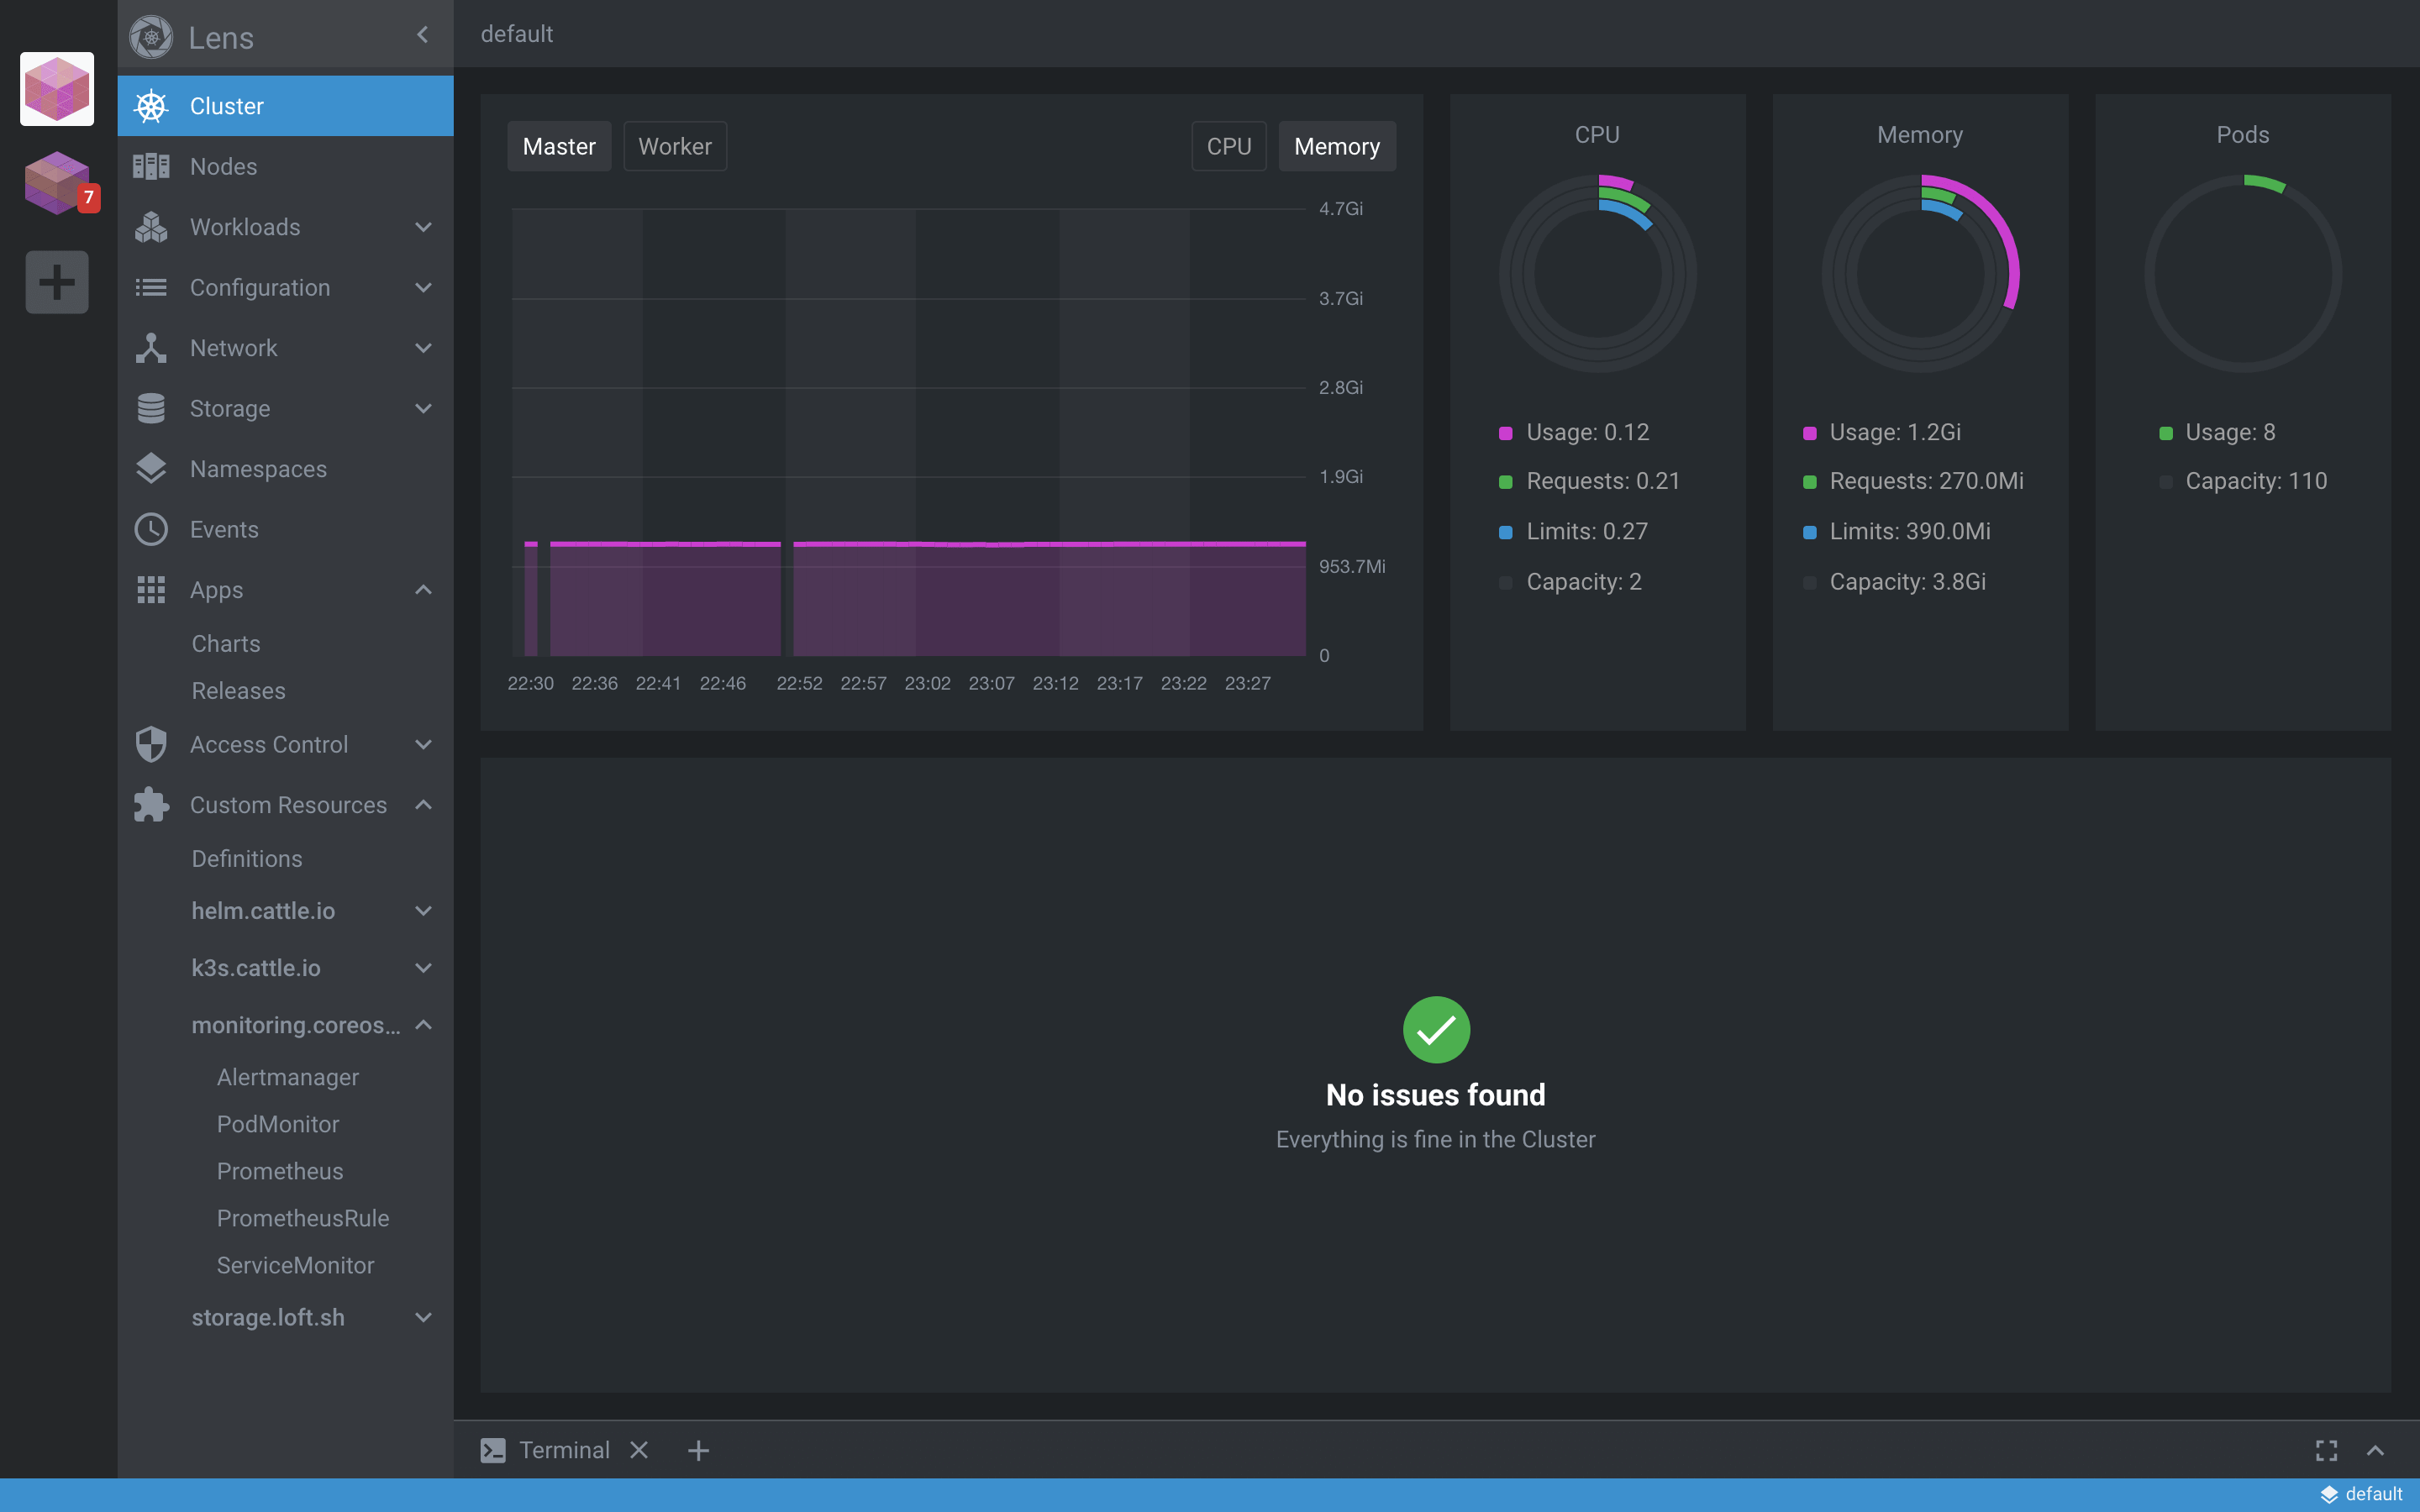
    Kubernetes 的桌面客戶端有那麼幾個,曾經 Kubernetic 應該是最好用的,但最近有個叫 Lens 的 APP 改變了這個格局,功能比 Kubernetic 多,使用體驗更好,適合廣大系統重啟工程師裝逼。它有以下幾個亮點:

    ① Lens 就是一個強大的 IDE,可以實時查看集群狀態,實時查看日誌流,方便排查故障。有了 Lens,你可以更方便快捷地使用你的集群,從根本上提高工作效率和業務迭代速度。

    日誌流界面可以選擇显示或隱藏時間戳,也可以指定显示的行數:

    ② Lens 可以管理多集群,它使用內置的 kubectl 通過 kubeconfig 來訪問集群,支持本地集群和外部集群(如EKS、AKS、GKE、Pharos、UCP、Rancher 等),甚至連 Openshift 也支持:

    只是與 Openshift 的監控還不太兼容。也可以很輕鬆地查看並編輯 CR:

    有了 Lens,你就可以統一管理所有的集群。

    ③ Lens 內置了資源利用率的儀錶板,支持多種對接 Prometheus 的方式:

    ④ Lens 內置了 kubectl,它的內置終端會確保集群的 API Server 版本與 kubectl 版本兼容,所以你不需要在本地安裝 kubectl。可以驗證一下:

    你會看到本地安裝的 kubectl 版本和 Lens 裏面打開的終端里的 kubectl 版本信息是不一樣的,Lens 確實內置了 kubectl。

    ⑤ Lens 內置了 helm 模板商店,可直接點擊安裝:

    現在 Lens 迎來了最新版 3.5.0,換上了全新的 Logo:

    穩定性也提升了很多,快去試試吧。

    Kubernetes 1.18.2 1.17.5 1.16.9 1.15.12離線安裝包發布地址http://store.lameleg.com ,歡迎體驗。 使用了最新的sealos v3.3.6版本。 作了主機名解析配置優化,lvscare 掛載/lib/module解決開機啟動ipvs加載問題, 修復lvscare社區netlink與3.10內核不兼容問題,sealos生成百年證書等特性。更多特性 https://github.com/fanux/sealos 。歡迎掃描下方的二維碼加入釘釘群 ,釘釘群已經集成sealos的機器人實時可以看到sealos的動態。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

    ※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

    ※教你寫出一流的銷售文案?

    ※超省錢租車方案

  • 用Map+函數式接口來實現策略模式

    用Map+函數式接口來實現策略模式

    用Map+函數式接口來實現策略模式

    目前在魔都,貝殼找房是我的僱主,平時關注一些 java 領域相關的技術,希望你們能在這篇文章中找到些有用的東西。個人水平有限,如果文章有錯誤還請指出,在留言區一起交流。

    本文已投稿至公眾號 Hollis 原文鏈接:https://mp.weixin.qq.com/s/hkypvNBkRjPM6HM51_jW9g

    我想大家肯定都或多或少的看過各種“策略模式”的講解、佈道等等,這篇文章就是來好好“澄清”一下策略模式,並嘗試回答以下的問題:

    1. 策略模式是如何優化業務邏輯代碼結構的?
    2. 殺雞焉用宰牛刀?就是幾個if else場景我需要用到策略模式?!
    3. 有沒有什麼更好的代碼結構來實現策略模式的嗎?

    策略模式是如何優化業務邏輯代碼結構的?

    要回答這個問題,我們還得先扒一扒策略模式的定義,從定義着手來理解它:

    策略模式的教科書定義

    它的定義很精簡:一個類的行為或其算法可以在運行時更改。我們把它降維到代碼層面,用人話翻譯一下就是,運行時我給你這個類的方法傳不同的“key”,你這個方法會執行不同的業務邏輯。細品一下,這不就是 if else 乾的事嗎?

    策略模式優化了什麼?

    其實策略模式的核心思想和 if else如出一轍,根據不同的key動態的找到不同的業務邏輯,那它就只是如此嗎?

    實際上,我們口中的策略模式其實就是在代碼結構上調整,用接口+實現類+分派邏輯來使代碼結構可維護性好點。

    一般教科書上講解到接口與實現類就結束了,其他博客上會帶上提及分派邏輯。這裏就不啰嗦了。

    小結一下,即使用了策略模式,你該寫的業務邏輯照常寫,到邏輯分派的時候,還是變相的if else。而它的優化點是抽象了出了接口,將業務邏輯封裝成一個一個的實現類,任意地替換。在複雜場景(業務邏輯較多)時比直接 if else 來的好維護些。

    殺雞焉用宰牛刀?就是幾個if else場景我需要用到策略模式?!

    我想小夥伴們經常有這樣的不滿,我的業務邏輯就3 4 行,你給我整一大堆類定義?有必要這麼麻煩嗎?我看具體的業務邏輯還需要去不同的類中,簡單點行不行。

    其實我們所不滿的就是策略模式帶來的缺點:1、策略類會增多 2、業務邏輯分散到各個實現類中,而且沒有一個地方可以俯視整個業務邏輯

    針對傳統策略模式的缺點,在這分享一個實現思路,這個思路已經幫我們團隊解決了多個複雜if else的業務場景,理解上比較容易,代碼上需要用到Java8的特性——利用Map與函數式接口來實現。

    直接show代碼結構:為了簡單演示一個思路,代碼用String 類型來模擬一個業務BO

    其中:

    1. getCheckResult() 為傳統的做法
    2. getCheckResultSuper()則事先在Map中定義好了“判斷條件”與“業務邏輯”的映射關係,具體講解請看代碼註釋
    /**
     * 某個業務服務類
     */
    @Service
    public class BizService {
    
        /**
         * 傳統的 if else 解決方法
         * 當每個業務邏輯有 3 4 行時,用傳統的策略模式不值得,直接的if else又顯得不易讀
         */
        public String getCheckResult(String order) {
            if ("校驗1".equals(order)) {
                return "執行業務邏輯1";
            } else if ("校驗2".equals(order)) {
                return "執行業務邏輯2";
            }else if ("校驗3".equals(order)) {
                return "執行業務邏輯3";
            }else if ("校驗4".equals(order)) {
                return "執行業務邏輯4";
            }else if ("校驗5".equals(order)) {
                return "執行業務邏輯5";
            }else if ("校驗6".equals(order)) {
                return "執行業務邏輯6";
            }else if ("校驗7".equals(order)) {
                return "執行業務邏輯7";
            }else if ("校驗8".equals(order)) {
                return "執行業務邏輯8";
            }else if ("校驗9".equals(order)) {
                return "執行業務邏輯9";
            }
            return "不在處理的邏輯中返回業務錯誤";
        }
    
        /**
         * 業務邏輯分派Map
         * Function為函數式接口,下面代碼中 Function<String, String> 的含義是接收一個Stirng類型的變量,返回一個String類型的結果
         */
        private Map<String, Function<String, String>> checkResultDispatcher = new HashMap<>();
    
        /**
         * 初始化 業務邏輯分派Map 其中value 存放的是 lambda表達式
         */
        @PostConstruct
        public void checkResultDispatcherInit() {
            checkResultDispatcher.put("校驗1", order -> String.format("對%s執行業務邏輯1", order));
            checkResultDispatcher.put("校驗2", order -> String.format("對%s執行業務邏輯2", order));
            checkResultDispatcher.put("校驗3", order -> String.format("對%s執行業務邏輯3", order));
            checkResultDispatcher.put("校驗4", order -> String.format("對%s執行業務邏輯4", order));
            checkResultDispatcher.put("校驗5", order -> String.format("對%s執行業務邏輯5", order));
            checkResultDispatcher.put("校驗6", order -> String.format("對%s執行業務邏輯6", order));
            checkResultDispatcher.put("校驗7", order -> String.format("對%s執行業務邏輯7", order));
            checkResultDispatcher.put("校驗8", order -> String.format("對%s執行業務邏輯8", order));
            checkResultDispatcher.put("校驗9", order -> String.format("對%s執行業務邏輯9", order));
        }
    
        public String getCheckResultSuper(String order) {
            //從邏輯分派Dispatcher中獲得業務邏輯代碼,result變量是一段lambda表達式
            Function<String, String> result = checkResultDispatcher.get(order);
            if (result != null) {
                //執行這段表達式獲得String類型的結果
                return result.apply(order);
            }
            return "不在處理的邏輯中返回業務錯誤";
        }
    }
    

    通過http調用一下看看效果:

    /**
     * 模擬一次http調用
     */
    @RestController
    public class BizController {
    
        @Autowired
        private BizService bizService;
    
        @PostMapping("/v1/biz/testSuper")
        public String test2(String order) {
            return bizService.getCheckResultSuper(order);
        }
    }
    

    這是個簡單的demo演示,之後會舉一些複雜的場景案例。

    魯迅曾說過,“每解決一個問題,就會引出更多的問題”。我們一起來看看這樣的實現有什麼好處,會帶來什麼問題。

    好處很直觀:

    1. 在一段代碼里直觀的看到”判斷條件”與業務邏輯的映射關係
    2. 不需要單獨定義接口與實現類,直接使用現有的函數式接口(什麼?不知道函數式接口?快去了解),而實現類直接就是業務代碼本身。

    不好的點:

    1. 需要團隊成員對lambda表達式有所了解(什麼?Java14都出來了還有沒用上Java8新特性的小夥伴?)

    接下來我舉幾個在業務中經常遇到的if else場景,並用Map+函數式接口的方式來解決它

    在真實業務場景問題的解決思路

    有的小夥伴會說,我的判斷條件有多個啊,而且很複雜,你之前舉個例子只有單個判斷邏輯,而我有多個判斷邏輯該怎麼辦呢?

    很好解決:寫一個判斷邏輯的方法,Map的key由方法計算出

    /**
     * 某個業務服務類
     */
    @Service
    public class BizService {
    
        private Map<String, Function<String, String>> checkResultDispatcherMuti = new HashMap<>();
    
        /**
         * 初始化 業務邏輯分派Map 其中value 存放的是 lambda表達式
         */
        @PostConstruct
        public void checkResultDispatcherMuitInit() {
            checkResultDispatcherMuti.put("key_訂單1", order -> String.format("對%s執行業務邏輯1", order));
            checkResultDispatcherMuti.put("key_訂單1_訂單2", order -> String.format("對%s執行業務邏輯2", order));
            checkResultDispatcherMuti.put("key_訂單1_訂單2_訂單3", order -> String.format("對%s執行業務邏輯3", order));
        }
    
        public String getCheckResultMuti(String order, int level) {
            //寫一段生成key的邏輯:
            String ley = getDispatcherKey(order, level);
    
            Function<String, String> result = checkResultDispatcherMuti.get(ley);
            if (result != null) {
                //執行這段表達式獲得String類型的結果
                return result.apply(order);
            }
            return "不在處理的邏輯中返回業務錯誤";
        }
    
        /**
         * 判斷條件方法
         */
        private String getDispatcherKey(String order, int level) {
            StringBuilder key = new StringBuilder("key");
            for (int i = 1; i <= level; i++) {
                key.append("_" + order + i);
            }
            return key.toString();
        }
    }
    

    用http模擬一下:

    /**
     * 模擬一次http調用
     */
    @RestController
    public class BizController {
    
        @Autowired
        private BizService bizService;
    
        @PostMapping("/v1/biz/testMuti")
        public String test1(String order, Integer level) {
            return bizService.getCheckResultMuti(order, level);
        }
    }
    

    只要設計好你的key的生成規則就好。

    還有小夥伴會問:我的業務邏輯有很多很多行,在checkResultDispatcherMuitInit()方法的Map中直接寫不會很長嗎?

    直接寫當然長了,我們可以抽象出一個service服務專門放業務邏輯,然後在定義中調用它就好了:

    提供一個業務邏輯單元:

    /**
     * 提供業務邏輯單元
     */
    @Service
    public class BizUnitService {
    
        public String bizOne(String order) {
            return order + "各種花式操作1";
        }
        public String bizTwo(String order) {
            return order + "各種花式操作2";
        }
        public String bizThree(String order) {
            return order + "各種花式操作3";
        }
    }
    
    /**
     * 某個業務服務類
     */
    @Service
    public class BizService {
        @Autowired
        private BizUnitService bizUnitService;
    
        private Map<String, Function<String, String>> checkResultDispatcherComX = new HashMap<>();
    
        /**
         * 初始化 業務邏輯分派Map 其中value 存放的是 lambda表達式
         */
        @PostConstruct
        public void checkResultDispatcherComXInit() {
            checkResultDispatcherComX.put("key_訂單1", order -> bizUnitService.bizOne(order));
            checkResultDispatcherComX.put("key_訂單1_訂單2", order -> bizUnitService.bizTwo(order));
            checkResultDispatcherComX.put("key_訂單1_訂單2_訂單3", order -> bizUnitService.bizThree(order));
        }
    
        public String getCheckResultComX(String order, int level) {
            //寫一段生成key的邏輯:
            String ley = getDispatcherComXKey(order, level);
    
            Function<String, String> result = checkResultDispatcherComX.get(ley);
            if (result != null) {
                //執行這段表達式獲得String類型的結果
                return result.apply(order);
            }
            return "不在處理的邏輯中返回業務錯誤";
        }
    
        /**
         * 判斷條件方法
         */
        private String getDispatcherComXKey(String order, int level) {
            StringBuilder key = new StringBuilder("key");
            for (int i = 1; i <= level; i++) {
                key.append("_" + order + i);
            }
            return key.toString();
        }
    }
    

    調用結果:

    總結

    最後,我們一起嘗試回答以下幾個問題:

    1. 策略模式是如何優化業務邏輯代碼結構的?
      —— 抽象了出了接口,將業務邏輯封裝成一個一個的實現類,任意地替換。在複雜場景(業務邏輯較多)時比直接 if else 來的好維護些。
    2. 殺雞焉用宰牛刀?就是幾個if else場景我需要用到策略模式?!——我們所不滿的其實就是傳統接口實現的缺點:1、策略類會很多。 2、業務邏輯分散到各個實現類中,而且沒有一個地方可以俯覽整個業務邏輯
    3. 有沒有什麼更好的代碼結構來實現策略模式的嗎?——針對傳統策略模式的缺點,分享了利用Map與函數式接口來實現的思路。

    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※別再煩惱如何寫文案,掌握八大原則!

  • Python異常處理

    Python異常處理

    Python中的異常處理

    異常分類

      程序中難免出現錯誤,總共可分為兩種。


      1.邏輯錯誤

      2.語法錯誤


      對於剛接觸編程的人來說,這兩個錯誤都會經常去犯,但是隨着經驗慢慢的積累,語法錯誤的情況會越來越少反而邏輯錯誤的情況會越來越多(因為工程量巨大)。不論多麼老道的程序員都不可避免出現這兩種錯誤。


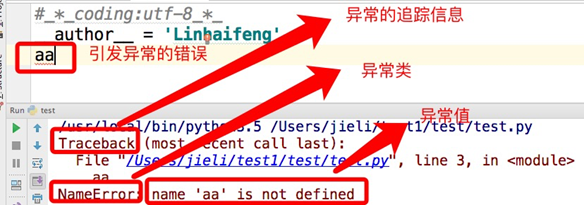
    異常的三大信息

      異常其實就是程序運行時發生錯誤的信號,我們寫代碼的過程中不可避免也最害怕的就是出現異常,然而當程序拋出異常時實際上會分為三部分,即三大信息。


    常用的異常類

      在Python中一切皆對象,異常本身也是由一個類生成的,NameError其實本身就是一個異常類,其他諸如此類的異常類還有很多。

    Python中常見的異常類 
    AttributeError 試圖訪問一個對象沒有的屬性,比如foo.x,但是foo並沒有屬性x
    IOError 輸入/輸出異常;基本上是無法打開文件
    ImportError 無法引入模塊或包;基本上是路徑問題或名稱錯誤
    IndentationError 語法錯誤(的子類) ;代碼沒有正確對齊
    IndexError 下標索引超出序列邊界,比如當x只有三個元素,卻試圖訪問x[5]
    KeyError 試圖訪問字典里不存在的鍵
    KeyboardInterrupt Ctrl+C被按下
    NameError 試圖使用一個還未被賦予對象的變量
    SyntaxError Python代碼非法,代碼不能編譯(其實就是語法錯誤,寫錯了)
    TypeError 傳入對象類型與要求的不符合
    UnboundLocalError 試圖訪問一個還未被設置的局部變量,基本上是由於另有一個同名的 全局變量,導致你以為正在訪問它
    ValueError 傳入一個調用者不期望的值,即使值的類型是正確的


    異常處理

      我們可以來用某些方法進行異常捕捉,當出現異常時我們希望代碼以另一種邏輯運行,使得我們的程序更加健壯,這個就叫做異常處理。異常處理是非常重要的,本身也並不複雜,千萬不可馬虎大意。

      但是切記不可濫用異常處理,這會使得你的代碼可讀性變差。


    if else處理異常

      if和else本身就具有處理異常的功能,他們更多的是在我們能預測到可能出現的範圍內進行規避異常,對於我們不能預測的異常來說就顯得不是那麼的好用。如下:

    # ==== if else 處理異常 ====
    
    while 1:
        select = input("請輸入数字0進行關機:").strip()
        if select.isdigit():  # 我們可以防止用戶輸入非数字的字符
            if select == "0":
                print("正在關機...")
                break
        print("輸入有誤,請重新輸入")
    
    # ==== 執行結果 ====
    
    """
    請輸入数字0進行關機:關機
    輸入有誤,請重新輸入
    請輸入数字0進行關機:關機啊
    輸入有誤,請重新輸入
    請輸入数字0進行關機:0
    正在關機...
    """

      這種異常處理機制雖然非常簡單,但是並不靈活,我們可以使用更加簡單的方式來處理他們。


    try except處理異常


      try:代表要檢測可能出現異常的代碼塊

      except:當異常出現后的處理情況


      執行流程:

        try中檢測的代碼塊 —> 如果有異常 —> 執行except代碼塊 —> 執行正常邏輯代碼 —> 程序結束

        try中檢測的代碼塊 —> 如果沒有異常 —> 執行完畢try中的代碼塊 —> 執行正常邏輯代碼 —> 程序結束


    # ====  try except 執行流程 有異常的情況 ====
    
    li = [1,2,3]
    
    try:
        print("開始執行我try了...")
        print(li[10])  # 出錯點...
        print("繼續執行我try...")
    except IndexError as e:
        print("有異常執行我except...")
    
    print("正常邏輯代碼...")
    
    # ==== 執行結果 ====
    
    """
    開始執行我try了...
    有異常執行我except...
    正常邏輯代碼...
    """ 
    # ====  try except 執行流程 無異常的情況 ====
    
    li = [1,2,3]
    
    try:
        print("開始執行我try了...")
        print(li[2])
        print("繼續執行我try...")
    except IndexError as e:
        print("有異常執行我except...")
    
    print("正常邏輯代碼...")
    
    # ==== 執行結果 ====
    
    """
    開始執行我try了...
    3
    繼續執行我try...
    正常邏輯代碼...
    """ 
    # ==== try except 處理異常 ====
    
    while 1:
        try:  # try檢測可能出錯的語句,一旦出錯立馬跳轉到except語句塊執行代碼。
            select = int(input("請輸入数字0進行關機:").strip())
            if select == 0:
                print("正在關機...")
                break
            print("輸入有誤,請重新輸入...")
        except ValueError as e:  # 當執行完except的代碼塊后,程序運行結束,其中e代表的是異常信息。
            print("錯誤信息是:",e)
            print("輸入有誤,請重新輸入")
    
    # ==== 執行結果 ====
    
    """
    請輸入数字0進行關機:1
    輸入有誤,請重新輸入...
    請輸入数字0進行關機:tt
    錯誤信息是: invalid literal for int() with base 10: 'tt'
    輸入有誤,請重新輸入
    請輸入数字0進行關機:0
    正在關機...
    """


    多段except捕捉多異常

      我們可以使用try和多段except的語法來檢測某一代碼塊,可以更加方便的應對更多類型的錯誤,Ps不常用:

    # ==== 多段 except 捕捉多異常 ====
    
    while 1:
    
        li = [1,2,3,4]
        dic = {"name":"Yunya","age":18}
    
        li_index = input("請輸入索引:")
        dic_key = input("請輸入鍵的名稱:")
    
        if li_index.isdigit():
            li_index = int(li_index)
    
        try:
            print(li[li_index])
            print(dic[dic_key])
        except IndexError as e1:  # 注意,先拋出的錯誤會直接跳到其處理的except代碼塊,而try下面的語句將不會被執行。
            print("索引出錯啦!")
        except KeyError as e2:
            print("鍵出錯啦!")
    
    # ==== 執行結果 ====
    
    """
    請輸入索引:10
    請輸入鍵的名稱:gender
    索引出錯啦!
    請輸入索引:2
    請輸入鍵的名稱:gender
    3
    鍵出錯啦!
    """


    元組捕捉多異常

      使用多段except捕捉多異常會顯得特別麻煩,這個時候我們可以使用(異常類1,異常類2)來捕捉多異常,但是需要注意的是,對比多段except捕捉多異常來說,這種方式的處理邏輯會顯得較為複雜(因為只有一段處理邏輯),如下:

    # ====  元組捕捉多異常 ====
    
    while 1:
    
        li = [1,2,3,4]
        dic = {"name":"Yunya","age":18}
    
        li_index = input("請輸入索引:")
        dic_key = input("請輸入鍵的名稱:")
    
        if li_index.isdigit():
            li_index = int(li_index)
    
        try:
            print(li[li_index])
            print(dic[dic_key])
        except (IndexError,KeyError) as e:  # 使用()的方式可以同時捕捉很多異常。
            print("出錯啦!")
    
    # ==== 執行結果 ====
    
    """
    請輸入索引:10
    請輸入鍵的名稱:gender
    出錯啦!
    請輸入索引:2
    請輸入鍵的名稱:gender
    3
    出錯啦!
    """

      可以看到,不管是那種錯誤都只有一種應對策略,如果我們想要多種應對策略就只能寫if判斷來判斷異常類型再做處理。所以就會顯得很麻煩,如下:

    # ====  元組捕捉多異常 ====
    
    while 1:
    
        li = [1,2,3,4]
        dic = {"name":"Yunya","age":18}
    
        li_index = input("請輸入索引:")
        dic_key = input("請輸入鍵的名稱:")
    
        if li_index.isdigit():
            li_index = int(li_index)
    
        try:
            print(li[li_index])
            print(dic[dic_key])
        except (IndexError,KeyError) as e:
            # 判斷異常類型再做出相應的對應策略
            if isinstance(e,IndexError):
                print("索引出錯啦!")
            elif isinstance(e,KeyError):
                print("鍵出錯啦!")
    
    # ==== 執行結果 ====
    
    """
    請輸入索引:10
    請輸入鍵的名稱:gender
    索引出錯啦!
    請輸入索引:2
    請輸入鍵的名稱:gender
    3
    鍵出錯啦!
    """


    萬能異常Exception

      我們可以捕捉Exception類引發的異常,它是所有異常類的基類。(Exception類的父類則是BaseException類,而BaseException的父類則是object類)

    # ====  萬能異常Exception ====
    
    while 1:
    
        li = [1,2,3,4]
        dic = {"name":"Yunya","age":18}
    
        li_index = input("請輸入索引:")
        dic_key = input("請輸入鍵的名稱:")
    
        if li_index.isdigit():
            li_index = int(li_index)
    
        try:
            print(li[li_index])
            print(dic[dic_key])
        except Exception as e:  #使用 Exception來捕捉所有異常。
            # 判斷異常類型再做出相應的對應策略
            if isinstance(e,IndexError):
                print("索引出錯啦!")
            elif isinstance(e,KeyError):
                print("鍵出錯啦!")
    
    # ==== 執行結果 ====
    
    """
    請輸入索引:10
    請輸入鍵的名稱:gender
    索引出錯啦!
    請輸入索引:2
    請輸入鍵的名稱:gender
    3
    鍵出錯啦!
    """


    try except else聯用

      這種玩法比較少,else代表沒有異常發生的情況下執行的代碼,執行順序如下:


      try中檢測的代碼塊 —> 如果有異常 —> 終止try中的代碼塊繼續執行 —> 執行except代碼塊 —> 執行正常邏輯代碼 —> 程序結束

      try中檢測的代碼塊 —> 如果沒有異常 —> 執行完畢try中的代碼塊 —> 執行else代碼塊 —> 執行正常邏輯代碼 —> 程序結束


    # ====  try except else聯用 有異常的情況====
    
    li = [1,2,3]
    
    try:
        print("開始執行我try了...")
        print(li[10])  # 出錯點...
        print("繼續執行我try...")
    except IndexError as e:
        print("有異常執行我except...")
    else:
        print("沒有異常執行我else...")
    print("正常邏輯代碼...")
    
    # ==== 執行結果 ====
    
    """
    開始執行我try了...
    有異常執行我except...
    正常邏輯代碼...
    """
    # ====  try except else聯用 無異常的情況====
    
    li = [1,2,3]
    
    try:
        print("開始執行我try了...")
        print(li[2])
        print("繼續執行我try...")
    except IndexError as e:
        print("有異常執行我except...")
    else:
        print("沒有異常執行我else...")
    print("正常邏輯代碼...")
    
    # ==== 執行結果 ====
    
    """
    開始執行我try了...
    3
    繼續執行我try...
    沒有異常執行我else...
    正常邏輯代碼...
    """


    try except finally聯用

      finally代表不論拋異常與否都會執行,因此常被用作關閉系統資源的操作,關於try,except,else,finally他們的優先級如下:


      有異常的情況下:

        try代碼塊

        終止try代碼塊繼續執行

        except代碼塊

        finally代碼塊

        正常邏輯代碼


      無異常的情況下:

        try代碼塊

        else代碼塊

        finally代碼塊

        正常邏輯代碼


    # ====  try except else finally 執行流程 有異常的情況 ====
    
    li = [1,2,3]
    
    try:
        print("開始執行我try了...")
        print(li[10])  # 出錯點...
        print("繼續執行我try...")
    except IndexError as e:
        print("有異常執行我except...")
    else:
        print("沒有異常執行我else...")
    finally:
        print("不管有沒有異常都執行我finally...")
    
    print("正常邏輯代碼...")
    
    # ==== 執行結果 ====
    
    """
    開始執行我try了...
    有異常執行我except...
    不管有沒有異常都執行我finally...
    正常邏輯代碼...
    """
    # ====  try except else finally 執行流程 無異常的情況 ====
    
    li = [1,2,3]
    
    try:
        print("開始執行我try了...")
        print(li[2])
        print("繼續執行我try...")
    except IndexError as e:
        print("有異常執行我except...")
    else:
        print("沒有異常執行我else...")
    finally:
        print("不管有沒有異常都執行我finally...")
    
    print("正常邏輯代碼...")
    
    # ==== 執行結果 ====
    
    """
    開始執行我try了...
    3
    繼續執行我try...
    沒有異常執行我else...
    不管有沒有異常都執行我finally...
    正常邏輯代碼...
    """


    自定義異常

    raise主動拋出異常

      在某些時候我們可能需要主動的去阻止程序的運行,主動的拋出一個異常。可以使用raise來進行操作。這個是一種非常常用的手段。

    # ====  raise使用方法  ====
    
    print("----1----")
    print("----2----")
    print("----3----")
    raise Exception("我也不知道是什麼類型的異常...")
    print("----4----")
    print("----5----")
    print("----6----")
    
    # ==== 執行結果 ====
    
    """
    ----1----
    ----2----
    ----3----
    Traceback (most recent call last):
      File "C:/Users/Administrator/PycharmProjects/learn/元類編程.py", line 6, in <module>
        raise Exception("我也不知道是什麼類型的異常...")
    Exception: 我也不知道是什麼類型的異常...
    
    Process finished with exit code 1
    """


    自定義異常類

      前面已經說過一切皆對象,異常也來自一個對象。因此我們也可以自己來定製一個對象。注意,自定義異常類必須繼承BaseException類。

    # ====  自定義異常類  ====
    
    class MyError(BaseException):
        pass
    
    raise MyError("我的異常")


    # ==== 執行結果 ====
    
    """
    Traceback (most recent call last):
      File "C:/Users/Administrator/PycharmProjects/learn/元類編程.py", line 6, in <module>
        raise MyError("我的異常")
    __main__.MyError: 我的異常
    """


    擴展:斷言assert

      斷言是一個十分裝逼的使用,假設多個函數進行計算,我們已經有了預期的結果只是在做一個算法的設計。如果函數的最後的結果不是我們本來預期的結果那麼寧願讓他停止運行也不要讓錯誤繼續擴大,在這種情況下就可以使用斷言操作,使用斷言會拋出一個AssertionError類的異常。

    # ====  斷言assert  ====
    
    def calculate():
        """假設在做非常複雜的運算"""
        return 3+2*5
    
    res = calculate()
    
    assert res == 25  # AssertionError
    
    print("算法測試通過!你真的太厲害了")
    
    # ==== 執行結果 ====
    
    """
    Traceback (most recent call last):
      File "C:/Users/Administrator/PycharmProjects/learn/元類編程.py", line 8, in <module>
        assert res == 25
    AssertionError
    """


    本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

    【其他文章推薦】

    ※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

    ※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

    ※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

    ※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

    ※新北清潔公司,居家、辦公、裝潢細清專業服務

    ※教你寫出一流的銷售文案?